【Unreal Fest 2023】《鸣潮》基于虚幻引擎4的多平台效果和性能优化实践
来源:C:\Users\shaotang\Downloads\Bilibili_Videos[UFSH2023]《鸣潮》基于虚幻引擎4的多平台效果和性能优化实践 _ 王宏波 库洛游戏.mp4
提取时间:2026-05-11 21:10:36
以下是您提供的内容的结构化总结与关键点提炼,便于理解和应用:
一、TAA(Temporal Anti-Aliasing)优化方案
1. 混合方案设计
- 核心思想:结合传统TA算法与图像处理技术,针对不同像素特征(静态/动态)进行动态权重调整。
- 关键技术:
- 双权重系统:根据像素运动速度(Velocity)动态调整当前帧与历史帧的权重(速度越快,当前帧权重越高)。
- 图像锐化算法:引入Unsharp Mask算法增强动态物体边缘清晰度,复用十字形采样数据。
- 混合采样策略:融合经典TA算法与FSR(FidelityFX Super Resolution)的多项式逼近方法,支持不同上采样算法(如双线性采样)。
2. 性能测试数据
- ARM Mali GPU:
- 仅开启TAA:约1.1毫秒/帧。
- 开启TAA+TAU(混合方案):约1.5毫秒/帧。
- 问题定位:
- FPK失效:在ARM Mali GPU上,使用
Device Fetch导致FPK(Fragment Processing Kernel)效率骤降(开启后FPK值从1.2MB降至0.01MB)。 - 解决方案:禁用
Device Fetch,但需牺牲部分性能(G84性能不足),最终采用混合管线(One Pass Deferred + Forward卡通渲染)。
- FPK失效:在ARM Mali GPU上,使用
3. 高通GPU带宽优化
- 问题发现:
- One Pass方案读取带宽节省超30%,但写入带宽优化不足(仅10%-15%)。
- 原因:Adreno和Mali GPU对RT(Render Target)进行高效压缩,实际带宽消耗低于理论预期(单帧约1.2-1.3GB,60帧下每秒约72-78GB)。
- 修复措施:
- 修正UE4.26/4.27版本RHI(Rendering Hardware Interface)的Bug,避免错误resolve所有RT。
二、One Pass Deferred管线优化
1. GBuffer结构设计
- 初始方案:
- 四张GBuffer(Scene Color、Normal+Light Fusion、Base Color+AO) + Depth Buffer。
- 材质区分:通过Stencil Mask实现卡渲材质(卡通)、NPR植被材质与PBR材质的分离。
- 问题与改进:
- FPK失效:ARM Mali GPU因
Device Fetch导致FPK效率低下。 - 混合管线方案:
- 结构调整:将Depth信息编码到GBuffer中,减少GBuffer数量(从3种模式降至2种)。
- 流程重构:将Decal、Light Function、Water Fog等处理逻辑后移至Lighting Pass后,避免Forward Pass的额外开销。
- FPK失效:ARM Mali GPU因
2. 性能收益
- ARM Mali GPU:
- 温度下降5-6°C,GPU时钟频率降低约25%。
- 高通GPU:
- 带宽优化显著(读取带宽节省30%+),但需修复UE4 RHI Bug。
三、多平台适配策略
1. 核心理念
- 统一平台思维:将多平台视为单一平台处理,按性能层级划分(如PC高配 ≈ PS5,手机高配 ≈ PS4低配)。
- 影响因素:
- 内存、计算能力(CPU/GPU)、I/O性能、功耗、包体大小。
2. 适配分层方案
- 三层优化策略(内容被截断,需补充):
- 基础层:统一资源管理(如纹理压缩、LOD策略)。
- 中间层:平台特性适配(如Mali GPU的
Device Fetch禁用、Adreno带宽优化)。 - 应用层:动态调整渲染管线(如混合One Pass Deferred + Forward卡通渲染)。
3. 树的双端方案(未完整内容)
- 可能方向:针对不同平台(如PC/主机 vs 手机)采用差异化树模型(如高精度模型用于PC,低多边形模型用于手机)。
四、总结与建议
- TAA优化:混合方案(TA + 图像处理)可兼顾画质与性能,需针对不同GPU特性(如ARM Mali的
Device Fetch问题)进行适配。 - One Pass管线:需警惕UE4特定Bug(如RHI错误resolve RT),并采用混合管线(One Pass + Forward)平衡性能与兼容性。
- 多平台适配:统一性能层级划分,结合平台特性(如带宽、FPK效率)动态调整渲染策略,避免“一刀切”方案。
如需进一步补充某部分内容(如树的双端方案细节),请提供更多信息!
Slide 1 — 00:00:00

📌 要点汇总
- (过渡内容,无关键要点)
大家好,我叫王波,现在在酷洛游戏。我今天的分享是关于《明朝》在多平台的一些效果和性能优化。由于内容可能比较碎片化,另外我个人的语速可能会比较快,大家稍微见谅一点。现在就开始。
这个分享主要涉及两个方面:首先是多平台上的效果和性能优化,其次是针对可能出现的碎片化内容和语速问题的说明。由于内容涉及多个技术细节,可能需要分点阐述,但整体逻辑会保持连贯。希望各位能够耐心聆听,如果有任何疑问,欢迎在后续环节交流。
Slide 2 — 00:00:22
📌 要点汇总
- (过渡内容,无关键要点)
这是我过往做过的一些游戏。然后昨天晚上刚好跟一个朋友吃饭的时候就聊到这个事儿,就是我想找我第一款做过的游戏就已经找不到了。从从业大概有接近二十年了,有一个感触,就是还能跟大家一起做游戏都挺不容易的。
先看看我们游戏的一个介绍。
Slide 3 — 00:00:53
(该幻灯片时间段内未检测到语音内容)
Slide 4 — 00:01:05
📌 要点汇总
- 项目为开放世界二次元游戏,核心特性包括大世界、ACT战斗系统和宝可梦式收集系统
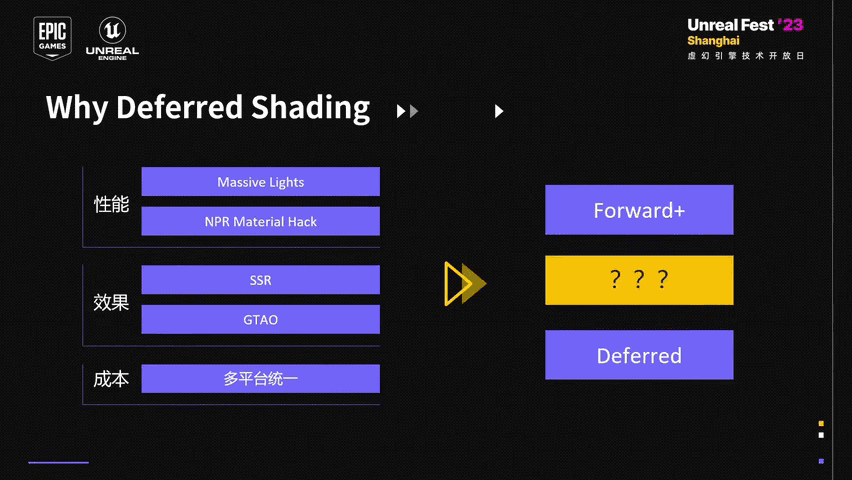
- 选择deferred shading因同屏灯光达200+、需实现SSR/GTAO效果,且开发成本与forward+方案相近
- One Pass Deferred实现中需解决G-Buffer优化与引擎兼容性适配问题
- 多平台大规模森林需平衡视觉效果与性能,涉及LOD控制、资源管理和跨平台渲染管线适配
- TAA优化方案未展开,但属于三大技术方案之一(需后续补充)
我们项目是一款开放世界的二次元游戏。它的主要特性包括:第一是大世界,第二是ACT战斗系统,第三是类似宝可梦的收集系统。刚才大家看的视频,应该已经对游戏有了整体印象,这样方便我后面讲解时,大家能理解为什么需要那样设计。由于时间限制,我无法面面俱到。今天的分享将重点介绍三个典型方案:第一个是为什么选择deferred shading渲染管线,第二个是TAA的优化方案,第三个是实现One Pass Deferred时遇到的两个问题,以及在多平台上实现大规模森林时如何平衡效果与性能。
关于选择deferred shading的原因,移动端通常采用forward shading或mobile shading方案,这主要源于大规模灯光处理的需求。我们同屏灯光数量较多,通常可达两百多盏,最少也有四五十盏,夜间TOD场景时灯光数量会进一步增加。选择deferred的第二个原因是效果需求,我们希望实现SSR(屏幕空间反射)和GTAO(屏幕空间环境光遮蔽)等效果。第三个原因是开发成本,无论是采用forward+还是deferred方案,开发成本差异不大。经过权衡后我们最终选择了deferred方案。
但选择deferred方案也面临挑战。首先是G-Buffer(几何缓冲区)的实现问题,其次是引擎本身的适配问题。在实现One Pass Deferred时,我们遇到了两个主要问题:第一是G-Buffer的优化,第二是引擎层面的兼容性处理。这些都需要在开发过程中重点解决。
在实现大规模森林场景时,我们面临多平台性能与效果的平衡难题。需要确保在不同设备上都能保持视觉效果的同时,不牺牲性能表现。这涉及到资源管理、LOD(细节层次)控制、多平台渲染管线适配等多个技术环节,需要综合考虑硬件差异和渲染效率。
Slide 5 — 00:03:54
📌 要点汇总
- 二次元游戏同屏边缘像素率可达4-5%,AA难度高于常规PBR游戏
- TA pass结构与UE默认mobile TA pass差异:增加velocity buffer pass并调整位置
- 手机端采用十字形5点采样kernel,低配机用RGB空间优化鬼影问题
- Velocity buffer包含速度编码(24位RGB)和角色像素mask(Character Mask)
- 为避免性能损耗,未渲染勾边pass到velocity buffer导致角色边缘黑边问题
- 角色动画需多次渲染(base pass×2、velocity pass×2等),最终舍弃velocity buffer
选了 Developer 之后的话,那我们的 AA 方案就只能够选择后处理的 AA 了。这是我截了一张我们的游戏的图,大家可以看到整个游戏的话,那个在 AA 之前它的锯齿是非常多的。无论我们的角色的勾边,或者说我们的草,或者说像我们的那个树以及我们远处的那些建筑本身,都是有很多的锯齿。对于一般的 PBR 的游戏来说,它的同屏的一个边缘像素率占比大概在百分之 1 到百分之 2 左右。对于一个 PBR 的游戏或者说二次元游戏,像去年的 UOD 就人统计过某一款比较知名的二次元游戏,它的同屏的边缘像素率占比大概有百分之 4 到百分之 5。按我们游戏来说可能会更高,所以我们的 AA 可能会更加的难做。所以我们会第一个讲我们的 AA,那 AA 的分享的话主要分几个点来讲。第一个就是讲我们 AA 的一个基本的一个渲染流程。第二个就是讲我们的一些关于鬼影、关于闪烁的一些优化。第三个是关于我们在做一些更细节的一些效果优化的时候是怎么做的。最后呢,会简单介绍一下我们这个 TAU 的 U 是怎么实现的。
这里有一个问题就是,我不会去介绍我们 TAU 的一般的一个算法流程,我就假定大家都是知道是怎么做的,所以我就直接进入正题,直接讲怎么优化。第一个介绍是我们的 TA 的 pass 和那个 UE 默认的 mobile TA 的 pass 的一个区别。这里 UE 四 UE 五的话,它是有一套 PC 的那个 TA,跟我们的可能整个的那个流程可能会差异会更大一些。可以看到左侧呢是那个 UE 默认的 TA 的 pass,我们的右侧是我们的一个 pass。从结构上来说呢,可能看不出太多的一些变化,就是我们加了一个 velocity buffer 的一个 pass,然后 TA 的 pass 呢变成一个 TAU 的 pass。但实际上在内部的实现呢,会差异会比较大。我们加了一个 velocity pass,也就是因为我们需要对角色做处理所做的一些外的一些数据准备。另外 TA 的 pass 放在了那个 Bloom 和 Tonemapping 之后呢,它会产生一些问题,就是比如说 Bloom 会导致它那些锯齿和那些闪烁会被放大,但是因为一些性能的原因,我们最终还是选择了把它放到后面。当然我们有些手段可以把它一些问题给处理掉。
第一个就是讲一下我们的一个鬼影一般的鬼影问题的一个优化的方式,这个方式跟传统的方式没什么区别,也都是走了历史像素的一个 clamp 的一个算法。第一个就是我们的采样的一个 kernel 的选择,在 kernel 选择呢,在 PC 上当然是三乘三的了,但是在那个手机上呢,我们是采用了一个十字形的一个采样,这是五个采样点。第二个就是关于那个历史像素的一个包含 box 的一个计算,这也有三种算法,我们最后呢在手机上选的是 A、B、B 也是最廉价的一个方式,但它效果呢也会要略差一点。最后一个呢,就是关于那个 color space 的一个选择。color space 的选择呢,这一块呢因为人也是对那个亮度会比对颜色会更加敏感,所以一般来说都会选择用亮度或者用把它颜色转换到 YCOCG 这个空间去做一些那个历史像素的一个 clamp。在这里呢,我们是同时实现了这三种模式。然后我们会在低配机上面选一下 RGB 的一个颜色空间来做,但是可能在一些高配上面可能会选择 YCOCG 来做。虽然说 YCOCG 单个像素的转换成本不是很高,但是它对于我们采样五个像素或更多像素的时候,它的采样成本会变得比较高。
第二个就是 Velocity Buffer 的一个介绍了。因为只有那个历史像素的 Camera 呢,它其实是解决不了那个角色呀,或者说一些带其他的顶点动画、带骨骼动画的这一种模型的它的那个鬼影的问题的,因为它的运动轨迹是跟那个相机没有关系的。这是我们的一个 Velocity buffer 的一个结构,就是大概分为两部分。第一部分就是关于我们的一个速度,速度就是一个编码到了 24 位的一个 RGB 里面去了。另外呢还会有一个 Character Mask,它是专门记录说这个东西是不是角色的这个像素。这个是因为在做角色在做那个记的时候,需要非常精确的一个判断是它是不是角色,这样就更不容易产生一些鬼影和一些染色的一个问题。大家可以看一看这个 buffer,看看有没有什么问题。
这里下一页就是讲的是我们的 velocity buffer,其实可以看得到它那个因为我们没有把那个勾边儿这个 pass 渲染那个 velocity buffer,所以它会导致说,发现角色上有很多的黑边。就是黑边的话,那它就会被,因为我们的 cavity mask 会判断它是不是角色的像素,这就会导致说,我们在真正做 TA 的时候会判定它不是一个角色的像素,这就会导致一些问题。为什么我们会这么做?其实主要也是因为性能的问题。在移动端的话,如果说我们要渲染一个角色,对卡渲来说,它至少要渲染五六遍以上的。大家可以看到我这里列了一下,base pass 可能要渲染两遍,然后呢,你的那个 velocity pass 可能要渲染两遍,然后你的阴影可能要渲染一遍,然后你的如果你要做一些类似 OIT 或者是或者说像一些其他的其他的一些像类似于勾边边缘光这种效果,可能还需要渲染一个 custom 的一个 double pass。然后蒙皮的话就更夸张了,因为如果你要算那个 velocity pass 的时候呢,你可能需要每一次的渲染都需要蒙皮两次,因为它需要上一帧的位置和当前帧的位置才能够得到一个那个它的速度,所以我们最终选择其实实际上是把它给去掉了的。可以看下一页,就可以看看大家看看视频效果,就是能看到我们去掉了 velocity buffer 之后呢,它会导致我们的角色边缘会产生比较厉害的…
Slide 6 — 00:09:52
📌 要点汇总
- 避免Ghost需依赖边缘像素无法采样历史数据的特性
- 性能优化通过跳过VRC buffer勾边渲染实现
- 低通滤波(如Bass Filter)减少闪烁,复用十字形采样数据
- 静态/动态像素分离处理,权重根据velocity插值
- 引入Unsharp Mask锐化算法,复用十字形采样数据
- TAU的U部分实现距离权重插值及FSR多项式逼近算法
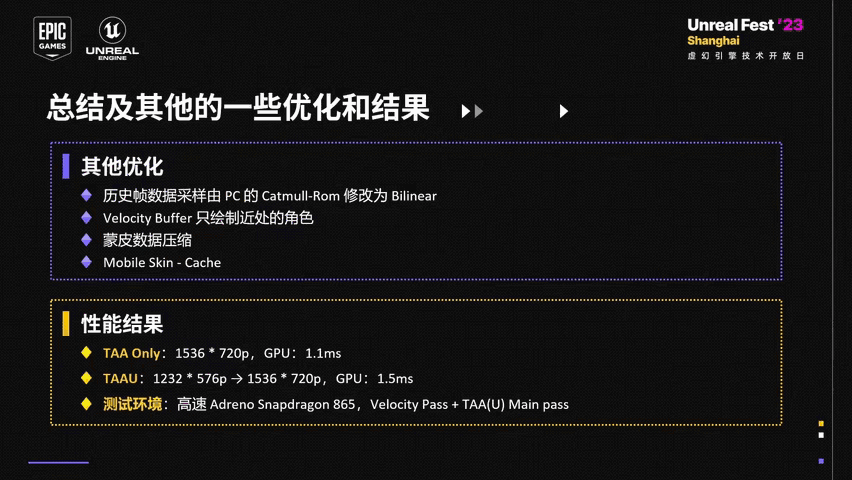
- TAA性能:八六五平台TAA约1.1ms,TAAU约1.5ms
- 混合方案融合经典TA算法与图像处理优化,适配多平台
不知道看不看得清?大家可以看到那个头发呀,包括那个它的沟边的边缘然后内部的边,像衣服的边都会闪的比较厉害。然后我们再来看看我们TA的目标吧。因为出了这个问题之后,我们总是要重新去想一想,我们要怎么应该怎么做。第一个就是说,我们还是不想要Ghost。第二个呢,我们需要我们的性能还是足够好的,因为我们要适配手机。第三个呢,就是我们最好是不要出现刚才说那种闪烁,或者说尽可能的减少它,让它至少出现频率会低一些,或者说基本上我们感知不到。
这个解决方案呢,其实也相对说比较简单,就是我们的操作方式比较。因为第一个就是像不需要Ghost的这个事情呢,我们只需要不需要做什么操作就好了,因为我们现在本来那些边缘像素就采不到历史像素,所以它就是本身就不会产生Ghost。第二个呢,我们需要性能要好,所以我们是坚持我们是不去做那个VRC buffer的一个勾边的渲染。当然,我们除了这个之外,还做了一些其他的优化,后面会做一个非常简单的介绍,就不会详细去讲了。
第三个就是要不出现那种闪烁的话,那其实有一些方案可以做,就比如说我们尝试了用那个图像空间的一些处理,这是我们比如说做了一个低通滤波。低通滤波的话呢,它就可以减少这些那个像素的这些闪烁的问题。因为我们刚才在做那个历史像素clamp的时候呢,就已经采样过一个十字形周围的一些像素信息,这时候我们可以重复这些采样,重复这些采样呢,其实就已经能够节省这部分的带宽。后面可以看一下我们的一个处理的一个效果。我们常用的一个低通滤波呢,比如说你用一个Bass Filter,它都是可以做的。这是我们处理之后的一个效果。
这个闪烁的问题处理呢,也引发了我们对TA的一些别的思考。就比如说,抛开TA的一个基本原理不说的话,就单纯的看TA算法的实现,它其实就是有两个问题。第一个是,如果它的历史真的权重比较高,那就比较容易产生鬼影;如果它历史真的权重很低或者基本没有的时候呢,那就很容易产生闪烁。所以呢,针对这个问题,我们有些新的想法。我最后我们也把它给实现出来了。
第一个就是说,我们尝试了把静态的像素和动态像素分开处理。我们引入了两套权重系统,然后呢,最终权重是根据velocity值的大小进行插值的。像上述的运动速度越快,它的当前真的那个权重就会越高;相反呢,如果运动速度越慢,那它的当前真的那个权重就会越小,然后它整个物体呢就会变得更加的稳定。这是PPT上有一个简单的公式。这两个权重都是可以配置的。
第二个尝试呢,就是我们引入了一套图像的一个锐化算法。这个算法主要是为了处理动态物体的,就是动态的像素的,比如说我们选择简单的一个Unsharp Mask的锐化算法都可以。这时候Unsharp Mask的算法它有个好处就是它也是一个十字形的一个采样,所以我们仍然可以重用我们之前的一个采样数据。
最后是介绍一下我们TAU的U的部分。U的部分呢,其实没有太多的一个创新,所以就做一个简单介绍。这个一般来说,在做图像上采样的时候呢,它考虑的是目标像素到原像素的距离来做一个权重的插值。因为很多时候放大的时候,它的图像本身可能找不到原像素了,所以它算是个距离,根据距离来算权重,最后根据权重来做插值。但是呢,对于后面新的一些算法,就比如像FSR的话,他们其实除了考虑那个像素的距离之外,它还会考虑原像素本身的一些边缘的一个情况。这个算法呢,这两部分我们都是有实现的。
这里呢,就写了三个那个采用那个滤波器的选滤波器的一个函数,包括有图像。这图像呢,像那个拉索斯就是拉索斯二就是那个FSR用的一个函数。然后拉索斯二的话,FSR它一个精髓实际上是实现了一套那个多项式的一个逼近。最终我们也是用了多项式逼近去做的。然后我们也实现了一个双线性采样的一个上采样,可能在不同的机器上会开不同的一些上采样的一个算法。
这是我们TA的一个数据的一个对比,就是总结一下,就是我们的TA实际上是一个混合方案,就是我们既实现了一个比较经典的一个TA的一个算法,同时呢又融合了一些图像处理的一些方式和方法,然后呢又针对不同的像素的特征做了一些像素的混合处理和弱化处理等等这些优化。有些是不光用来mobile上面,也用在了pc和主机上面的。
然后呢,我们的测试数据大概是八六五上面的话,如果只开TAA的话,大概是一点一毫秒;然后如果说是开TAAU的话,大概是一点五毫秒。
Slide 7 — 00:15:23
📌 要点汇总
- One Pass Deferred管线将多个Pass合并至单个硬件Pass实现
- Lightning拆分基于Cluster技术,材质分为卡渲、NPR植被和PBR三类
- 材质区分通过Stencil Mask实现,支持GLSL 3.2、Metal 2/3、Vulkan API
- One Pass实现依赖on-chip memory,但未展开技术细节
- UE4平台存在特定问题,可能影响管线实现(如踩坑经验)
第二部分的话就是明朝的One Pass Deferred管线的一个总结,主要是想分享我们踩了两个比较大的坑,相信业界很多人做的时候都会碰到这一个问题。我们用的是UE4,大家知道有些问题是UE4独有的。
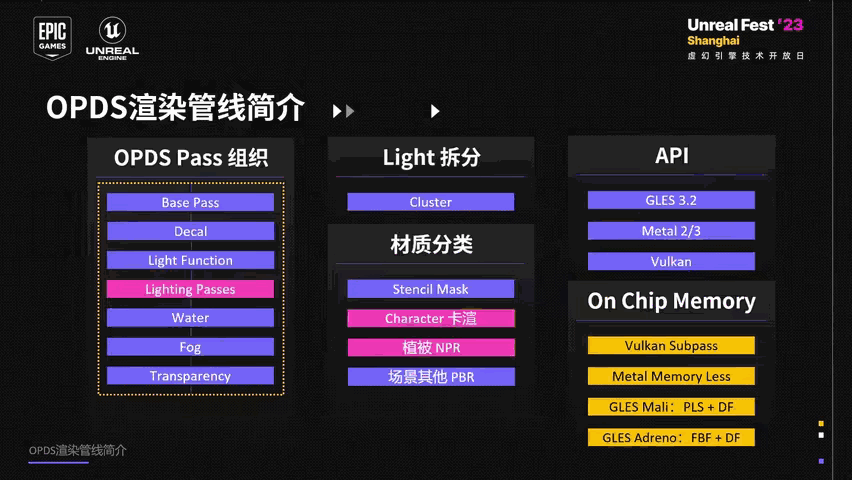
第一个就是简单介绍一下我们的整个One Pass的一个实现,所谓的One Pass是说这张图的左图里面黄色边框里包含的所有Pass,都是在一个硬件Pass里面实现的。然后我们的lightning拆分是通过cluster去做的,材质主要分为三类:卡渲材质、NPR植被材质和场景的其他材质是PBR材质。明朝虽然说是高速渲染游戏,但场景大部分的材质都是PBR的。
材质区分是通过Stencil Mask去做的,我们支持的API包括GLSL 3.2、Metal 2和3,以及Vulkan。One Pass实现都是基于on-chip memory去做的,这一部分因为有很多分享,所以就不做细节介绍了。
Slide 8 — 00:16:31
📌 要点汇总
- GBuffer结构包含4张GBuffer(含Scene Color)+1 Depth Buffer
- Scene Color存储自发光信息,GBuffer A含法线、Light Fusion(用于云层投影)
- GBuffer C存储Base Color与AO(环境光遮蔽)信息
- 不同材质(G/BG/B)在GBuffer中存储特化信息
- 通过Depth Fetch可获取深度信息以实现渲染优化
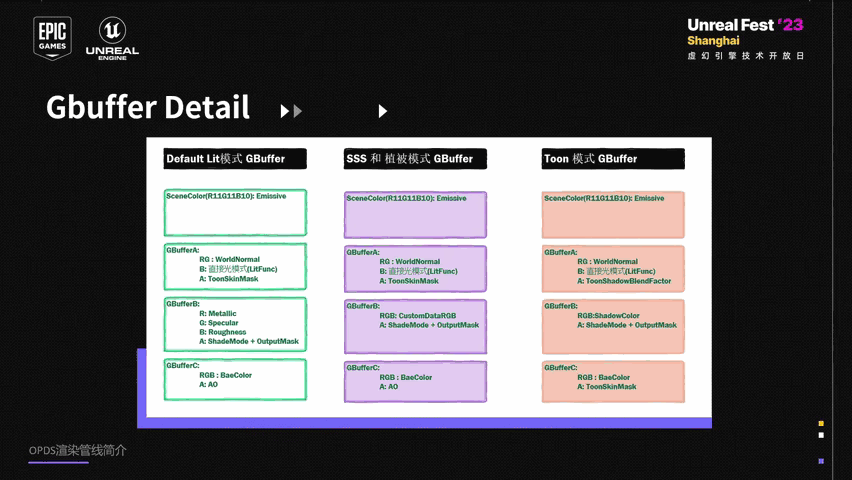
介绍一下我们的GBuffer的结构。我们第一版的实现里用到了三张GBuffer加上一张Scene Color,然后再加上一个Depth Buffer,所以我们应该是四张的GBuffer加上一个Depth。通过Depth Fetch可以获取深度信息。
三种材质中的Scene Color存储的是自发光信息。GBuffer A存储的是法线信息,以及Light Fusion和一个通道的通道信息。其中Light Fusion主要用于云层投影的处理。
GBuffer C存储的是Base Color和AO(环境光遮蔽)的信息。对于G、BG、B和B这几种材质,每种材质存储的内容都不太一样,包含了一些比较特化的信息。
大家看一下图,图上有详细的介绍。
Slide 9 — 00:17:13
📌 要点汇总
- ARM Mali GPU上灯光pass指令数异常高,FPK值仅0.01兆,确认为device flash导致FPK失效
- 关闭device flash后FPK值提升至1.2兆(差异超100倍),ARM最新驱动(九三零级)可能已修复
- 禁用Device Fetch导致G84性能不足,实际可用位数仅88位(文档宣称256/512位)
- 采用混合管线重构:one pass deferred + forward卡通渲染 + G buffer重新编码,减少G buffer模式至2种
- lighting pass后处理decal/light function,直接处理water fog/半透明,优化后GPU温度降5-6℃,时钟频率降25%
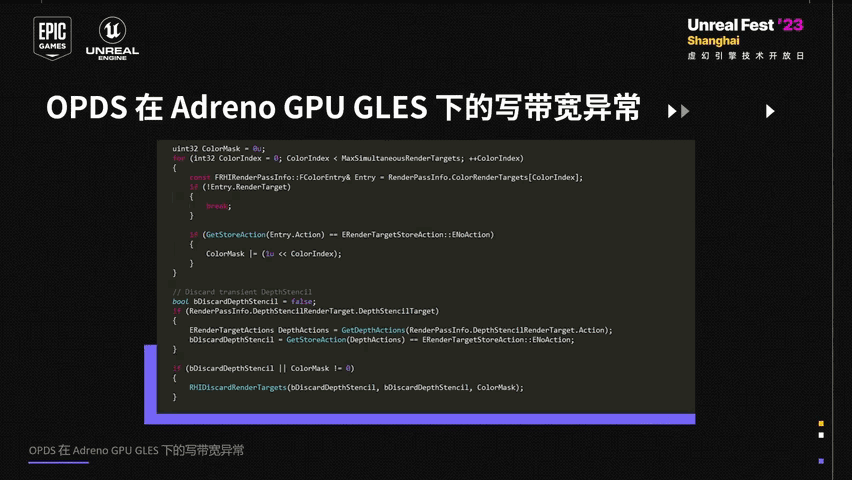
- 高通GPU带宽测试发现UE4.26/4.27 RHI实现bug:discard RT时错误resolve七张RT,UE5已修复
好,这是我们实现完之后测试的一个结果,比较意外地发现了一个比较大的问题。在ARM的Mali GPU上测试时,发现三个灯光pass的指令数非常高,相比苹果和高通的方案高出很多。通过Streamline分析后,发现其实是FPK失效了。这三个灯光pass的FPK值只有0.01兆(图中应该有显示,但可能不太清晰)。进一步测试后,最终确认是device flash的问题。无论在何处使用device flash,无论是one pass deferred还是其他功能,都会导致FPK失效。对比数据显示,关闭device flash后FPK值约为1.2兆,而开启后只有0.01兆,两者相差超过100倍。我们已将数据反馈给ARM团队确认,他们表示在最新驱动(九三零级)中可能已解决该问题。
解决这个问题需要禁用Device Fetch,但禁用后G84的性能又不足。虽然ARM文档中提到支持256位、512位甚至更高位数,但实际测试显示可用位数只有88位。我们又不希望在ARM平台上牺牲画质,因此最终选择了另一条更艰难但更正确的路径。
这是我们最终的方案:采用混合管线,结合one pass deferred、forward卡通渲染和G buffer重新编码。我们将原来的depth信息编码到G buffer中,这是修改后的G buffer结构。由于卡通渲染已转移到前向渲染阶段,GBase不再需要存储相关信息,因此从三种模式减少到两种模式。此外,PBR和NPR中存储的卡券信息也已删除,这些信息原本存储在GBase B中。我们调整了Pass结构,最初考虑是否只需增加一个forward pass,但经过评估发现处理问题过多。如果将角色渲染到半透明层,会导致decal light、water fog和transparency等信息需要在forward pass中重新处理,可能引发排序错误或效果缺失。同时,这会打断one pass流程,增加额外pass导致带宽增加,抵消优化效果。
最终我们将处理逻辑调整到lighting pass之后,只需处理decal和light function,water fog和半透明效果直接在该阶段处理。这部分修改涉及整个渲染管线的重构,耗时较长,但优化效果显著。在Mali GPU测试中,温度平均下降5-6摄氏度,GPU时钟频率下降约25%。
另一个问题出现在高通GPU的带宽测试中。对比One Pass和Multi Pass的带宽时发现,读取带宽节省明显,但写入带宽几乎没有优化。经过排查,发现是引擎RHI实现中的一个bug,该问题存在于UE4.26和4.27版本,UE5已修复。代码中黄色标记的部分仅对SceneColor和Depth生效,若丢弃discard的RT,会将七张RT全部resolve。我们修改后的思路是:根据RT的index判断是否discard。
Slide 10 — 00:22:40
📌 要点汇总
- 实际带宽节省830MB,低于理论预期的1.8G,因Adreno/Marley GPU对RT的高效压缩
- 读取带宽节省超30%,但写入仅10%-15%,显示压缩对读写影响差异显著
- 单帧带宽消耗1.2G-1.3G,但实际应计算为每秒带宽(60帧游戏场景)
- 需注意术语混淆:单帧带宽≠每秒带宽,需根据帧率重新计算总带宽
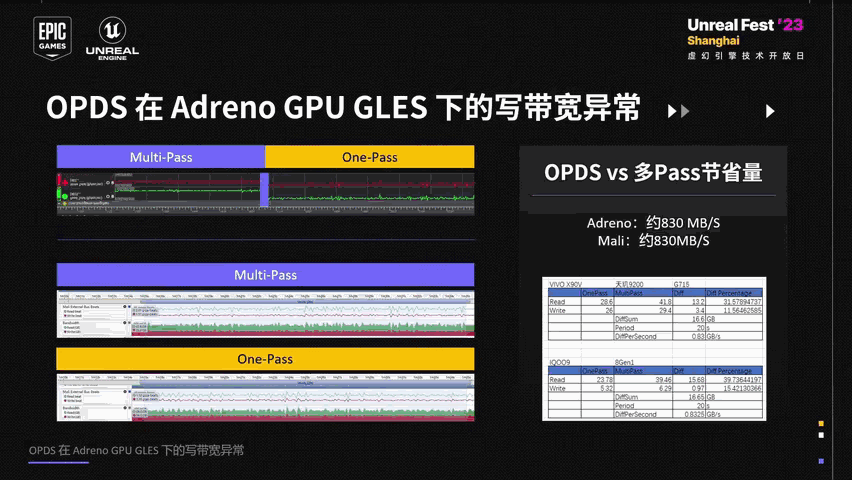
最后也是一个测试性能测试数据。这个测试数据就是我们使用OnePass和MultiPass带宽的测试结果。这个结果实际上比我们预想的要有些令人惊讶。按理说我们觉得应该能节省更多带宽,按照理论计算应该可以节省约1.8G带宽,但实际只节省了约830MB左右。这是因为Adreno和Marley的GPU实际上都会对RT进行压缩,这种压缩效率相当惊人。
大家注意这个数据比较有意思的地方在于,读取带宽节省超过了30%,但写入带宽节省只有10%到15%左右。单帧的带宽消耗非常少,大家可以看到实际只在1.2G到1.3G之间,还不到1.4G。这里需要纠正一下,不是单帧带宽,而是每秒的带宽。我们是60帧的游戏,因此每秒的带宽消耗需要重新计算。
Slide 11 — 00:23:38
📌 要点汇总
- 多平台适配分为打包、加载、运行时三个阶段处理平台差异
- 刚配类数据需独立处理分辨率/码率,否则导致碰撞/贴地失败
- PC/主机近景用模型数,手机近景用BIRBO数,中远景统一用IMPOSE数
- 标波树仅需30-40%面片即可还原慢速效果,但阴影需面向光源渲染
- Imposter树通过312个input buffer离线渲染,内存占用<15MB,GPU消耗<4MB
- IOD切换优化:将blob/input数据嵌入链表,ISM中选最大物体做切换配比
- Imposter树支持场景投影、云层投影,内存占用低且渲染效率高
接下来就是最后一个方案了,就是树的一个双端的方案。我讲的很快。树的方案呢,就是在介绍这个方案之前,我会先简单介绍一下我们多平台的一个适配策略是怎么样子的。然后呢,再会介绍我们树大概是怎么去做多平台的适配,包括怎么去做一些方案的。这是我们的一个多平台适配的一个基本框架。第一部分的想法就比较简单,就是我们多平台其实当做一个平台来处理的这个思路想想其实也没什么问题。比如说我们的PC的高配就等于PS5,然后我们PC的中配比PS的低配要高一点儿,PS4又比手机的高配要高一点儿。因为对平台来说,实际上影响它的因素就只有内存、计算能力(计算能力包含你CPU和GPU的),还有你I/O的性能,以及你的功耗的影响。对于发行来说,还多一条,就是你的包体的大小。那除此之外,其实没有什么东西会影响我们去做多平台适配的。所以我们的主要方案也一般来说也分为三个层面去做处理,就是我们在打包的时候去做一些处理,然后我们在加载的时候去做一些处理,以及我们在运行时去做一些处理。所以后面列了一些主要方案,就是分布到这三个不同的阶段去做的。比如说我们在打包的时候,可以区分一些平台相关性,然后也可以做一些LD bios、MIP bios等等。我们也可以在加载的时候,比如说加载更少的数据,或者是把有些平台相关的东西给过滤掉。我们也可以在运行时去做一些动态的,比如说像那个I/O/D切换、那个缩放等等。但是这里做多平台呢,有一个坑,大家可能要注意到,就是你的刚配类数据一定是需要跟引擎显示以及或者说音视频这些数据的分辨率码率都是要分开的。比如说你把I/O/D做了bios之后的话,你就会发现碰撞可能对不上了,你贴地就完蛋了。你的脚就踩不到地上了!这类似的这种问题,除了碰撞之外,还有其他的,包括寻路一些物理数据都会有些类似的问题。
还有一个好处就是,因为我们这个游戏呢是一个ST,所以我们只关注三五十米之内的这一些跟拍的数据,而不会关注很远。比如说你做的是一款FPS游戏的话,那你可能会需要关注到你的,就比如说你可能一百多米、两百米之外的这些物体,因为它需要开镜。开镜之后,那他需要他的精度是保持的。这是我们的树的一个通的一个方案的一个简介,就是按照平台来分。首先呢,PC和主机来说,我们的近景都是模型数,然后中景呢是BIRBO的数,远景呢是IMPOSE的数。对手手机来说呢,我们的近景呢就已经是BIRBO的数了,然后中远景呢是IMPOSE的数。
第一个就简单介绍一下我的。我们的标波的树是怎么实现的?我们的标波的树的实现基本思路是把原来插片树的每一丛树叶都面向相机的,变成一个标波的来替代。这里左侧呢就是那个标波的树,右侧呢是麦这个Mesh插片树。左图是一个效果对比,右图呢是一个我们大概三角形的一个对比。可以看到我们的统计数据是标波的树大概只要百分之三十到百分之四十的一个面片的占用就可以达到我们慢速的基本的一个效果的还原。
这是一个比较详细的一个效果对比视频,就是我们左侧是比较薄的树,右侧呢是插片树。我们在相机下面前后、左右、上下转动相机,看看效果的对对比是什么样子的。大家可以看到效果其实还是可以的。但是比较波的树有它的问题,这里大家看到了阴影是有问题的,可以看到了,就是因为比较波的树是面向相机的,那它一转动相机的时候,阴影就会跟着转动,这看起来是不能接受的。但这个解决起来也很简单,就是把那个渲染阴影的时候,让那个比较波的面向光源就好了,没有必要去面向相机。
接下来呢,就是介绍我们的imposter树。一个比较常见的错误是认为imposter树就是一个billboard比较,imposter和billboard其实没啥关系。imposter树的基本思路是围绕模型放一圈相机去拍这棵树,然后记录下树的一些基本的渲染信息,就比如说类似于一个mini的G buffer。它渲染的时候呢,再通过相机的方向去采一些最接近当前相机方向的那些离线渲染出来的信息呢,做一些信息的合成,最终生成当。在相机下,它应该出现的那个样子。这是impos树的一个设计目标。大家可以看一下,除了那个着色和形态上我们希望能够还原之外呢,我们还希望它能够支持各式各样的投影,就比如说它自己可以投影到场景里面,然后它也可以接受场景的投影,它也可以支持云层的投影等等。然后同时,我们也希望它内存占用要足够少,除了渲染效率好之外。
这是impos的树的,刚才说的那个离线渲染的input buffer。三百一十二个input buffer,然后加起来一共它的内存实际上就只有小于十五兆,然后四个区块就会可以画出来,面数是小于四万的,然后GPU的一个耗这个消耗也是很小的,GPU core大概是四兆以内就基本上能够满足我们对效果和性能的一个诉求。
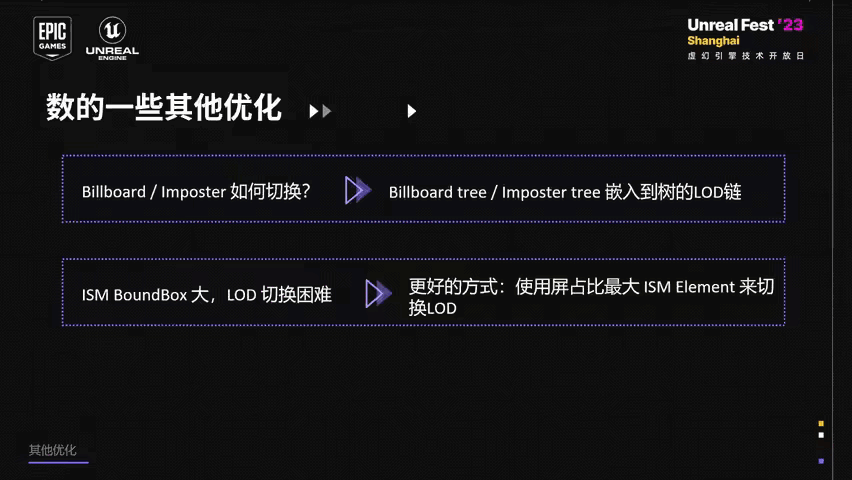
最后还有一些其他的一些优化,就是我们的blob的数和input的数都是直接嵌入到了树的IOD链里面去的,这样的话我们在做IOD切换的时候没有什么外的处理。另外就是我们的一些树是走ISM去做的,因为它模型树在进出还是需要去合批的。那这时候呢,ISM是比较难切IOD的,因为它标那个包的包围盒会比较大。这时候我们做一些优化,就是我们选了一个ISM中最大的那个那个物体来做它的IOD切换的一个一个配比,这样的话IOD切换也会比较快。
好,我的分享今天就到这,谢谢大家。