【GDC 2024】Ray Tracing in Snowdrop Scene Representation and Custom BVH
来源:PDF: GDC 2024 - Ray Tracing in Snowdrop Scene Representation and Custom BVH.pdf Video: GDC 2024 - Ray Tracing in Snowdrop Scene Representation and Custom BVH.mp4
提取时间:2026-05-15 12:00:24
这段内容非常详尽,涵盖了从场景遍历、BVH构建、光线追踪优化、自定义BVH与DXR的对比、实例管理、动画处理、法线计算等多个方面的技术细节,适用于实时渲染引擎开发(如游戏引擎、影视渲染、VR/AR等)。
以下是对这段内容的结构化总结与技术要点提炼,便于理解、复用和进一步开发:
🧩 一、场景遍历与实例收集
1.1 场景四叉树与程序扇区
- 使用四叉树结构来组织场景对象,便于空间剔除和实例收集。
- 程序扇区(Programmed Sectors)用于动态管理实例,支持实时更新。
1.2 实例收集
- 收集所有需要进行光线追踪的实例(包括叶实例、缓存子区域、冒名顶替者扇区等)。
- 实例收集过程中会进行剔除(Culling)以减少不必要的计算。
🧱 二、BVH 构建与优化
2.1 自定义 BVH 构建流程
- 底层 BVH(Leaf Level):
- 在 CPU 上构建,使用快速选项(Fast Build Option)。
- 支持多种边界类型(AABB、Sphere、Cylinder)。
- 用于静态网格和动态对象(如蒙皮角色)。
- 动态对象在 GPU 上进行顶点动画和 BVH 更新。
- 顶层 BVH(Top Level):
- 在 CPU 上构建,使用缓存的子树结构(Subtree Caching)。
- 不使用 GPU 构建顶层,以减少 GPU 负载。
- 支持“多根”(Multi-Root)结构,提升 BVH 遍历效率。
2.2 优化技术
- 多根(Multi-Root):
- 将多个实例组合成子树,提升空间划分效率。
- 减少边界重叠,提升光线追踪效率。
- 性能提升约 10%。
- 堆栈遍历(Stack Traversal):
- 使用 LDS(Local Data Share)和 VGPR(Vector General Purpose Register)混合方式。
- 支持共享堆栈(Shared Stack)用于光通道(Light Traversal)。
- 最大堆栈深度控制在 21-22 项。
- 共享堆栈遍历(Shared Stack Traversal):
- 适用于光通道,提升性能。
- 不对子节点排序,保持遍历顺序一致性。
📊 三、DXR 与自定义 BVH 的对比
| 特性 | DXR | 自定义 BVH |
|---|---|---|
| 构建方式 | GPU 构建 | CPU 构建 |
| 实例管理 | 合并所有实例上传 | 使用缓存子树 |
| 法线计算 | 预计算并存储 | 运行时计算 |
| 动态对象 | 支持,但需额外处理 | 支持,GPU 更新 |
| 性能 | 高(GPU并行) | 稳定(CPU控制) |
| 灵活性 | 低(依赖硬件) | 高(可自定义) |
🧪 四、法线计算与材质管理
4.1 法线计算
- 自定义 BVH:
- 从叶三角形节点读取顶点,使用叉积计算法线。
- DXR:
- 法线预计算并存储在缓冲区中,通过基元索引获取。
4.2 材质与 Vlas
- 每个实例需要自己的 Vlas(Vertex Layout and Shader)。
- 常见 Vlas 类型:
- 剥皮(Skinning):用于蒙皮角色。
- 样条实体(Spline Entities):使用特殊变换着色器。
🔄 五、动态对象与动画处理
- 蒙皮角色(Skinned Mesh):
- 顶点位置在 GPU 上更新。
- 每帧重新调整底层 BVH。
- 样条实体(Spline Entities):
- 使用计算着色器生成变换后的位置。
- 支持动态更新。
🧠 六、性能优化与注意事项
- 堆栈大小限制:
- 最大堆栈深度控制在 21-22 项,避免栈溢出。
- 发散度控制:
- 遍历过程中若发散度过高,可能丢弃光线。
- 共享堆栈遍历:
- 适用于光通道,提升性能。
- LDS 与 VGPR 平衡:
- 使用 LDS + VGPR 混合方式,优化着色器占用率。
📌 七、总结
这段内容展示了一个完整、高效的光线追踪系统,涵盖了从场景管理、BVH构建、光线遍历、动态对象处理、法线计算、性能优化等多个关键环节。
- 自定义 BVH 提供了更高的灵活性和控制力,适用于对性能和渲染质量有高要求的场景。
- DXR 提供了更高效的 GPU 构建方式,适合大规模静态场景。
- 多根结构、堆栈遍历、共享堆栈等技术是提升光线追踪性能的关键。
如果你需要将这些内容用于:
- 技术文档撰写
- 引擎开发参考
- 团队内部培训
- 性能优化方案制定
我可以进一步帮你整理为技术文档、图表、流程图、代码片段等。
是否需要我继续帮你做这些?
Slide 1 — 00:00:57

📌 要点汇总
- 最新一代硬件引入了光线追踪支持,引发了行业内的广泛讨论和期待。
- 尽管存在怀疑,团队仍决定将光线追踪用于GI(全局光照)解决方案,并在原型阶段看到了积极的结果。
- 在完整实现过程中,团队对光线追踪技术进行了扩展和增强,以提升其性能和适用性。
那么,我们谈论的是哪种光线追踪?最新一代的硬件引入了光线追踪支持。炒作是真实的,在那个时候,我们的怀疑与炒作相当成正比。但我们仍然决定尝试将其用于 GI 解决方案,并且最初的原型显示出了希望。
因此,我们继续进行完整的实现,同时将一些内容添加到我们的光线追踪中。
Slide 2 — 00:01:32
📌 要点汇总
- SnellJob 现在支持间接漫反射照明、反射、远距离阴影和音频查询的光线追踪。
- 《阿凡达:潘多拉边境》实现了所有这些光线追踪功能。
- 游戏世界包含广阔风景、动态照明、时间与天气系统,以及大量植被。
- 复杂的环境对光线追踪技术提出了高要求,需优化性能与视觉质量。
我们决定将支持范围扩展到扩散 GI 之外。目前,SnellJob 支持间接漫反射照明、反射、远距离阴影和音频查询的光线追踪。我们在《阿凡达:潘多拉边境》中交付了所有这些内容。
《阿凡达》的世界有广阔而美丽的风景、远景、森林、丛林。如此多的树木和植被,以及动态照明、一天中的动态时间和天气。
Slide 3 — 00:02:07
📌 要点汇总
- 控制台支持 30 FPS 和 60 FPS 模式,所有效果均可运行
- 光线追踪依赖屏幕空间和硬件光线追踪的混合方案
- 没有本机硬件支持光线追踪,依赖光线追踪探测器
- 演讲内容涵盖材质、场景表示及加速结构的构建与使用
- 加速结构在不同平台和 API 上的实现是重点讨论内容
控制台上的 30 FPS 和 60 FPS 模式均支持所有效果。我们在 PC 硬件上支持它,但实际上也没有对光线追踪的本机硬件支持。我们的光线追踪是屏幕空间和硬件光线追踪的混合体,我们也依赖光线追踪探测器。
本演讲涵盖材质和场景表示。我们如何在不同平台和 API 上构建和使用加速结构。
Slide 4 — 00:02:43
📌 要点汇总
- Snowdrop渲染器使用基于节点的架构来描述游戏对象和各种系统。
- 节点图提供了灵活的构建和修改渲染流程的方式。
- 这种架构支持模块化和可扩展性,有助于处理复杂的光照计算。
你们中的许多人可能已经看过另一场关于昆汀·克雷内林(Quentin Crenellin)的关于光线追踪管道中的光照和噪声的演讲,或者如果您没有看过,我建议您去看看。因此,为了了解光线追踪的工作原理以及我们面临哪些挑战,让我们首先概述一下雪花莲网格渲染。
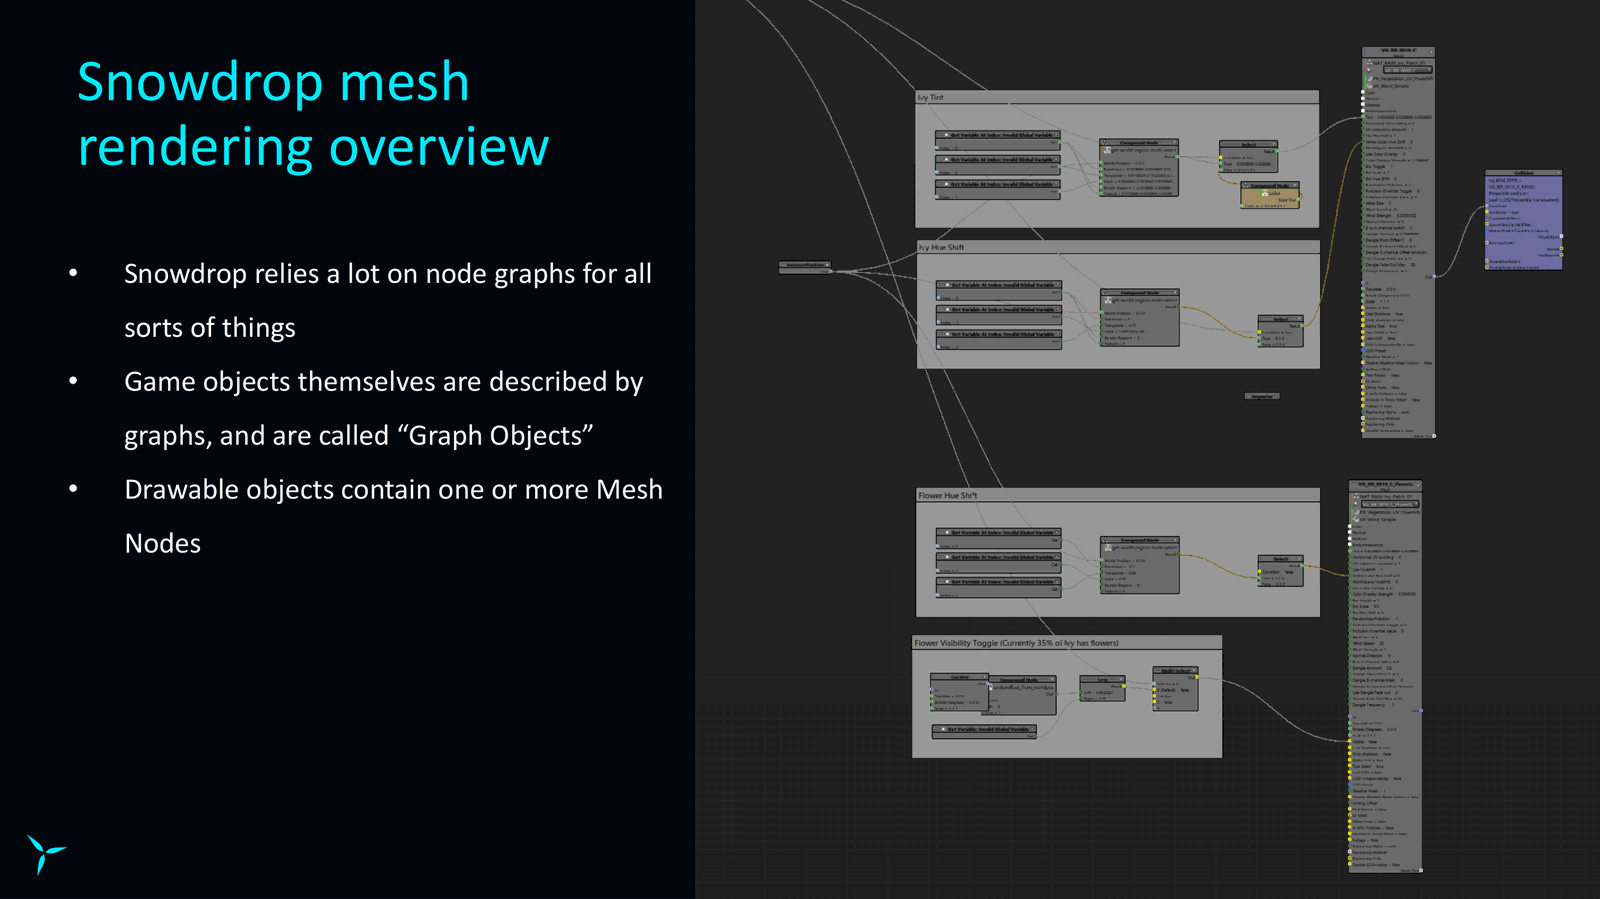
Snowdrop依赖于节点图。对于各种事物,以及游戏对象本身都是通过图来描述的。这种基于节点的架构使得我们能够灵活地构建和修改渲染流程,同时保持系统的模块化和可扩展性。通过这种方式,我们可以更高效地处理复杂的光照计算和渲染任务。
Slide 5 — 00:03:18
📌 要点汇总
- 图形对象用于封装需要在屏幕上绘制的网格节点,通常包含多个节点。
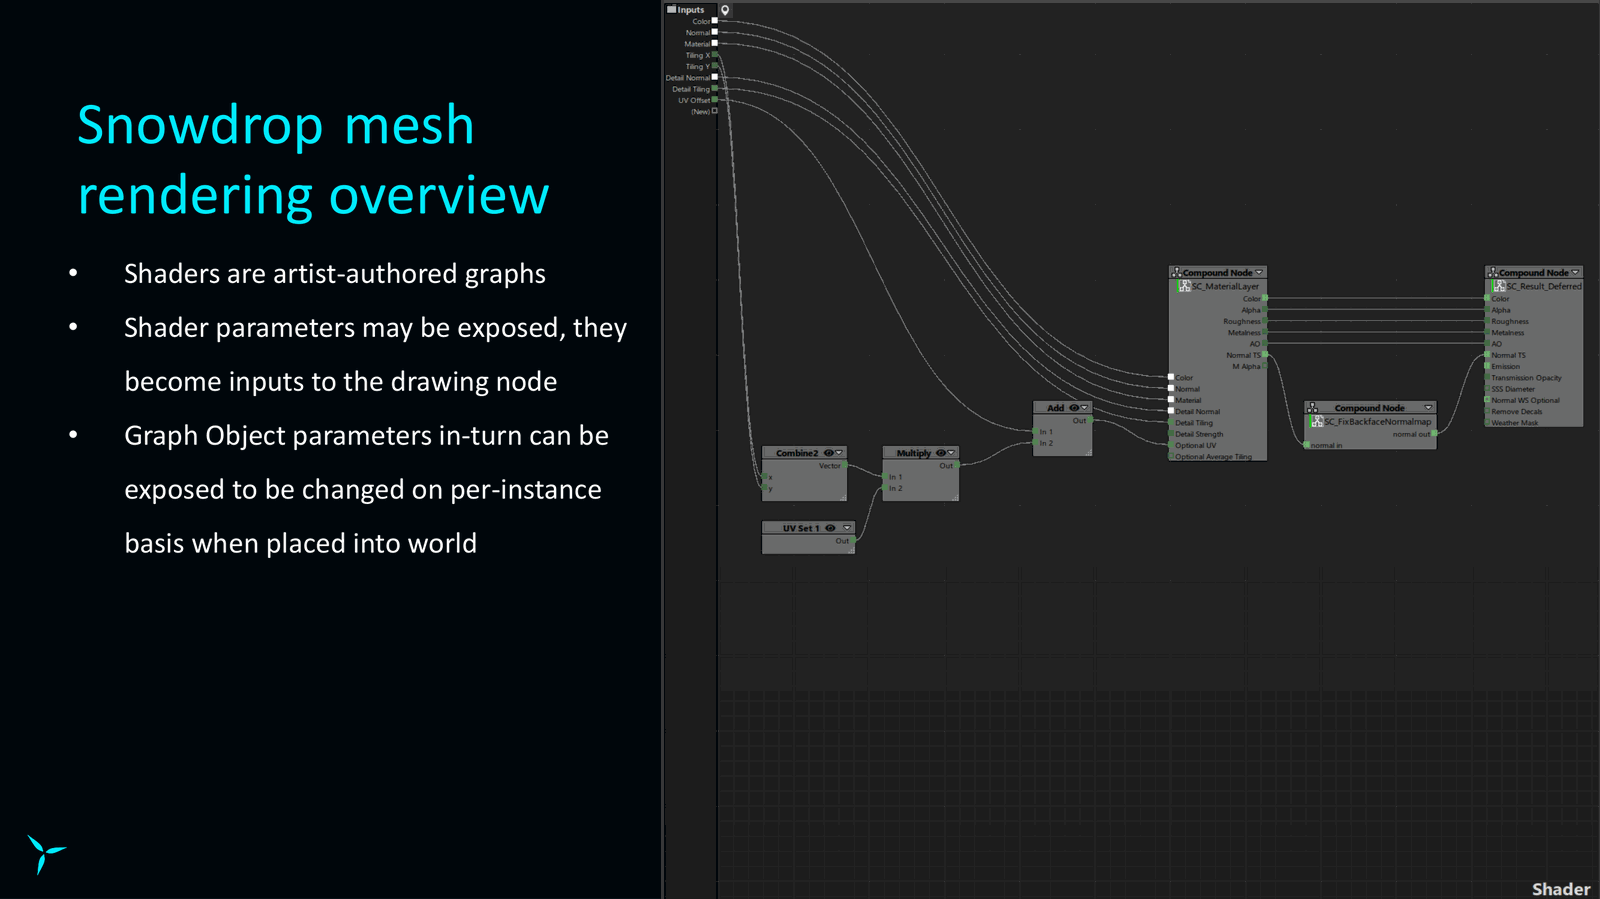
- 网格节点包含着色器参数,这些参数可以由艺术家定义并公开。
- 图形对象通过包含网格节点,将参数暴露给外部,便于控制和调整。
我们灵机一动,决定将它们称为图形对象。如果它们需要在屏幕上绘制一些网格,那么图形对象将包含一个或多个网格节点,并且通常不止一个。
着色器也是图形,它们是由艺术家创作的,并且着色器参数可能会被公开。那么,一个网格节点就会包含我们需要传入的参数,然后图形对象的参数就可以暴露给外界了。
Slide 6 — 00:03:53
📌 要点汇总
- 网格可以手动放置在关卡编辑器中,也可以通过程序化方式放置。
- 程序化布局使用图表描述逻辑,并使用专用 GPU 驱动的管道实现。
- 手动放置网格使用基于 Quatrefoil 系统的 CPU 管道。
- 渲染支持广泛,涵盖多种放置方式和管道实现。
例如,我们可以在关卡编辑器中手动放置网格,也可以按程序放置网格。程序布局也使用图表来描述其逻辑。我们有一个特殊的 GPU 驱动的管道,用于按程序放置网格。
手工放置的网格遵循基于 Quatrefoil 系统的更传统的 CPU 管道。我们还对渲染提供广泛的支持。
Slide 7 — 00:04:29
📌 要点汇总
- 远处物体使用代理网格合并多个节点以提高渲染效率
- 使用简化材质和烘焙深度信息增强视觉体积感
- 采用传统广告牌冒名顶替者技术优化性能
- 光线追踪技术结合上述方法实现高效渲染
远处的物体最后加载,将多个网格节点合并为一个,并使用简化的材质立即渲染。代理网格将整个地标的大量对象组合到一个网格中。我们还使用了冒名顶替者,这是传统的广告牌冒名顶替者。我们确实添加了烘焙的深度信息,以增加它们的体积。因此,通过对光线追踪的广泛概述,我们使用了上述方法。
Slide 8 — 00:05:04
📌 要点汇总
- 修复了光线追踪世界中几何图形的低级别细节,依赖每个网格的平均材质。
- 仅使用 DXR 1.1 的内联跟踪功能,无需更高级别的特性。
- 为不支持光线追踪的控制台和 PC 硬件实现了自定义的 BVH。
- 通过简化材质处理和自定义 BVH,确保了跨平台兼容性。
较低级别的细节,修复了光线追踪世界中几何图形的较低级别细节。我们依赖于每个网格的平均材质,因此我们只需要 DXR 1.1 的内联跟踪功能。此外,我们还为不支持光线跟踪的控制台和 PC 硬件实现了自定义的 BVH。
现在我要从一个主题跳到另一个主题,但我想也许如果我给它一些背景信息,它会更完整一些。
Slide 9 — 00:05:40
📌 要点汇总
- 更高效的加速结构如 BVH 被引入,提升光线追踪性能和精度
- 硬件加速如 NVIDIA RT Core 提升光线追踪效率,支持实时光线追踪应用
- 材质模型需处理微表面和各向异性反射,以提升视觉真实感
- 实现中需处理光线相交失败和 BVH 构建错误,确保系统稳定性
- 场景遍历和自定义 BVH 的区别影响光线追踪性能和实现方式
可以理解为什么。因此,我们首先大致讨论一下场景遍历。然后我们描述定制 BVH 的工作原理。现在回到更详细的场景遍历,我们可以检查 DXR 和自定义 BVH 之间的区别。之后,我们跟进材料,讨论不同的优化和技巧,也许还有途中的错误。
那么,光线追踪世界中添加了什么?我们引入了更高效的加速结构,例如 BVH(Bounding Volume Hierarchy),以及更精细的光线-物体相交算法。这些改进使得光线追踪能够在更复杂的场景中实现更高的性能和更精确的渲染结果。
此外,现代光线追踪技术还引入了基于硬件的加速,例如 NVIDIA 的 RT Core,它能够显著提升光线追踪的计算效率。这些硬件特性与软件算法相结合,使得实时光线追踪成为可能,并在游戏和影视制作中得到了广泛应用。
在材料方面,我们不仅需要考虑基础的反射和折射属性,还需要处理更复杂的材质模型,如微表面模型和各向异性反射。这些模型能够更真实地模拟现实世界中的表面特性,从而提升渲染的视觉质量。
在实现过程中,我们还需要处理各种错误和异常情况,例如光线与场景中物体的相交计算失败,或者 BVH 构建过程中出现的结构不一致问题。通过合理的错误处理机制,可以确保光线追踪系统在各种复杂场景下都能稳定运行。
Slide 10 — 00:06:15
📌 要点汇总
- 《阿凡达》场景中光线追踪的半径范围设定为4公里,用于确定参与光线追踪的对象范围。
- 默认情况下,所有静态网格物体自动参与光线追踪,而皮肤网格或需要实例独立处理的网格则被排除。
- 艺术家可手动覆盖默认设置,使特定网格参与光线追踪,以满足项目需求。
- 该设置提供灵活性,有助于在复杂场景中平衡性能与视觉质量。
- 合理配置光线追踪设置可显著提升渲染效率并保持高质量视觉效果。
以半径范围遍历场景,对于《阿凡达》来说,半径为四公里。添加我们认为与光线追踪相关的所有内容。是否添加网格的逻辑取决于艺术家的设置,默认情况下,所有网格都设置为自动光线追踪。具有此设置的静态网格物体会自动添加到世界中,但皮肤网格物体或需要每个实例的网格物体,由于某种原因会被自动排除,艺术家可以覆盖这一设置。
在实际应用中,这种设置允许艺术家根据具体需求调整哪些对象参与光线追踪,从而在性能和视觉效果之间取得平衡。如果艺术家希望某个特定的网格物体参与光线追踪,即使它是皮肤网格或需要每个实例独立处理的网格,也可以手动覆盖默认设置,确保其被正确添加到光线追踪系统中。
这种灵活性对于复杂场景的渲染尤为重要,尤其是在涉及大量动态对象或需要精细控制光照效果的项目中。通过合理配置这些设置,可以显著提升渲染效率,同时保持高质量的视觉表现。
Slide 11 — 00:06:50
📌 要点汇总
- 光线追踪世界需要区分透明和不透明网格,图形处理只关注不透明网格,而音频查询需考虑透明度。
- 透明网格被屏蔽图形效果,但保留用于音频处理,以满足不同需求。
- 通过检查场景四叉树添加手工放置的网格,确保所有相关网格被正确识别和处理。
- 为提高效率,构建网格列表以支持缓存优化,实现高效管理和访问。
在光线追踪世界中,我们需要强制启用或禁用网格。我们只对图形中不透明的网格感兴趣,但音频查询需要考虑透明度。因此,我们也向光线追踪世界中添加了透明度,但这些透明网格会被屏蔽掉所有图形效果。
我们通过检查场景四叉树来添加所有手工放置的网格。由于我们高度依赖缓存,因此我们构建了一个列表,以确保能够高效地管理和访问这些网格。
Slide 12 — 00:07:26
📌 要点汇总
- 每个四叉树节点的光线追踪实例仅创建一次,以提高性能
- 实例在每帧遍历中被重用,减少重复计算
- 仅当单元被外部系统监控时,才会清除并重新生成实例列表
- 若内容被更新或移动,会检查特殊扇区并重新构建实例列表
- 进入扇区流后,会随机修剪部分网格体以优化性能
每个四叉树节点的光线追踪实例只进行一次。然后,我们在每次遍历、每帧上重用这个实例,并且只有在单元被外部系统监控时,才会清除列表并重新调用。因此,如果有任何内容被更新或移动,我们还会检查那些按程序放置的网格体所处的特殊扇区,并且我们只需要在该扇区中构建实例列表。一旦进入该扇区流,我们还会从中随机修剪一些网格体。
Slide 13 — 00:08:01
📌 要点汇总
- 程序部分通过启发式方法减少光线追踪世界中的实例数量,较小网格因实例化次数多更易被修剪。
- 地形不使用三角形表示,而是直接在相交例程中使用射线的
March.Height字段进行处理。 - 天空渲染作为光线追踪世界的一部分,与网格和地形共同构成完整场景。
程序部分是为了避免光线追踪世界中出现过多的实例,我们遵循一些启发式方法来做到这一点。因此,实例化次数较多的较小网格被修剪的机会较高,而较大网格被修剪的机会较低。
我们在光线追踪世界中也有一些非网格实体。地形没有三角形表示,相反,我们直接在相交例程中使用射线的 March.Height 字段。
我们还渲染天空。
Slide 14 — 00:08:36
📌 要点汇总
- 使用低分辨率八面体纹理和体积云光线行进技术实现光线追踪的漫反射部分
- 反射部分使用环境贴图作为回退方案,以避免细节丢失
- 添加冒名顶替者以支持超出 Cascada 阴影贴图范围的遥远太阳阴影
- 需要光源来照亮命中点,但当前方案无法使用光源实现
低分辨率八面体纹理,还包括体积云的光线行进,这用于光线追踪的漫反射部分。对于反射,我们会回退到环境贴图以防丢失。
我们还在光线追踪世界中添加了冒名顶替者,以支持遥远的太阳阴影,这些阴影超出了我们的 Cascada 阴影贴图范围。
我们需要添加光,用某些东西来照亮我们的命中,但我们不能使用。
Slide 15 — 00:09:12
📌 要点汇总
- 使用单独的 BVH 加速结构来处理屏幕外的光线照射,提高光线追踪效率
- 根据光线范围构建盒子,并将这些盒子组合成 BVH 以优化光线与物体的相交检测
- 在照明过程中使用短光线模拟点与盒子的相交,减少计算开销
- 自定义 BVH 的构建方式有助于提升复杂场景下的渲染性能
正面灯光的光线通过,由于我们的光线照射可以在屏幕之外,所以我们为光线建立了一个单独的 BVH 加速结构。因此,我们根据光线的范围形成盒子,然后将所有这些盒子组合成一个 BVH。然后我们在照明过程中使用非常短的光线来模拟点盒相交。
现在我们准备讨论自定义 BVH。
Slide 16 — 00:09:47
📌 要点汇总
- The need for a software solution arose due to the experimental nature of console APIs for ray tracing in early stages.
- The software allows ray tracing on hardware that does not natively support it, ensuring broader compatibility.
- It provides flexibility for future optimizations and performance improvements.
- A standalone approach was chosen to ensure independence from hardware limitations and experimental APIs.
第一个问题是,我们为什么拥有它?答案是,在早期,当我们想尝试光线追踪的一些东西时,控制台 API 是高度实验性的,我们希望立即运行一些东西。我们还想要一个软件版本来支持实际上不支持光线追踪的硬件,并且某些优化是可能的。通过客户方法,我希望会介绍其中的一些。
所以,我们决定开发一个独立的软件解决方案,以确保光线追踪技术能够在更广泛的硬件上运行,并为未来的优化打下基础。这个软件不仅能够兼容不支持光线追踪的硬件,还能为后续的性能提升提供灵活性和扩展性。
Slide 17 — 00:10:23
📌 要点汇总
- 自定义 BVH 构建需基于 RDNA2 指令集中的 TMH BVH 相交射线指令
- BVH 节点需符合特定格式,软件可完全模拟该指令实现功能
- 实现过程中需确保 BVH 结构与硬件指令兼容以保证性能
为了构建自定义 BVH,我们需要知道需要支持什么。自定义 BVH 是围绕控制台上可用的硬件交叉指令构建的,您可以在 RDNA2 指令集中查找它。它称为 TMH BVH 相交射线。
它需要某种格式的 BVH 节点,而我们的工作就是提供适合该格式的 BVH。并且我们可以在软件中完全模拟该指令。
Slide 18 — 00:10:58
📌 要点汇总
- BVH节点由类型和索引组成,包含三角形节点和框十六/框三十二内部节点
- 框十六使用16位浮点数,框三十二使用32位浮点数,后者精度更高但占用更多内存
- 精度提升对性能要求高的场景可能至关重要,但会增加内存消耗
- 开发者需根据内存限制和精度需求选择合适的节点类型
- 选择不同节点类型会影响内存占用和访问效率,需权衡性能与资源消耗
这为我们提供了完整的功能对等,但性能显然有所下降。BVH中的节点由节点指针引用,这些节点由类型和节点索引组成。有多种节点类型,其中显然包括三角形节点,而三角形节点实际上可以包含多个三角形。此外,还有框十六或框三十二的内部节点,它们指向子节点。十六或三十二代表浮点精度。
在构建BVH时,选择不同的节点类型会影响内存占用和访问效率。框十六使用16位浮点数来表示包围盒,而框三十二使用32位浮点数,后者虽然占用更多内存,但可以提供更高的精度和更准确的包围盒。这种精度的提升在某些对性能要求较高的场景中可能是必要的。
在实际应用中,开发人员需要根据具体需求权衡精度与性能之间的关系。对于内存受限的设备,使用框十六可能是更优的选择;而对于需要高精度计算的场景,框三十二则更为合适。这种灵活性使得BVH结构能够适应多种不同的应用场景。
Slide 19 — 00:11:33
📌 要点汇总
- 内部节点包含四个边界框和四个子节点指针,交集指令可同时处理内部节点和三角形节点
- 存在一种特殊节点类型称为用户节点,用于指向实例数据并包含指向网格底层 BVH 的指针,支持构造操作
绑定存储。内部节点包含四个边界框和四个指向相应子节点的指针。因此,交集指令接受节点指针,并且它可以以相同的方式作用于内部节点和三角形节点。
还有一种特殊的节点类型称为用户节点,我们可以使用它来指向实例数据,并且该实例数据可以包含指向网格的底层 BVH 的指针,这允许我们进行构造。
Slide 20 — 00:12:09
📌 要点汇总
- 使用两级 BVH 结构来优化碰撞检测和光线追踪性能
- BVH 的底层和顶层分别处理不同层次的细节和范围
- CPU 上离线构建 BVH,通过定期烘焙所有网格资源实现
- 运行时优先加载烘焙的 BVH,失败或版本不匹配时动态构建
典型的两级 BVH 结构。所以现在我们需要处理 BVH 的底层和顶层,并且由于我们知道 BVH 的格式,因此我们可以在 CPU 上离线构建它。我们通过对所有网格资源进行定期烘焙过程来实现这一点。
在运行时,我们首先尝试加载烘焙的 BVH。如果加载失败,或者可能存在版本不匹配,我们可以构建一个。
Slide 21 — 00:12:44
📌 要点汇总
- A special fast option in a background thread skips triangle splitting and other performance optimizations, resulting in faster BVH construction at the cost of lower quality.
- High-quality BVH construction relies on surface area heuristic (SAH), which has been extensively studied and optimized in prior research.
- Efficient BVH building requires careful implementation of SAH to balance quality and performance.
在具有特殊快速选项的后台线程中,该选项没有三角形分割和其他一些性能调整,以使其在 BVH 质量降低的情况下更快。
为了构建高质量的 BVH,我们依靠表面积启发法。对此有很多广泛的研究,并且已经有很多工作来实现高效的构建过程。
Slide 22 — 00:13:19
📌 要点汇总
- 三角形分割允许多个边界框引用同一三角形,提升灵活性。
- 该方法减少细长三角形的边界面积,优化性能。
- 这是 PVH 的一项关键改进,带来显著积极影响。
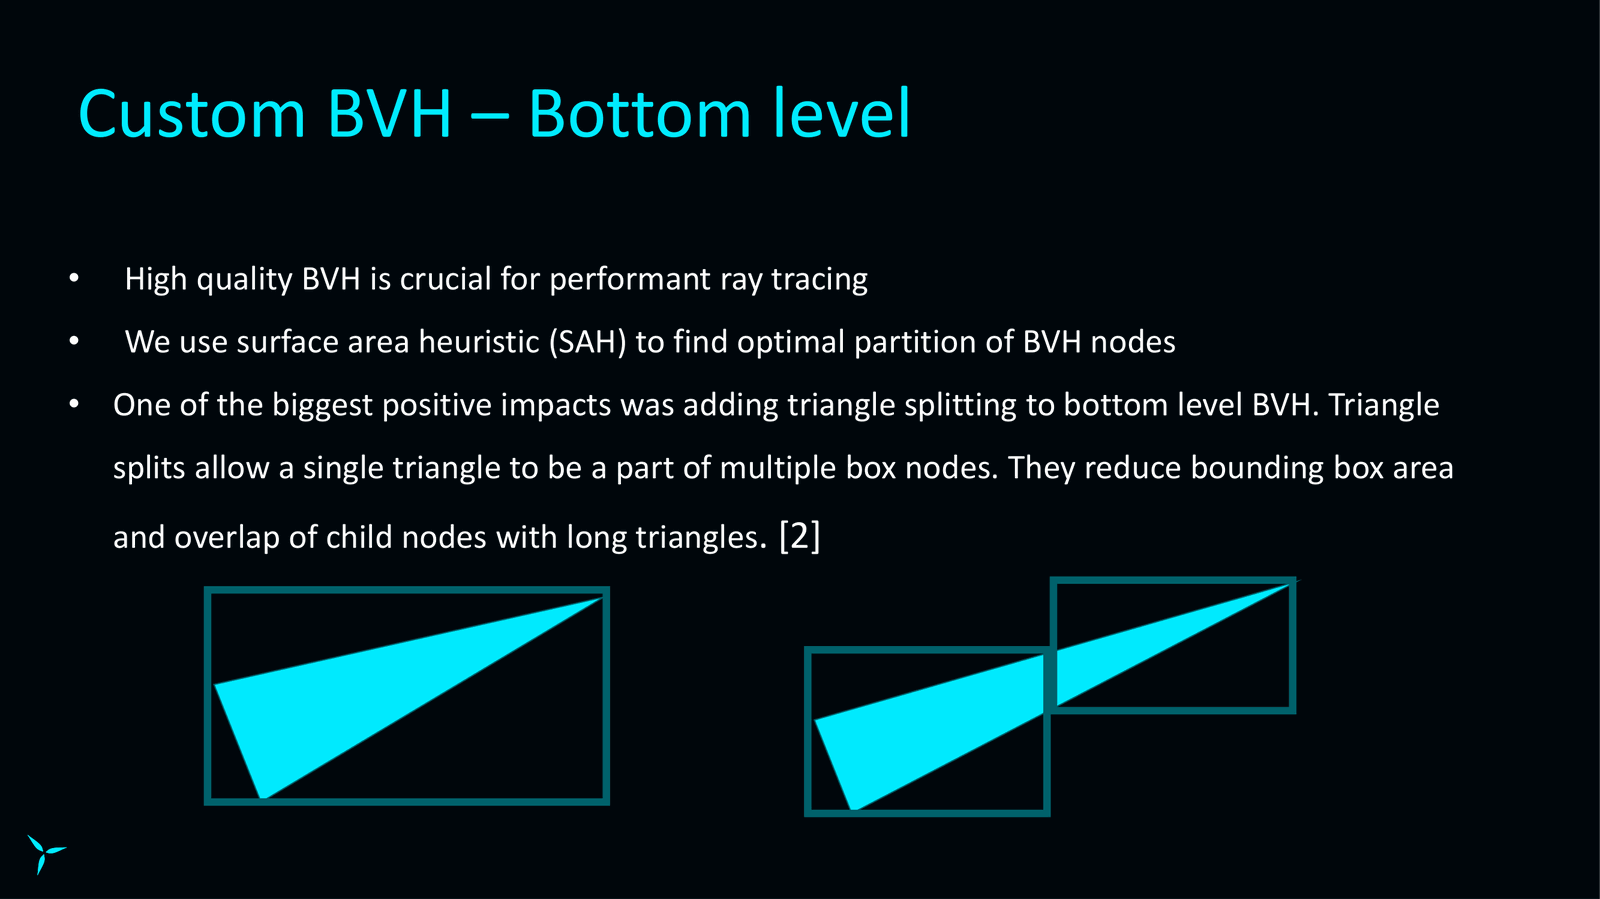
PVH,有很多东西要谈,但我只想关注我们拥有的最大的积极影响之一,那就是在底层 PVH 中添加三角形分割。
三角形分割本质上不是只允许一个边界框覆盖整个三角形,而是实际上可以有多个引用同一三角形的边界框,这使我们能够减少细长三角形的边界面积,所以。
Slide 23 — 00:13:55
📌 要点汇总
- 跟踪性能在使用快速构建底层 BBH 时比离线构建提升了 5% 到 10%
- 离线版本的性能现已达到行业顶级水平
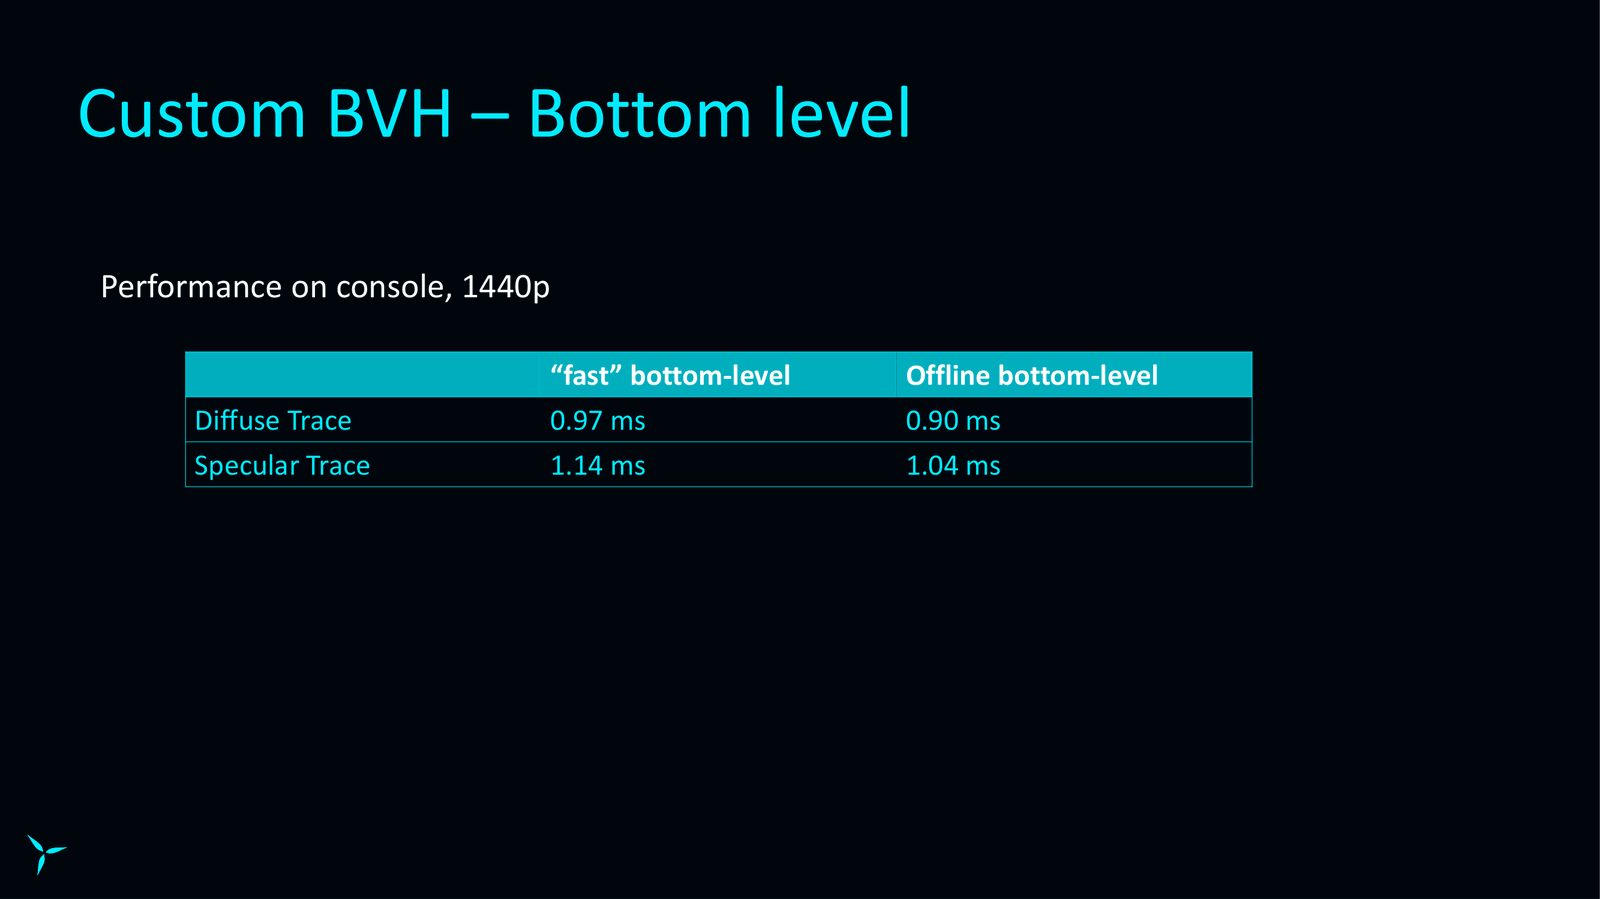
如果我们采取某个场景,某个随机场景,并将跟踪通道的性能与使用离线构建底层 BBH 或使用快速构建底层 BBH 时的性能进行比较,我们可以看到跟踪性能提高了 5% 到 10%。
使用离线版本,现在达到了顶级。
Slide 24 — 00:14:30
📌 要点汇总
- 使用 CPU 的快速选项构建每一帧的顶级 BVH,而非 GPU
- 通过将叶实例缓存到子树中,减少每帧处理的实例数量
- BVH 构建过程从单个实例开始,逐步组合边界形成层次结构
- BVH 的根节点为一个盒子根节点,用于封装整个场景的边界
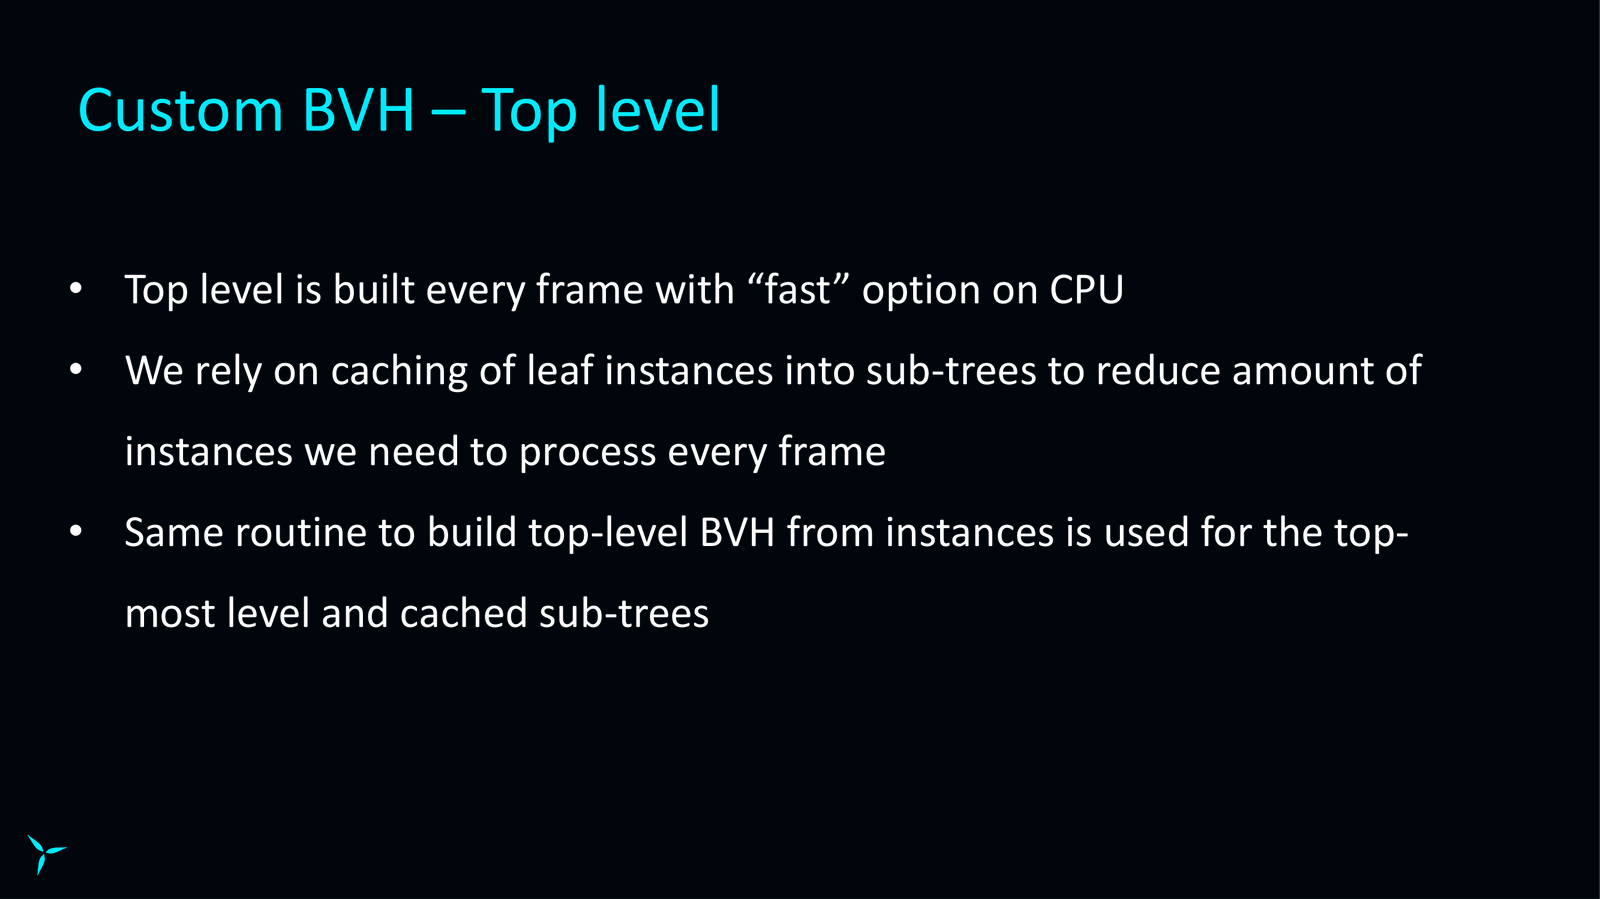
我们使用已经在 CPU 上提到的快速选项来构建每一帧的顶级 BVH。我们不使用 GPU 来构建顶级 BVH。我们依靠将叶实例缓存到子树中,以减少处理每帧所需的实例数量。
因此,如果我们考虑如何构建 BVH,我们首先有一个实例。该实例形成边界,然后我们将这些边界组合到 BVH 中。在该 BVH 的根处,我们有一个盒子根节点。
Slide 25 — 00:15:06
📌 要点汇总
- 该框根节点被视为边界实例,用于构建顶级 BVH。
- 通过构建子树代替存储实例列表,提升空间划分效率。
- 子树结构优化了碰撞检测性能,减少计算开销。
- 利用边界实例构建 BVH 是一种高效的空间组织方法。
本质上,该框根节点也只是边界,我们可以将其视为一个实例。我们实际上可以利用这些界限,并从中构建顶级 BVH,假装这些是实例。所以我们就是这么做的。
我们构建 BVH 的子树,而不是存储实例列表来构建顶层。我们将这些实例组合成一个子树,并且这样可以更高效地进行空间划分和碰撞检测。
Slide 26 — 00:15:41
📌 要点汇总
- Store individual fake instances in a list during tree traversal for manually placed quadtree nodes.
- When nodes are marked as “dirty,” collect and merge instances into subtrees.
- Similar process is applied to program-placed text nodes.
- This approach ensures efficient management and updating of quadtree structures.
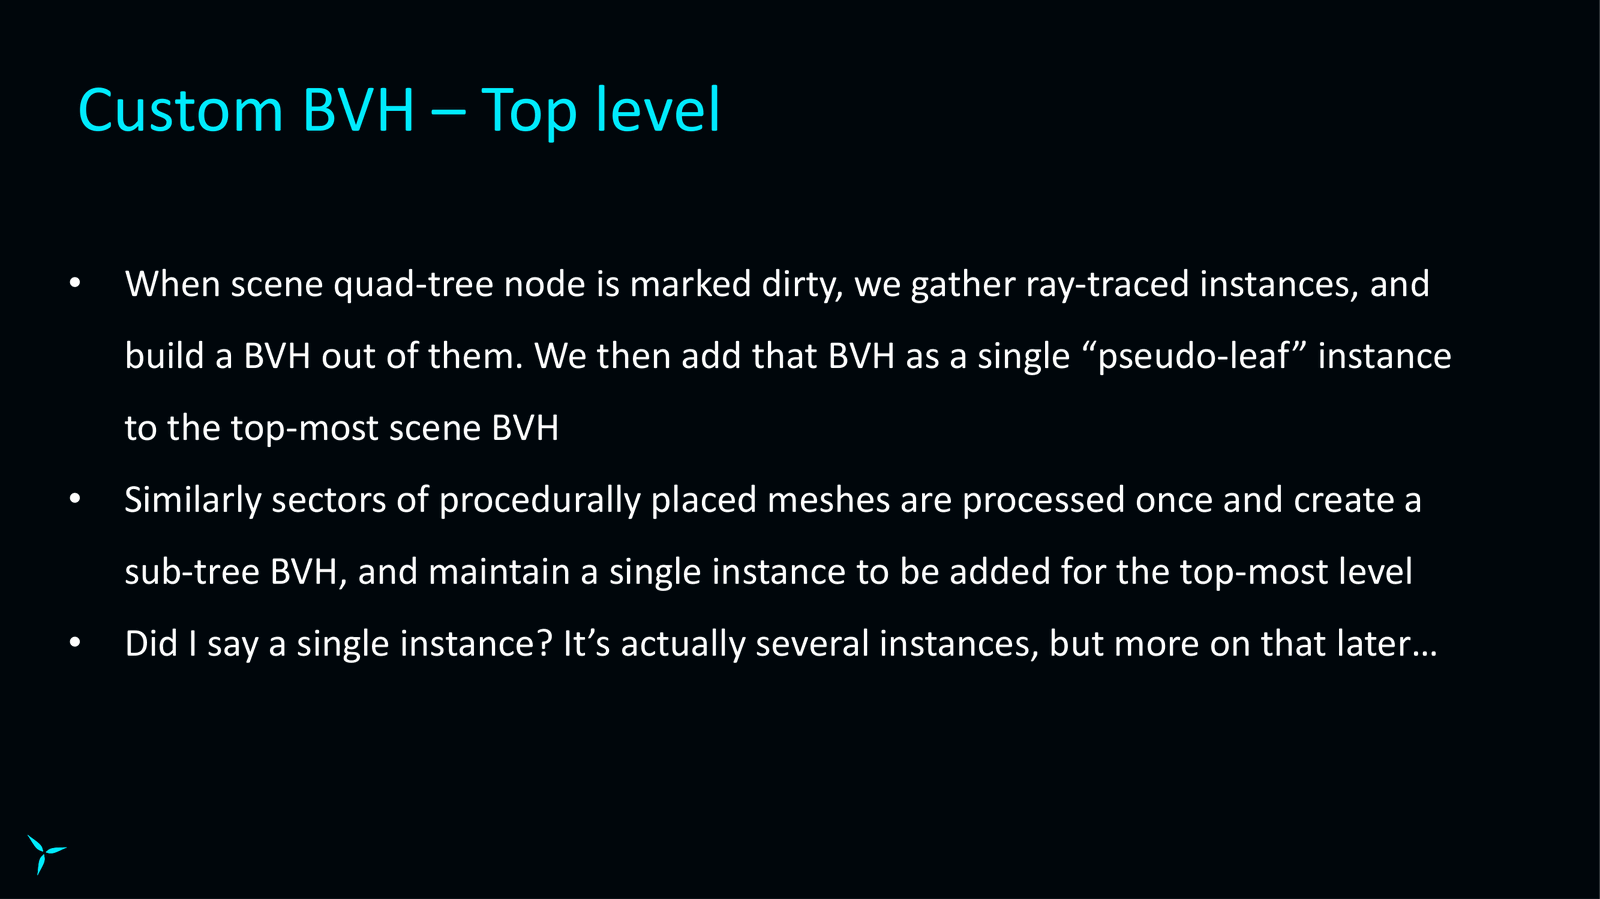
相反,将单个假实例存储在列表中。这就是这里描述的过程。我们在遍历树时,对手动放置的四叉树节点执行此操作。当它们被标记为“脏”时,我们需要收集实例,将它们组合起来,并将它们合并到子树中。我们对程序放置的文本执行类似的操作。
Slide 27 — 00:16:16
📌 要点汇总
- 实例转换时,边界处理需谨慎以减少性能影响
- BVH 构建时存储轴对齐边界框、球体和圆柱体边界以提高准确性
- 实例列表并非总是单个实例,可能包含多个实例,后续将详细说明
再次,我们在它们流入时执行一次。我一直说我们将实例列表交换为单个实例。这实际上不是真的。可能有多个实例,但稍后会详细介绍。
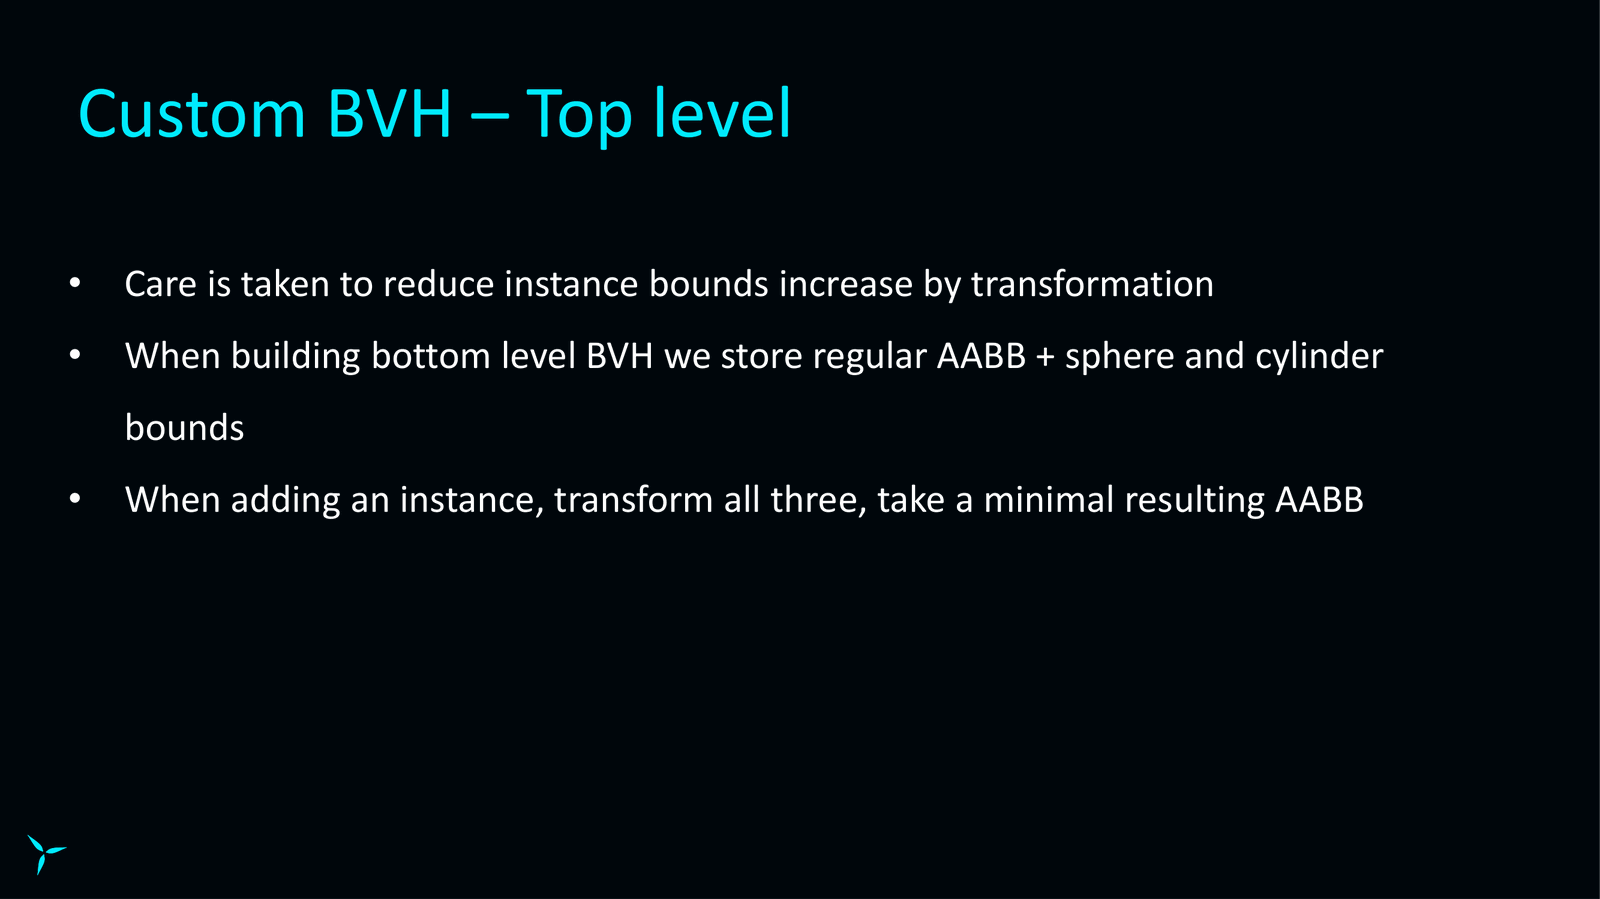
我们小心地减少因实例转换而增加的实例边界。因此,在构建底层 BVH 时,我们存储常规的轴对齐边界框,但我们也存储球体和圆柱体边界。
Slide 28 — 00:16:52
📌 要点汇总
- 当添加实例到顶层时,所有三个实例都会被转换,并从中提取最小结果边界框。
- 皮肤网格的改装需要特殊处理,在 BVH 构建过程中存储每个层级的元信息。
- 零级 BVH 对应顶点层级,每个顶点存储需要更新的位置数据的偏移量。
当将实例添加到顶层时,我们会转换所有三个实例。我们从这三个中取出一个最小的结果边界框。我们还需要以某种方式处理皮肤网格的改装。因此,在皮肤网格的 BVH 构建过程中,我们存储每个 BVH 级别的元信息。
因此,零级是顶点的级别。对于每个顶点,我们存储需要更新的位置数据的偏移量,并且。
Slide 29 — 00:17:27
📌 要点汇总
- 内部框节点的地址存储在框边界数据中,需在更新时同步修改
- 顶点动画的位置计算在 GPU 的临时缓冲区中执行
- BVH 位置更新后,逐级重新计算框边界以保持准确性
- 所有操作在 GPU 上执行,从顶级节点开始处理以确保效率
对于第一级及以上级别,这些是内部框节点,我们将框的地址存储到框边界数据中。这也需要更新。
在运行时,我们将皮肤或顶点动画的位置计算到 GPU 上的临时缓冲区中。我们首先更新 BVH 中的位置,然后逐级重新调整框边界。
所有这些都在 GPU 上运行,自顶级开始。
Slide 30 — 00:18:02
📌 要点汇总
- The system is built on top of the CPU and lacks certain information, requiring modifications at higher levels.
- Each instance needing modification is marked at the top level, and metadata is stored during the build process.
- Once lower-level modifications are complete, all top-level modifications are executed.
- Optimization strategies are now being discussed, focusing on improving performance and efficiency.
实际上是建立在 CPU 上的,并且它没有这些信息。我们需要继续并在顶部的各个层面推广改装。因此,每当我们有一个实例需要改装时,顶层也会标记它需要改装,并且在构建过程中存储与我刚才谈论的相同的元信息。一旦所有底层改装完成,我们现在运行所有顶层。
现在让我们谈谈一些优化。所以。
Slide 31 — 00:18:38
📌 要点汇总
- Adding instances directly to BVH may not always be optimal due to potential overlaps and inefficiencies in ray tracing.
- Using a binary tree structure with diagonal sub-boundaries can lead to undesirable overlaps and reduced performance.
- Treating child nodes as separate instances allows the top-level builder to make more efficient decisions and improve BVH construction.
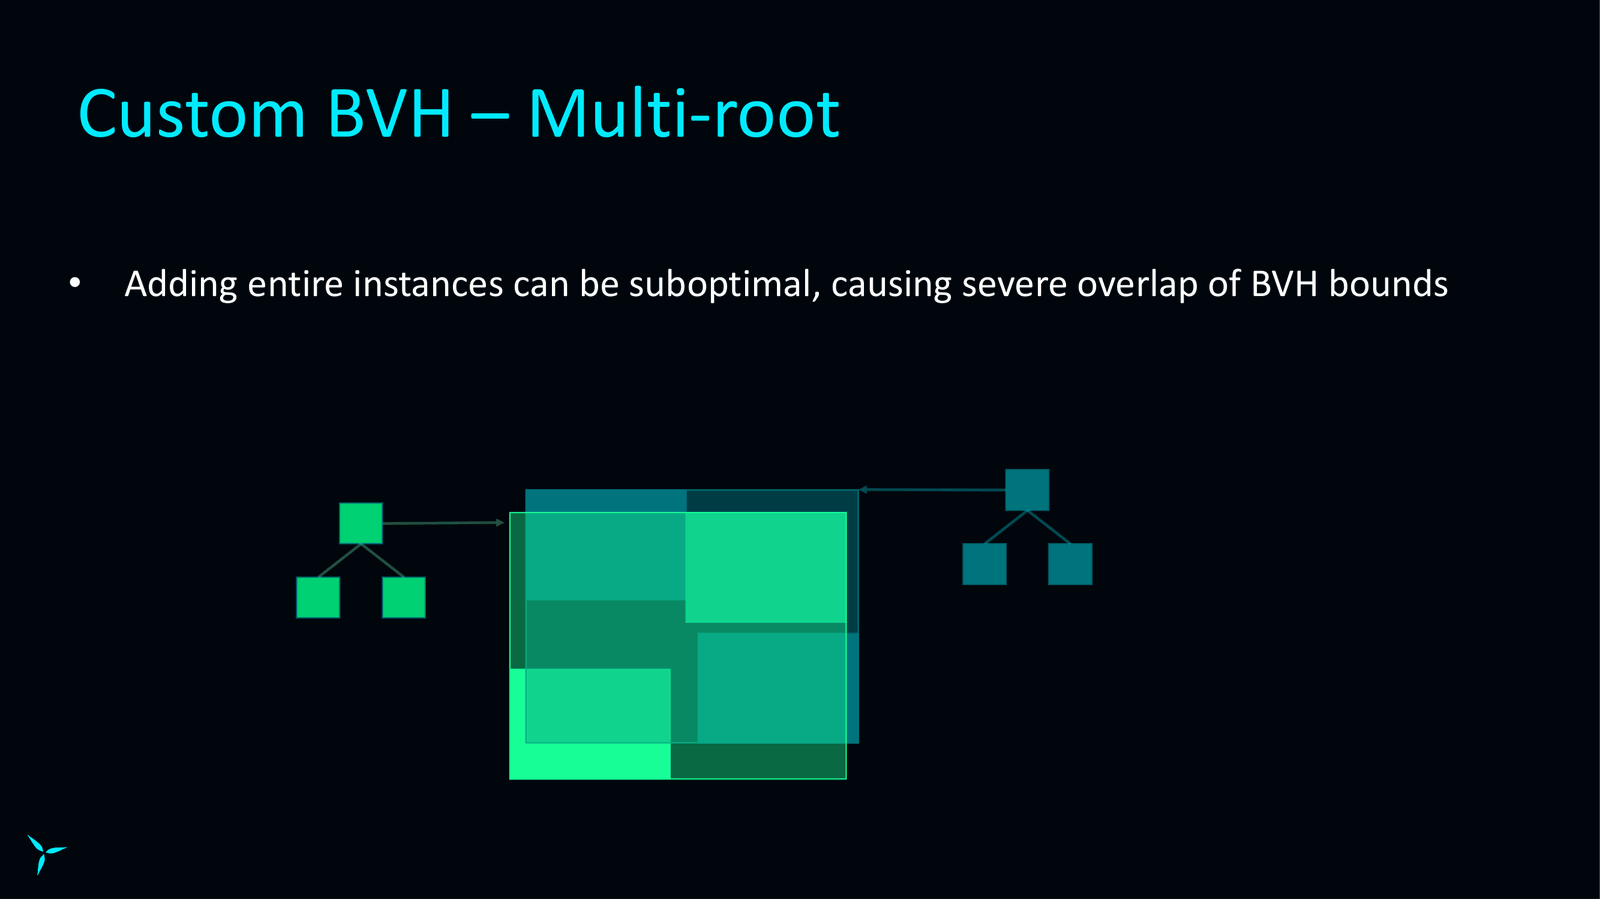
如果我们只是将实例添加到 BVH,有时这可能不是最佳的。因此,如果我们在这里简化并使用二叉树,再加上想象一些具有彼此对角线的子边界的对象,我们可能会出现一些令人讨厌的重叠,从而降低光线跟踪效率。
因此,如果我们取树的子节点,将它们添加为单独的实例,那么我们的顶级建造者就有更好的机会建造。
Slide 32 — 00:19:13
📌 要点汇总
- 提出了一种更高效的 BVH 构建方法,称为“多根”方法,与论文“Improved Two-Level BVHs using Partial Rewriting”类似但更简化
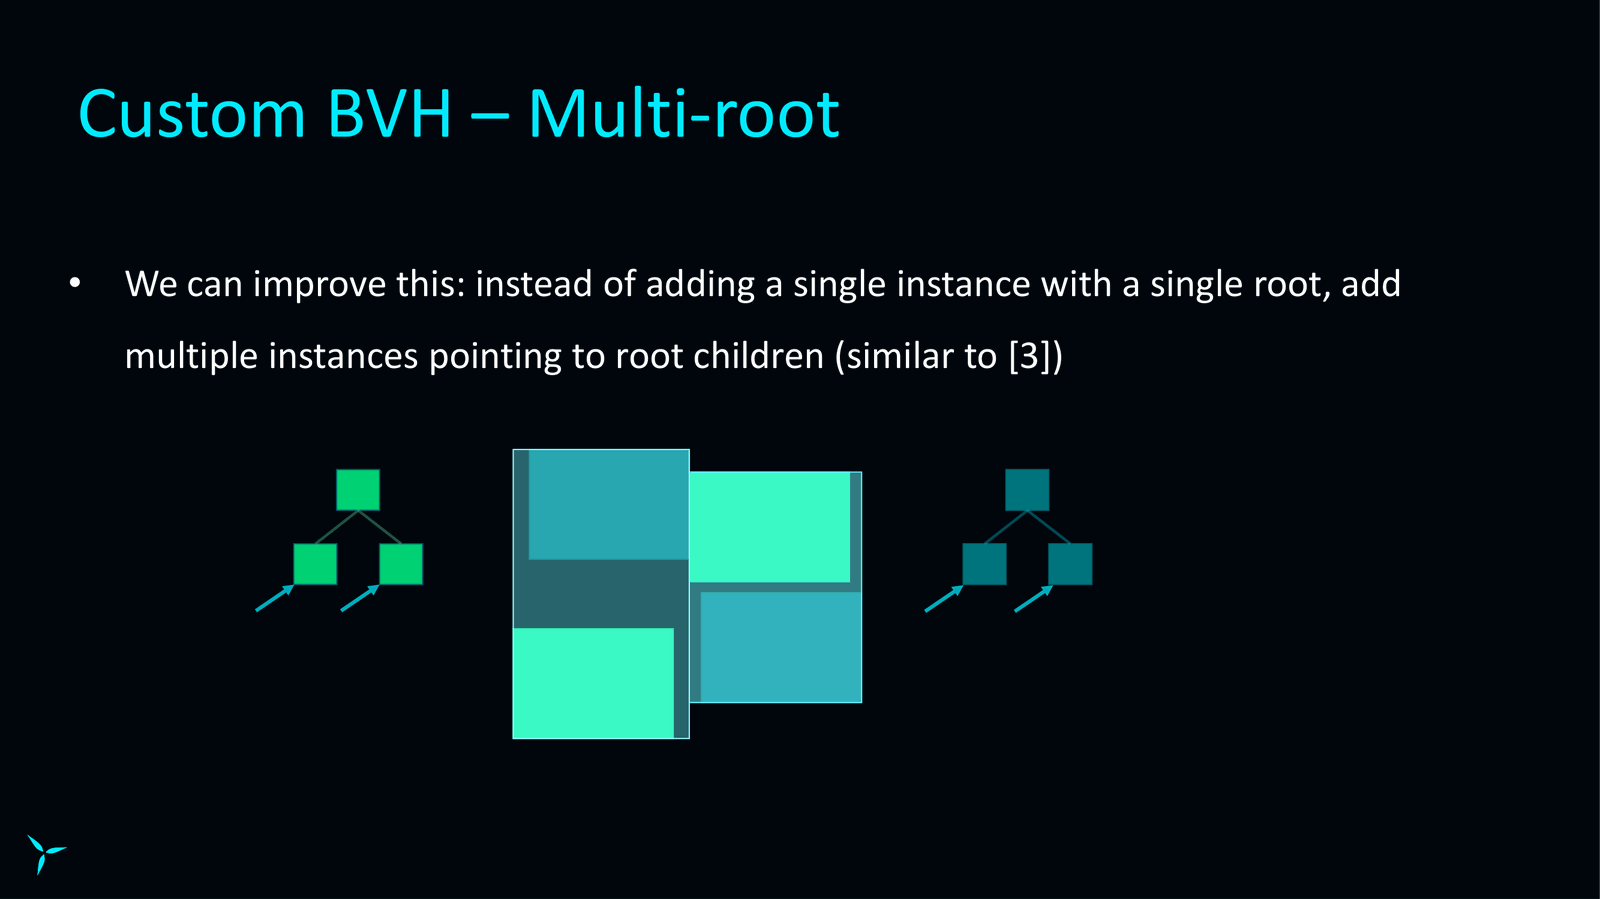
- 不同实体使用预定的层级结构,将子级添加到顶层,提高 BVH 的构建效率
- 常规网格体使用第一级,每个网格最多可添加四个实例,使用第二级到第三级进行细分
更高效的 BVH。这类似于一篇名为“Improved Two-Level BVHs using Partial Rewriting”的论文,但该论文实际上更广泛地应用了它。我们做一件更简单的事情。我们称之为多根,并且我们对不同的实体使用预定的级别,在该级别上将子级添加到顶层。
因此,对于常规网格体,它是第一级。由于我们在第一级有四个子级,因此我们可以添加。每个网格最多四个实例,并且我们使用第二级到第三级。
Slide 33 — 00:19:49
📌 要点汇总
- The cache sector and quadrant nodes have between 16 to 64 instances.
- The iteration heatmap compares performance with and without multi-root optimization.
- The heatmap shows the number of BVH iterations during traversal.
- Without multi-root optimization, traversal efficiency is lower, as shown in the visualization.
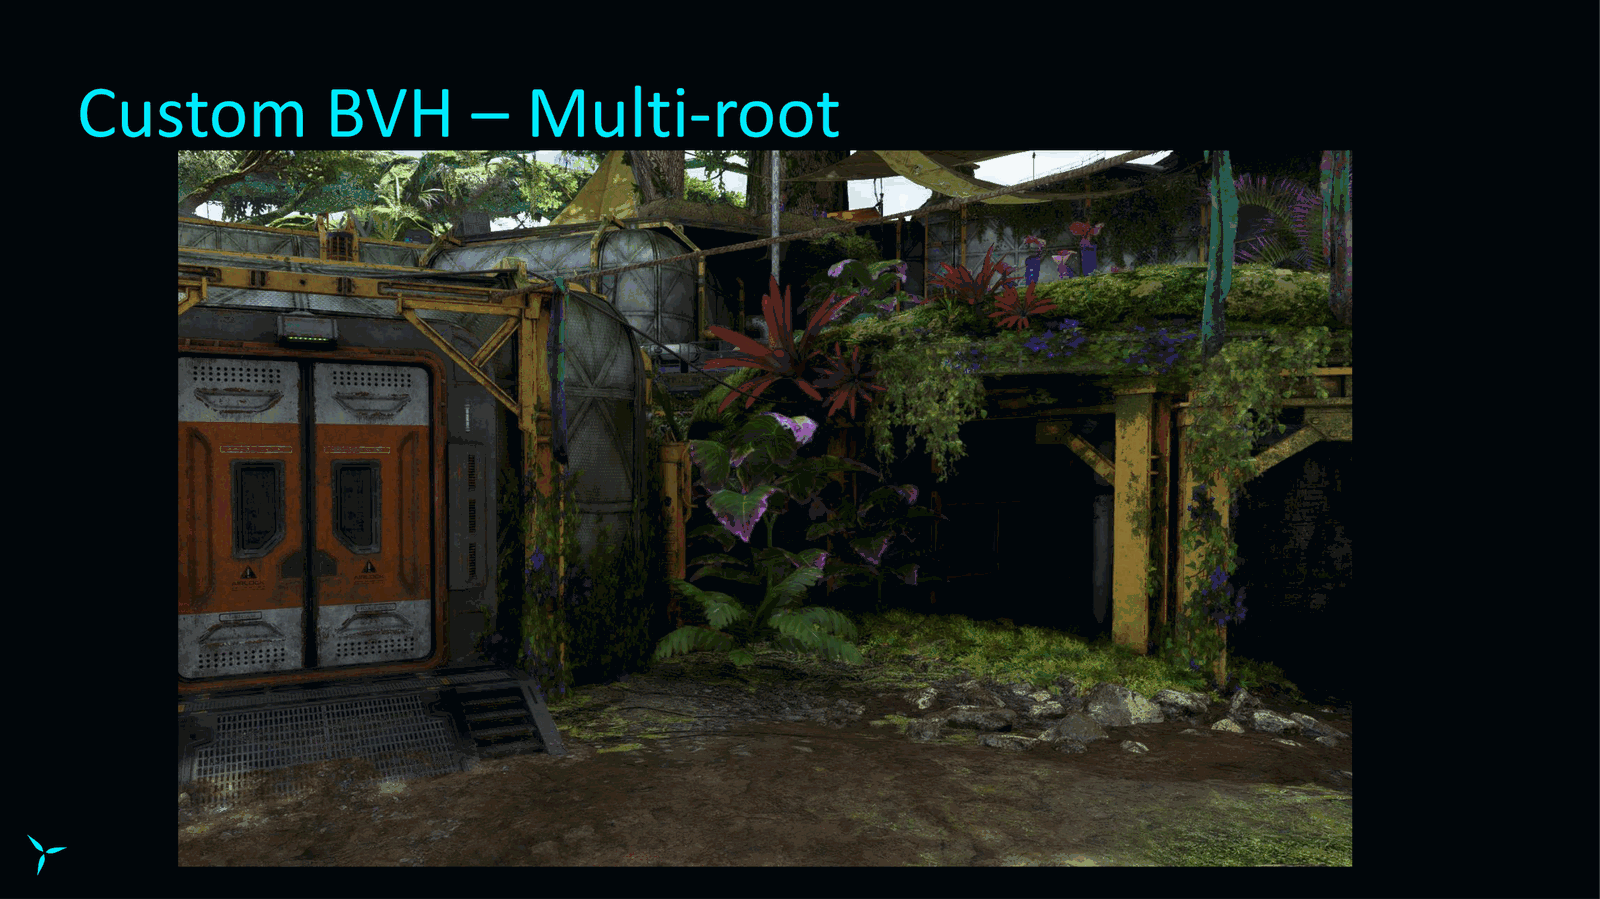
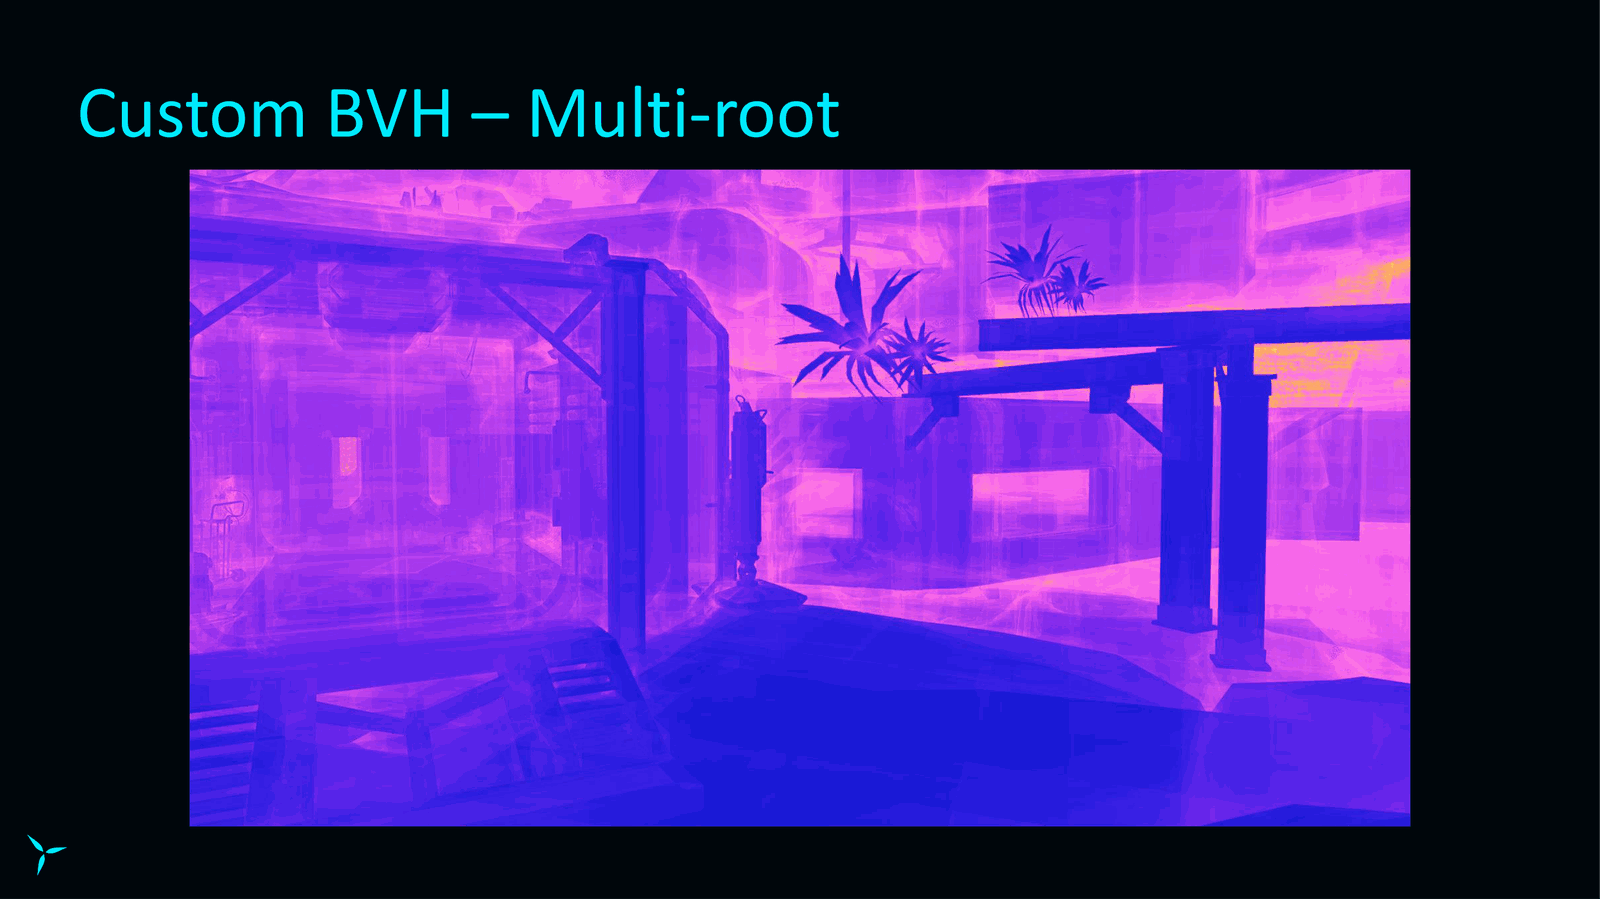
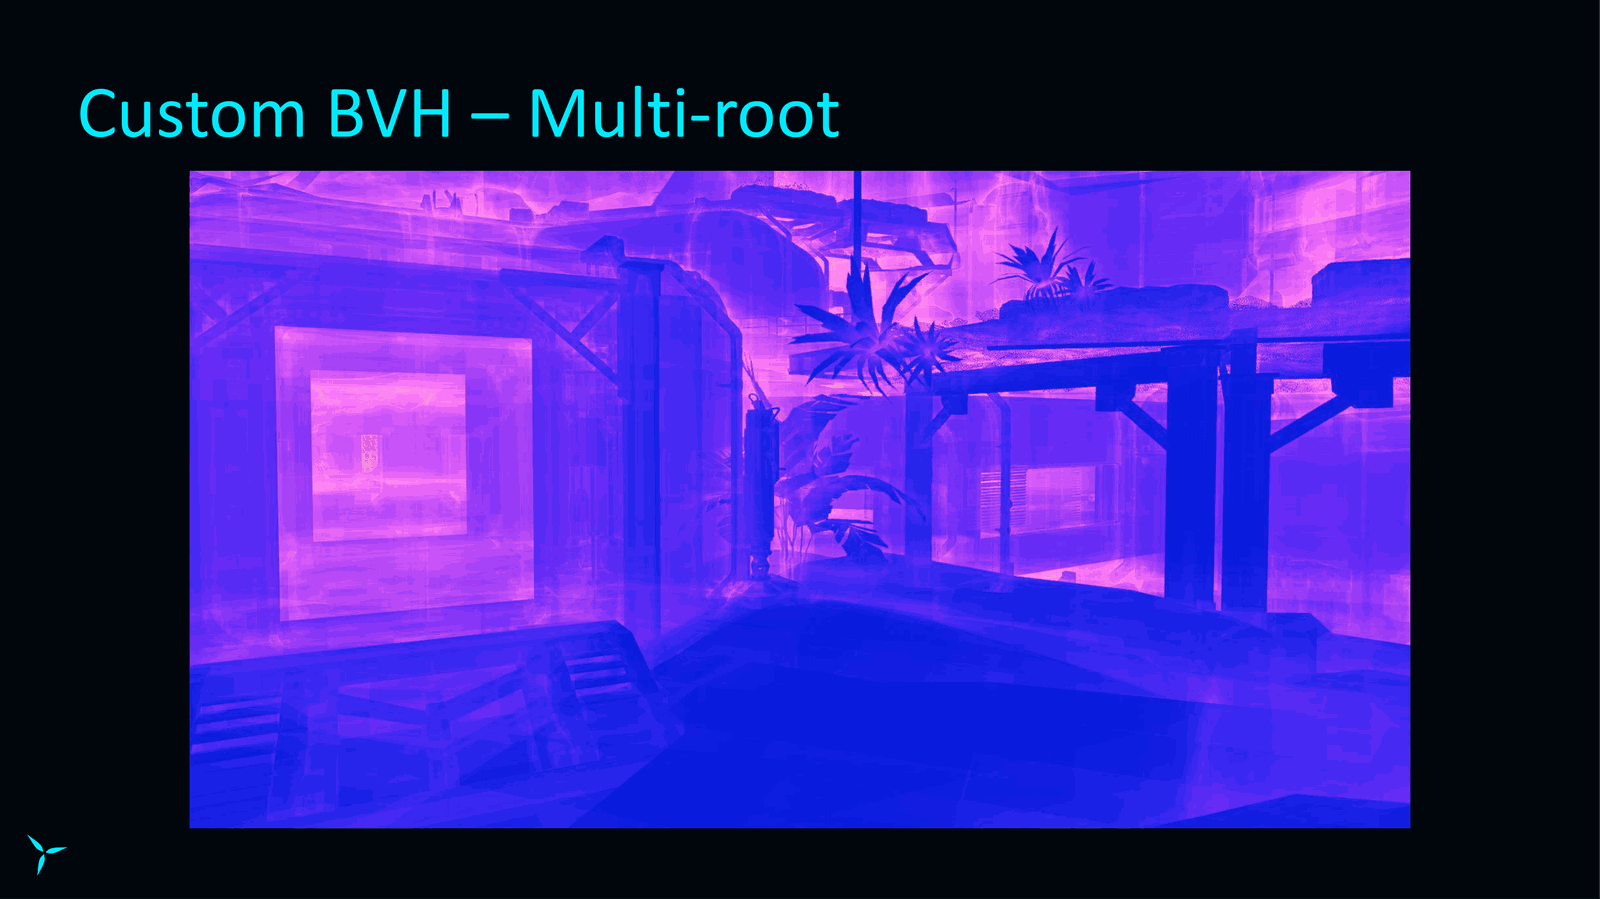
缓存扇区和象限节点,因此有 16 到 64 个实例。因此,如果我们查看这个特定场景并比较有或没有多根的情况,这就是我们的迭代热图。所以,它显示了我们在遍历过程中对 BVH 进行了多少次迭代。
而且这是没有进行多路由优化的情况,这就是它的样子。
Slide 34 — 00:20:24
📌 要点汇总
- Using multiple roots reduces the number of scene iterations needed.
- Multi-root setup avoids overlapping boundaries, preventing incorrect branch movements.
- Performance comparison shows approximately five improvements on the console with multi-root implementation.
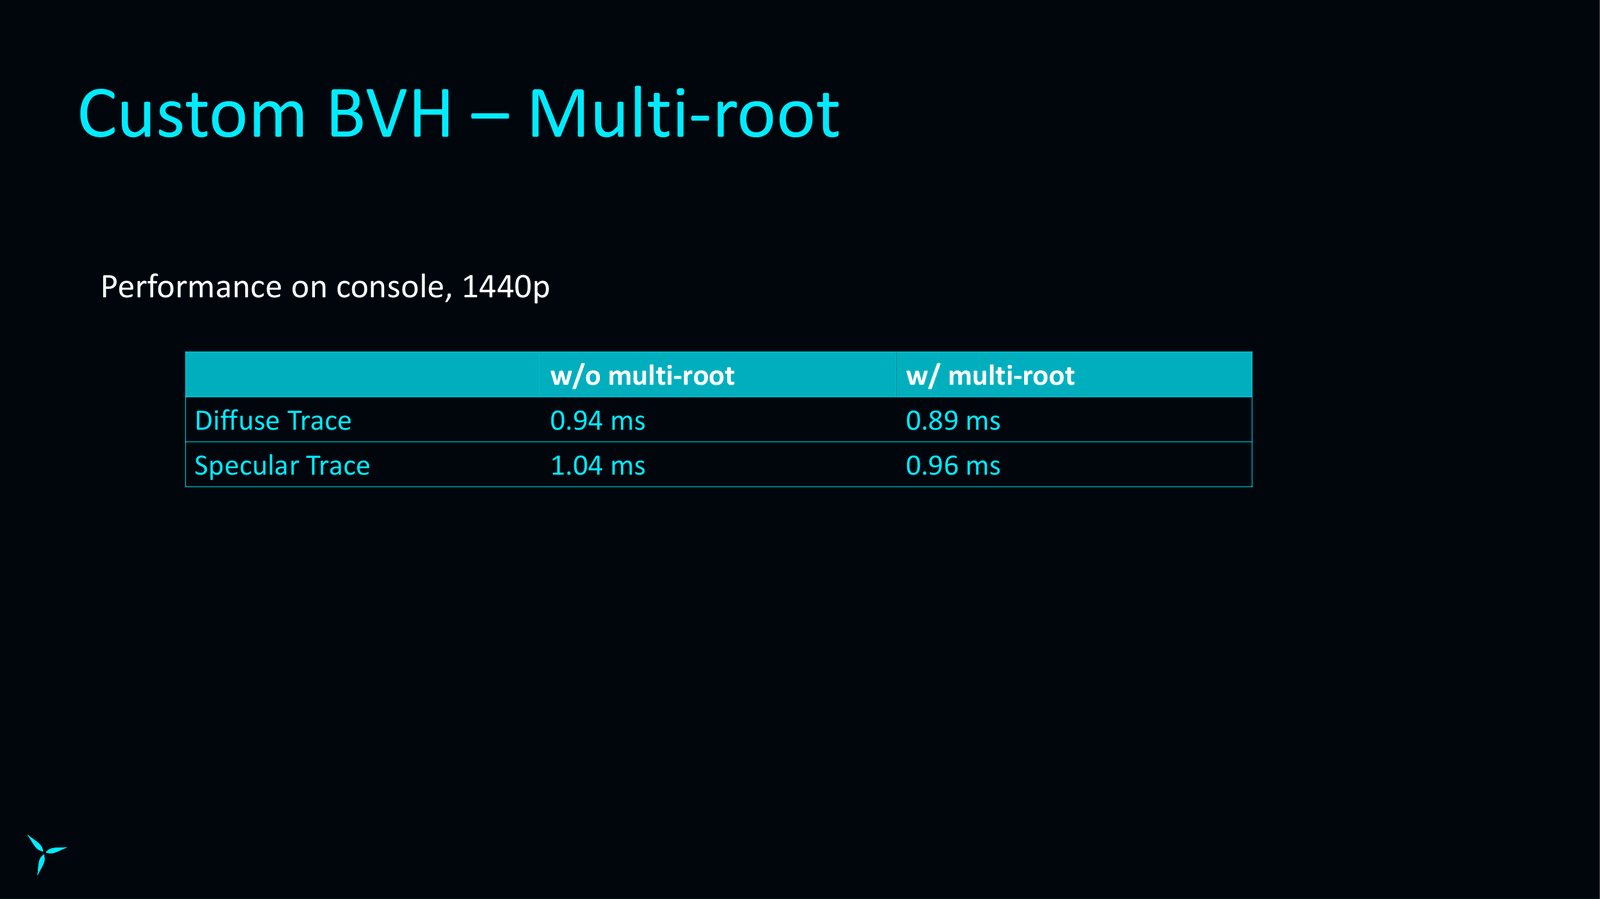
当启用多根时,您可以看到我们对场景的迭代通常要少得多。使用多根时,它也类似于适当的遮挡,因为我们没有重叠的边界,不会导致我们移动树的错误分支。
如果我们再次采取场景并比较控制台上的性能,我们使用多根,我们大约有五个。
Slide 35 — 00:20:59
📌 要点汇总
- 性能提升达到 10%,通过优化遍历自定义 BPH 的方式实现
- 遍历例程基于堆栈,包括发散堆栈和共享堆栈两种方式
- 发散堆栈使用 LDS 存储,大小为组大小乘以最大牌组大小(本例为 32)
- 堆栈最多支持 32 个元素,初始时全部存储在 LDS 中
- 共享堆栈用于轻量级 BPH 遍历,减少资源消耗
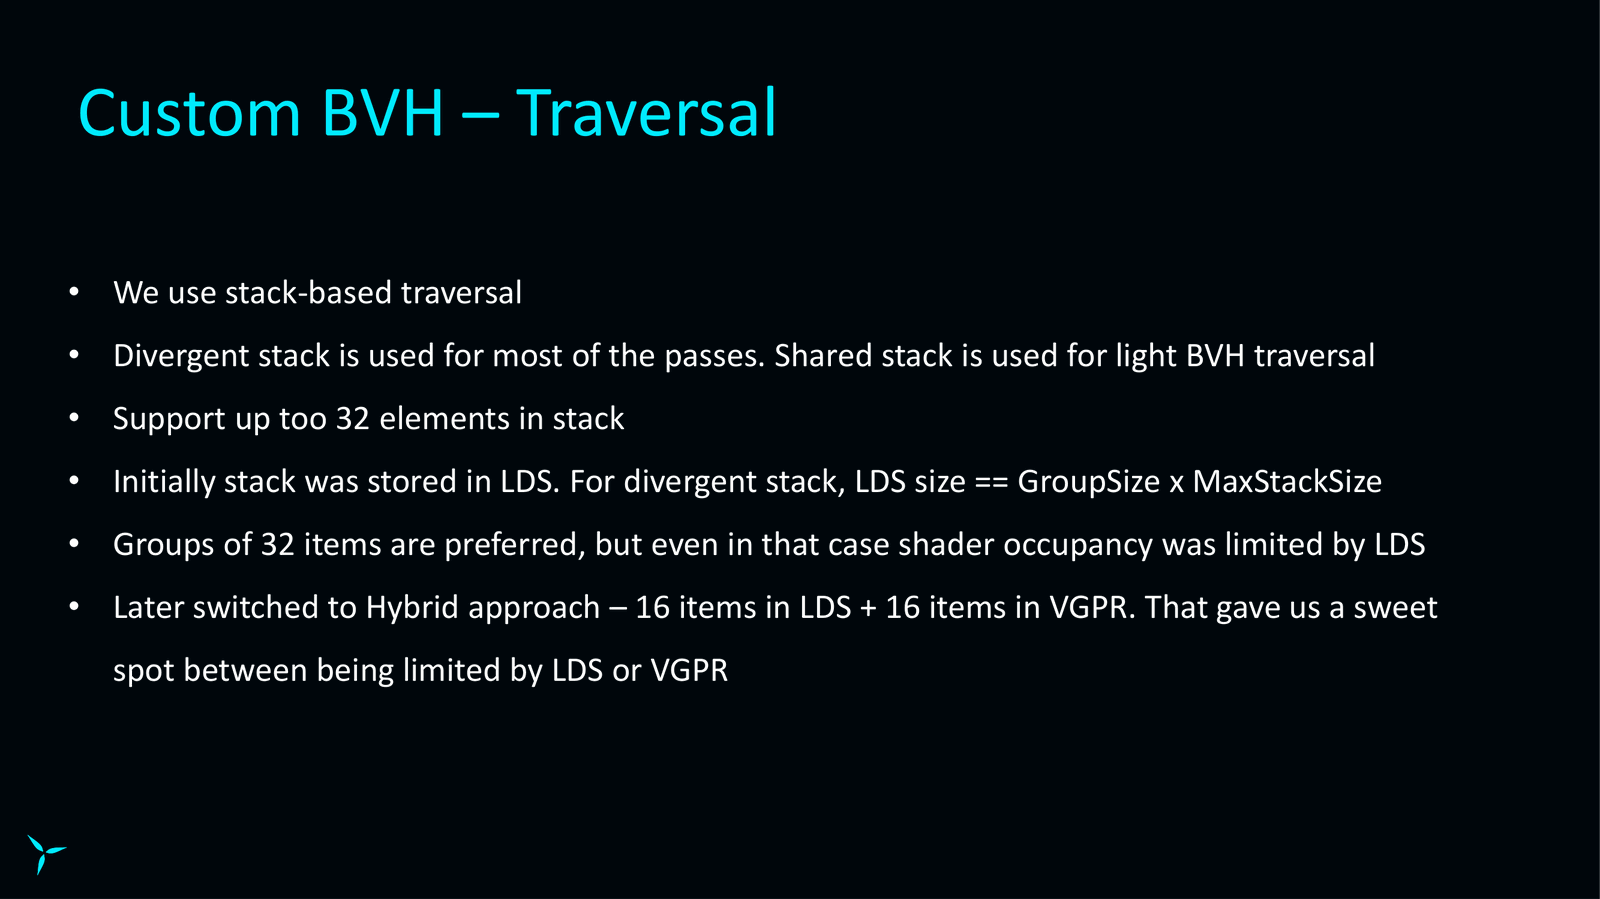
10% 性能提升。现在,我们如何遍历自定义的 BPH 呢?我们的遍历例程是基于堆栈的,大多数遍历都使用发散堆栈,但我们也使用共享堆栈进行轻量 BPH 遍历。我们支持堆栈中最多 32 个元素,最初,整个堆栈都存储在 LDS 中。
对于分歧堆栈,这意味着 LDS 大小是组大小乘以最大牌组大小。在本例中为 32 个元素。
Slide 36 — 00:21:35
📌 要点汇总
- 为减小 LDS 大小,最初选择 32 个项目组,但着色器占用率仍受限于 LDS。
- 后采用混合方法:LDS 中 16 个项目 + VGPR 中 16 个项目,实现 LDS 和 VGPR 之间的平衡。
- 该方法有效缓解了 LDS 和 VGPR 的资源限制问题,提升着色器性能。
- 示例代码展示了简化后的遍历例程,用于说明实现方式。
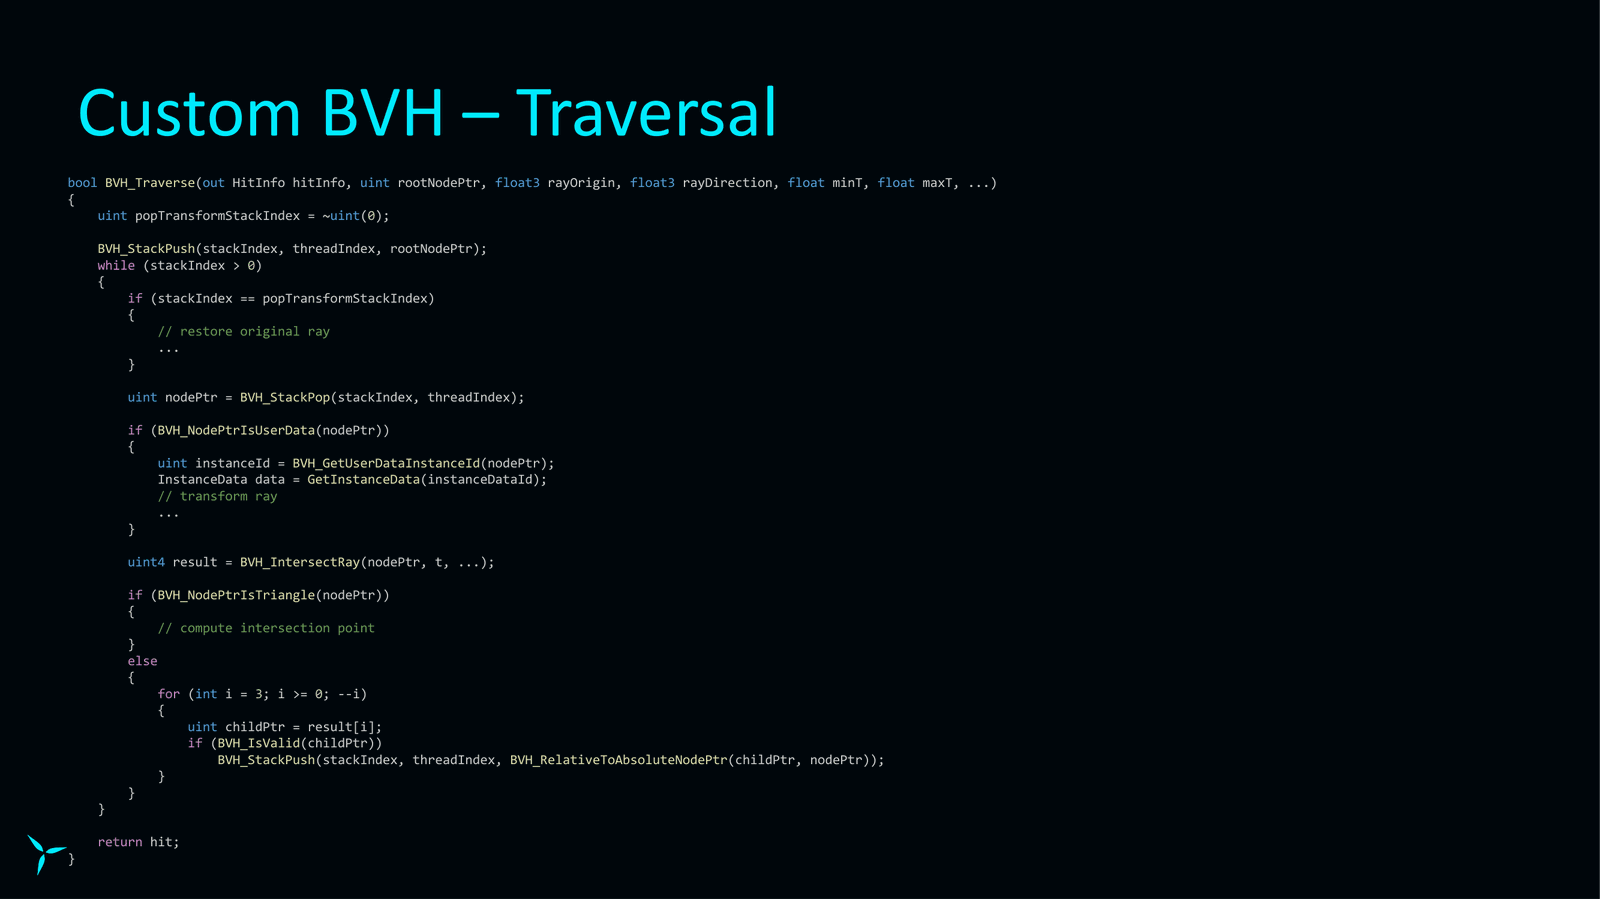
为了减小 LDS 的大小,优选 32 个项目的组。但即使在这种情况下,着色器占用率也受到 LDS 的限制。所以我们后来改用混合方法:LDS 中的 16 个项目加上 VGPR 中的 16 个项目。这让我们在受 LDS 或 VGPR 限制之间找到了最佳平衡点。
遍历例程看起来像这样。这是一个非常简化的代码。为了简单起见,我们展示。
Slide 37 — 00:22:10
📌 要点汇总
- 将所有四个孩子放入堆栈可能影响性能,保留最后一个孩子在本地 VGPR 更高效
- 遍历节点时,遇到实例节点需要对数组进行转换
- 弹出堆栈并离开实例时,需恢复数组以保持状态一致性
- 为性能牺牲精确结果可能导致数据不准确,需权衡取舍
将所有四个孩子放入堆栈中。实际上,将最后一个孩子留在本地 VGPR 中会更有效。我们在这里所做的是遍历节点。如果我们遇到一个实例节点,那么我们需要对数组进行转换。
如果我们将堆栈弹出,并且我们实际上离开了实例,我们需要恢复我们的数组。我们会为了性能而牺牲精确结果,所以。
Slide 38 — 00:22:45
📌 要点汇总
- 堆栈空间用完时,认为跟踪丢失,通常最大堆栈深度不超过21或22个项目。
- 遍历过程中波发散超过一定限度时,也认为踪迹丢失。
- 使用共享堆栈遍历和共享堆栈,对波中所有线程的同一节点测试发散射线。
如果我们用完了堆栈空间,那么我们就简单地认为跟踪丢失了。通常,使用统计数据,我们的最大堆栈深度不会超过 21 或 22 个项目。
如果遍历过程中波发散超过一定限度,我们也会考虑丢失踪迹。现在我们还使用共享堆栈遍历和共享堆栈,针对波中所有线程的同一节点测试发散射线。
Slide 39 — 00:23:21
📌 要点汇总
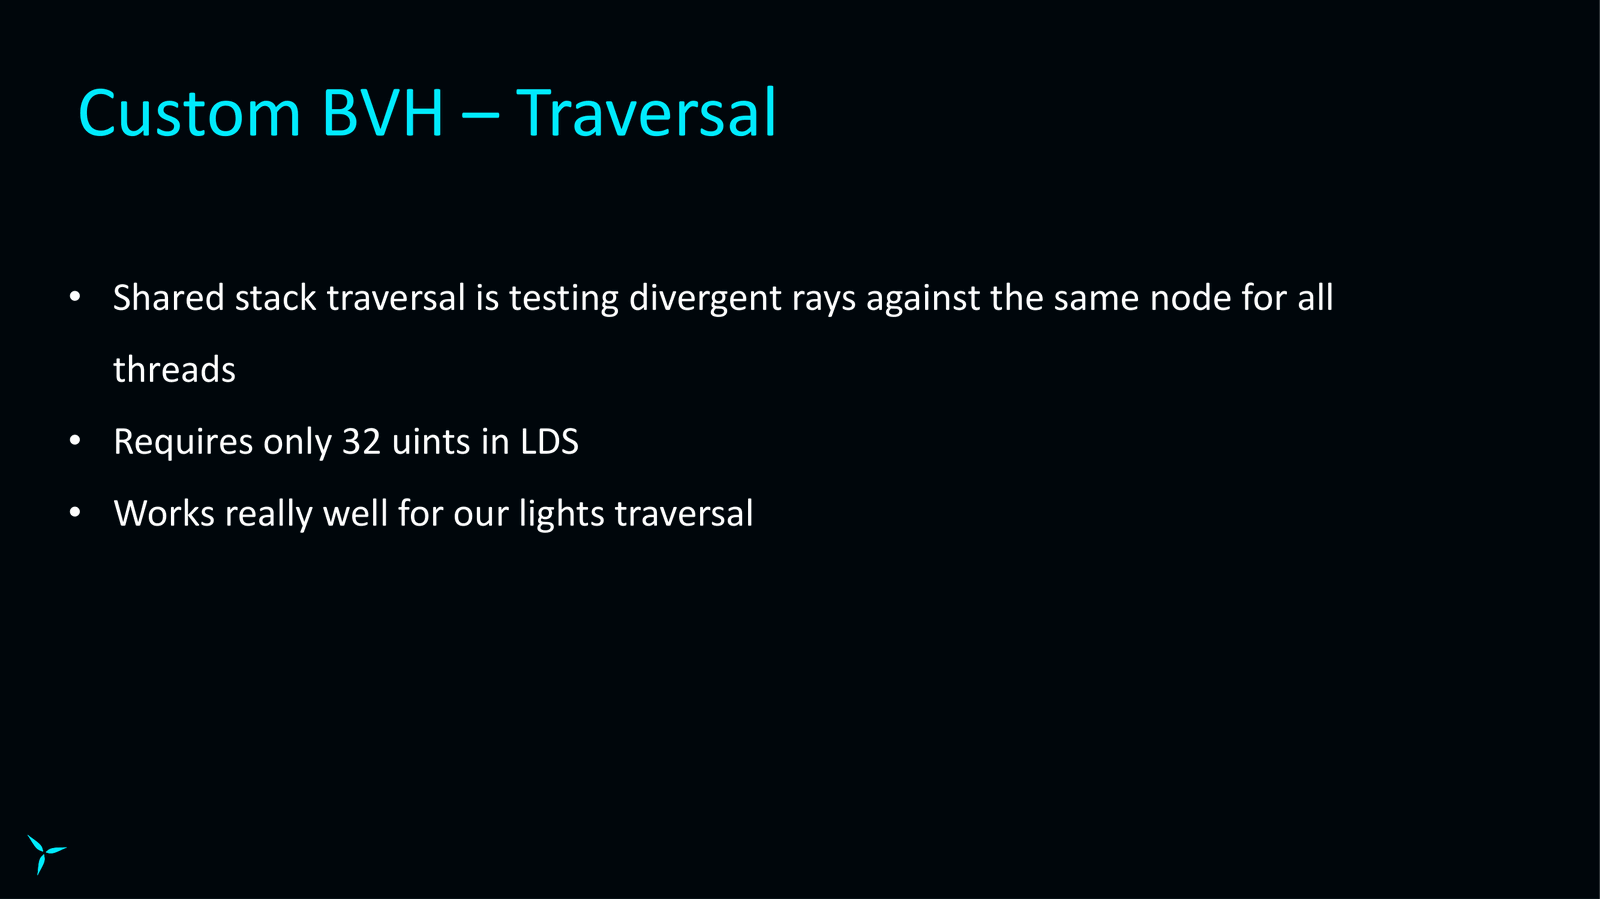
- LDS 中仅需 32 个单元,适合光遍历且连贯
- 代码实现基于灯光共享堆栈遍历
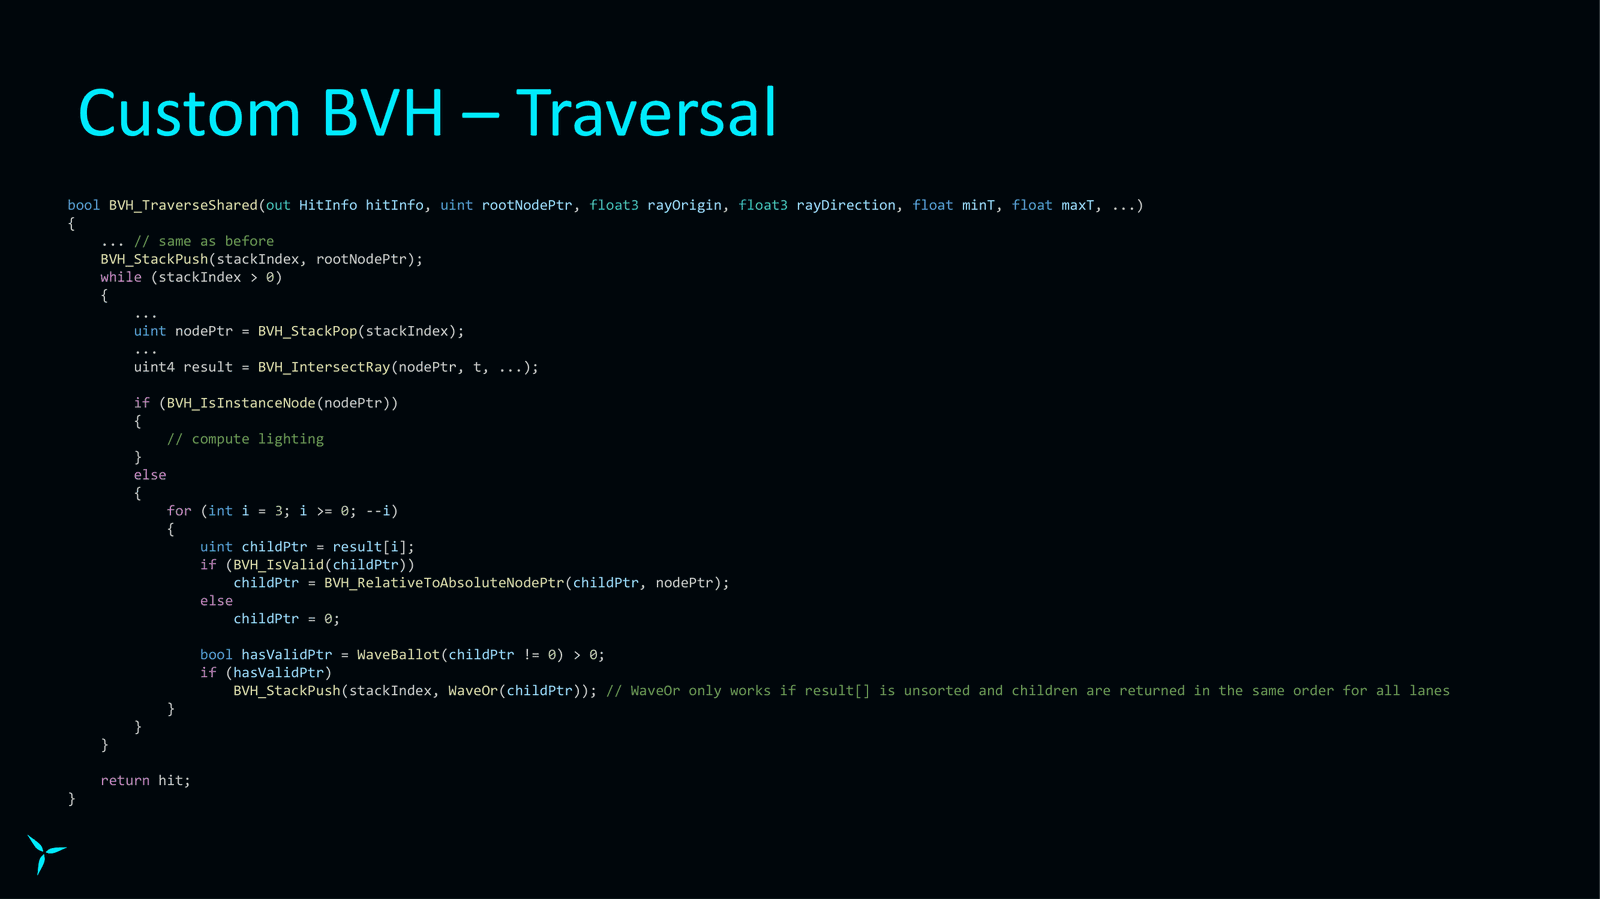
- 不对交集指令返回的子级进行排序,保持与交集例程相同的返回顺序
- 使用波或(wave or)操作可有效利用此特性
因此,它在 LDS 中只需要 32 个单元,并且非常适合我们的光遍历,而且往往非常连贯。这是我们的灯光共享堆栈遍历的代码。
这里重要的注意事项是,我们不对从交集指令返回的子级进行任何排序,因此它们始终以与交集例程相同的顺序返回,这样我们就可以使用波或。
Slide 40 — 00:23:56
📌 要点汇总
- 组合有效相交子项可获得整个波的单个值,有助于提升性能。
- 使用共享堆栈对灯光进行优化,可显著提高性能表现。
- 光通道对探针采样是性能预算的重要部分,实际影响可能比数据显示更大。
- 最大性能收益主要来源于较低的 LDS(线程调度开销)。
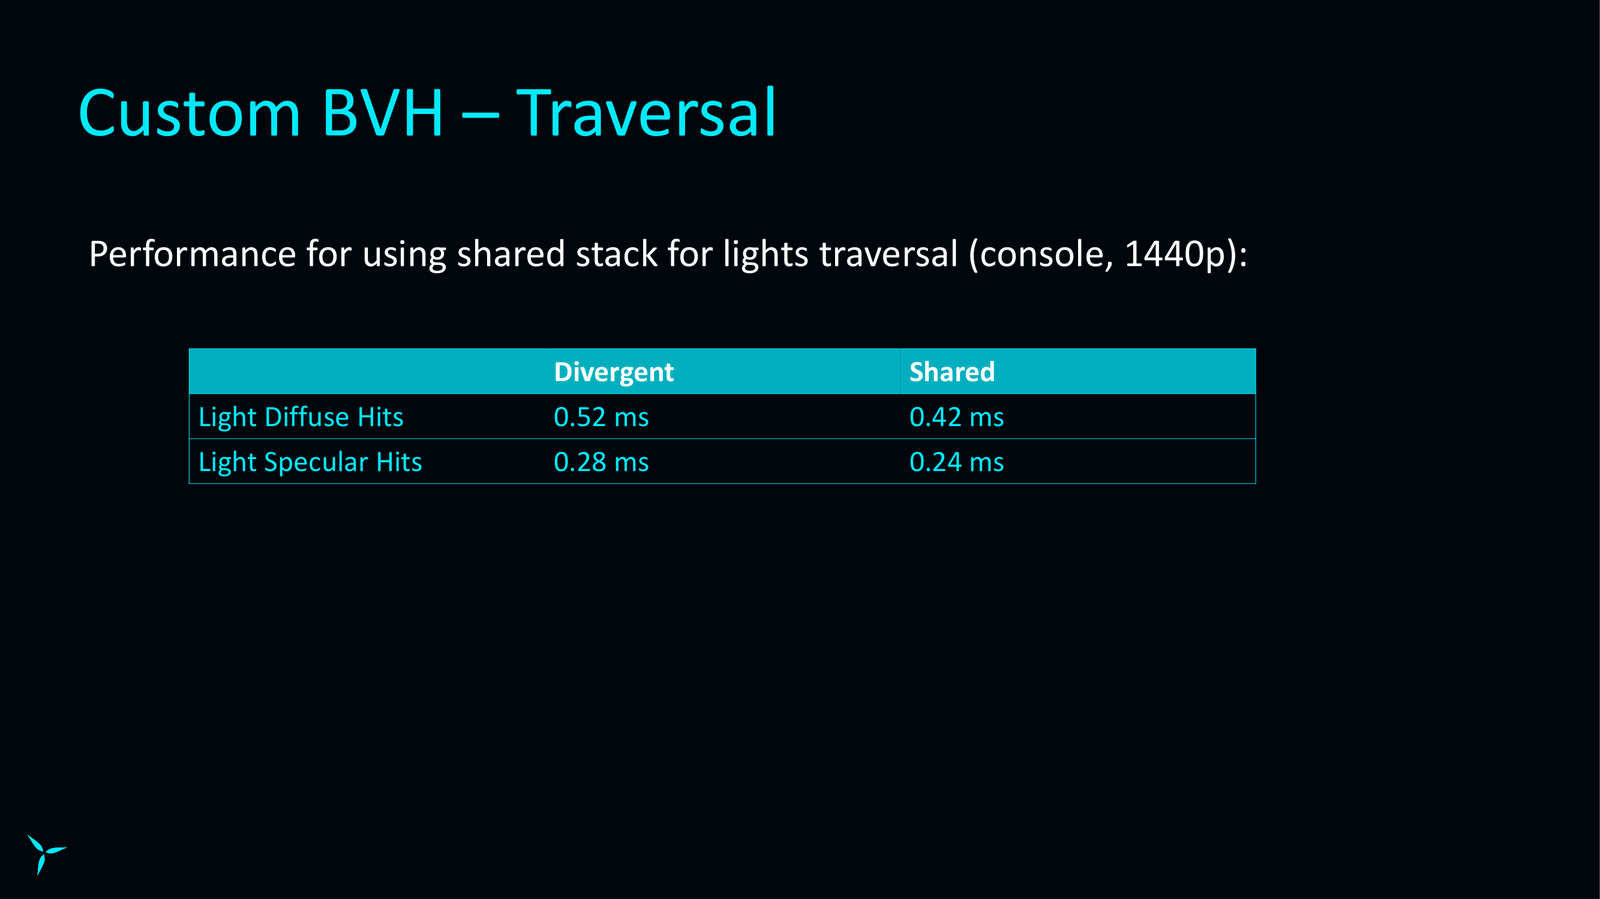
仅组合任何有效的相交子项并获得整个波的单个值。因此,如果我们对灯光使用共享堆栈,我们将获得相当大的性能提升。
值得一提的是,光通道还对探针进行采样,这是该通道性能预算的很大一部分。所以,实际上,影响可能比数字显示的要大。
这里最大的收益主要是由于 LDS 较低。
Slide 41 — 00:24:32
📌 要点汇总
- The slide revisits scene traversal fundamentals, focusing on quadtree and procedural sectors for ray tracing.
- Custom BVH structures can include actual leaf instances and cached subregions.
- Placeholder sectors (impersonators) are introduced and will be elaborated later.
- The next step involves building the light system.
现在我们可以回到场景遍历了。让我们再次回顾一下基础知识。我们检查场景四叉树和程序扇区,收集光线追踪实例。对于自定义 BVH,这些可以是实际的叶实例和缓存的子区域。我们添加冒名顶替者扇区。稍后我们会详细介绍这一点。
然后我们会构建光。
Slide 42 — 00:25:07
📌 要点汇总
- DXR 处理完整的实例列表,合并所有四叉树节点的实例并上传到 GPU 构建顶层
- 自定义 BVH 在 CPU 上构建顶层,与 DXR 的 GPU 构建方式形成对比
- 使用缓存减少 CPU 工作负载,但 DXR 仍需处理大量实例数据
- DXR 的 Blast 在 GPU 上构建,利用并行计算提升构建效率和性能
DXR 和自定义 BVH 之间的主要区别在于,DXR 适用于完整的实例列表。它会合并来自所有四叉树节点的所有实例,并将它们上传到 GPU 上,在 GPU 上构建顶层。我们仍然通过缓存每个剔除单元的这些实例列表来减少 CPU 的工作负载,但如前所述,自定义 BVH 是在 CPU 上构建顶层的。
每个网格的 DXR 的 Blast 也构建在 GPU 上。这种方式充分利用了 GPU 的并行计算能力,从而提高了构建效率和性能。
Slide 43 — 00:25:42
📌 要点汇总
- 构建处理丢失时会排队,限制每帧构建次数以减少 GPU 负载
- 使用压缩技术,构建完成后立即标记为准备就绪
- 自定义 BVH 支持从磁盘加载或后台线程构建,提升灵活性
- 使用孔面法线对 BVH 命中进行着色,确保渲染质量稳定
- 快速构建选项用于后台线程,不影响主流程性能
例如,当构建处理丢失时,我们会将其排队。我们只允许每帧进行少量构建,以限制对 GPU 的影响。我们使用压缩来构建,当它被创建和压缩时就被认为准备好了。
现在,自定义 BVH 要么从磁盘加载 BVH,要么如果它丢失,它会在后台线程中使用快速选项构建它。我们使用孔面法线来对 BVH 命中进行着色。所以,这种方法在保持性能的同时,也确保了渲染质量的稳定性。
Slide 44 — 00:26:18
📌 要点汇总
- 使用自定义 BVH 时,从叶节点读取顶点并计算法线,使用叉积方法
- 在 DXR 中,由于缺少顶点信息,需预先将法线计算并存储到独立缓冲区中
- 每个实例需要独立的 Vlas,常见情况包括剥皮等不同场景
使用自定义 BVH,我们在获得最终命中后计算法线。我们从叶三角形节点读取顶点,并使用叉积计算法线。
使用 DXR 时,我们没有这些信息,因此我们将法线分配并预先计算到一个单独的缓冲区中,然后使用提交的基元索引从该缓冲区中获取值。
我们有很多不同的情况,每个实例都需要自己的 Vlas。最常见的是剥皮,但是。
Slide 45 — 00:26:53
📌 要点汇总
- 使用特殊变换着色器处理样条实体,该着色器在计算上运行并存储原始和变换后的位置
- 对于蒙皮角色,每帧更新位置并重新调整底层结构
- 对于静态网格,通过更新着色器中的变换矩阵而非实际顶点,显著提升性能
- 该方法在保持视觉准确性的同时,避免了频繁更新网格顶点的高开销
另一个例子是我们的样条实体,我们支持生成一个特殊的变换着色器,它基本上是一个顶点着色器,但它在计算上运行并存储位置、变换后的位置。对于某些情况,例如蒙皮角色,我们会更新位置并重新调整每一帧的底层。
但对于大多数其他情况,我们将网格视为带皮但静态的,我们会“作弊”。我们更新的是着色器中的变换矩阵,而不是实际的网格顶点,这样可以显著提高性能,同时保持视觉效果的准确性。
Slide 46 — 00:27:28
📌 要点汇总
- 爆炸后不再接触资产,行为依赖于资产设置。
- XR 和自定义 BVH 都需要每帧进行改装,但后者还需传播到顶层。
- 在 DXR 上,顶层始终从头构建,因此是静态的。
一旦我们制造了爆炸一次,就不再碰它。该行为取决于资产的设置。因此,XR 和定制 BVH 之间的完全动态皮肤网格是相似的。它们都需要每一帧进行改装,但如前所述,自定义 BVH 还需要将改装传播到顶层。这不是问题。
在 DXR 上,因为我们总是从头开始构建顶层,静态的。
Slide 47 — 00:28:04
📌 要点汇总
- DXR 的蒙皮处理较为简单,只需计算位置,且数据在 GPU 上,构建一次即可完成。
- 自定义 BVH 的实现更复杂,需从 CPU 获取位置信息,最终选择将数据读回 CPU 并在后台线程构建 Plus。
- 几何 LOD 的处理需在不同细节层次间高效切换,以平衡性能与视觉效果。
DXR 上的蒙皮处理相对简单。我们只需要计算位置,由于这些数据位于 GPU 上,而 Plus 是从 GPU 构建的,因此我们只需构建一次即可。
但对于自定义 BVH 来说,情况就复杂得多,因为我们需要在 CPU 上获取这些位置信息。我们有多种实现方式可供选择,但最终我们选择了最直接的方法:将数据读回 CPU,然后在后台线程上使用快速选项创建 Plus。
在处理几何 LOD 时,我们同样需要考虑如何在不同细节层次之间进行高效切换,以确保性能和视觉效果之间的平衡。
Slide 48 — 00:28:39
📌 要点汇总
- 光线追踪无法直接与光栅化世界匹配,导致阴影精度受限,但可用于级联阴影贴图范围外的阴影计算。
- 为实现完整光线追踪,需将冒名顶替者纳入光线追踪世界,以确保所有施法者被正确处理。
- 在光线遍历过程中,采用特殊程序跟踪,使光线沿冒名顶替者深度行进,以准确计算交集。
光线追踪与我们的光栅化世界不匹配,这不允许我们拥有精确的光线追踪阴影。但我们仍然可以对级联阴影贴图范围之外的阴影使用光线追踪。
为了获得所有施法者,我们还需要将冒名顶替者纳入光线追踪世界。在光线遍历过程中,我们进行特殊的程序跟踪。程序光线沿着冒名顶替者深度行进以获得交集。
Slide 49 — 00:29:15
📌 要点汇总
- 冒名顶替者在空间部门处理,尺寸为 256 x 256 米,通过 DXR 的程序原语实现
- 每个冒名顶替者实例是一个程序框,冒名顶替者扇区是多个程序框的集合
- 跟踪过程中从候选原始索引恢复实例索引,命中叶框后继续处理
- 使用程序光线行进方法,并自定义 BVH 缓存冒名顶替者以提高性能
所以我们的冒名顶替者是在空间部门处理的。它的大小为 256 x 256 米,DXR 通过程序原语实现它们。因此,每个单独的冒名顶替者实例都是一个程序框,而冒名顶替者扇区是所有此类框的集合。
然后我们在跟踪期间从候选原始索引恢复实例索引,一旦我们命中叶框,我们就可以继续。使用我们的程序光线行进,然后自定义 BVH 缓存冒名顶替者。
Slide 50 — 00:29:50
📌 要点汇总
- 在子 BVH 中,进入冒名顶替者扇区实例时,执行冒充者射线行进例程而非常规交叉点计算。
- Per-object BVH 优化旨在解决实例间的重叠问题,与多根方法类似但采用不同处理方式。
在子 BVH 中,与我们对其他实体执行的操作类似,在遍历过程中,一旦进入冒名顶替者扇区实例,我们就会运行冒充者射线行进例程,而不是常规交叉点。
我们再来说一下优化。所以,per-object BVH 试图解决一个问题。它有点类似于之前提到的多根,是实例之间的重叠,但是这次,它采用了一种不同的方法来处理这种情况。
Slide 51 — 00:30:25
📌 要点汇总
- DXR 和自定义 BVH 可用于处理重叠边界框问题
- 多个子网格在同一对象中可能导致边界框重叠
- 示例中筒仓基础网格与管道网格存在完全重叠的边界框
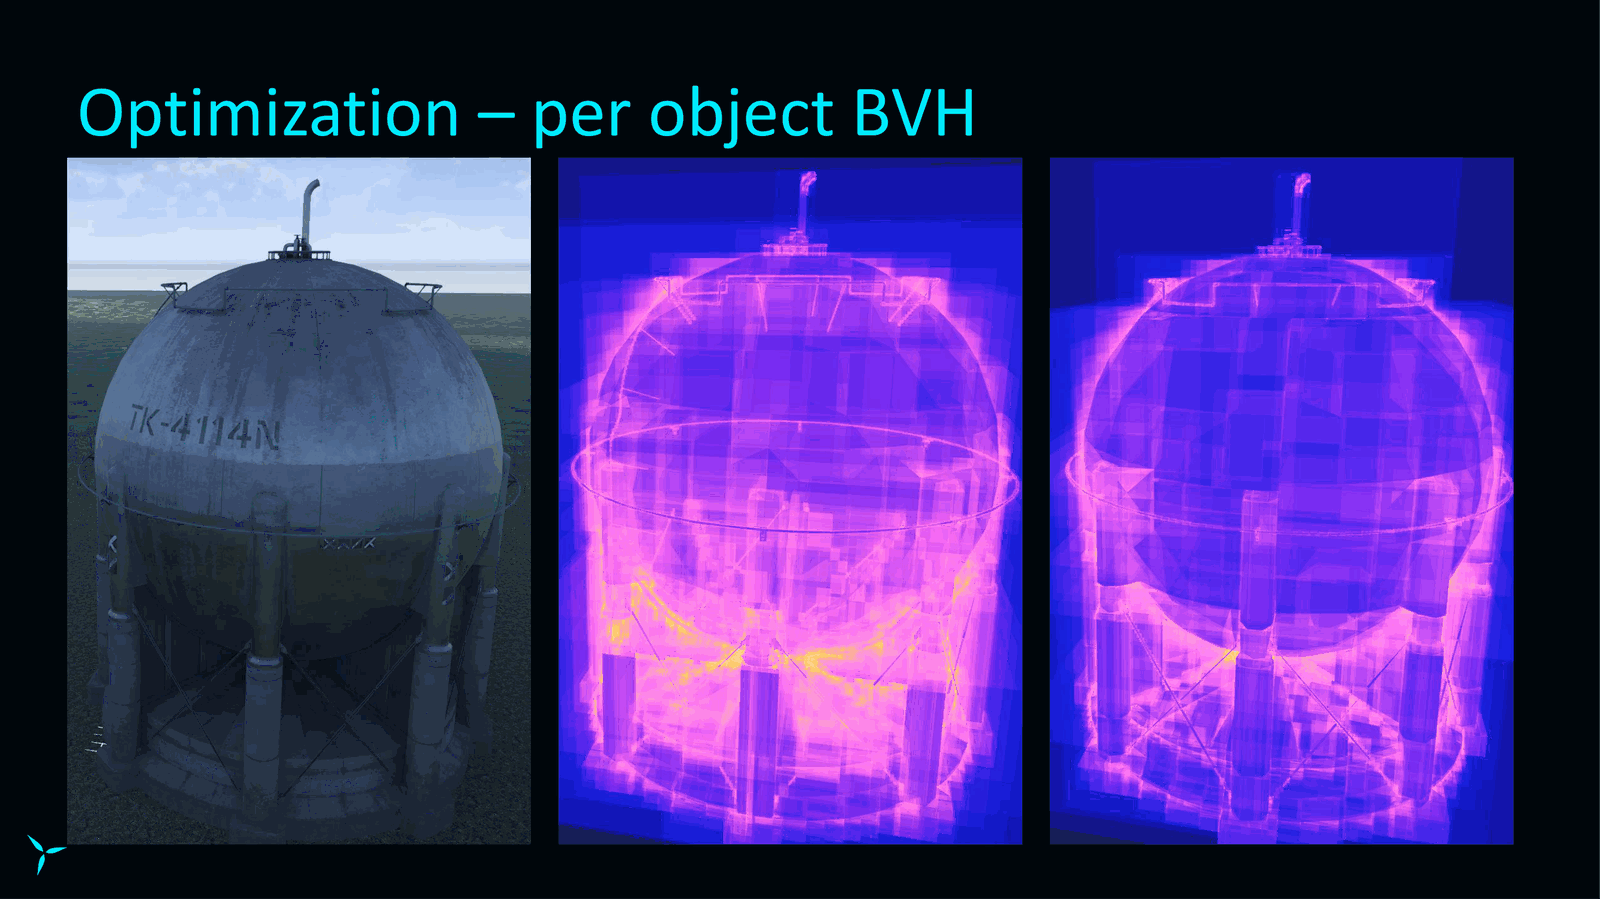
实际上,我们可以对 DXR 和自定义 BVH 执行此操作,问题是由于我们通常在单个对象中使用多个子网格,有时这可能会导致边界框重叠。
所以,如果你看一下这里的例子,这个筒仓由一个大的基础网格组成,但该网格周围的管道是一个单独的网格节点,所以我们实际上在这里有完全重叠的边界。
Slide 52 — 00:31:01
📌 要点汇总
- 使用单独的 BVH 会导致遍历效率较低
- 合并所有网格并构建统一的 BVH 可提高遍历效率
- 统一 BVH 是更有效的空间遍历结构
- 该方法优化了对象交集迭代的性能
中间又是该对象的交集迭代命中图。如果我们只是在对象内的每个网格节点使用单独的 BVH,但是如果我们将所有这些网格合并在一起并从中构建 BVH,我们就会得到更高效的遍历结构。实际上,这是一种更有效的遍历方式。就是这样。
Slide 53 — 00:31:36
📌 要点汇总
- Snowdrop 网格渲染需要确保子网格始终形成相同的对象,这在灵活性高的系统中并不简单。
- 灯柱等对象的较高部分可以旋转,因此无法使用每个对象的优化方法。
- 程序放置的网格相对容易处理,因为它们本质上是静态的,但仍有特定需求。
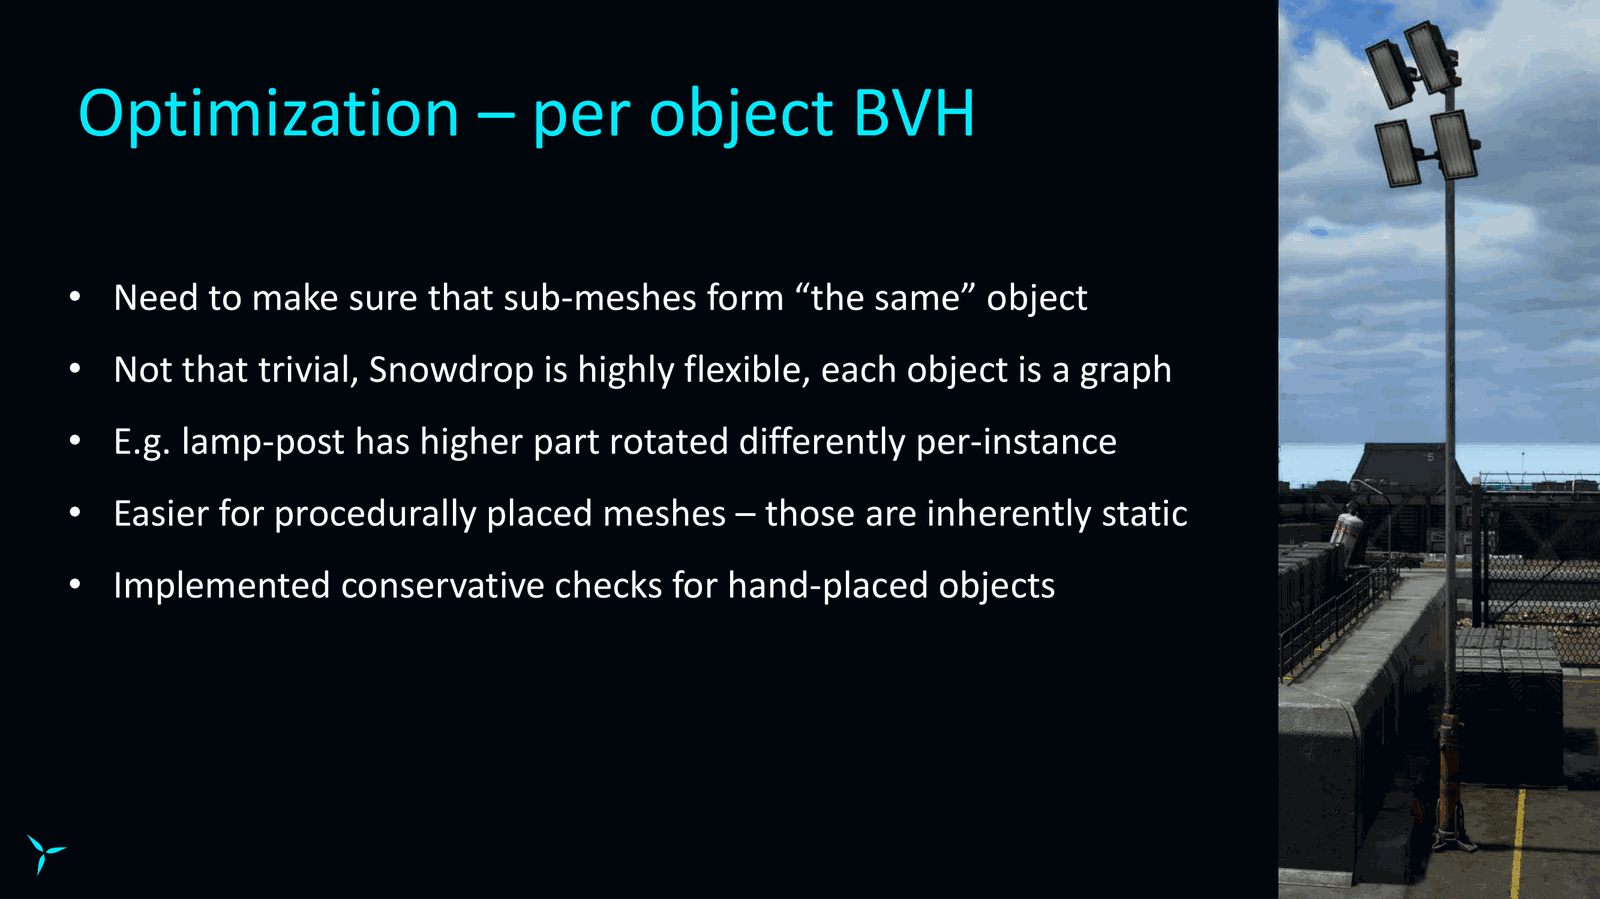
令人惊讶的是,这对于 Snowdrop 网格渲染来说并不简单,因为我们需要确保子网格始终形成相同的对象。这并不是那么简单,因为 Snowdrop 非常灵活,并且每个对象都是一个图。
因此,例如,这里的灯柱,它的较高部分可以以不同的方式旋转,我们实际上不能在这里使用每个对象的优化。
对于程序放置的网格来说要容易得多。这些本质上是静态的,但我们需要。
Slide 54 — 00:32:12
📌 要点汇总
- DXR 支持通过在加速结构中提供多个几何图形来实施对手工放置物体的保守检查。
- 几何索引函数可用于从相交结果中恢复子网格索引。
- 每个三角形节点中存储子网格索引以支持自定义 BVH。
- 离线 BVH 构建器了解每个对象的方法,可更精确构建层次结构,提高光线追踪效率和准确性。
为了对手工放置的物体实施一些保守的检查,DXR 通过在加速结构输入中提供多个几何图形来支持这一点,然后我们可以通过相交结果的几何索引函数恢复子网格索引。
我们还通过在每个三角形节点中存储子网格索引来支持自定义 BVH。离线 BVH 构建器了解每个对象的方法,因此它可以更精确地构建层次结构,以提高光线追踪的效率和准确性。
Slide 55 — 00:32:47
📌 要点汇总
- 该方法不仅为网格构建 BVH,还为相关对象构建,提升了性能约 50%
- 在《阿凡达》和《潘多拉边境》中仅部分使用,实际场景性能提升有限
- 使用率低与方法的限制有关,具体限制未详细说明
- 性能计时显示方法有效,但实际应用受限于某些未明确的技术障碍
除了单独为网格构建所有 BVH 之外,它还尝试为被认为与此优化相关的对象构建它们。为此提供性能计时是公平的,在综合测试中,它提供了与多根类似的提升,比如百分之五十。但它在《阿凡达》、《潘多拉边境》中只部分使用,因此真实场景中的计时没有得到有意义的改变。
使用率很低,部分原因是我提到的限制。
Slide 56 — 00:33:22
📌 要点汇总
- The material system is inspired by “Metro: Exodus” but does not support alpha testing, which is faked instead.
- Normal maps are applied per-face rather than per-vertex, which may affect lighting accuracy.
- The current approach has limitations, and further improvements are planned for future development.
部分由于一些错误,我们仍然打算改进和扩展该功能。关于 BVH 的部分就到此结束。
我们来谈谈一些材料。我们使用受《地铁:离去》启发的普通材料。我们不支持 alpha 测试,我们伪造它。
我们使用的法线是针对每个面的。
Slide 57 — 00:33:58
📌 要点汇总
- Alpha测试在《阿凡达》系列中广泛用于植被渲染,其性能表现对整体画面质量有直接影响。
- 评估alpha测试率逆转是优化渲染效率的关键步骤,有助于减少不必要的像素处理。
- 需要确保alpha测试的实现方式与材质和光照模型兼容,以避免视觉和性能上的问题。
我们面临的最大挑战是,由艺术家和不同的外观帖子创建的着色器基于公开的参数和不同的引擎内变量,如风、天气、一天中的时间等。因此,我们需要找到一种方法,让普通材质能够尊重这一点。
但首先,我们来谈谈 alpha 测试。潘多拉的《阿凡达》系列有很多依赖 alpha 测试的植被。关于评估 alpha 测试率逆转非常重要。
Slide 58 — 00:34:33
📌 要点汇总
- 使用蓝色噪声抖动替代昂贵的着色器图方法,以减少计算开销
- 每个通过 alpha 测试的实例分配恒定 alpha 值,并通过抖动测试随机拒绝三角形命中
- 该方法对弥漫性表面和置换水效果良好,能准确表现遮挡和饱和度
- 在完美镜面反射场景中表现不佳,但可通过其他手段弥补此缺陷
昂贵,对于任意着色器图来说更是如此。所以我们不这样做。相反,我们使用蓝色噪声抖动。每个经过 alpha 测试的实例都会获得一个恒定的 alpha 值,并且我们根据抖动测试随机拒绝三角形命中。
它对于弥漫性表面非常有效。它给出了树木的预期遮挡量和饱和度,并且对于反射也非常有效。在完美的镜面反射下它会失败。但例如,它对于置换的水却能很好地保持。
Slide 59 — 00:35:08
📌 要点汇总
- 屏幕空间通道被禁用,仅使用硬件光线追踪实现树冠渲染效果。
- 未使用 alpha 测试,但渲染效果依然良好,表明硬件光线追踪能力较强。
- 平均材质的实现方式有两种,其中一种是直接使用材质。
我们通常依赖屏幕空间通道进行光线追踪,但在这张图中,屏幕空间完全禁用,因此仅使用硬件光线。正如你所看到的,树冠支撑得很好。很难说我们这里没有使用 alpha 测试。
回到平均:我们如何获得它?我们支持两种主要的提供平均材料的方式。第一个很简单,就是材料。
Slide 60 — 00:35:44
📌 要点汇总
- 元数据着色器是从艺术家着色器图生成的特殊着色器,用于在 CPU 上执行,处理单个值并返回单个值
- 元数据着色器提供更高的灵活性和可重用性,适应多种材质需求
- 美术师无需修改基础着色器代码即可快速调整材质属性,提升工作效率
- 元数据着色器有助于开发团队管理复杂材质系统,减少重复劳动
覆盖节点,美术师可以为网格设置一个常量材质,更通用的方式是使用元数据着色器。这是从艺术家着色器图生成的特殊着色器,目标是在 CPU 上执行。因此,它在单个值或单个浮点值上运行,并且也返回单个值。它在网格实例化时执行。
元数据着色器的优势在于其灵活性和可重用性,能够适应多种不同的材质需求。通过这种方式,美术师可以在不修改基础着色器代码的情况下,快速调整材质属性,从而提高工作效率。此外,元数据着色器还能帮助开发团队更好地管理复杂的材质系统,减少重复劳动。
Slide 61 — 00:36:19
📌 要点汇总
- 元数据着色器现在通过读取平均纹理值来获取纹理数据
- 顶点颜色获取方式也改为使用平均顶点颜色
- 纹理和网格资源已添加对平均值的支持
- 元数据着色器编译器生成指令流以支持运行时操作
- 解释器使用 case 语句来评估每条指令
首先,或者如果认为需要的话,可能会进行更新。元数据着色器的纹理获取方式已更改为读取平均纹理值。类似地,顶点颜色获取方式也改为平均顶点颜色。我们在纹理和网格资源中添加了对这些平均值的支持。因此,我们的元数据着色器编译器会生成指令流,然后我们的运行时就可以正常工作了。
作为一个简单的解释器,它只是一个 case 语句来评估每条指令。
Slide 62 — 00:36:55
📌 要点汇总
- 引擎为艺术家提供大量内置着色器节点,需将其转换为元数据着色器指令
- 在节点内部添加特殊标签,标明元数据指令名称
- 解释器端需支持执行该指令
- 与语言、英语相比,若功能缺失则无法实现
我们的引擎为艺术家提供了大量内置着色器节点,我们需要以某种方式将这些节点转换为元数据着色器指令。因此,在这些节点内部,我们添加一个带有元数据指令名称的特殊标签,然后在解释器端,我们添加执行该指令的支持。
和语言、英语相比,如果功能缺失,我们没有。
Slide 63 — 00:37:30
📌 要点汇总
- 该代码包含支持特定节点的实现,但元数据着色器编译器无法处理。
- 着色器图支持特殊元数据覆盖节点,作为完全材质覆盖与可执行着色器之间的中间方案。
- 该方法简化了着色器逻辑,同时仍能保持响应能力,避免复杂逻辑处理。
在该代码中包含代码来支持某个节点。元数据着色器编译器将无法编译。我们的着色器图支持特殊的元数据覆盖节点。
这是完全材质覆盖和可执行着色器之间的中间地带。所以它允许我们绕过着色器中的一些复杂逻辑。而不是遵循一个简单得多的逻辑,但仍然可以响应。
Slide 64 — 00:38:05
📌 要点汇总
- 使用与着色器相同的输入实现普通材料存在一些问题,特别是在处理阶跃函数或条件语句时。
- 阶跃函数或条件语句可能导致光栅化世界和光线追踪世界之间的不匹配,因为它们对平均概念不友好。
- 通常需要使用元数据覆盖或完整材料覆盖来解决材料不匹配的问题。
与着色器具有相同的输入。显然,以这种方式实现的普通材料确实存在一些问题。例如,阶跃函数或任何类型的条件都会导致光栅化世界和光线追踪世界之间的不匹配,因为它们实际上对平均概念根本不友好。
通常,元数据覆盖或完整材料覆盖是必需的,而材料本身的不匹配无疑是必需的。
Slide 65 — 00:38:41
📌 要点汇总
- 发射不匹配可能导致间接照明中的闪烁问题,因此元数据执行会限制发射值在合理范围内
- 支持单独覆盖发射属性,同时为其他材质属性提供可执行着色器
- 普通材料外观比较用于验证不同材质属性对视觉效果的影响
但由于它仅用于间接照明,因此发射不匹配可能是一个大问题,因为它会导致各种闪烁。因此,我们的元数据执行将输出发射限制在一个合理的值。
我们还支持单独覆盖发射,同时为其余材质属性提供可执行着色器。
一点。普通材料外观的比较。
Slide 66 — 00:39:16
📌 要点汇总
- Alpha 抖动植被在光线追踪中比光栅化更复杂,增加了计算成本。
- 光线追踪目前仍较为昂贵,尤其在处理小型发射物体时会产生大量噪音。
- 由于预算限制,无法使用降噪技术来减少光线追踪中的噪音问题。
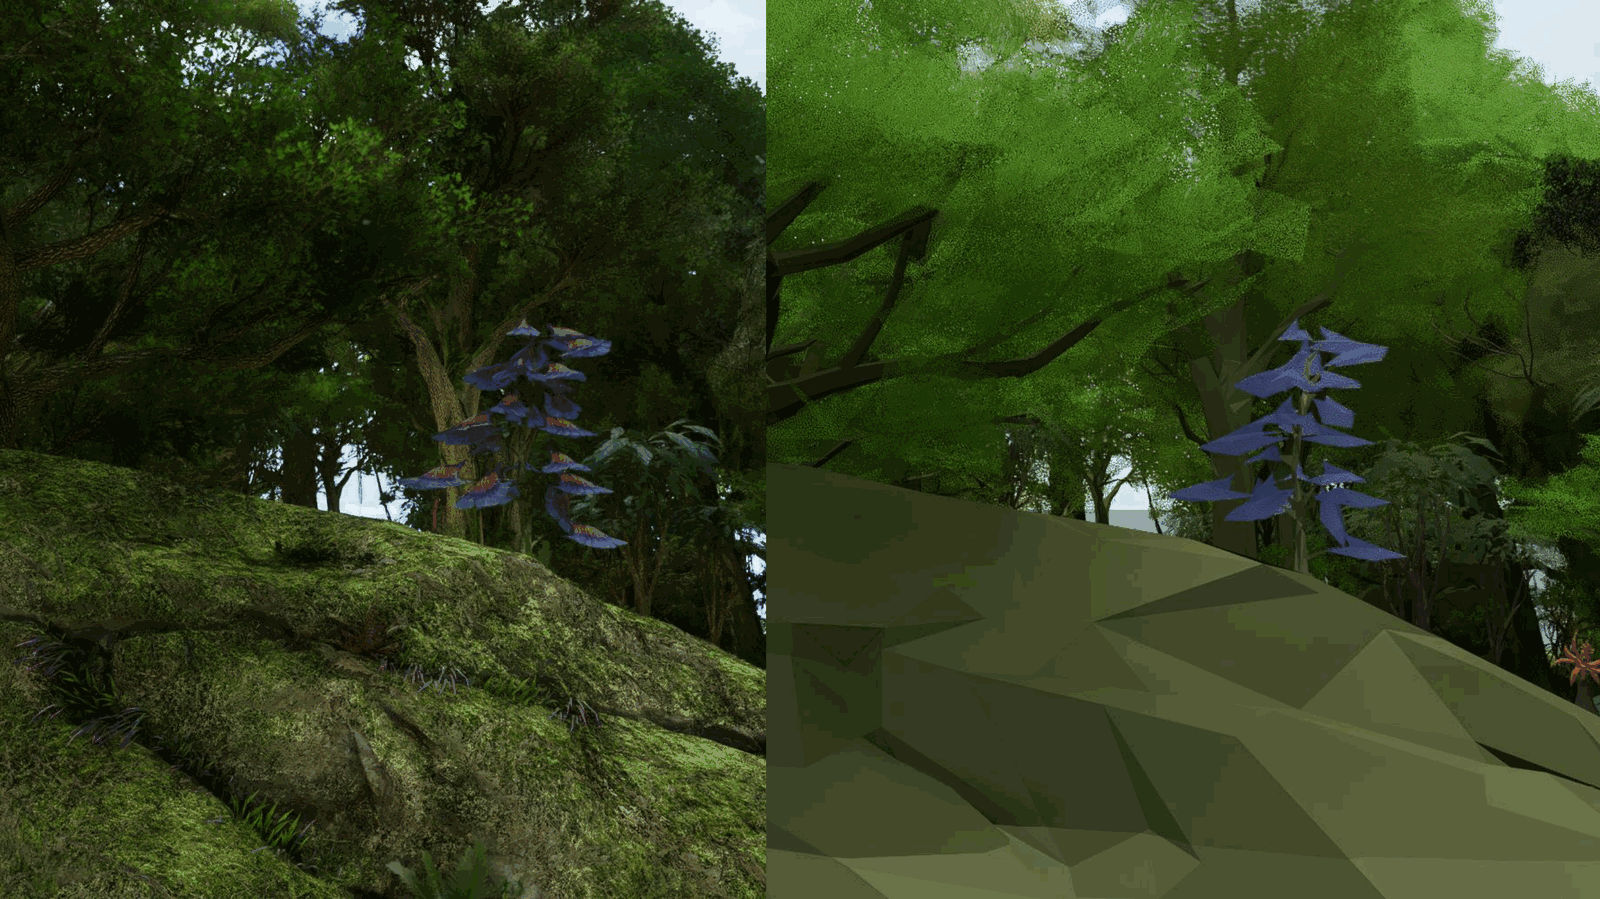
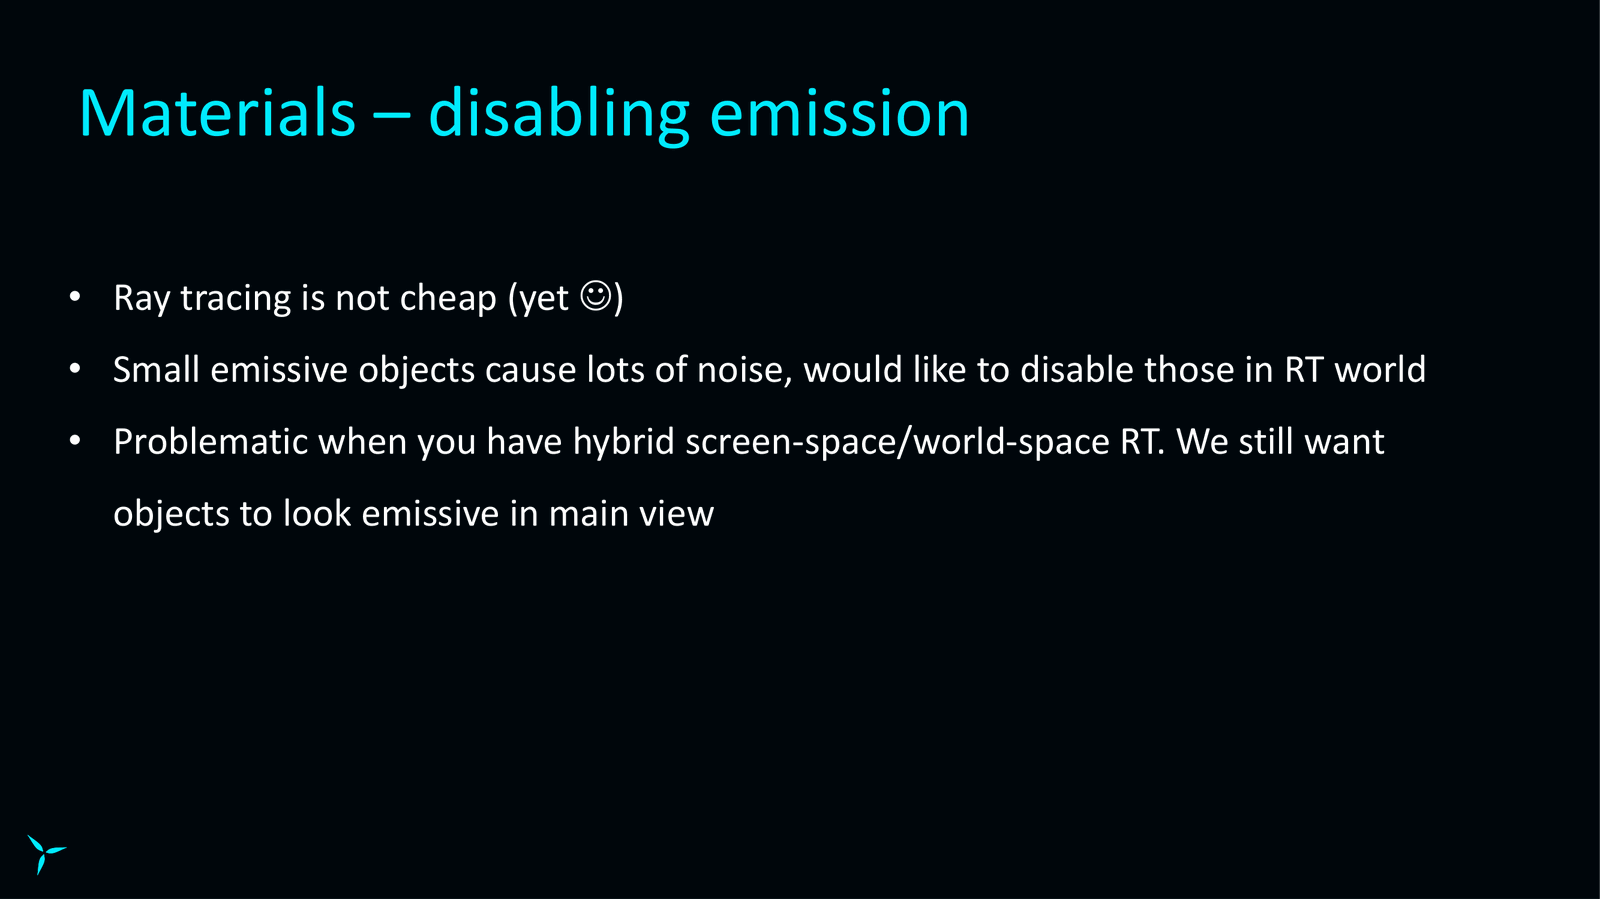
与光栅化世界相比,在这里您还可以看到我们的 alpha 抖动植被。因此,不幸的是,光线追踪并不便宜,至少目前为止,而且小型发射物体可能会产生大量噪音。
而且我们没有预算来通过噪音消除噪音,或者说我们没有预算。
Slide 67 — 00:39:51
📌 要点汇总
- 禁用小的发射物体可以减少光线追踪中的问题,特别是在混合屏幕空间和世界空间光线追踪的情况下。
- 屏幕空间中的自发光对象可能与光线追踪中的自发光对象冲突,需明确区分两者。
- 《阿凡达》采用了一种解决方案,但具体细节未提及,可能涉及自发光对象的管理或渲染优先级调整。
为了首先发送更多光线来避免这种情况,所以我们需要禁用那些小的发射物体。当您拥有具有世界空间光线追踪的混合屏幕空间时,这是有问题的。
我们仍然希望对象在主视图中看起来自发光,但是如果您在屏幕空间中看到自发光对象,您怎么知道您实际上不希望在光线追踪中出现这种情况?
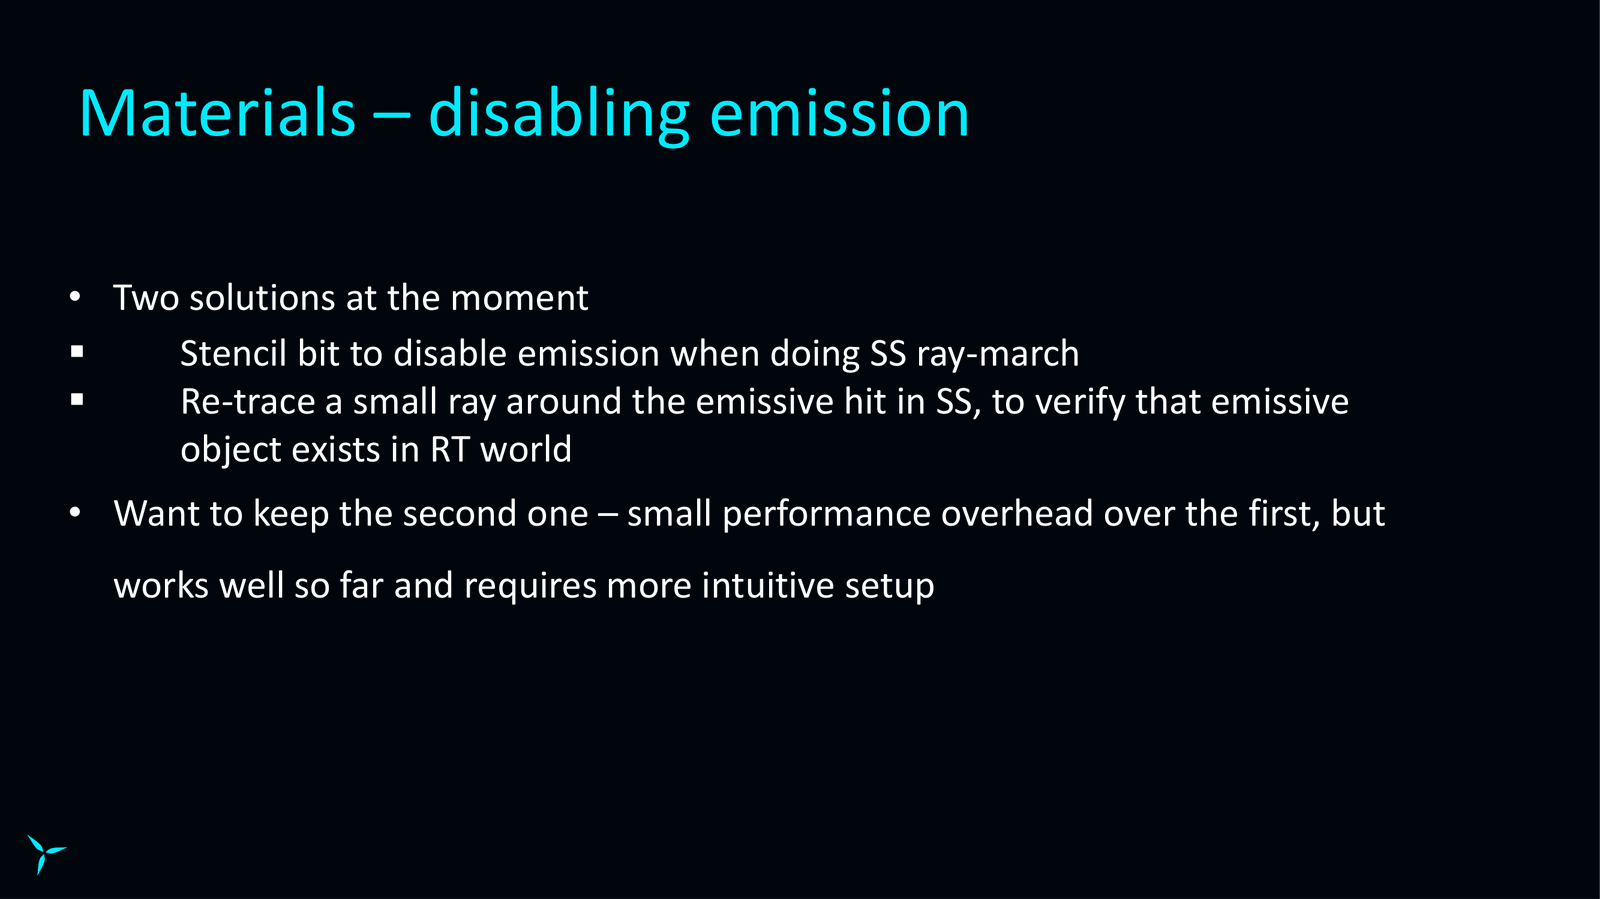
目前我们有两种解决方案,《阿凡达》附带了第一种解决方案。
Slide 68 — 00:40:27
📌 要点汇总
- 一个模板位用于在屏幕空间光线行进中禁用发射,允许艺术家标记网格节点以忽略发射。
- 未来计划采用回溯方法,在屏幕空间中击中后回溯并验证发射是否真实存在。
- 当前方法通过在发射命中周围回溯小射线来验证发射的有效性。
第一个是一个模板位,用于在进行屏幕空间光线行进时禁用发射。因此,艺术家会在屏幕空间中将网格节点标记为禁用发射,并且它将被忽略。
展望未来,我们希望更多地依赖不同的解决方案,即一旦您击中屏幕空间,您实际上会回溯并且它会发光。我们实际上在发射命中周围回溯一条小射线,以验证是否确实存在。
Slide 69 — 00:41:02
📌 要点汇总
- 自发光对象在光线追踪中需要美术师手动设置属性,虽然增加少量性能开销,但提升了直观性。
- “监狱”即将被取代,暗示旧方法或流程即将被淘汰。
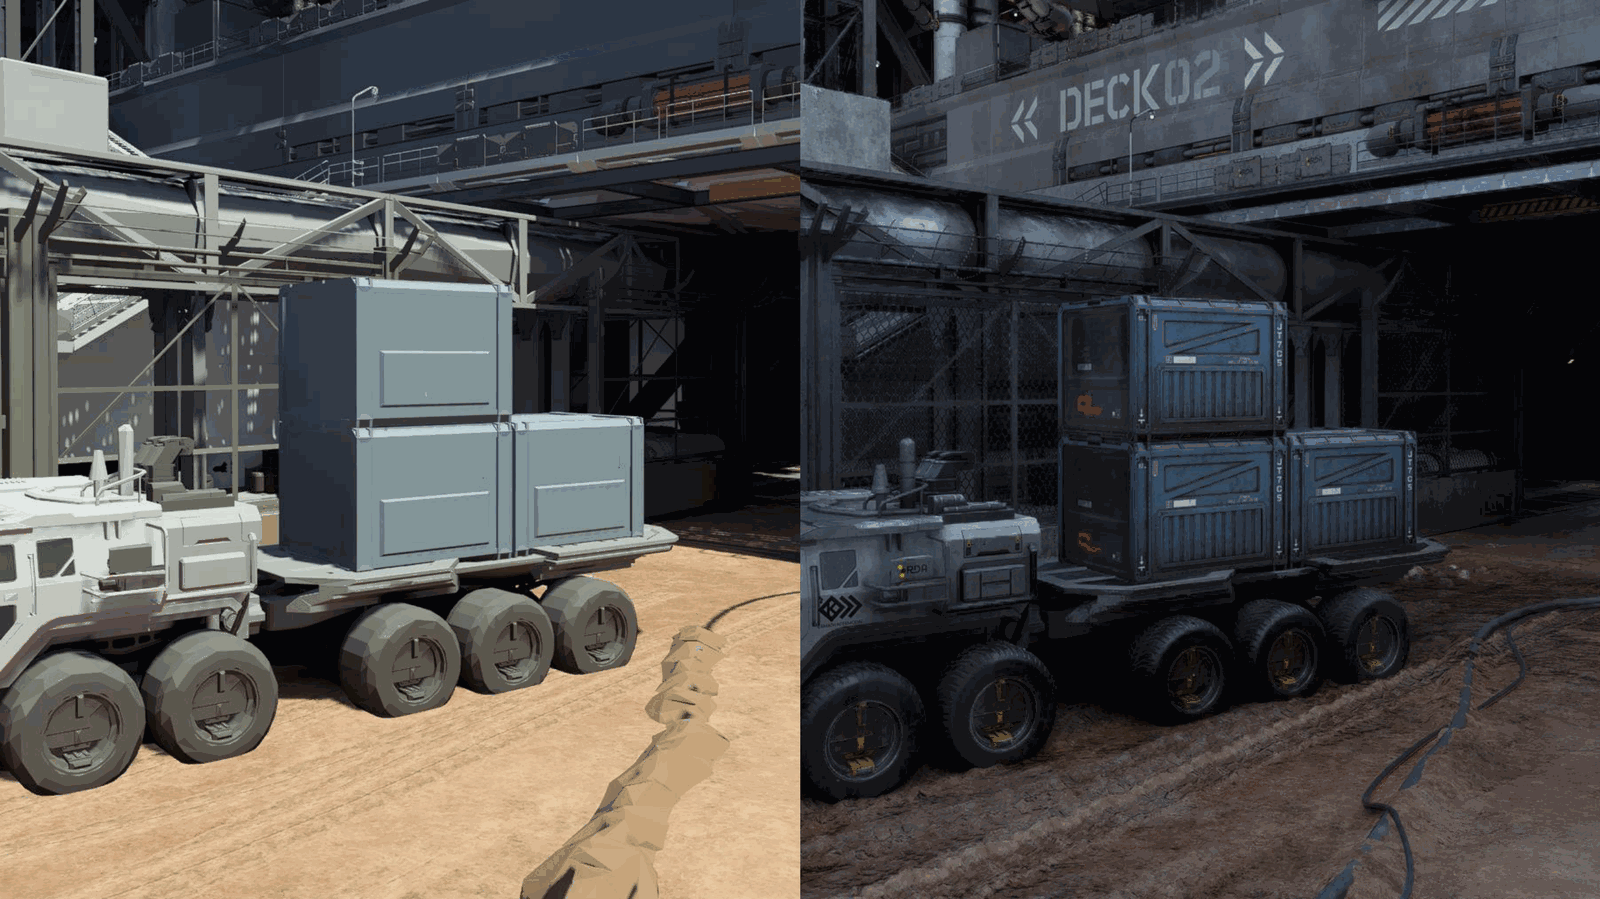
光线追踪世界中的自发光对象,这样美术师需要为网格的光线追踪设置自发光属性,这是一种更直观的方法。它确实有很小的性能开销,但到目前为止效果很好,正如我所说,这对于艺术家来说是一个更直观的设置。
事实上,我们即将迎来“监狱”的终结。
Slide 70 — 00:41:38
📌 要点汇总
- 光线追踪驱动的全局照明在当前一代游戏机中通过精细的工程和技巧实现。
- 新技术为开发人员和艺术家引入了全新的变量,需要持续合作以提升技术理解和应用。
- 随着经验积累和技术进步,未来在该领域的应用有望进一步提升。
总之,我们确实需要仔细的工程和技巧的结合,但光线追踪驱动的全局照明在这一代游戏机中是可能的。
还值得一提的是,这对我们和艺术家来说都是一组全新的变量,随着我们继续合作,技术和对如何使用该技术的理解都会不断发展。
希望未来只会变得更好。
Slide 71 — 00:42:13
📌 要点汇总
- (Transitional content, no key points)
非常感谢。如果您有任何疑问,请靠近麦克风。
嗨,谢谢你的谈话。
Slide 72 — 00:42:48
📌 要点汇总
- The speaker mentions exploring traversal performance on the console when using DXR or platform-specific APIs for TLAS, but no current API implementation exists on the console.
- The discussion briefly touches on bottom-up decision structures but lacks detailed technical implementation or specific metrics.
- The content appears transitional and lacks substantive technical details or lessons learned.
如果您要使用 DXR 或其他特定于平台的 API 构建 TLAS,您是否尝试过比较控制台上的遍历性能?不,这很有趣,我很想看到这一点。也许我们会这样做,但目前我们在控制台上没有任何 API 实现。这只是我们定制的。
关于自下而上决策结构的出现。因此,只为喜欢。
Slide 73 — 00:43:24
📌 要点汇总
- The system can analyze individual objects or entire scenes, including merging objects by identifying empty spaces.
- An example is merging two separate meshes into a single object.
- The approach also supports merging multiple mesh nodes into one during scene analysis.
单个对象,或者您还可以分析整个场景,例如检查场景上的空白空间,并以这种方式合并对象。因为在您展示的示例中,就像一个实际上由两个网格组成的单个对象,并且合并该网格很简单。
但您是否也对整个场景进行了分析?我们这样做。所以问题是,我们将多个网格节点合并为一个。
Slide 74 — 00:43:59
📌 要点汇总
- The discussion explores whether different materials are used in complex scenes with custom BVH.
- Custom BVH supports material variation, but DXR does not implement this feature.
- DXR allows combining multiple geometries but lacks material-specific BVH customization.
- The absence of material-based BVH in DXR may be due to design or performance considerations.
BVH,但是我们是否使用不同的材质来制作更复杂的场景?但是我们是否对整个场景都这样做?我们对自定义 BVH 是这样做的。是的,绝对是。但我们从来没有为 DXR 这样做。有什么特别的原因吗?因为,就像您支持从自定义 BVH 分析场景一样。所以,在 DXR 中,如果你愿意这样做,你就像需要组合多个几何图形。
Slide 75 — 00:44:34
📌 要点汇总
- 单输入加速调用无法实例化,需使用独特几何形状,增加内存压力
- 《阿凡达》大量依赖实例化,但内存压力限制了这种方法的使用
- 内联重新训练方法比完全重新训练管道更简单,无需材质评估和复杂设置
- DXR 1.1的内联跟踪简化了流程,只需在着色器中添加代码即可实现
- 不需要使用DXR 1.0提供的功能,使实现更直接和高效
单输入加速调用,并且您无法进行实例化,因此您必须对组合在一起的所有内容使用独特的几何形状,这是我们想要避免的内存压力。是的。所以这就是我们不这样做的原因。对于每个对象来说这很好,因为无论哪种方式这都将是唯一的几何体,但是是的,因为我记得 Gaias Activision 的 C D C 的一次演讲,他们在实例化方面也有同样的问题。就像他们只有在有一个实例时才会这样做。是的,我们在《阿凡达》中大量依赖实例化,所以值得考虑。但是,是的,记忆对我们来说已经有点压力了,我不认为这对我们有好处。但这是一个选择。好的。谢谢。
嗨,我是路易斯。讲得很好。我想知道为什么你选择常规的内联再训练,而不是使用完全再训练管道。抱歉,我没听清。当您使用直接DSR时,您选择使用内联重新训练来方法,但是为什么不使用原始流管道来重新训练管道?所以问题是,为什么我们只使用DXR 1.1中的内联跟踪而不是原始DXR 1.0实现?是的。这样我们在遍历的过程中就不需要评估材料了。就像材质评估一样,只是从内存中读取数据,从内存中读取单个数据,所以我们不需要所有的设置来完成类似需要间接执行TXR 1.0提供的材质评估,然后在这种情况下内联跟踪要简单得多。我们只需将代码放入我们想要的着色器中即可。它只是基本上简单得多。我们不需要 1.0 提供的任何功能。谢谢。我想就是这样。非常感谢。