【GDC 2024】144FPS Rendering on Mobile Frame Prediction in Arena Breakout
来源:GDC 2024 提取时间:2026-05-15
感谢您提供的详细内容!这段内容涵盖了两个非常重要的技术主题:
- 帧预测(Frame Prediction):一种用于提升游戏性能、降低功耗、提高帧率的技术,尤其适用于移动端游戏开发。
- 移动光线追踪(Mobile Ray Tracing):在《Arena Breakout》中实现的光线追踪技术,包括反射、软阴影、环境光遮挡等,用于提升画面真实感和沉浸感。
以下是对这两个部分的总结与提炼,便于理解、分享或进一步研究:
一、帧预测(Frame Prediction)技术总结
1. 技术背景
- 主流移动设备已支持高屏幕刷新率(90/120/144 Hz甚至更高),玩家期望在不降低图形质量的前提下获得更流畅的游戏体验。
- 高帧率面临三大挑战:图形质量与帧率冲突(更高图形质量需要更多渲染时间,会降低帧率)、大量电池功耗、电池过热。
- 现有方法均存在明显缺陷:
- 深度学习:依赖特定硬件,无法在所有设备上使用;运行神经网络的时间和电池功耗开销大,有时甚至超过渲染一帧图形的开销。
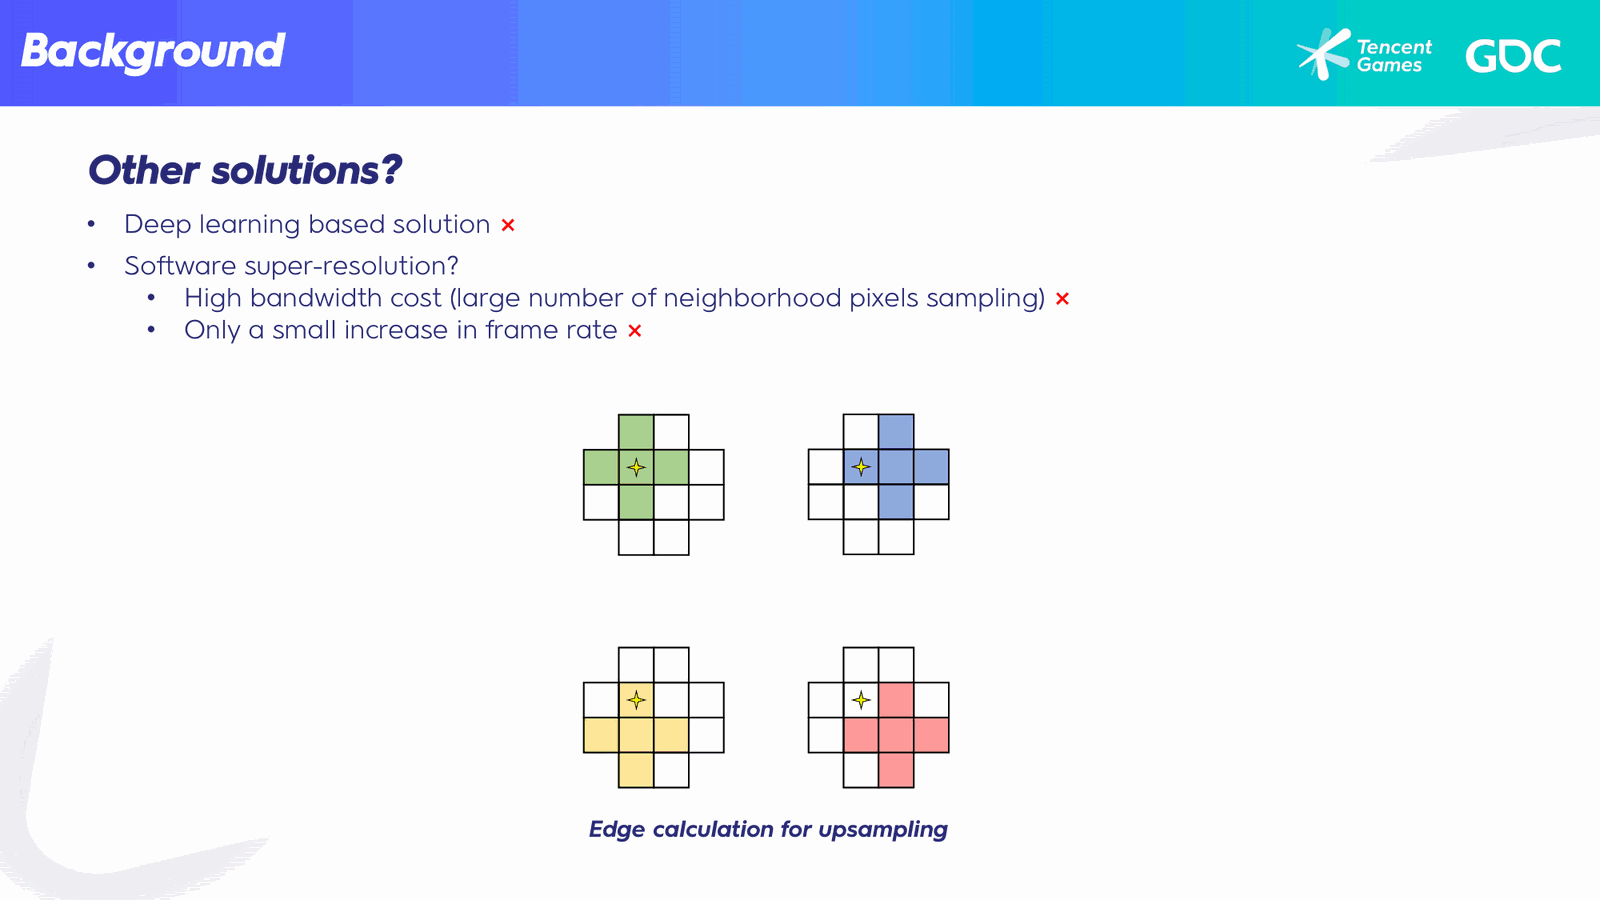
- 软件超分辨率(如FSR):需要大量邻域像素采样(FSR需12个邻域像素),时间和带宽成本高,对移动设备不友好;且在移动设备上帧率提升有限,无法满足高帧率需求。
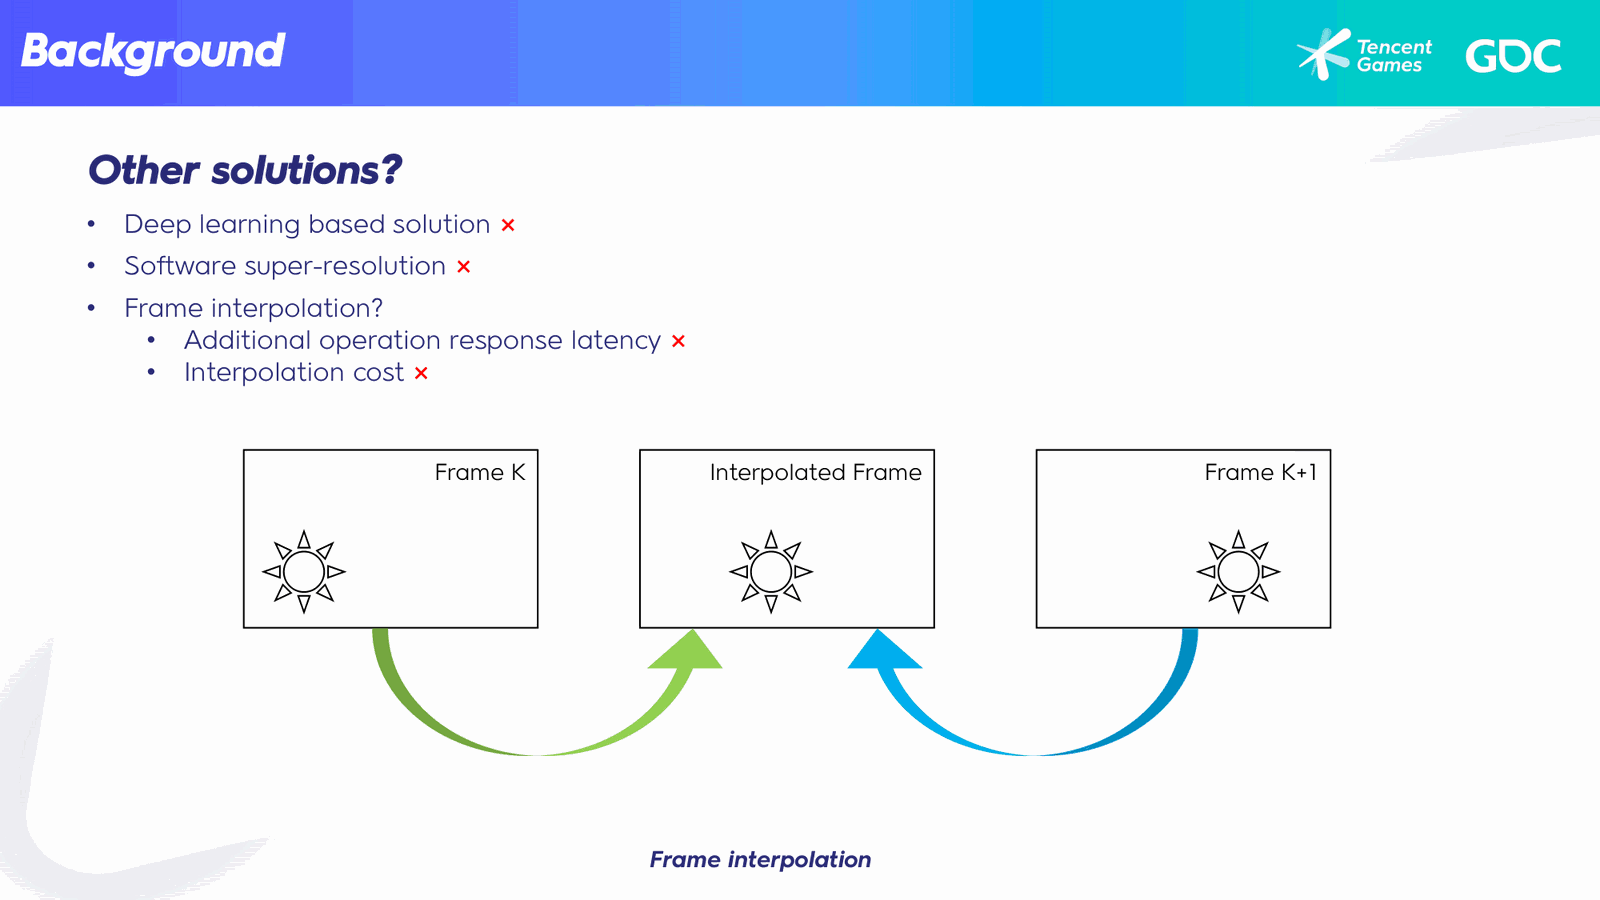
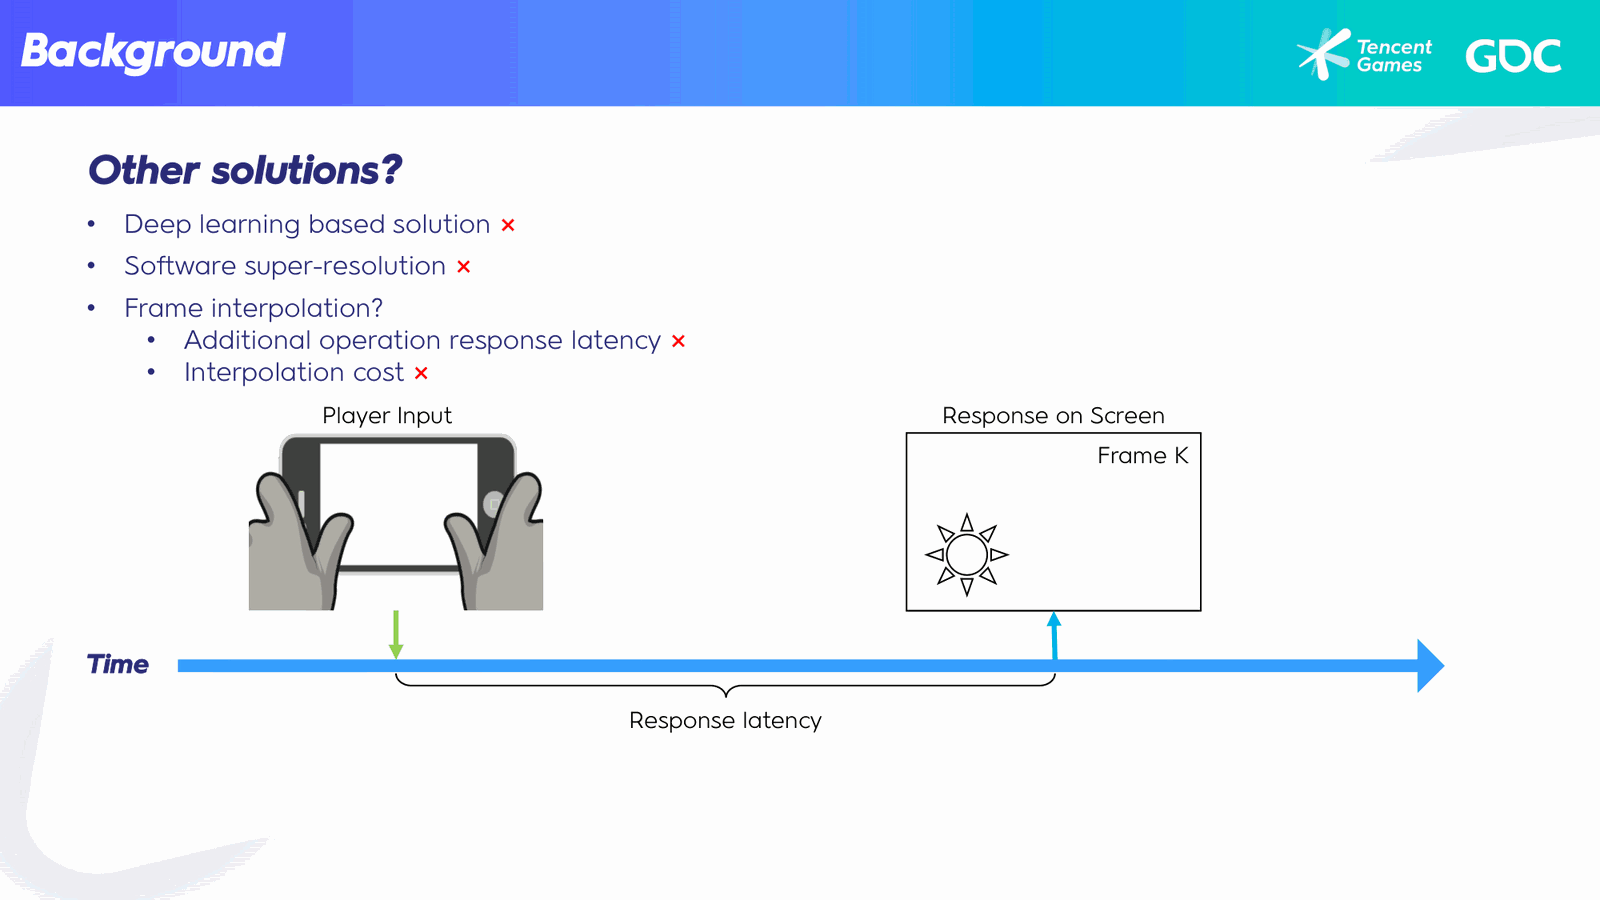
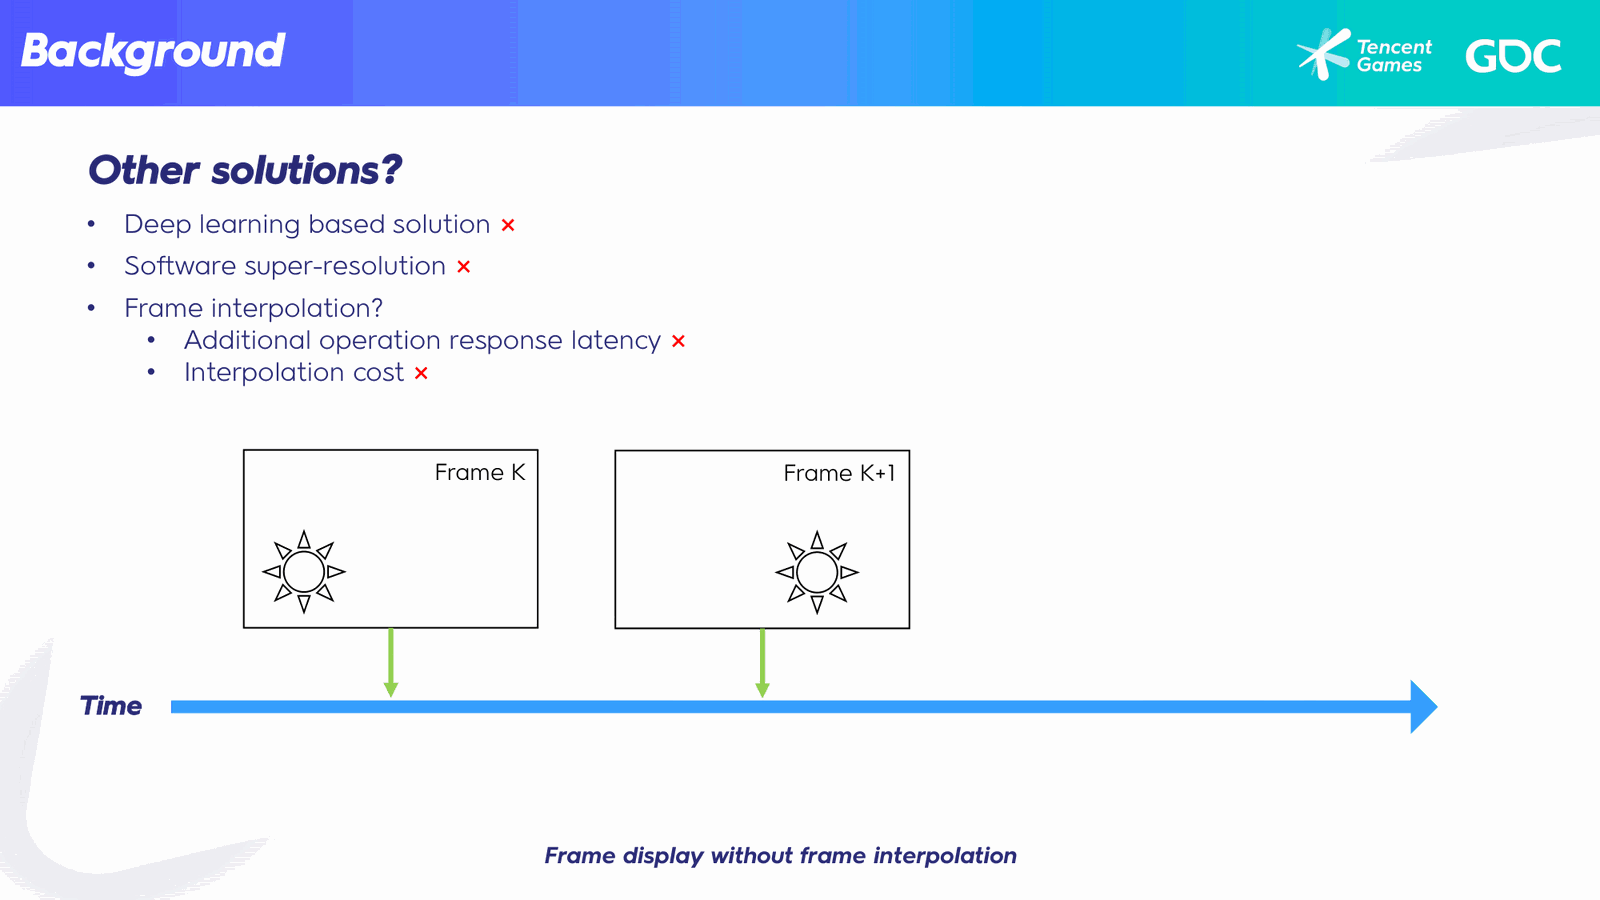
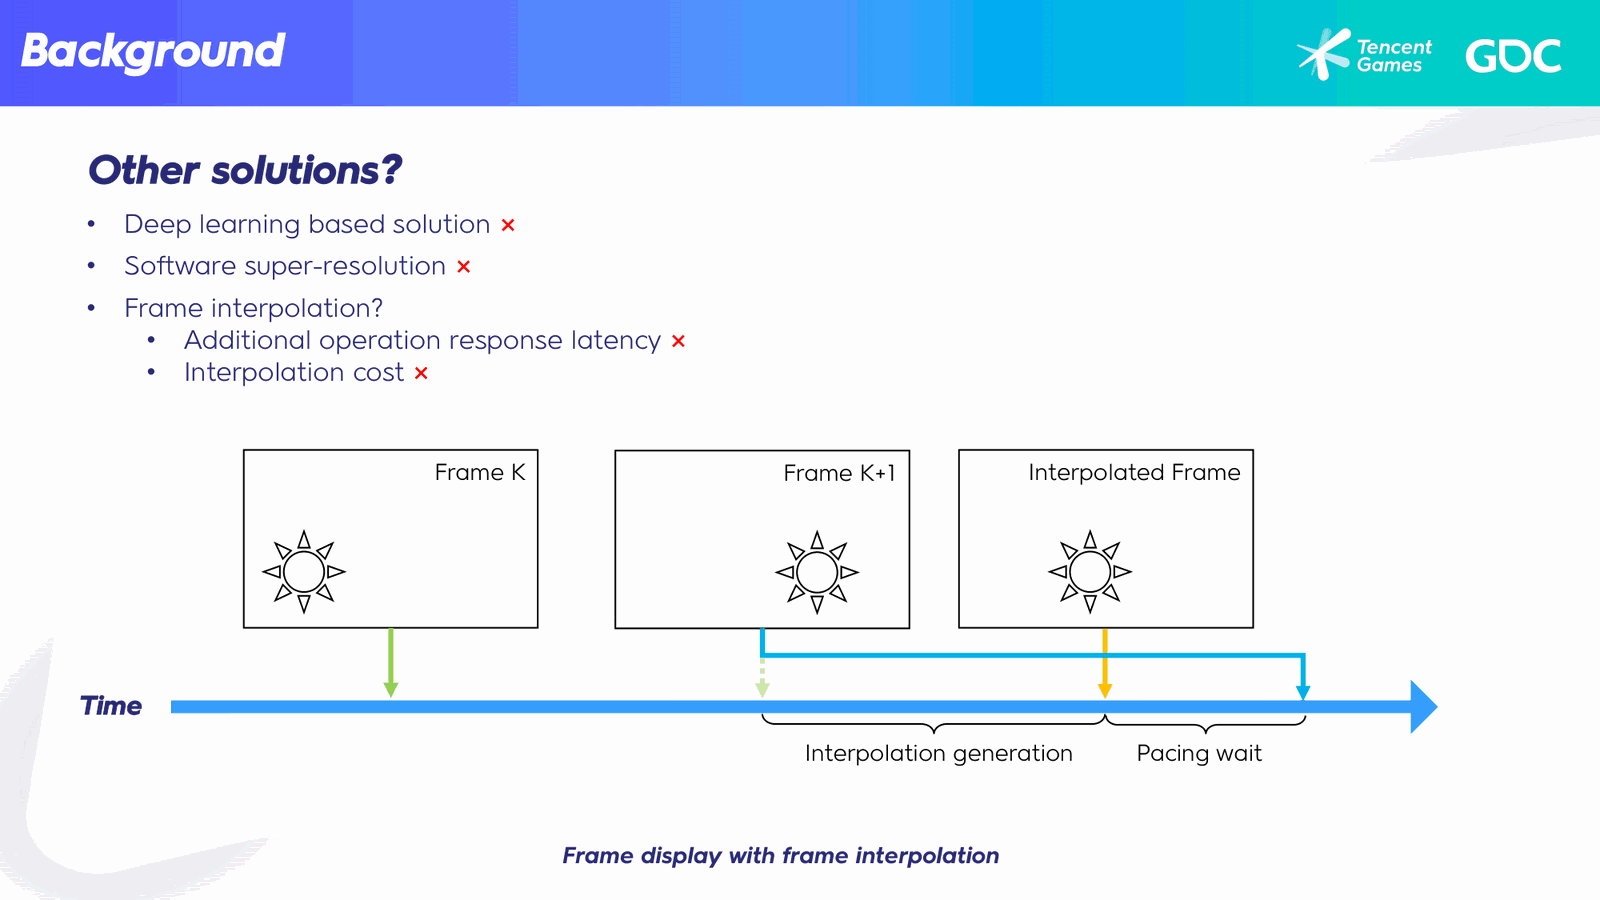
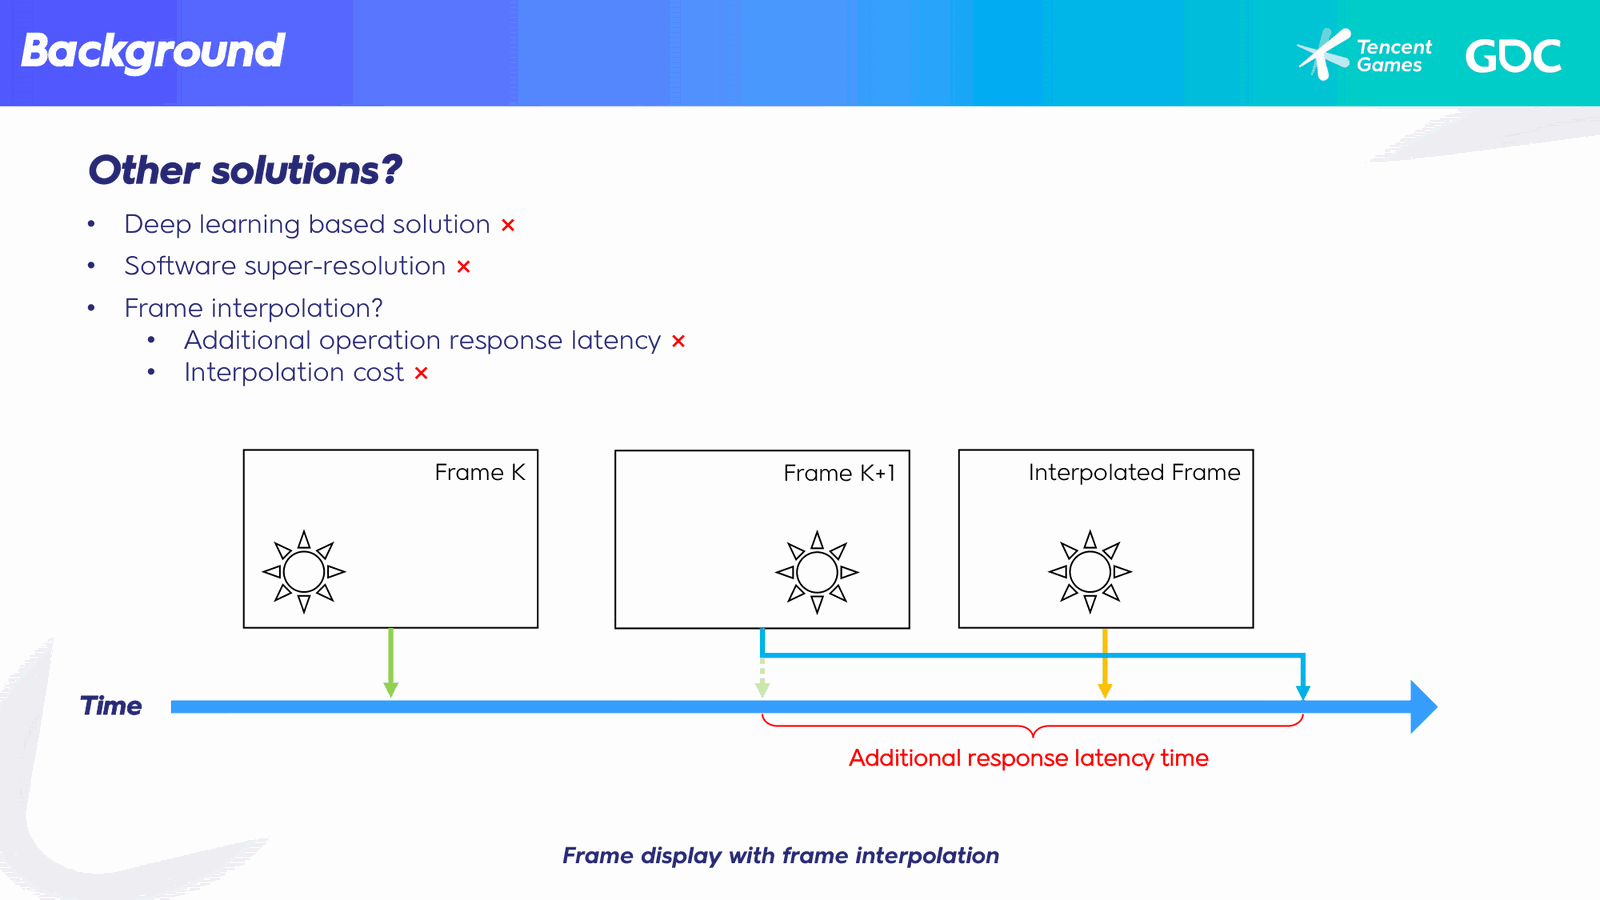
- 帧插值:使用前一帧和后一帧生成中间帧,但会引入额外的操作响应延迟时间(跟手延迟),导致带插帧的120Hz体验比不带插帧的60Hz更差,在动作游戏中影响尤其严重。
- 因此需要一种简单、快速、无额外延迟、稳健、高效且高度兼容(不依赖特定硬件)的解决方案。
2. 核心原理
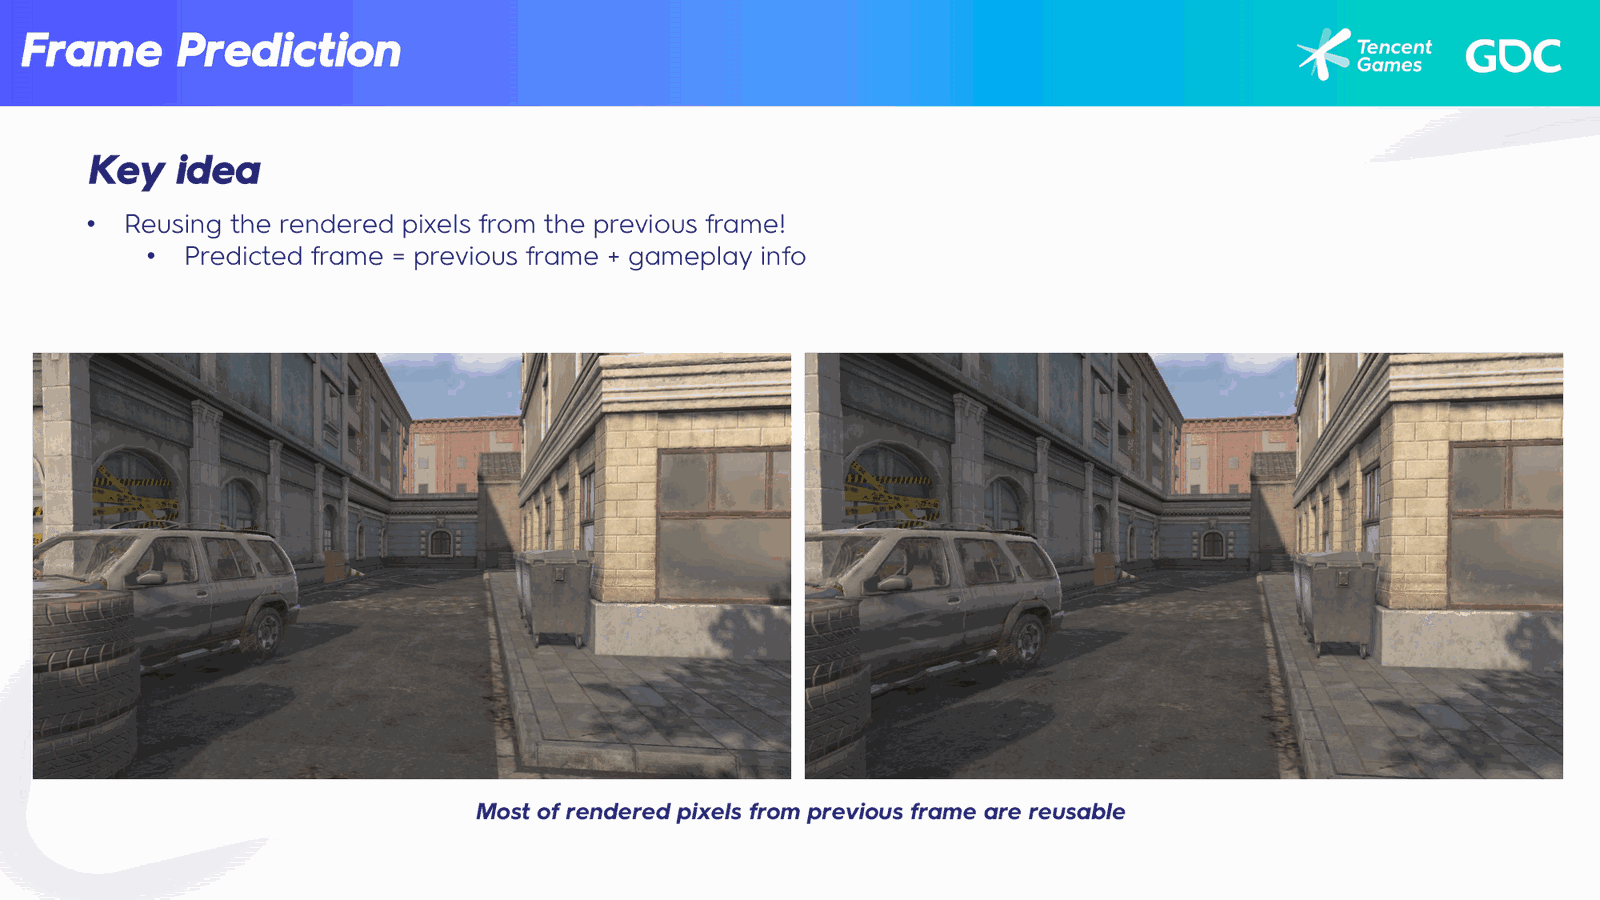
- 核心思想:相邻两帧非常相似,大部分渲染像素可被复用。通过前一帧的渲染结果和当前帧Game线程的信息生成预测帧。
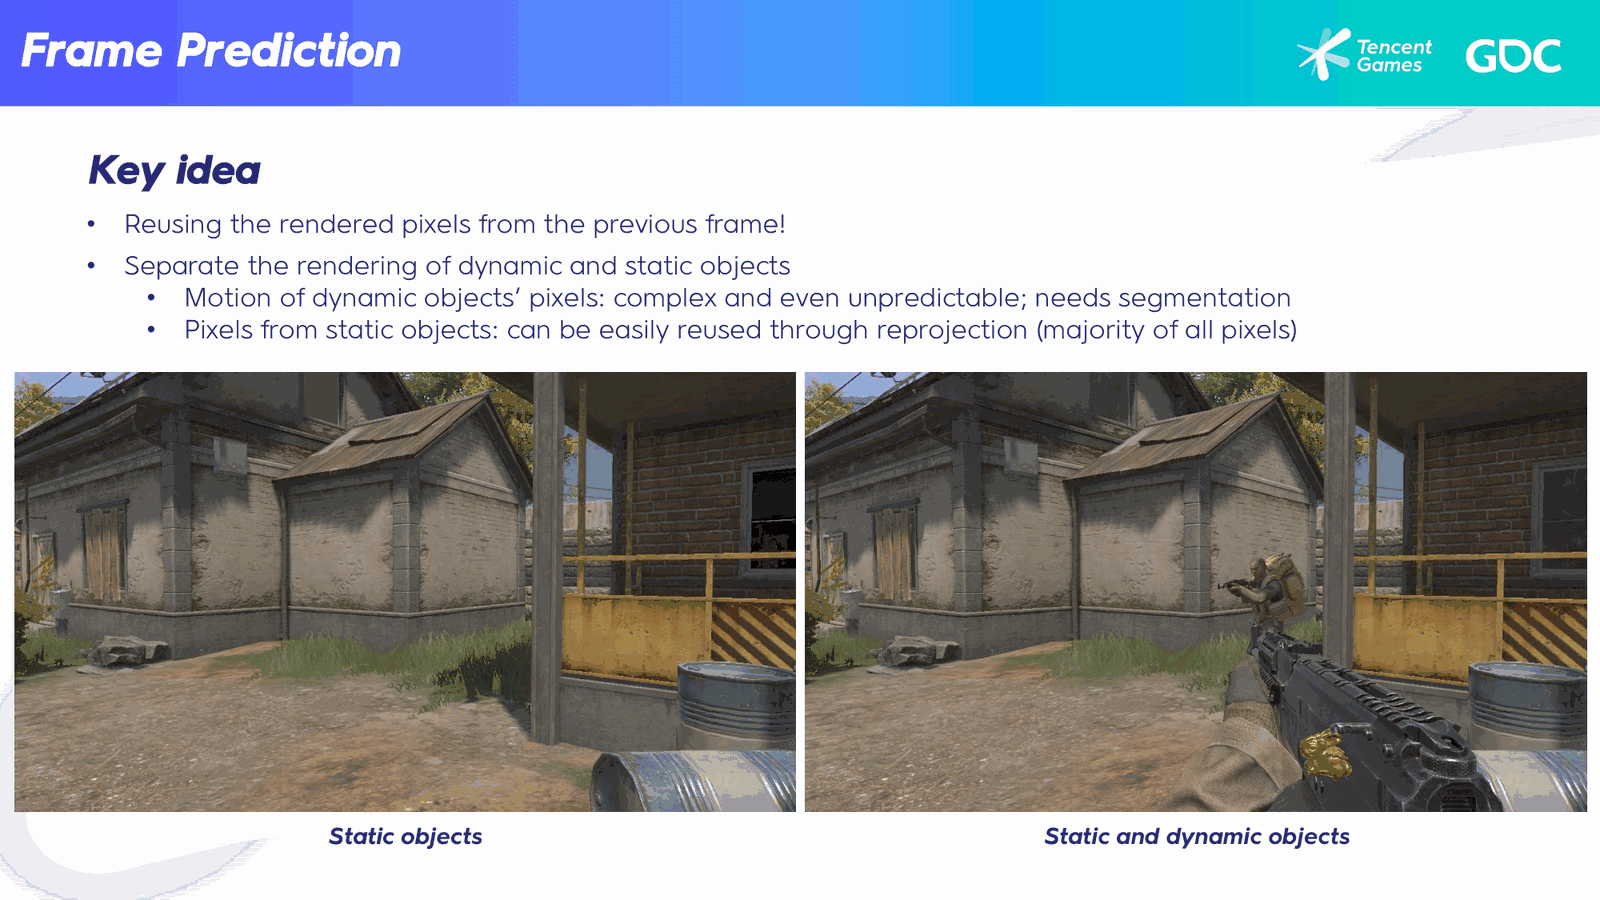
- 静动态分离:将静态对象和动态对象的渲染分开,在所有静态对象渲染完毕后才绘制动态对象。帧预测仅用于静态对象的像素——光流等动态对象预测方法在移动设备上成本高且容易出错,且动态对象运动不可预测(依赖其他玩家输入),在硬核FPS中预测错误的后果不可接受。
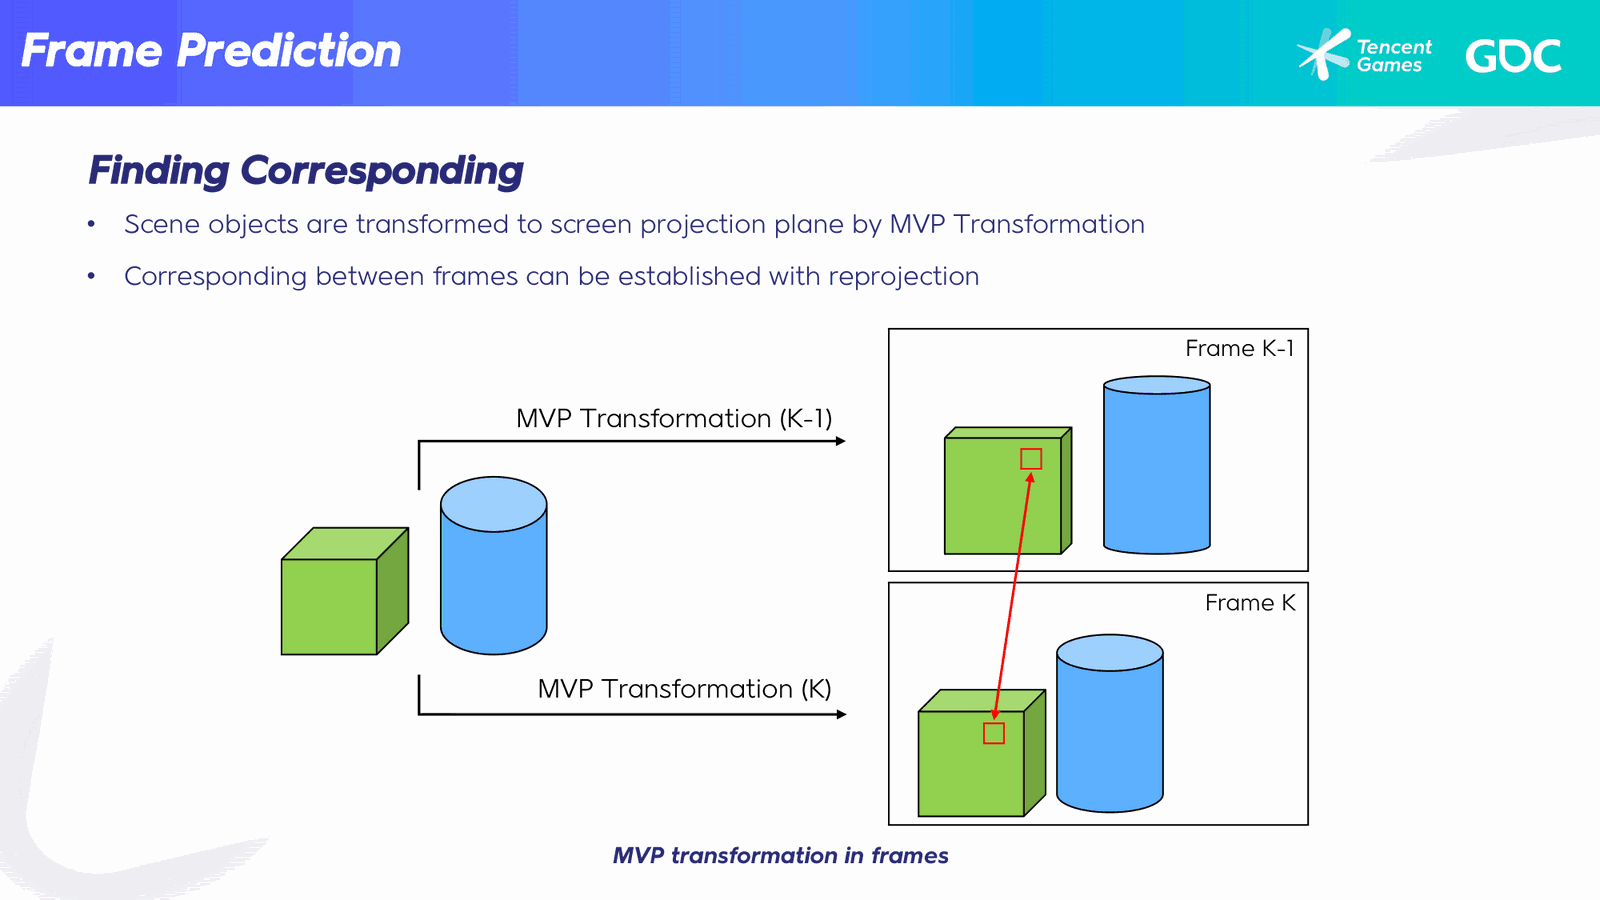
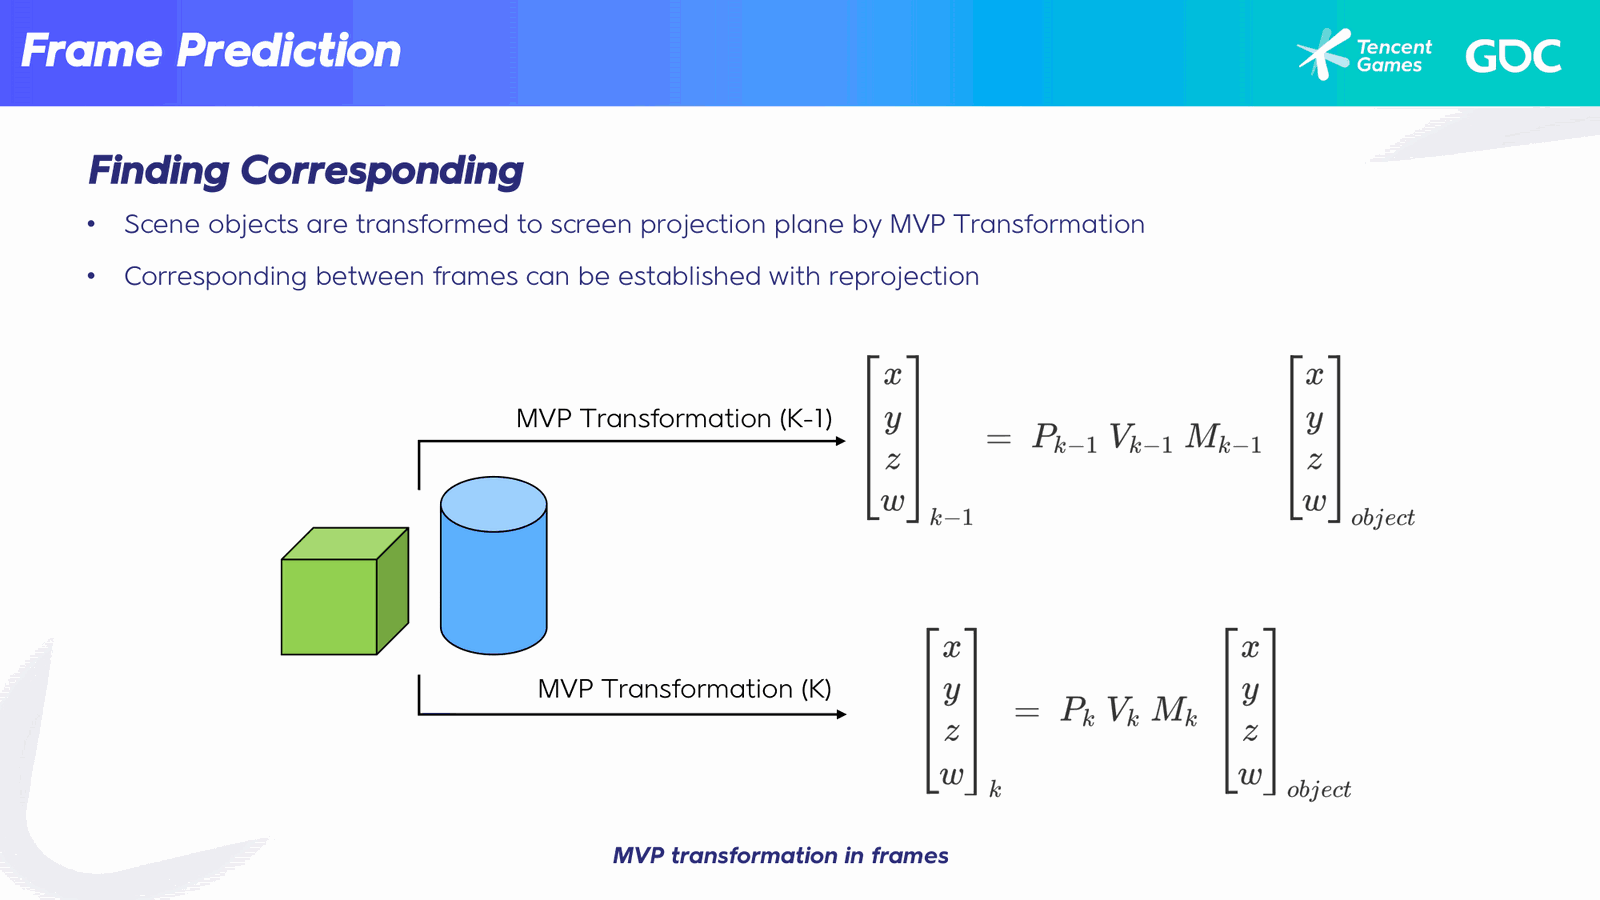
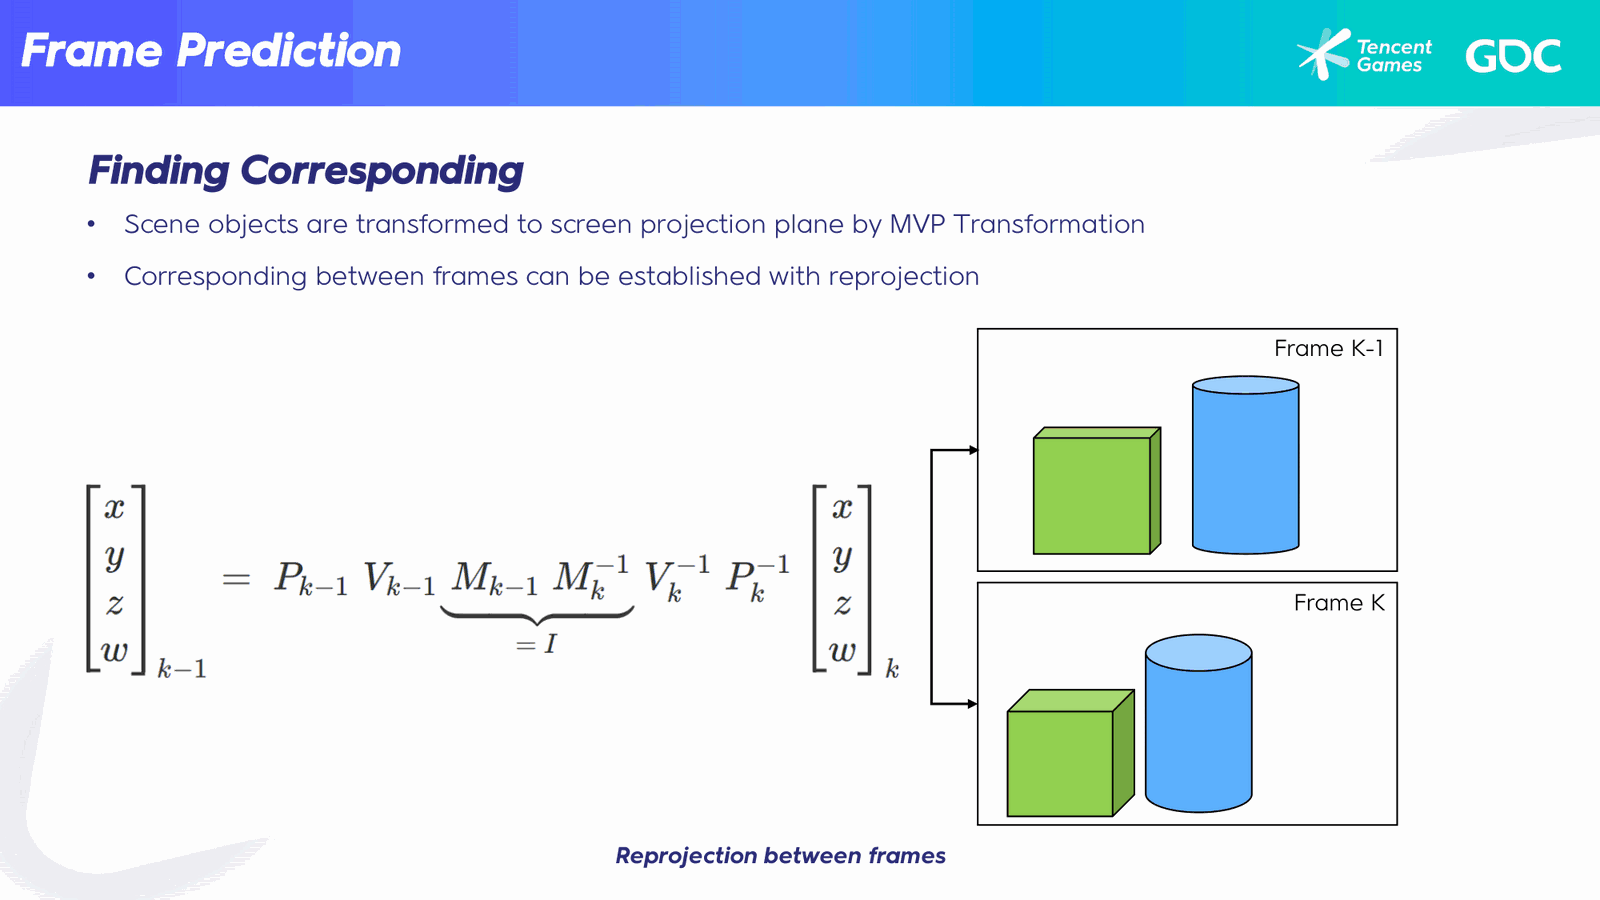
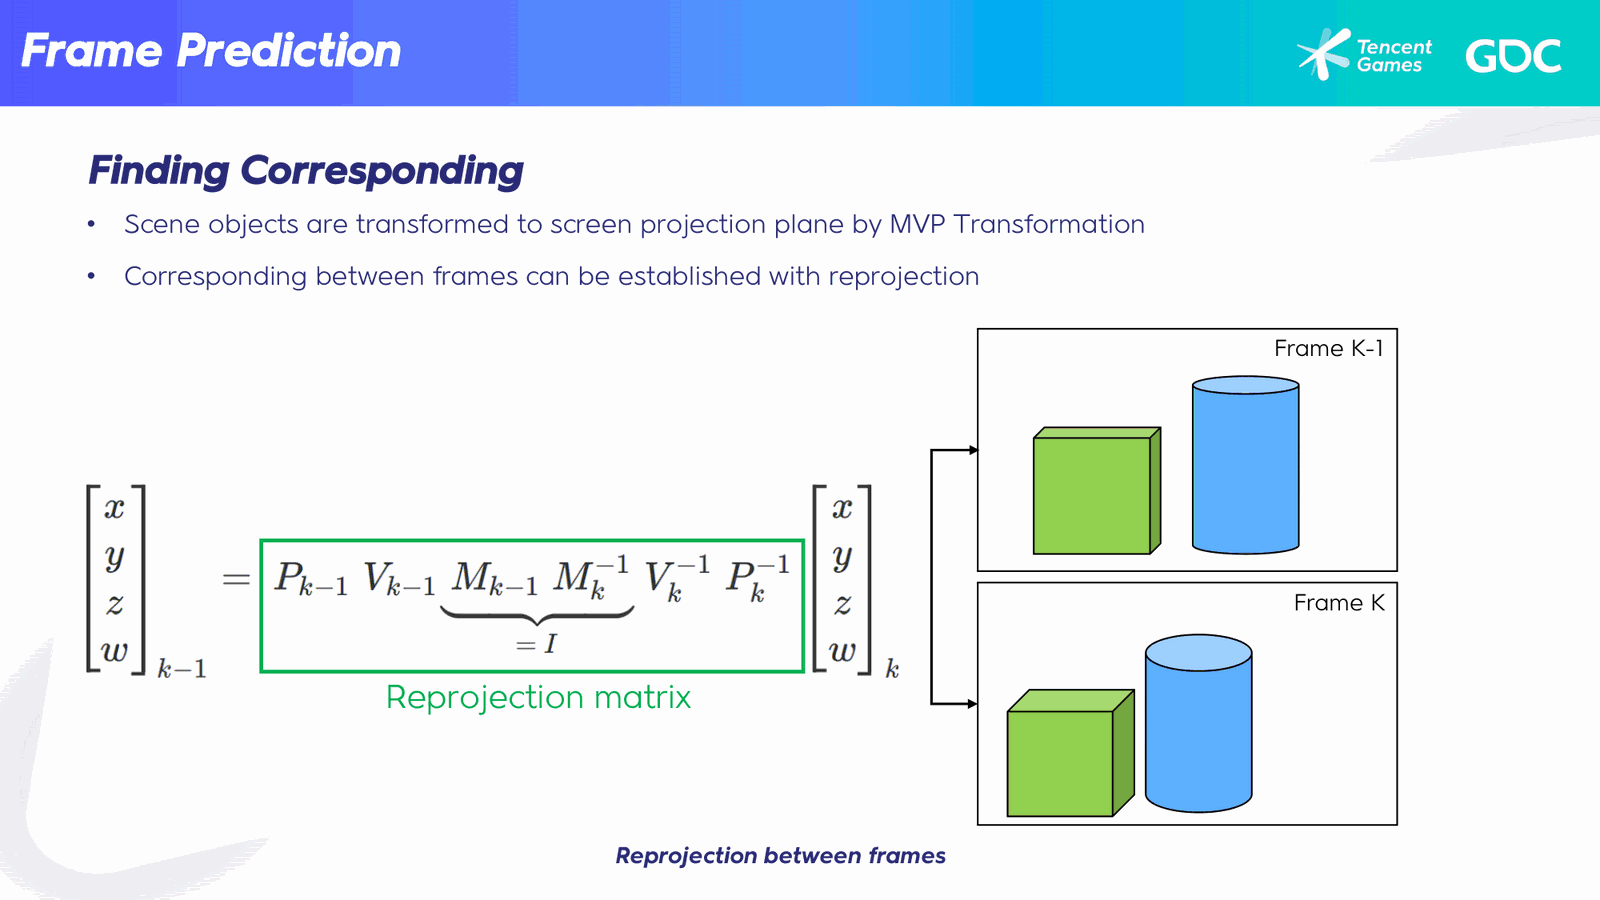
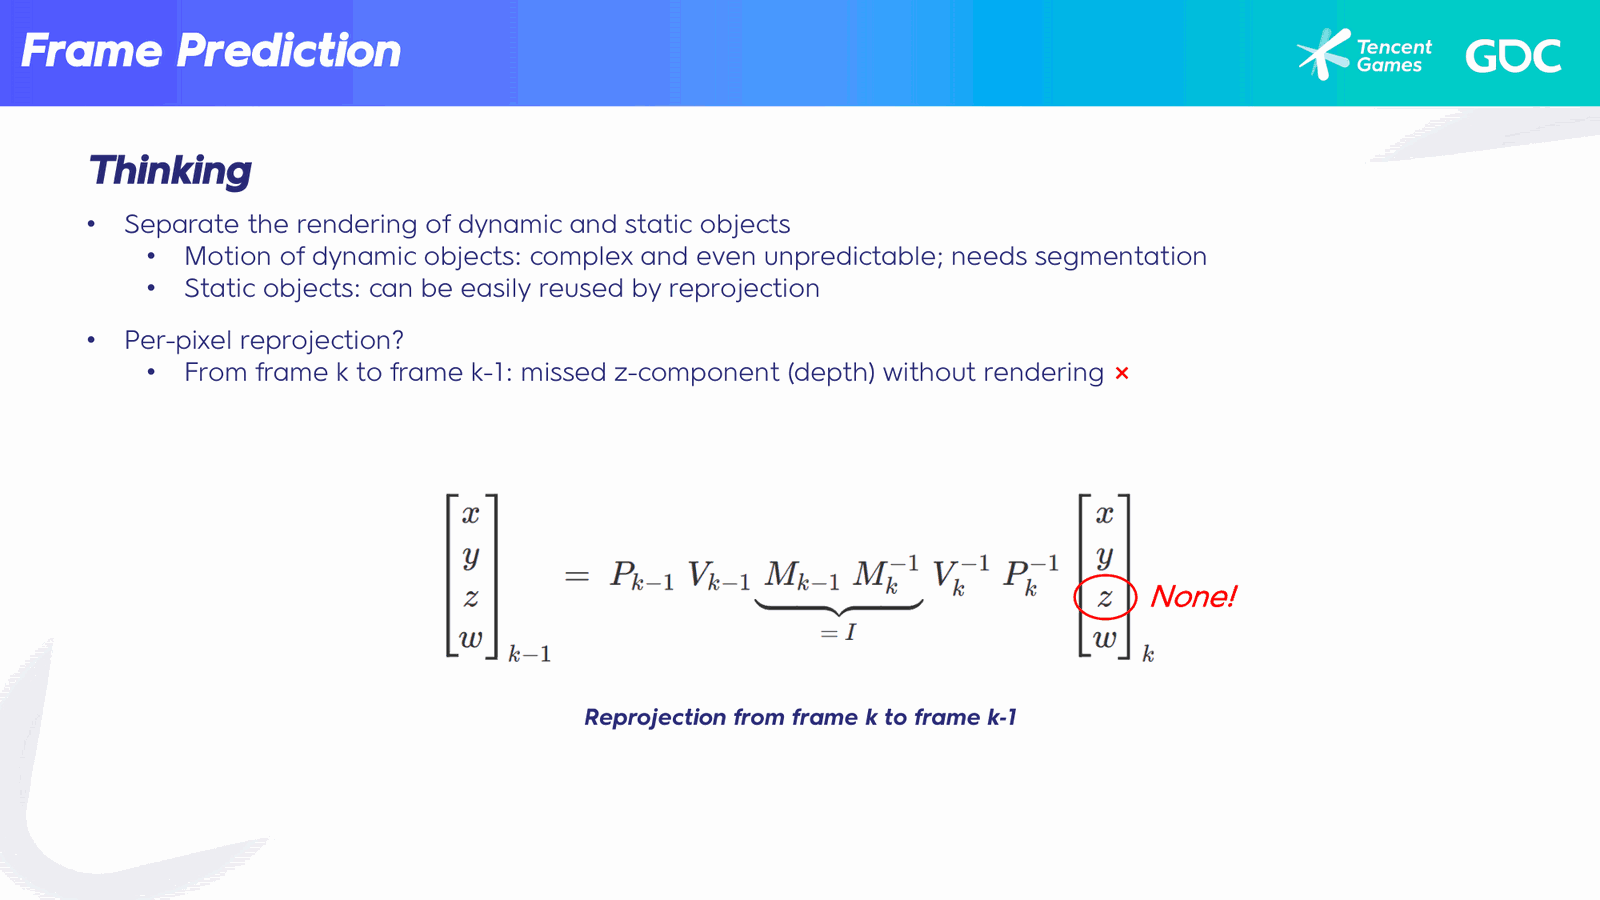
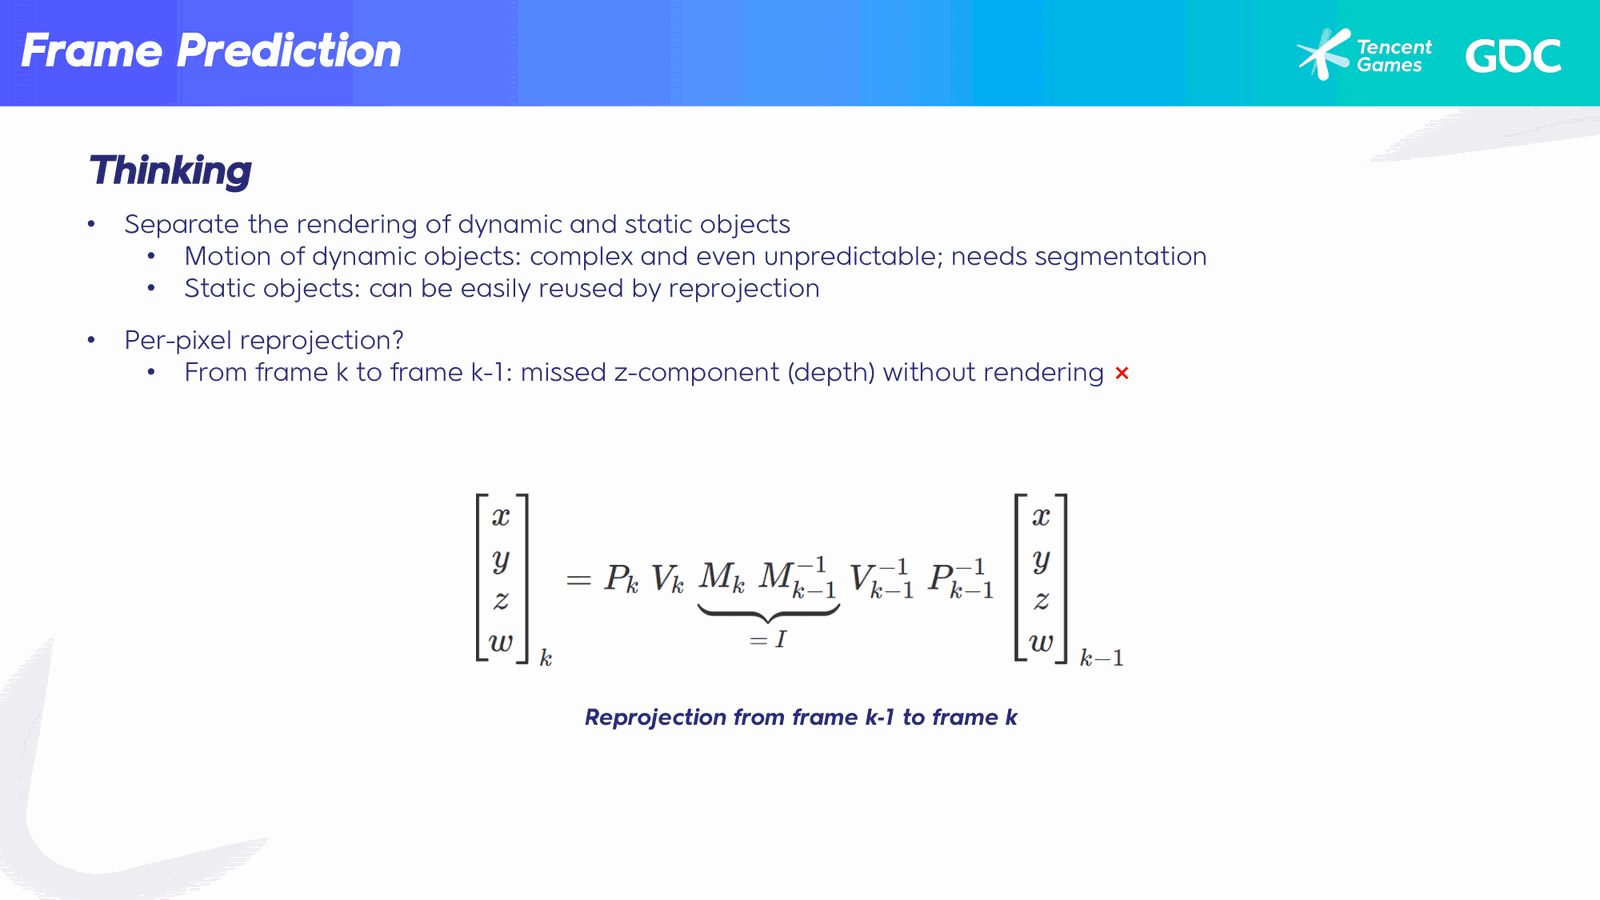
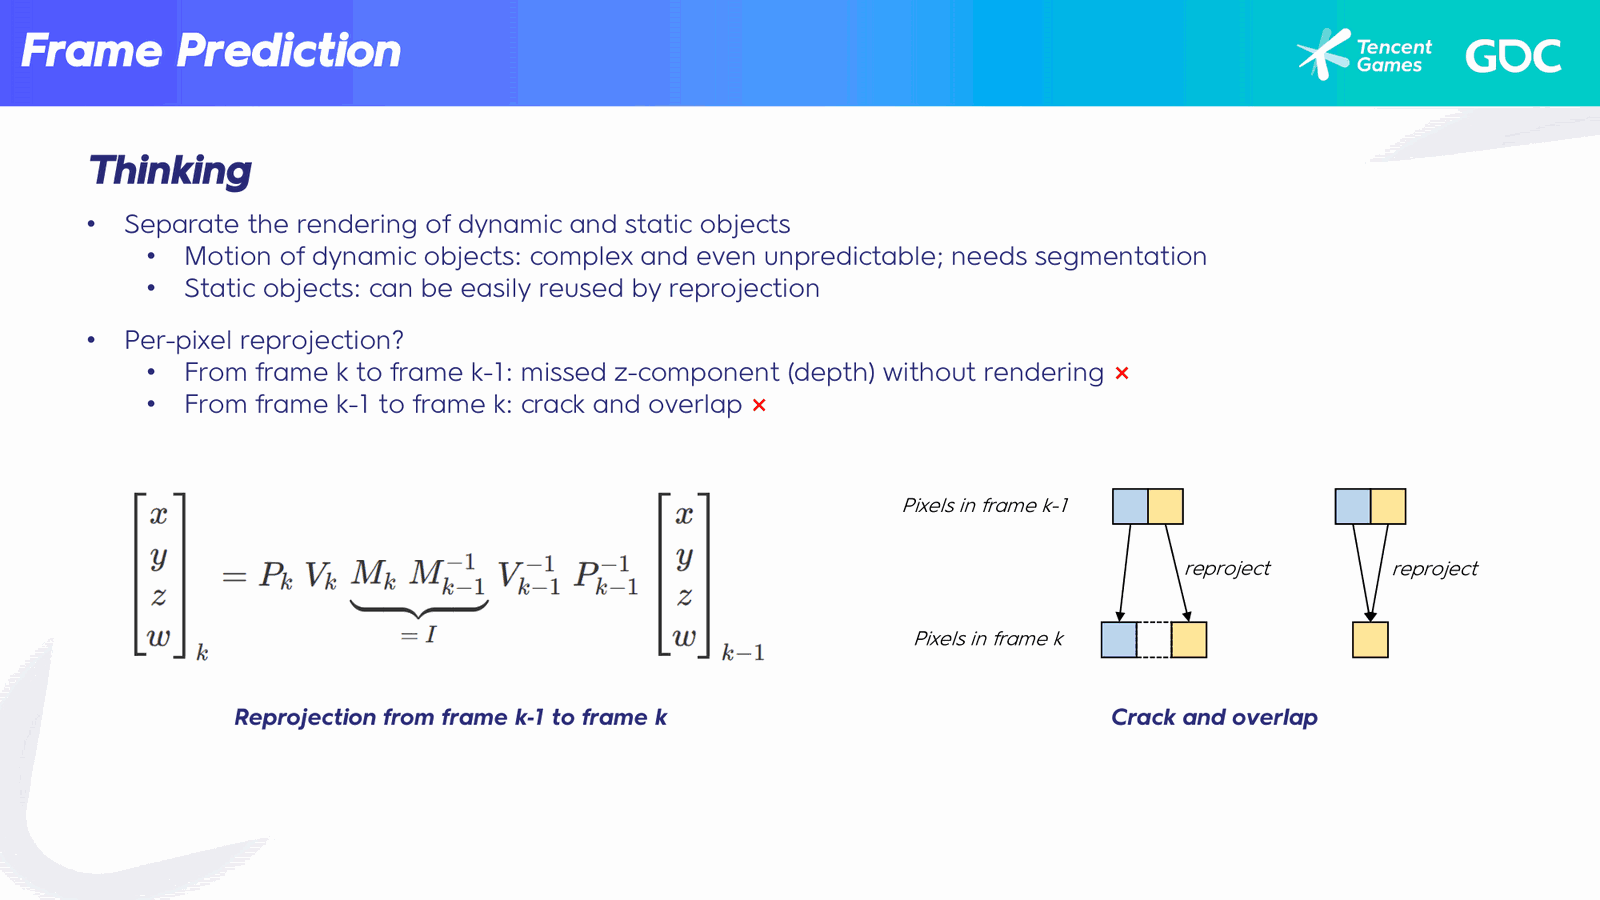
- 重投影(Reprojection):复用的关键是找到前一帧到当前帧的像素对应关系。通过MVP变换建立两帧间的对应关系:对于静态对象,M矩阵不变,M_{k-1} × M_k^{-1}始终为单位矩阵,由此推导出重投影矩阵。由于无法在未渲染时获取裁剪空间位置的Z分量(需从帧缓冲区的SceneDepth获取),因此使用从前一帧到当前帧的重投影。
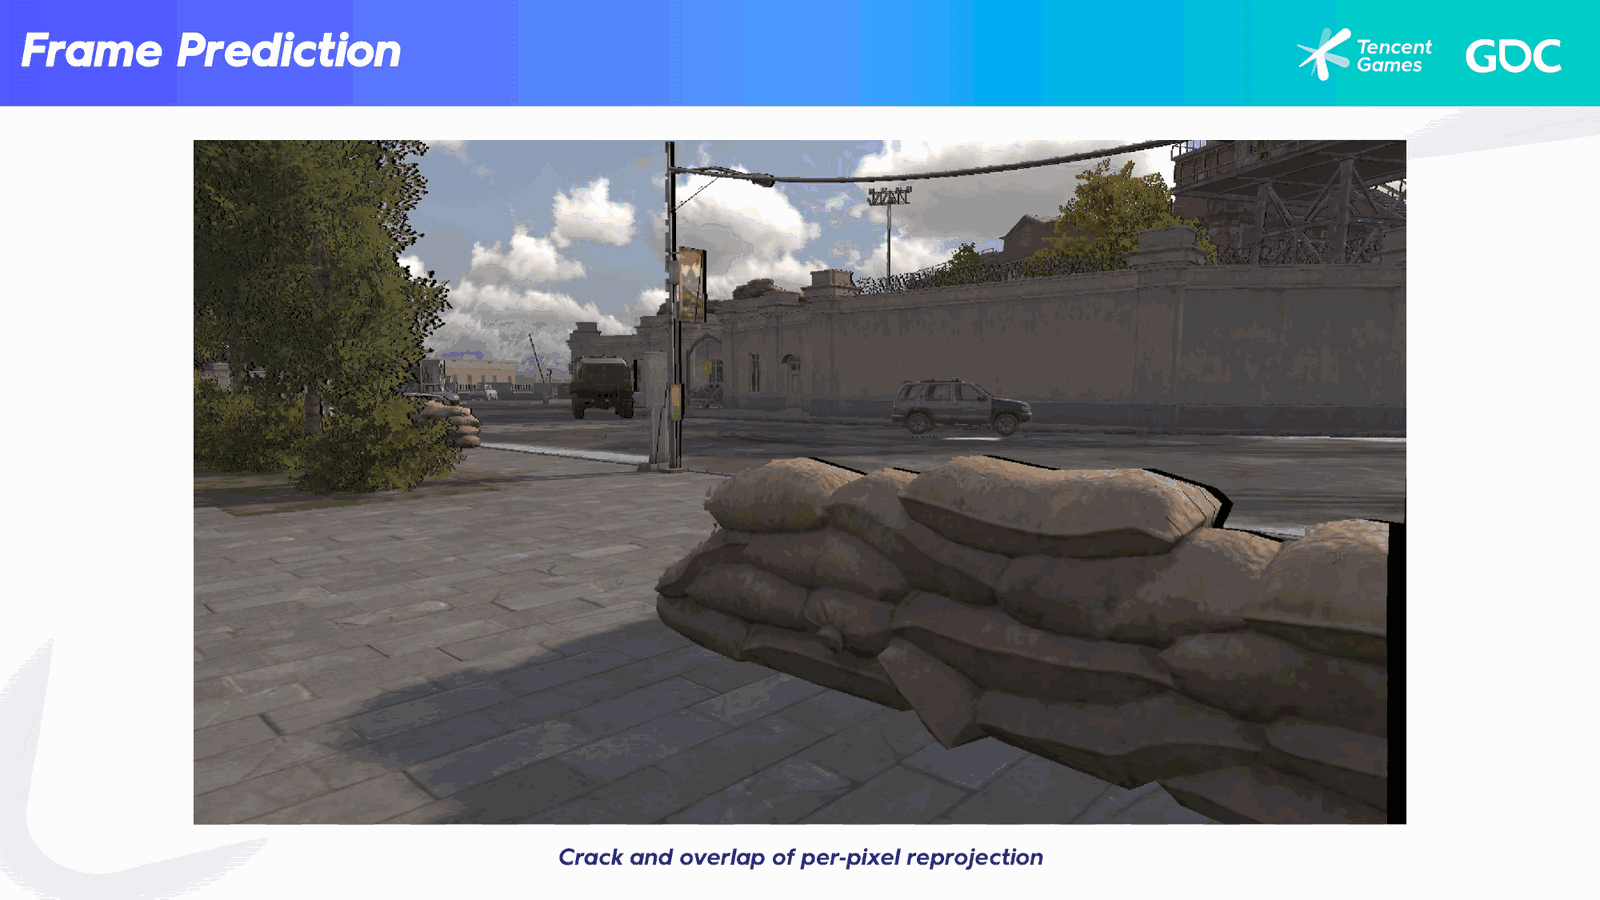
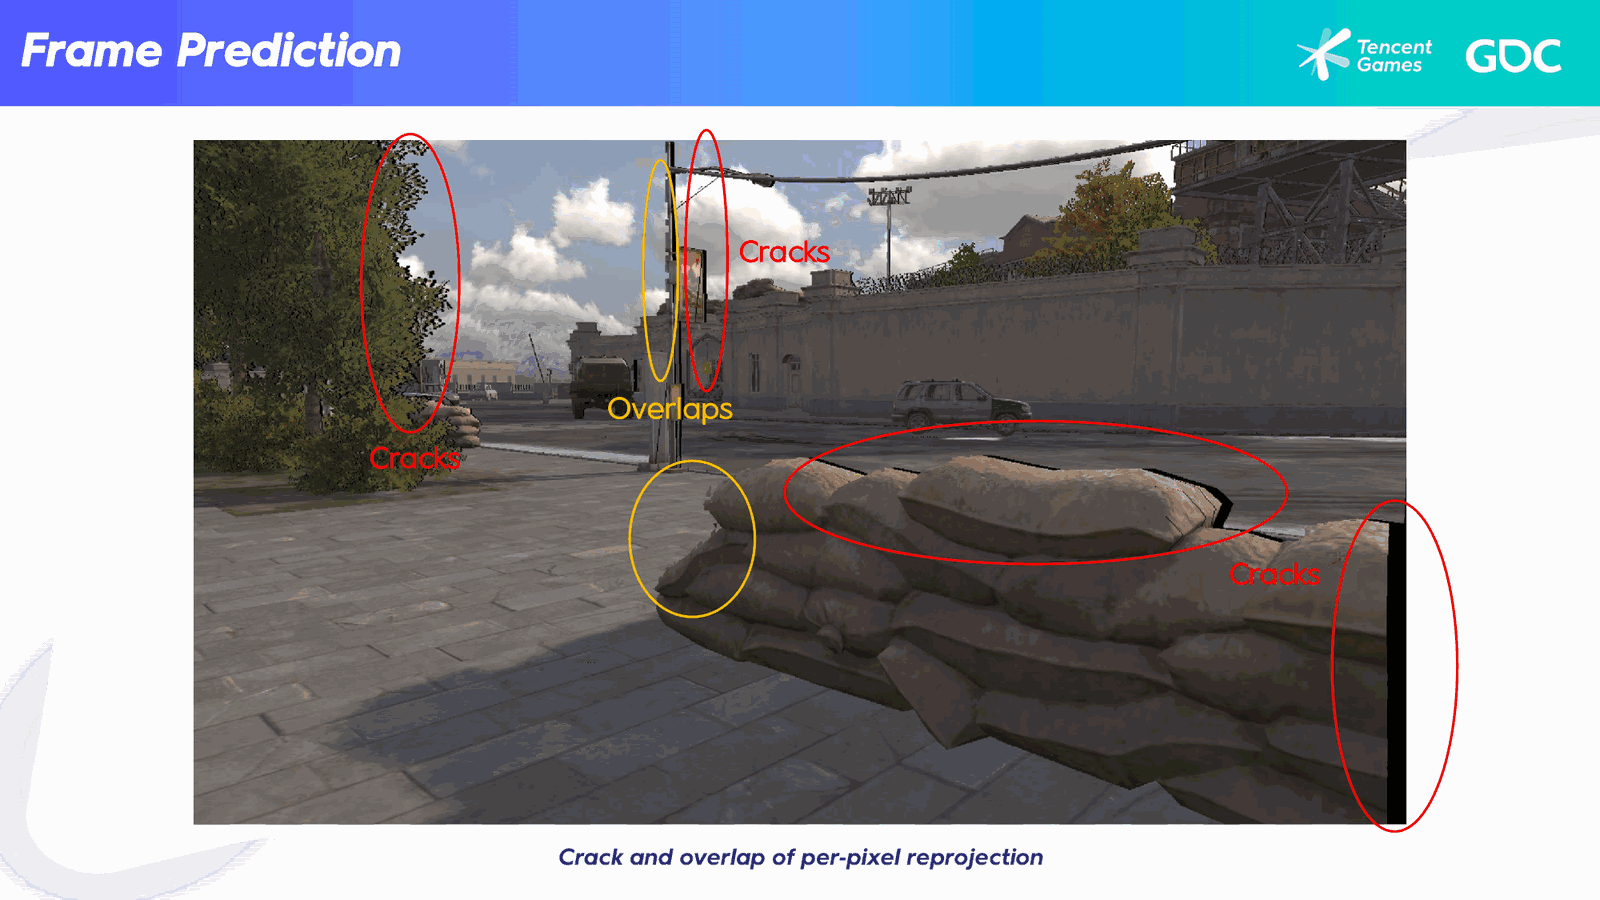
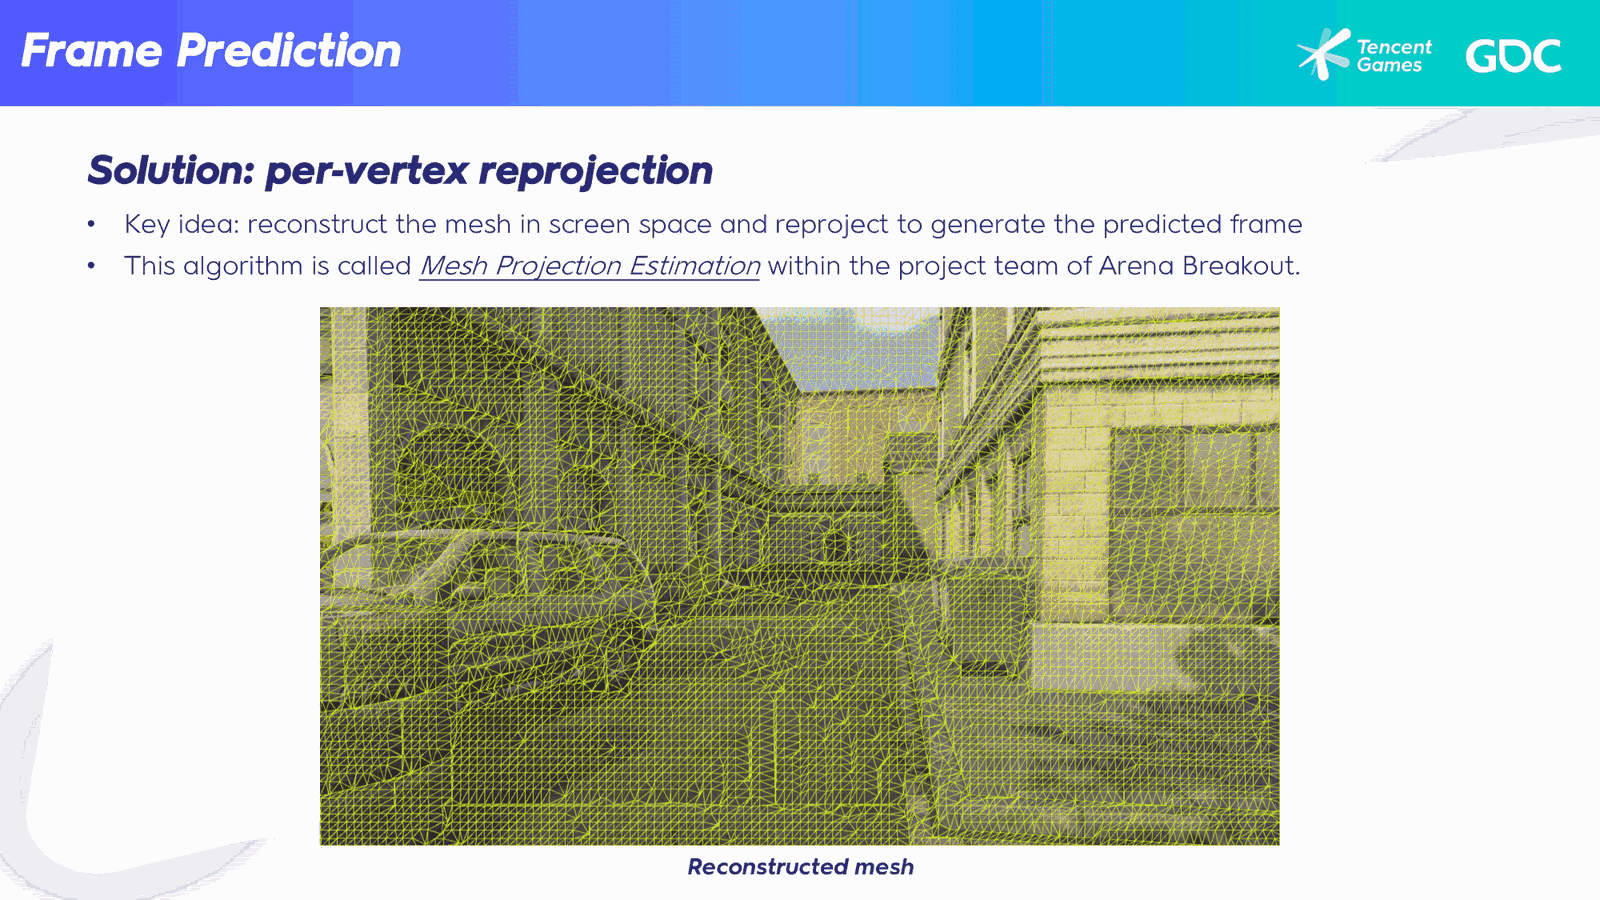
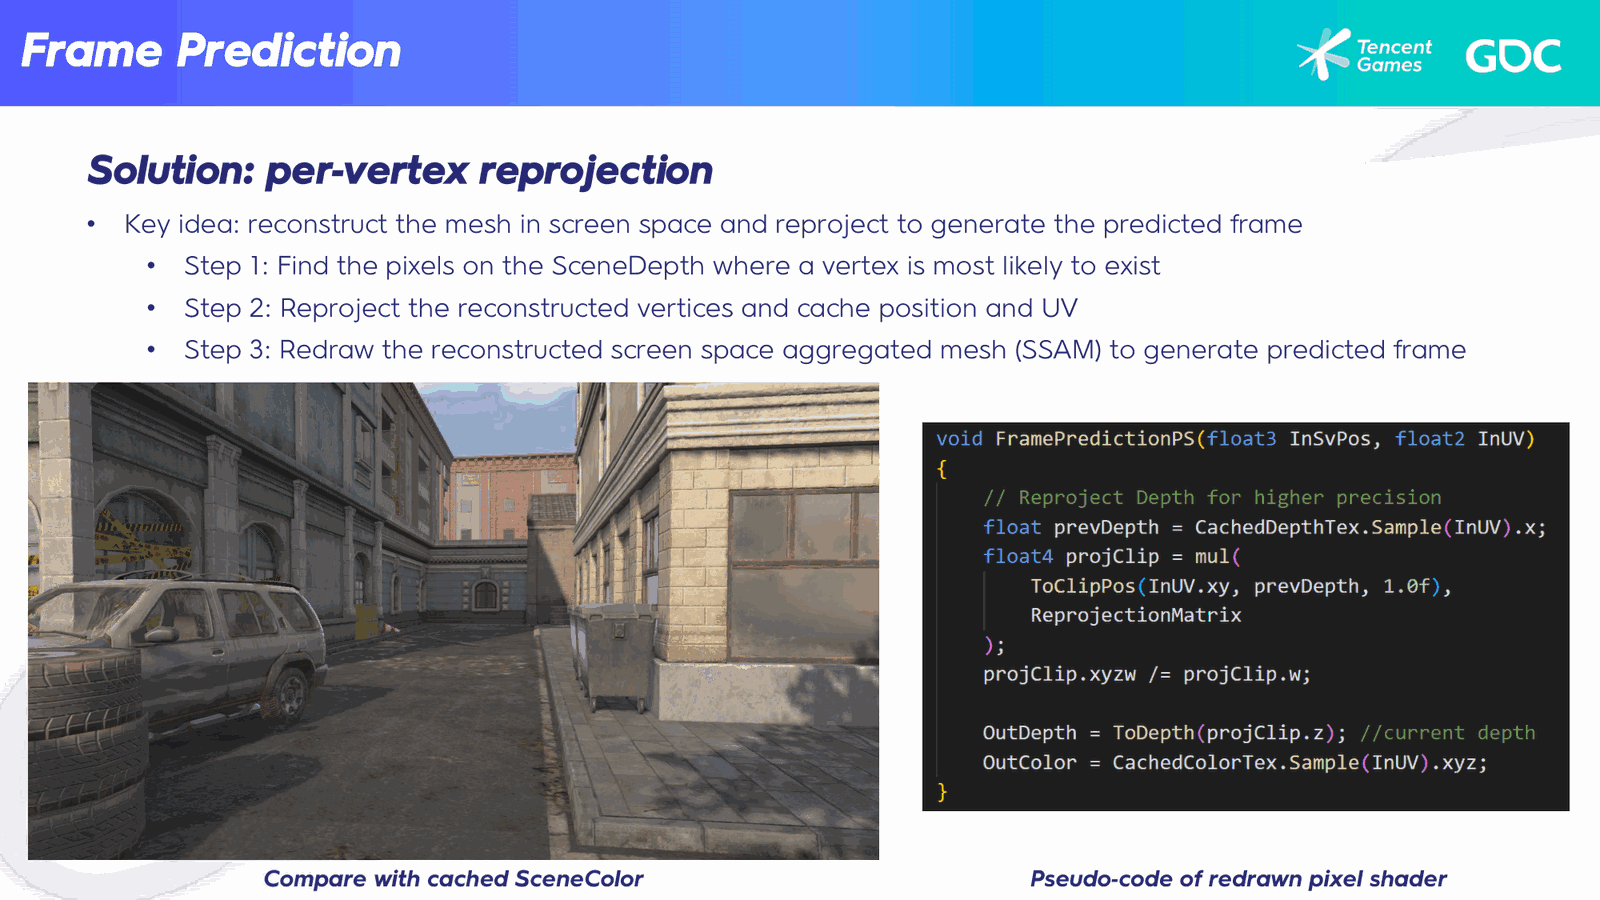
- 屏幕空间聚合网格(SSAM):逐像素重投影存在黑色裂缝和重叠(类似Z-fighting)问题,填补裂缝需要Mip-Maps或大范围邻域采样,成本高昂。因此提出新方案——Mesh Projection Estimation(网格投影估计):
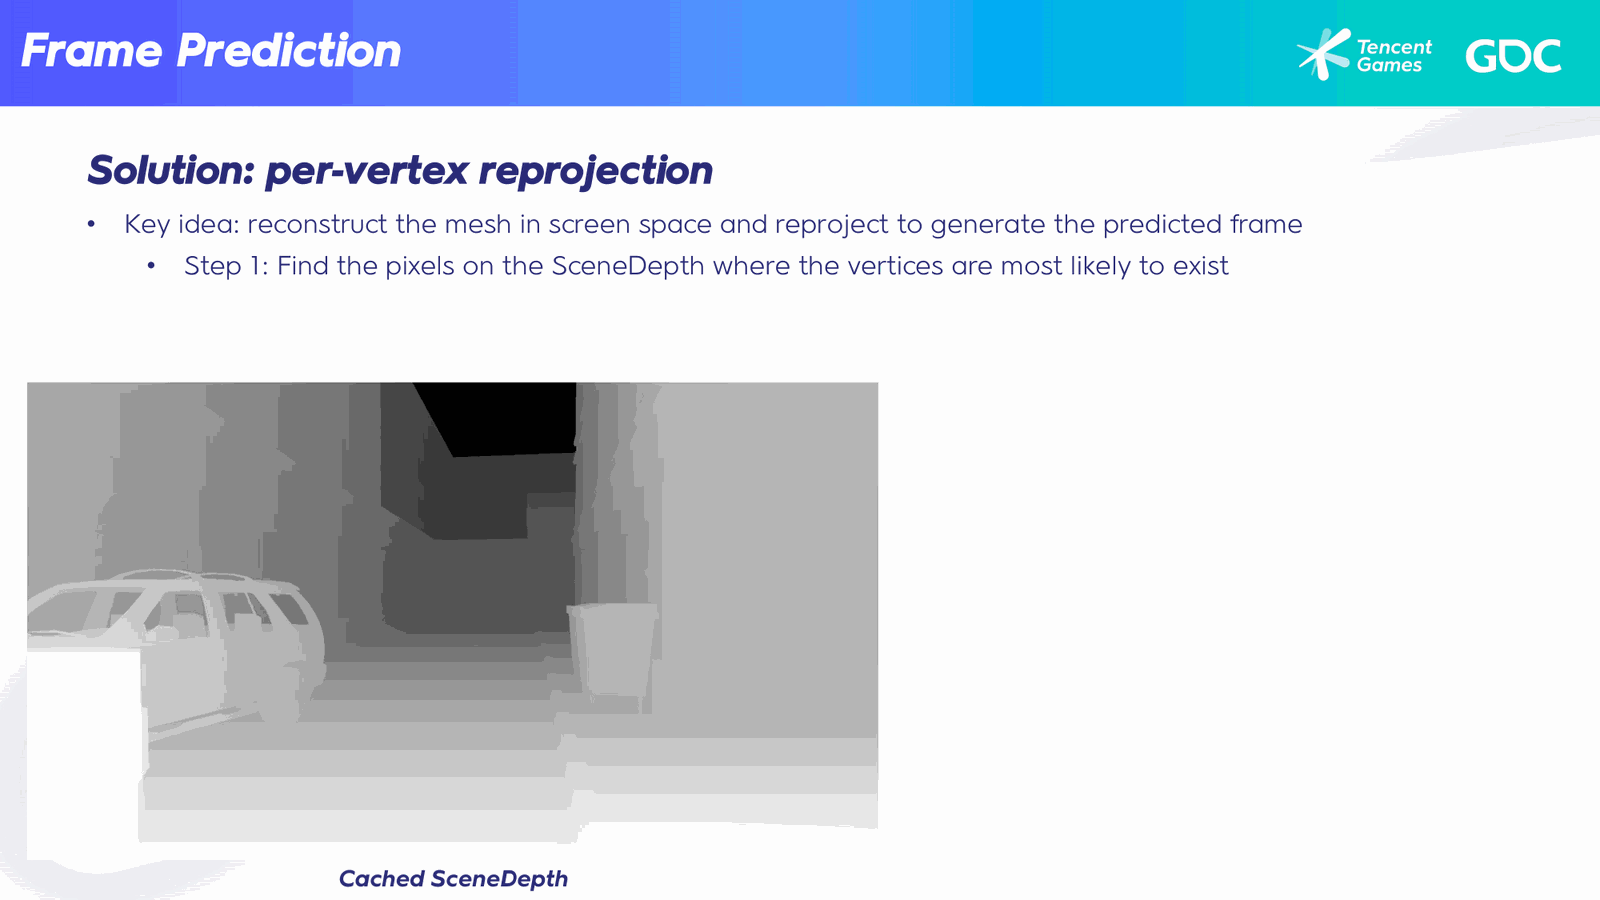
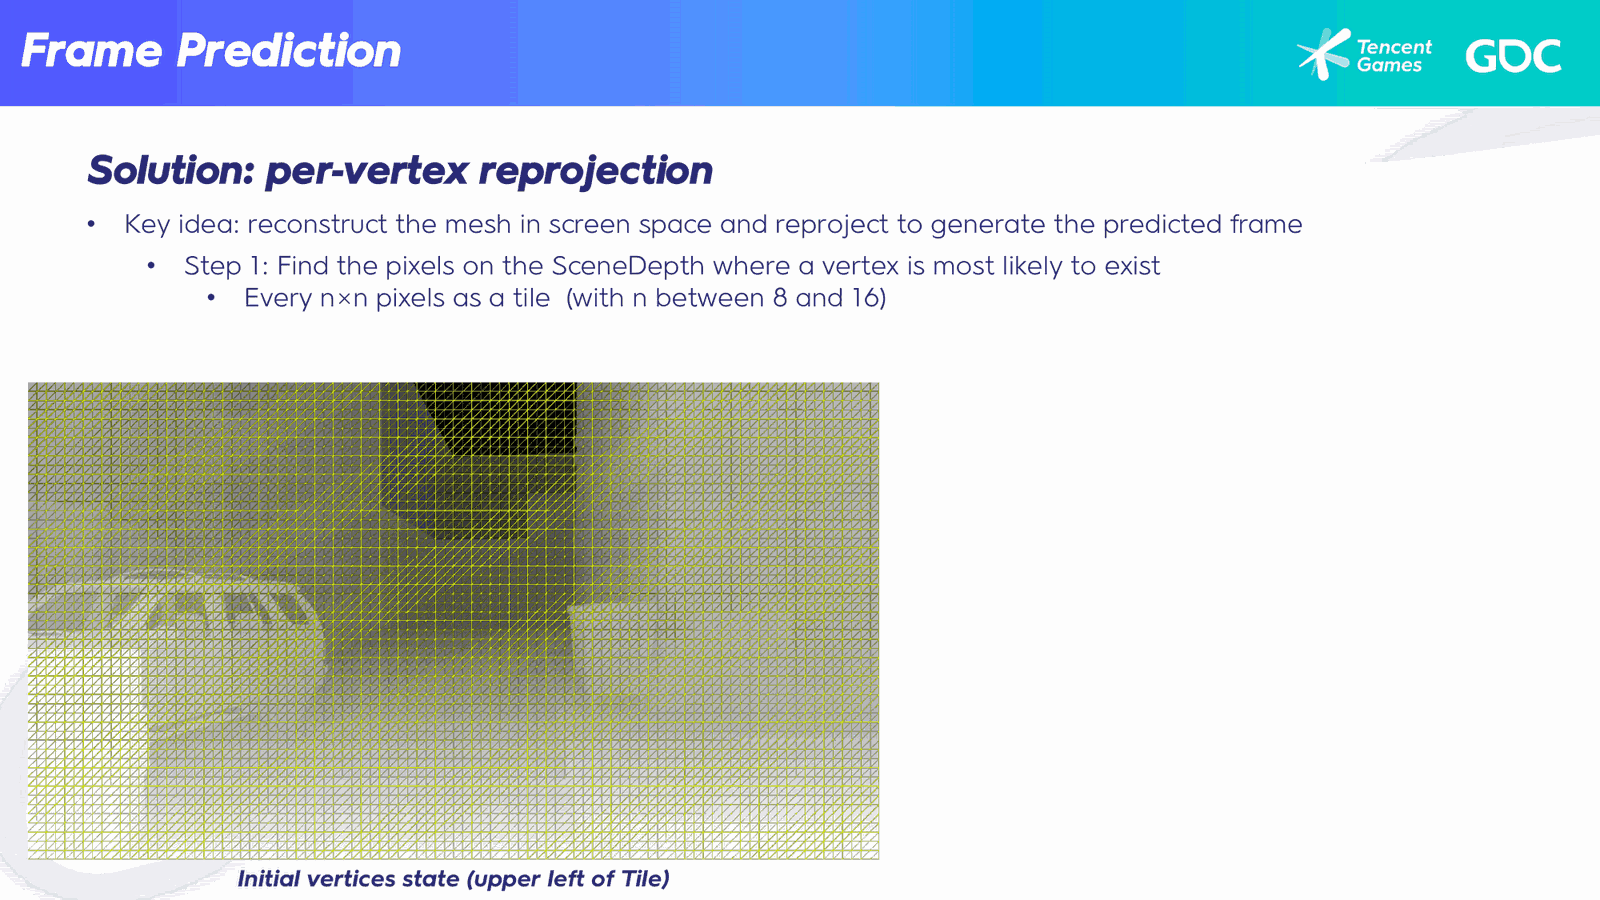
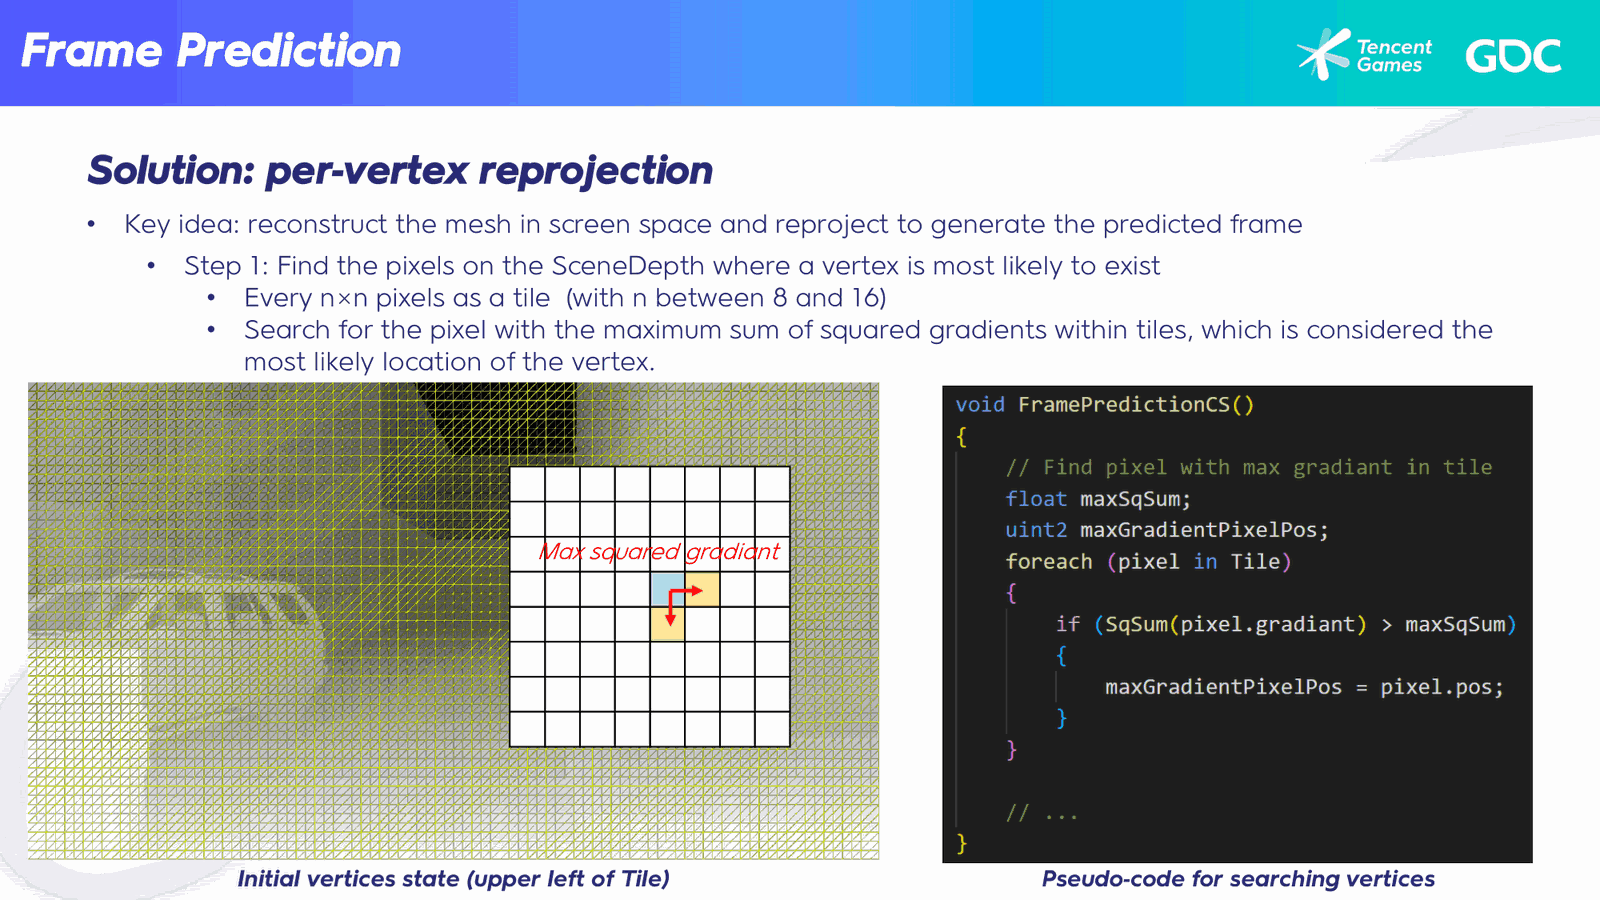
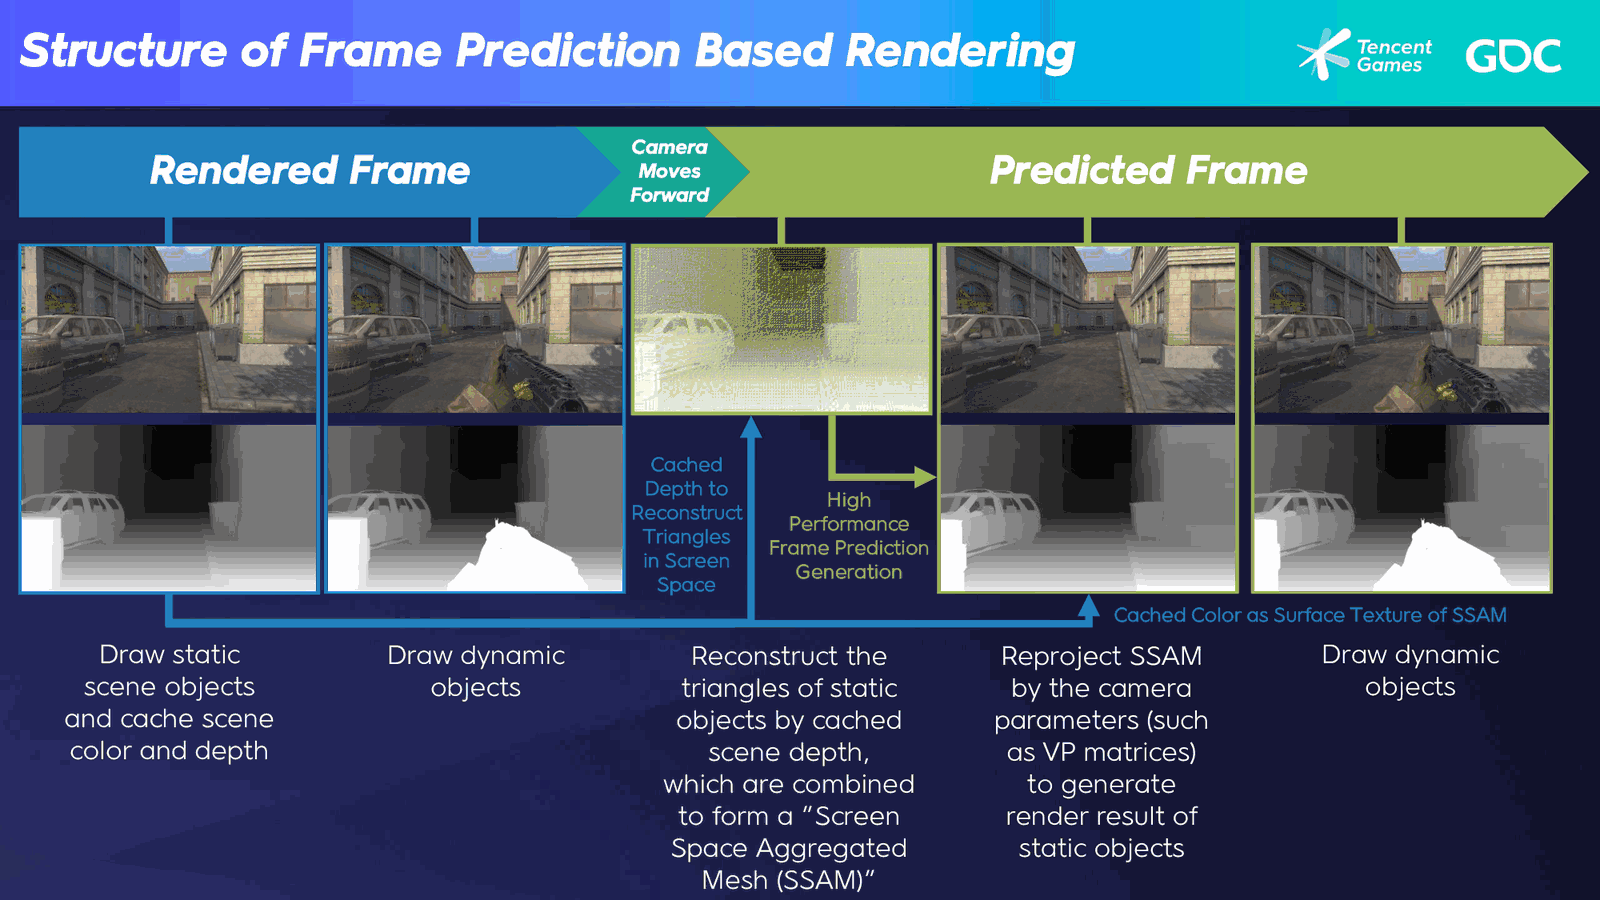
- 从前一帧的缓存SceneDepth纹理重建顶点,将SceneDepth分为N×N像素的Tile。
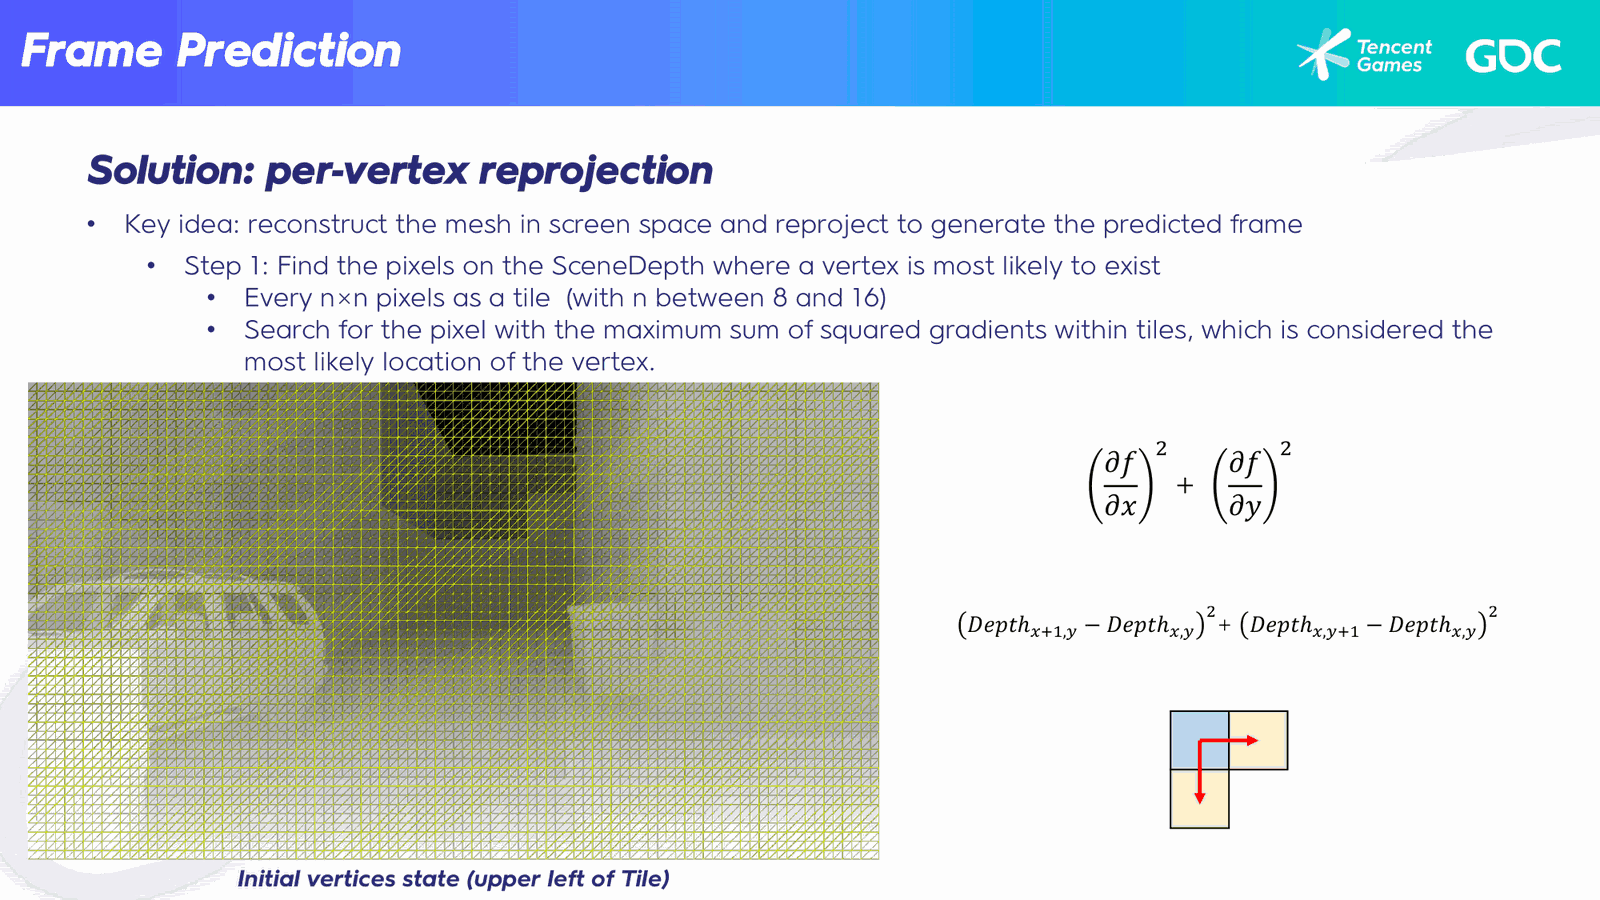
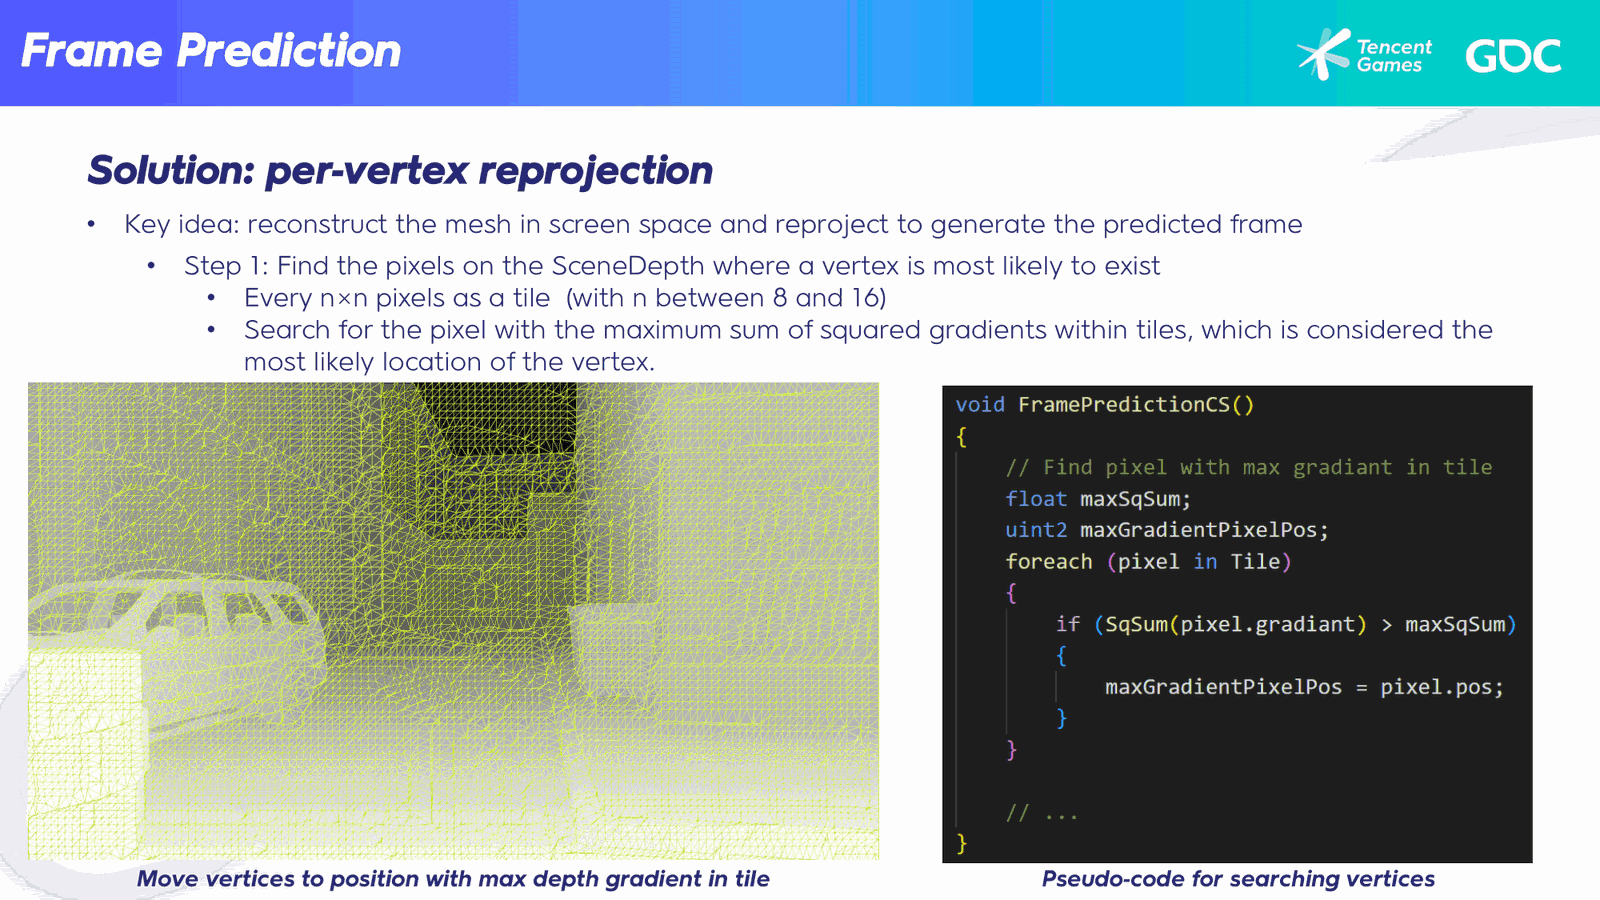
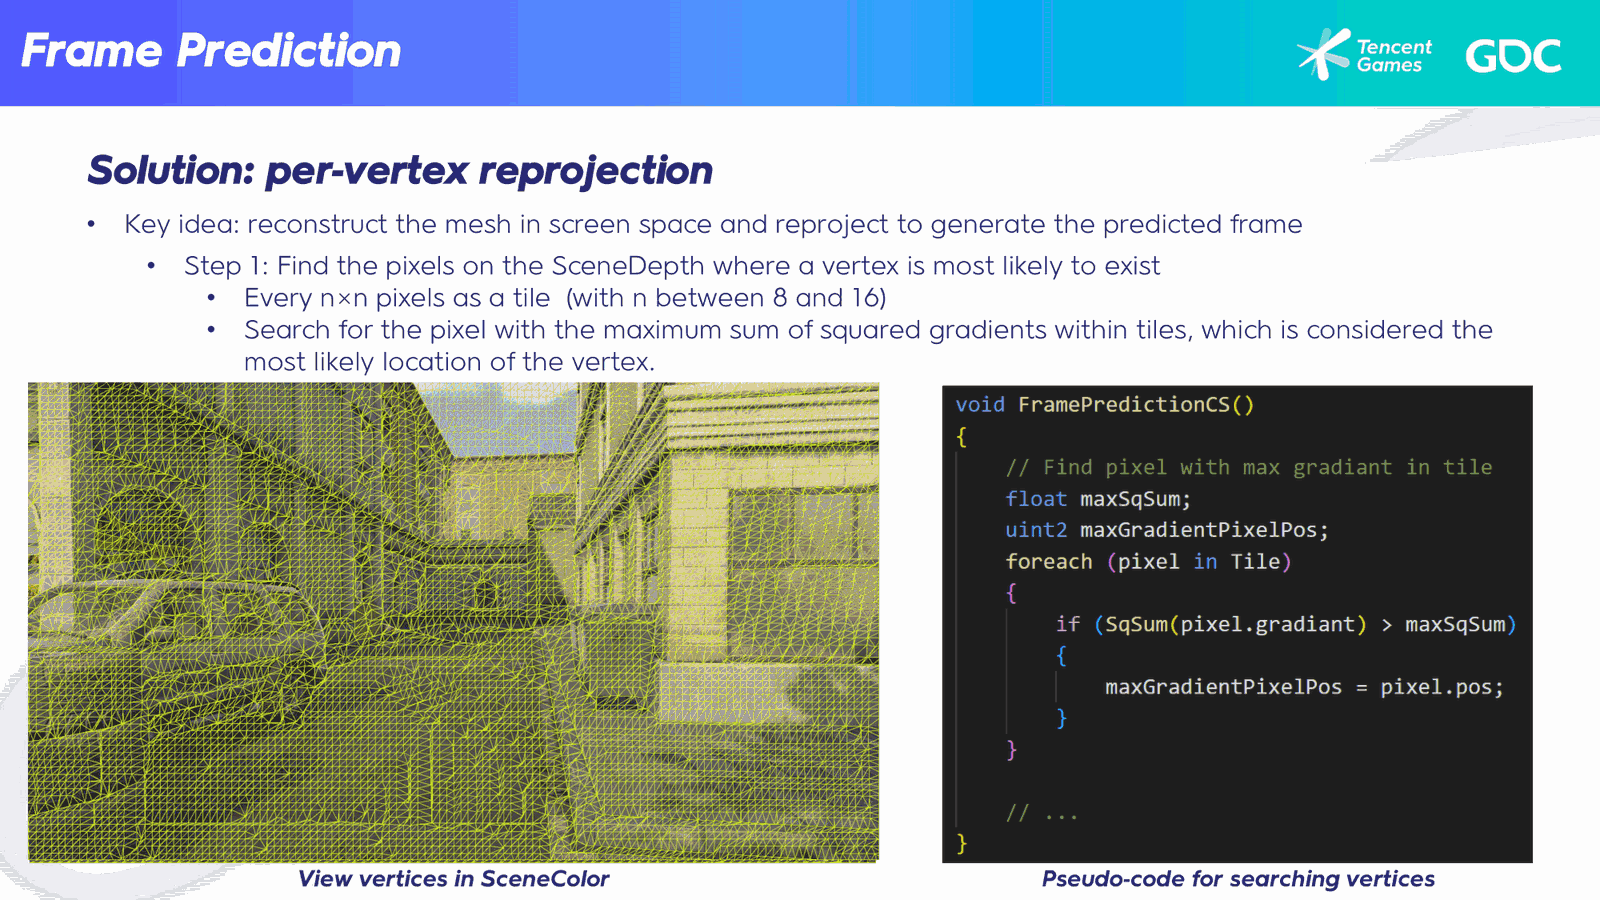
- 使用梯度平方和搜索顶点在Tile中最可能的位置(最大深度梯度处),使顶点与场景对象边缘对齐。
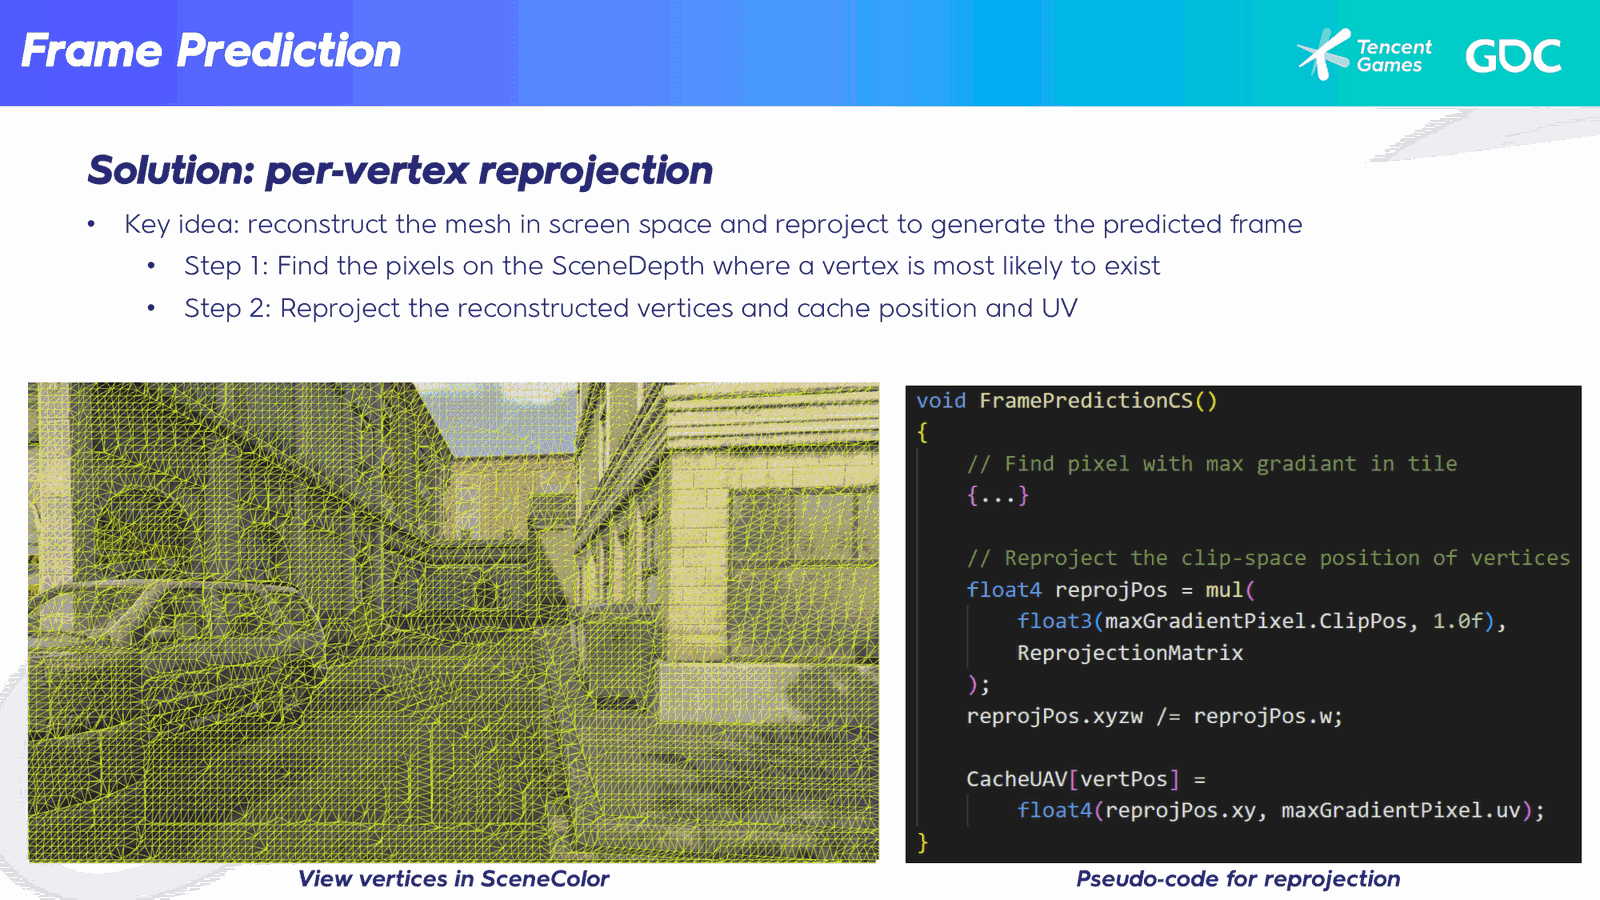
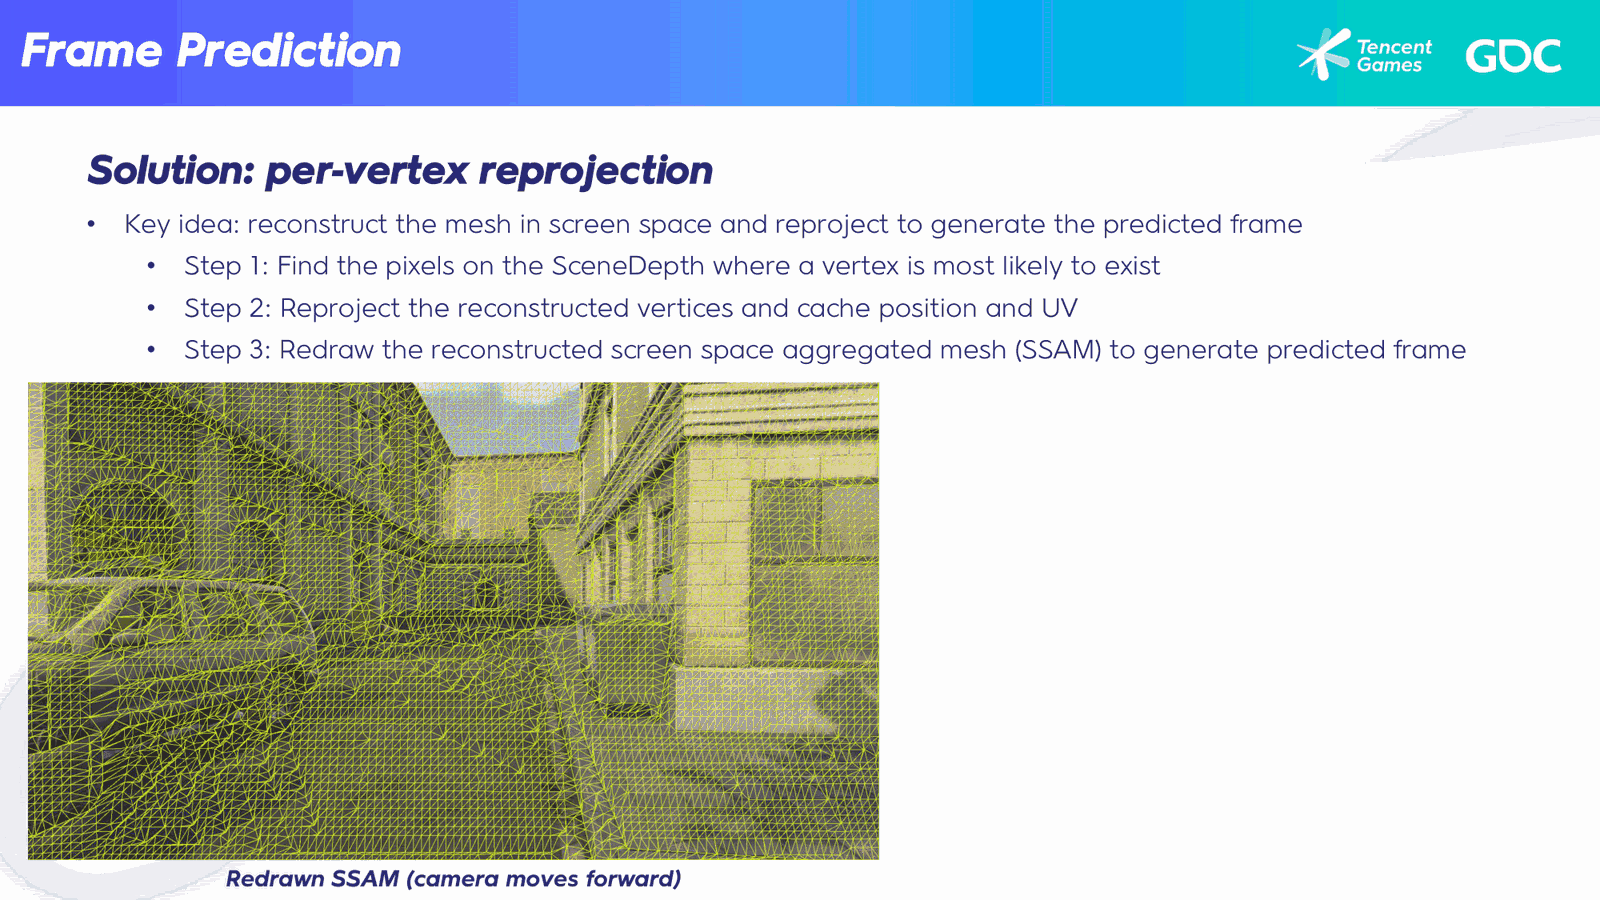
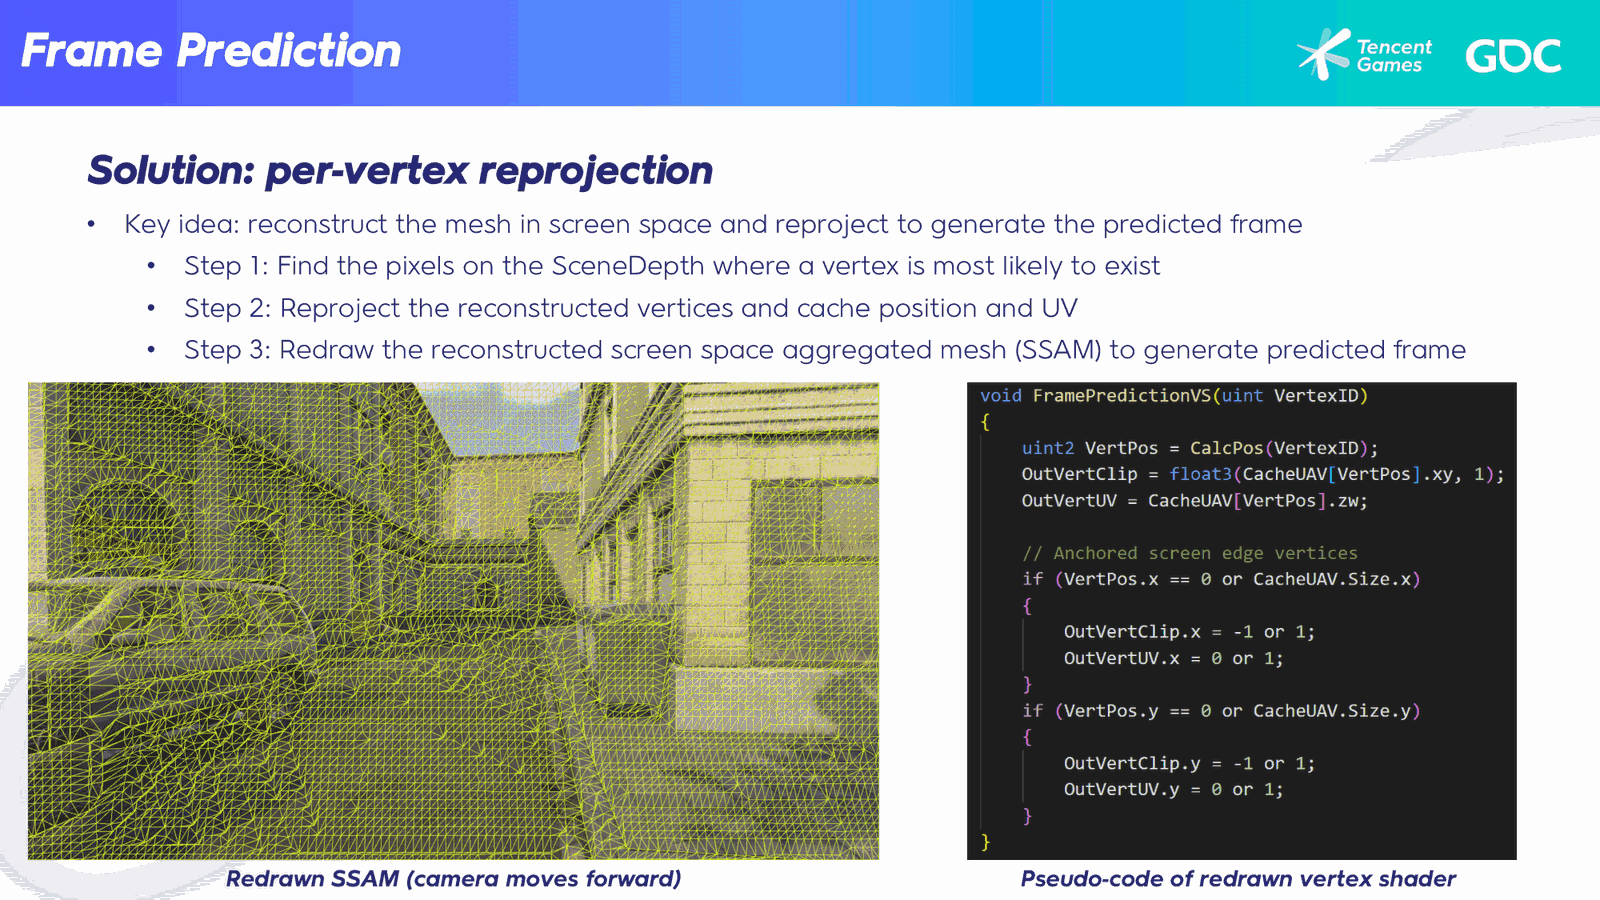
- 通过重投影矩阵重投影顶点位置,将重投影位置和顶点UV存储到UAV纹理中。
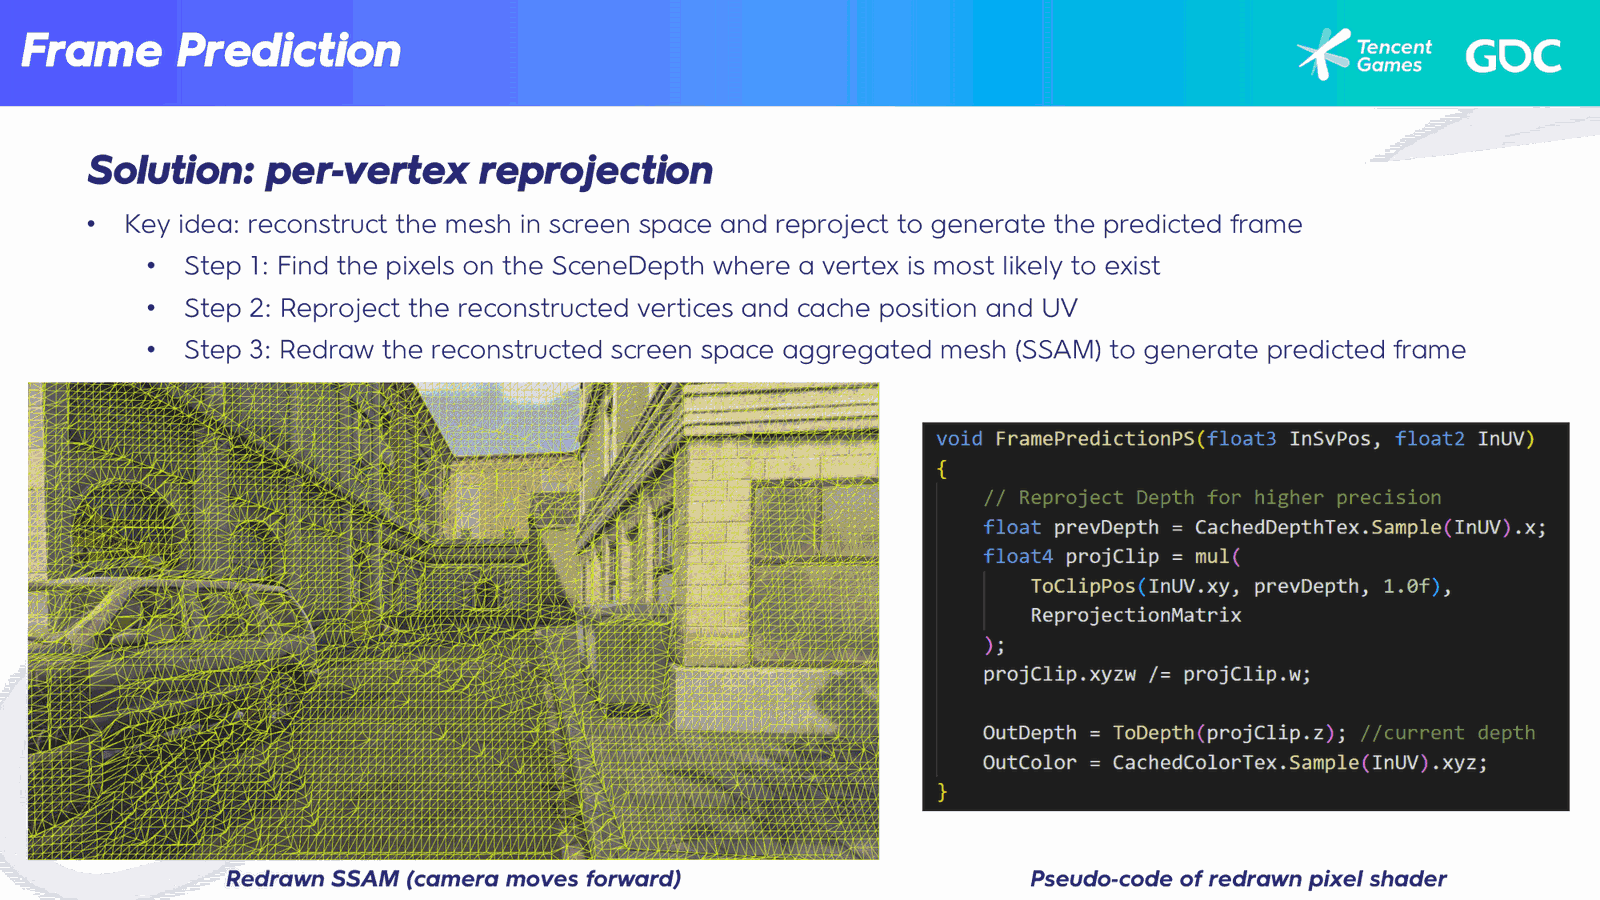
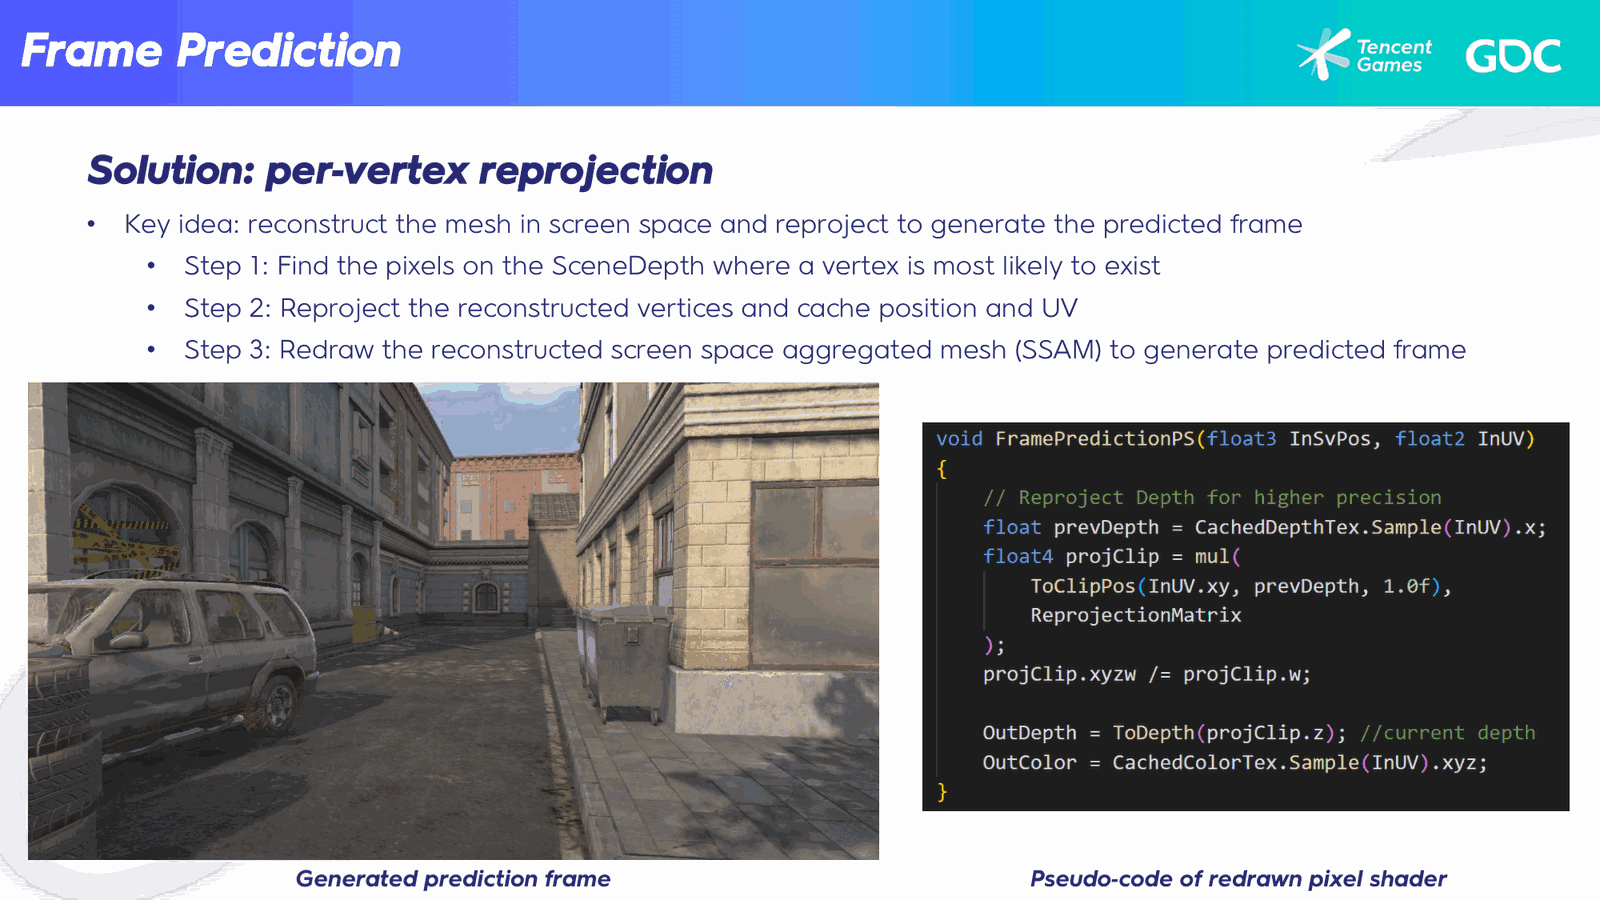
- 缓存的SceneColor纹理作为网格的表面纹理,通过重新绘制重投影网格生成预测帧。
- 顶点和三角形作为锚点驱动像素运动,硬件光栅化和深度测试以极低成本避免裂缝和重叠。
- 借鉴软件工程中”聚合”的概念,将来自不同对象的顶点视为单一实体,故称为屏幕空间聚合网格(SSAM)。
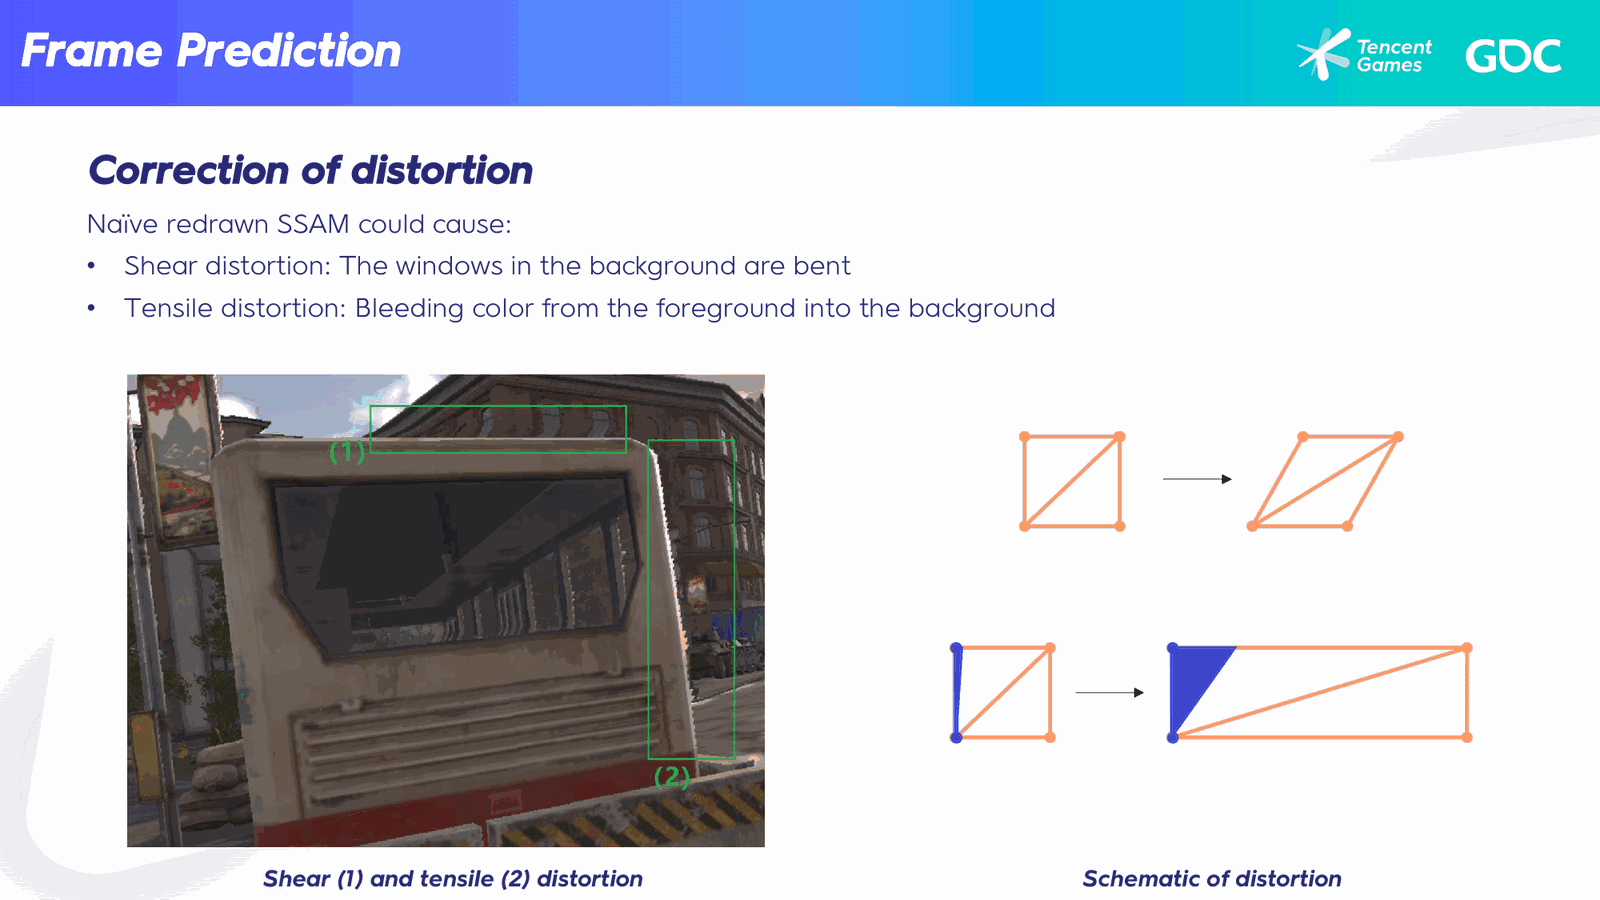
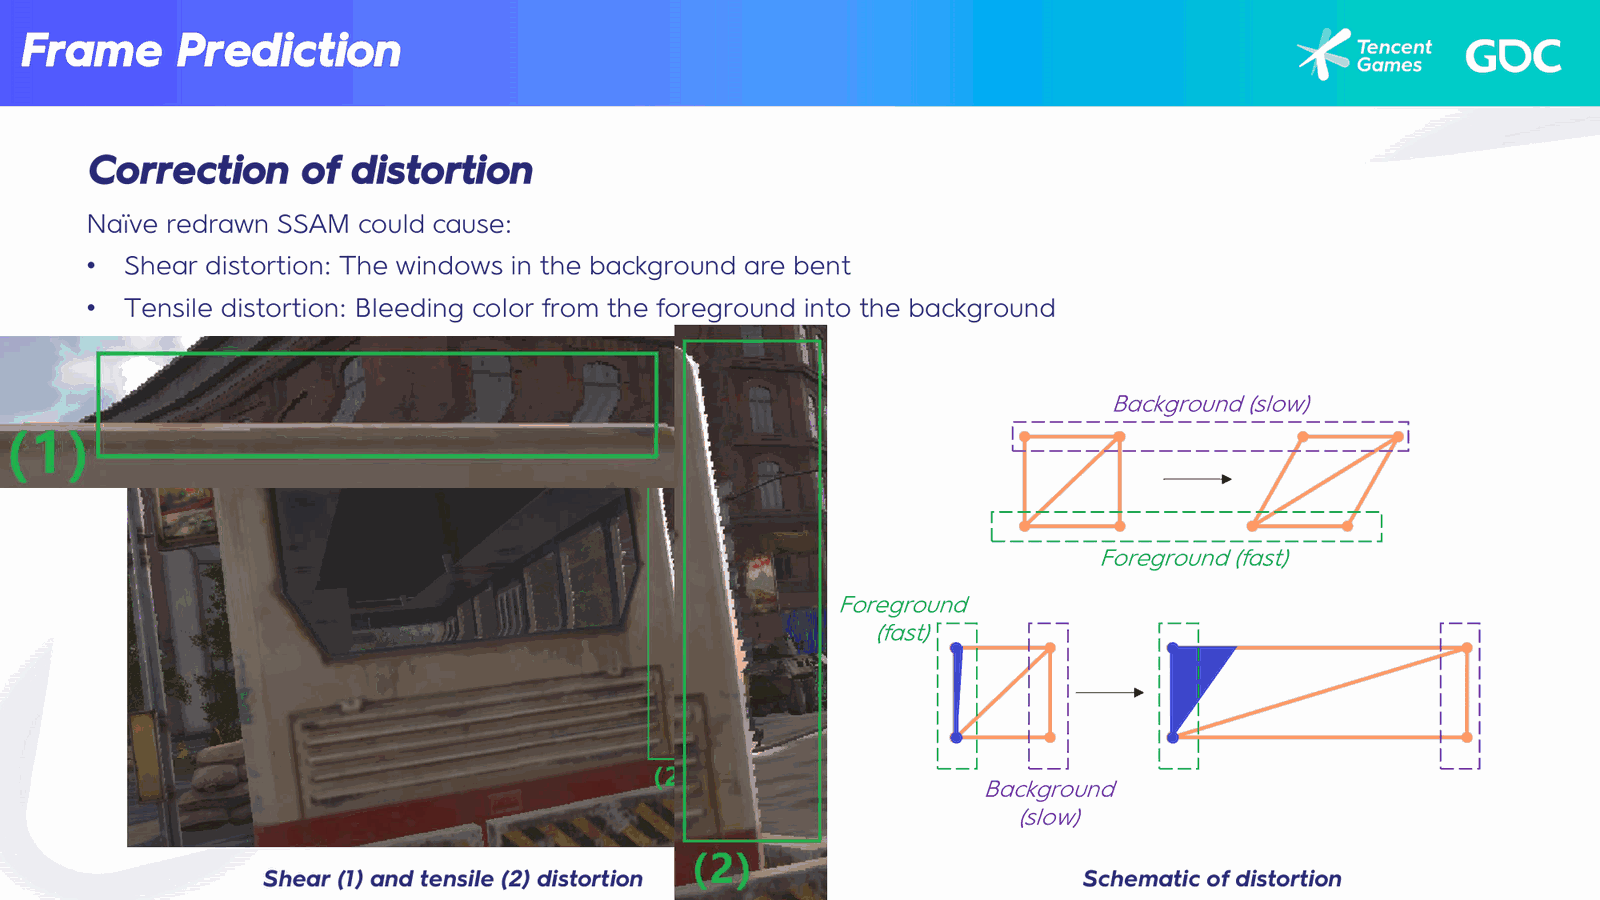
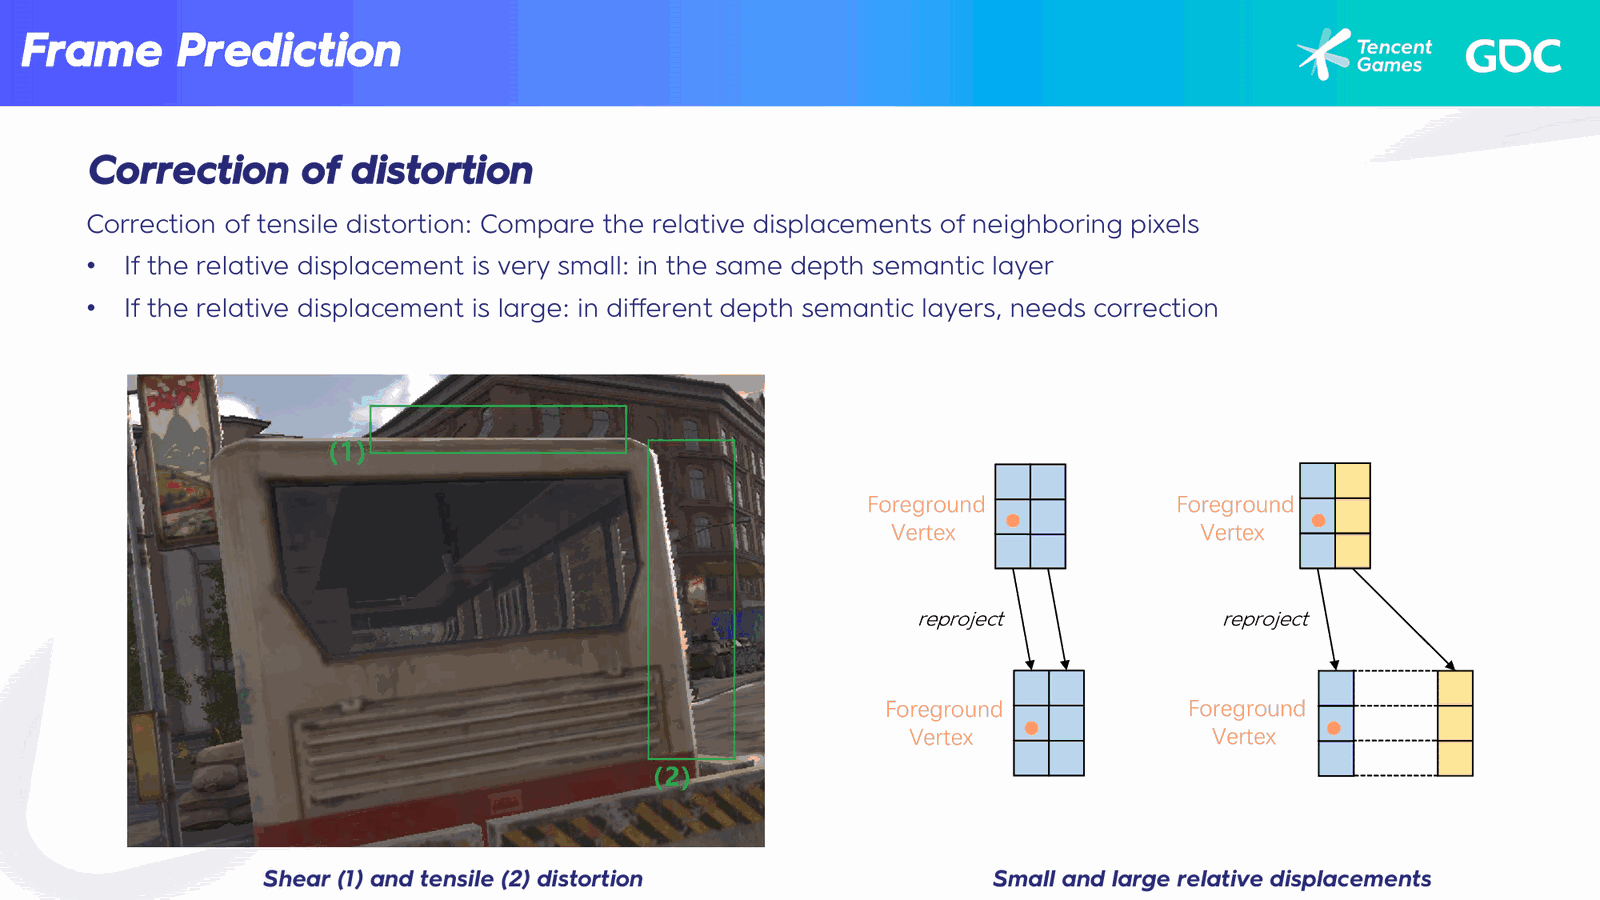
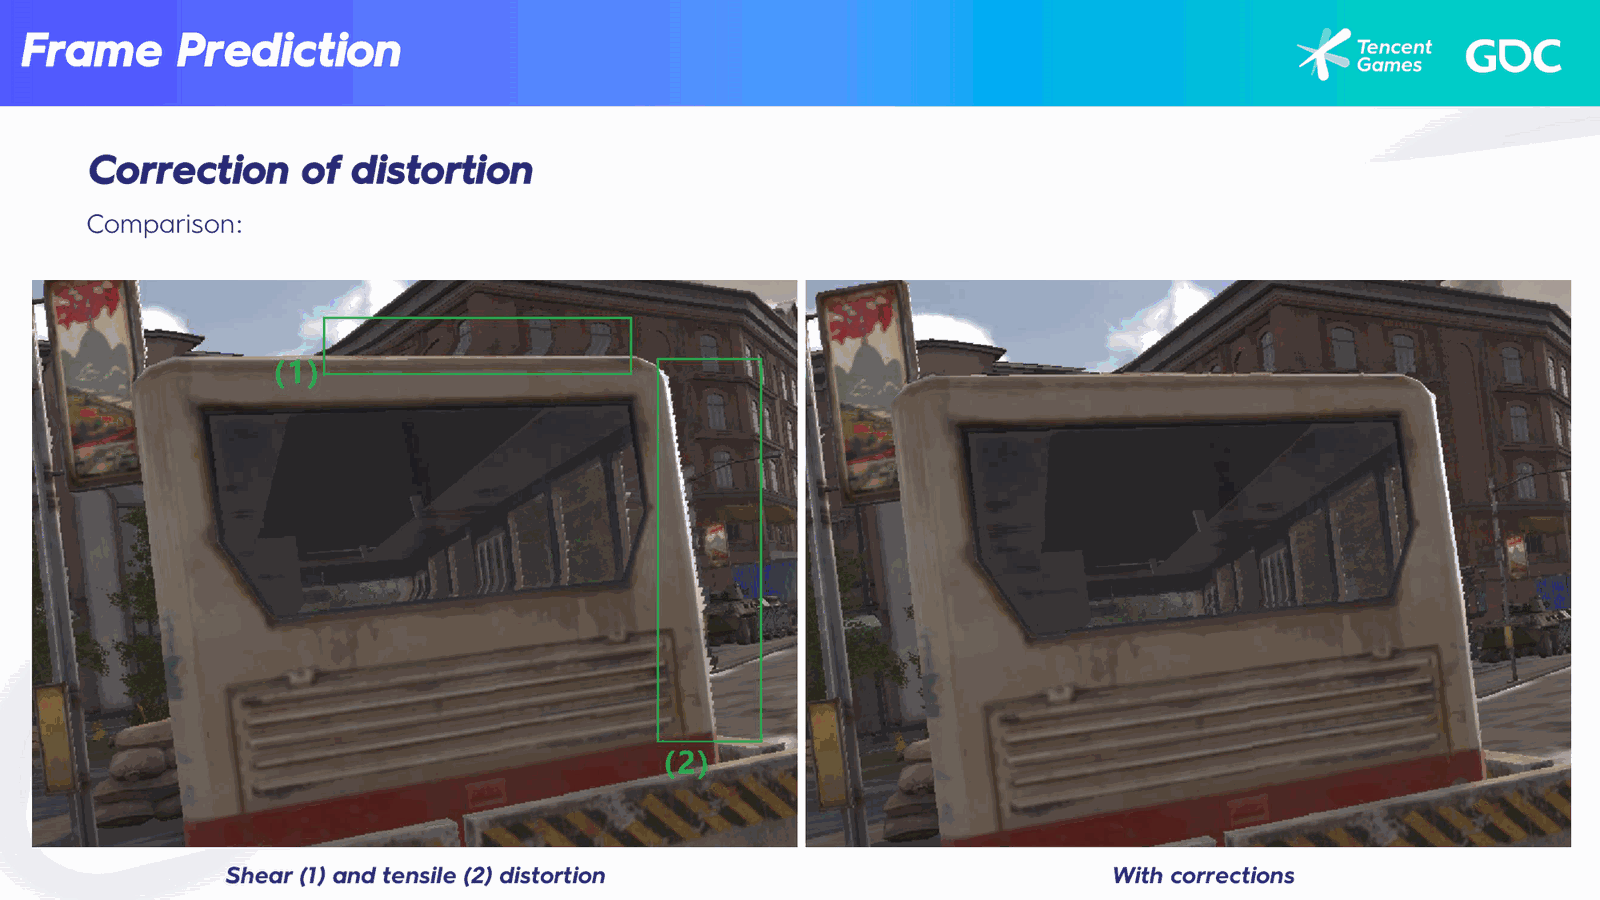
- 失真校正:透视相机移动时,远处物体像素移动比近处慢,导致剪切失真(背景窗户弯曲)和拉伸失真(前景颜色渗入背景)。
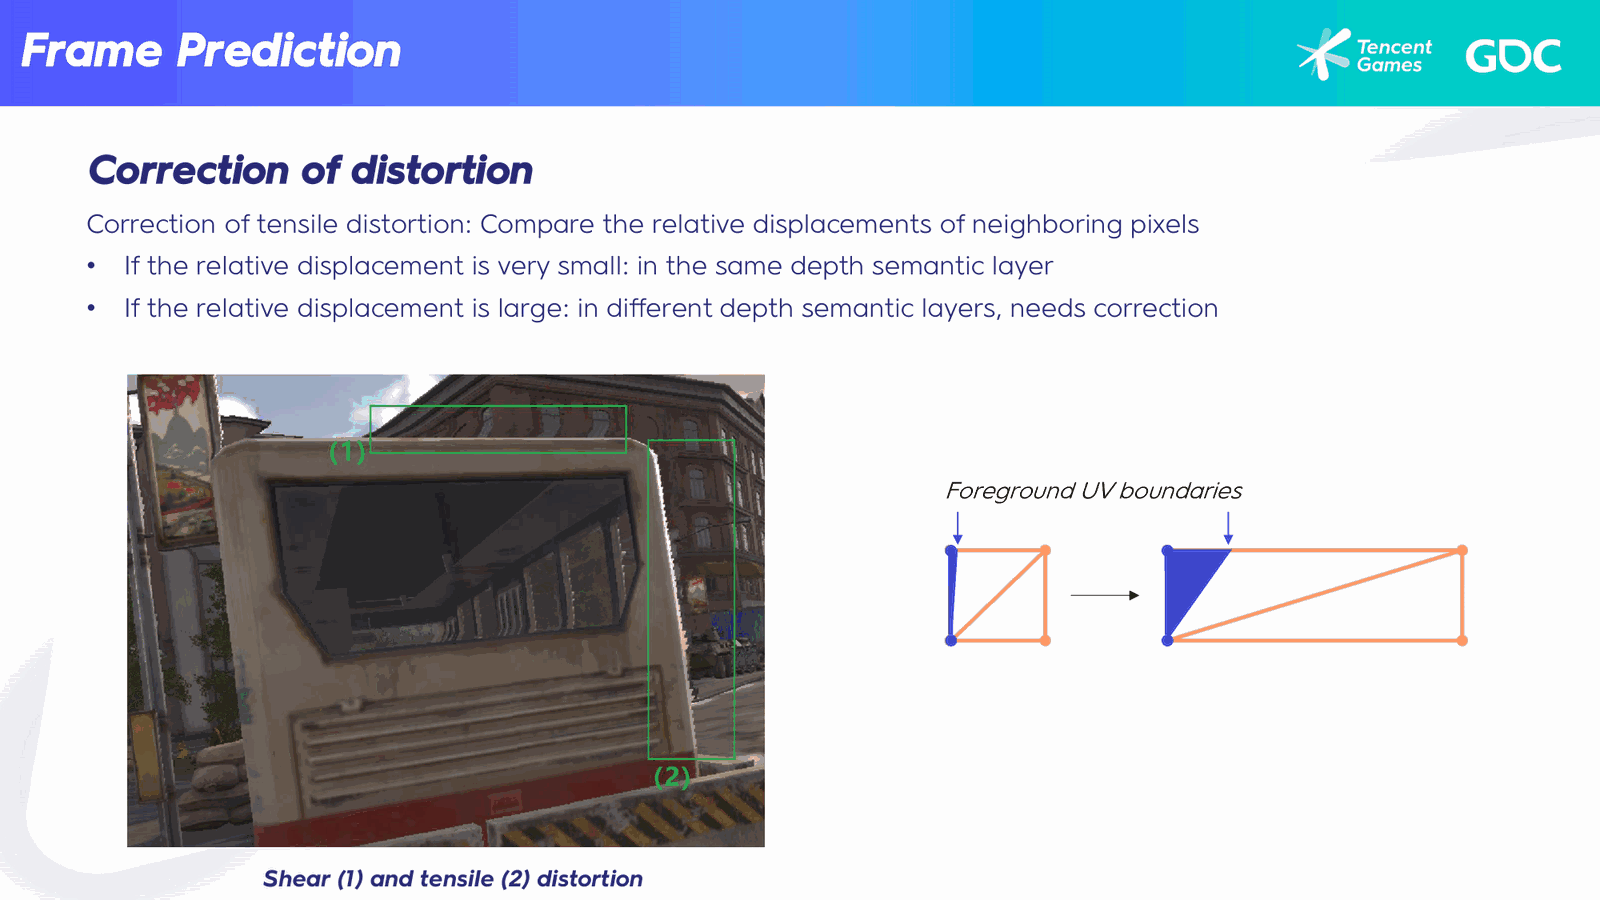
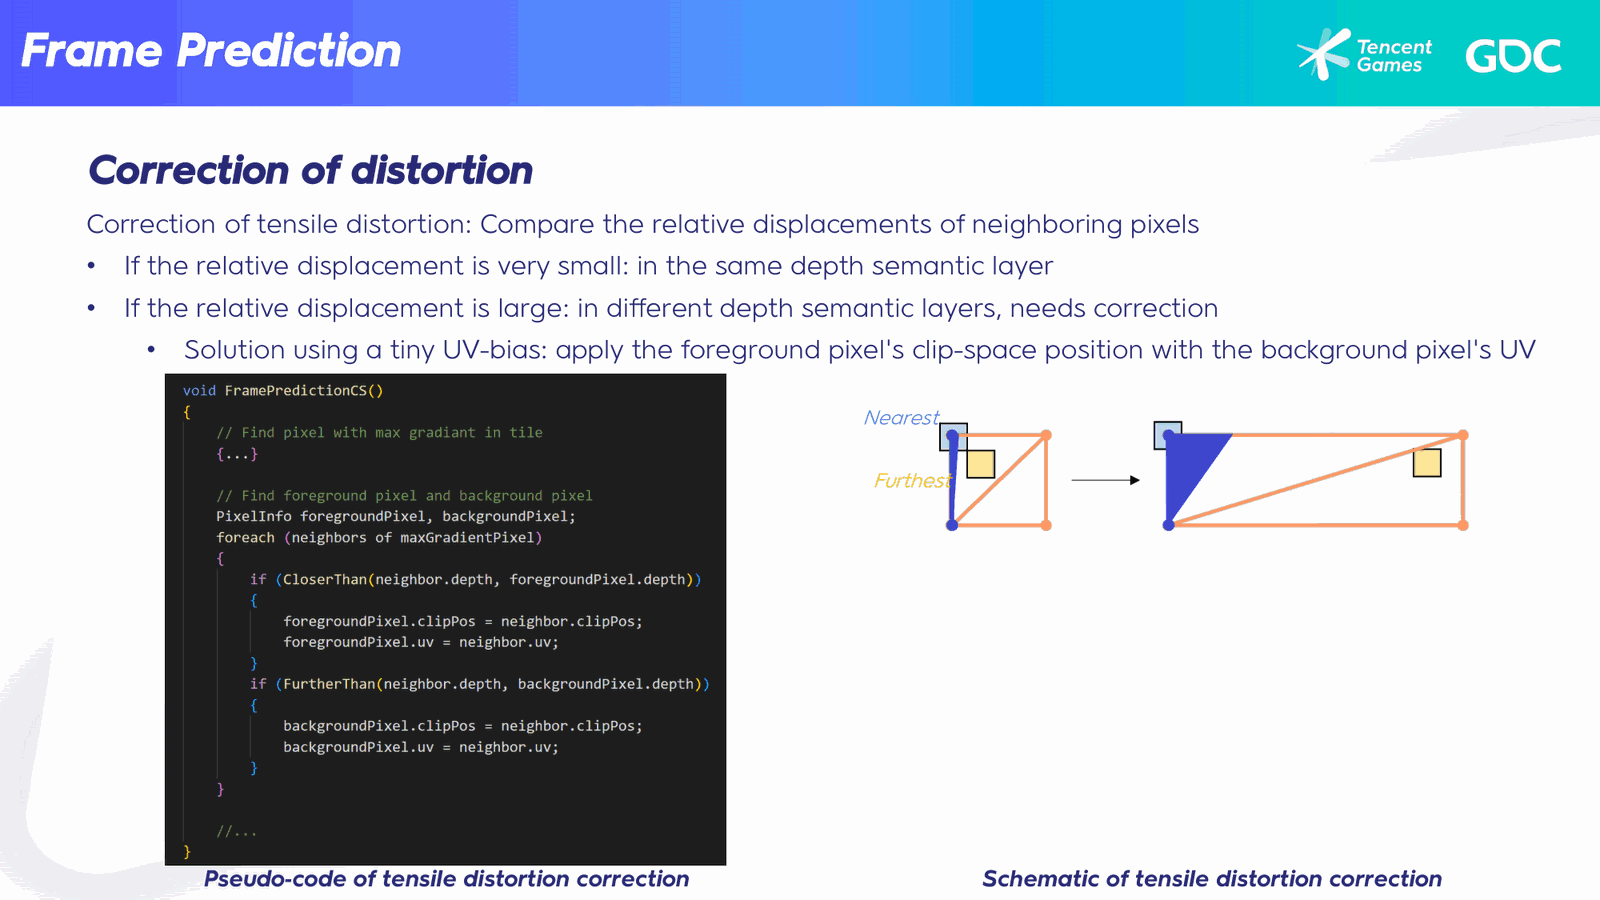
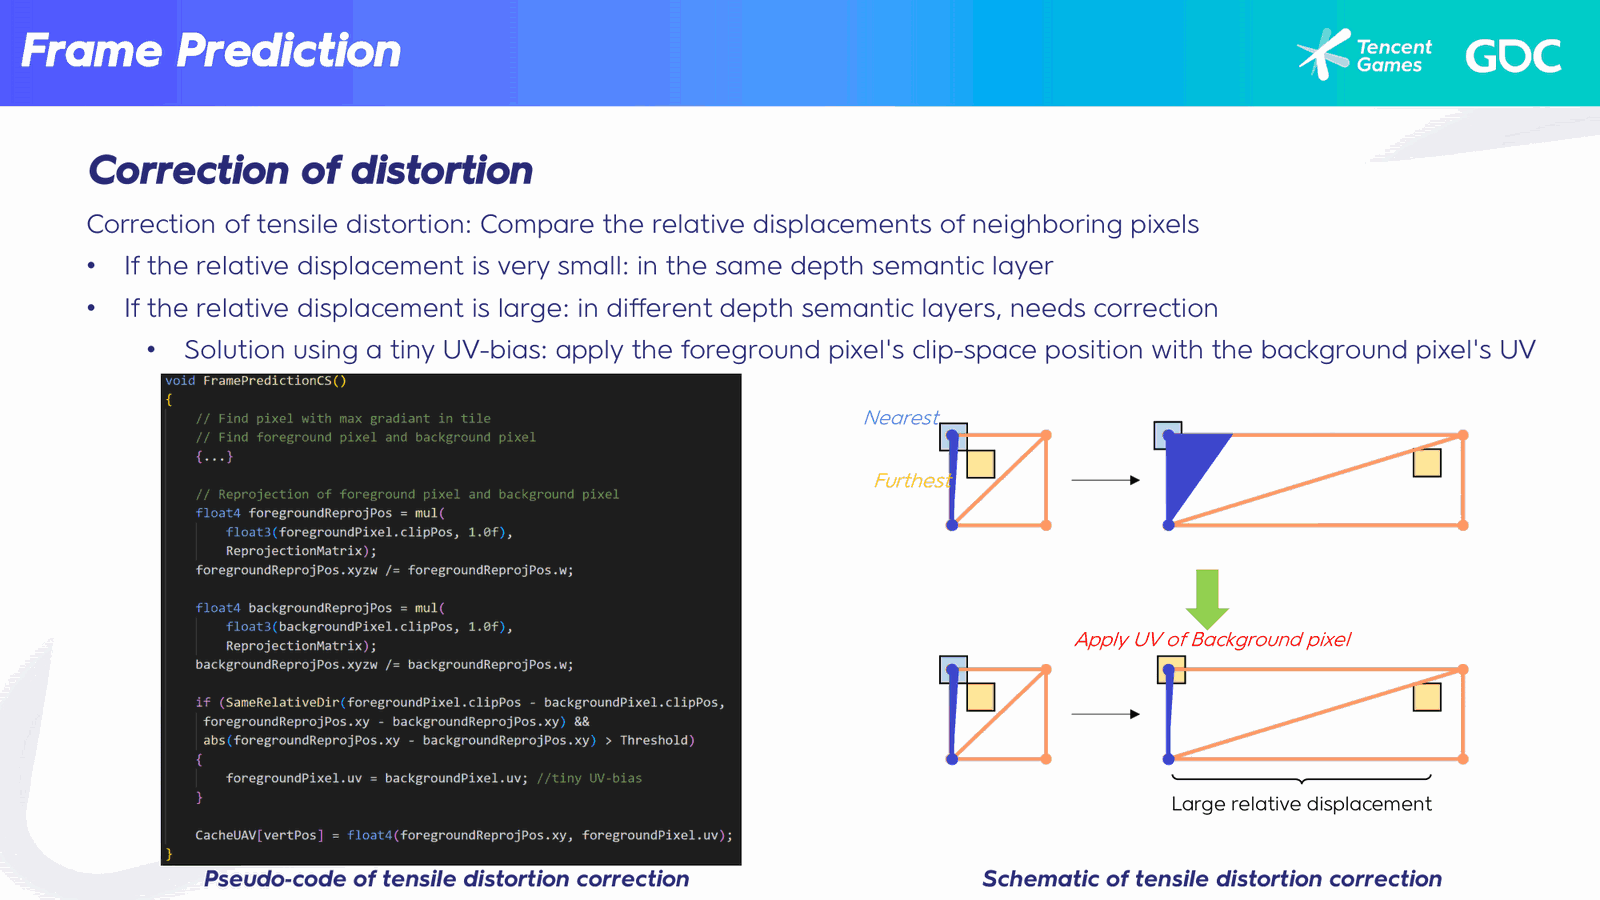
- 拉伸失真校正:通过前景顶点周围邻近像素的相对位移检测语义层差异;找到顶点周围最近/最远深度像素作为前景/背景像素,分别重投影后,若运动方向相同且位移大于阈值,应用一个像素大小的UV偏移(使用前景像素的裁剪空间位置+背景像素的UV)。
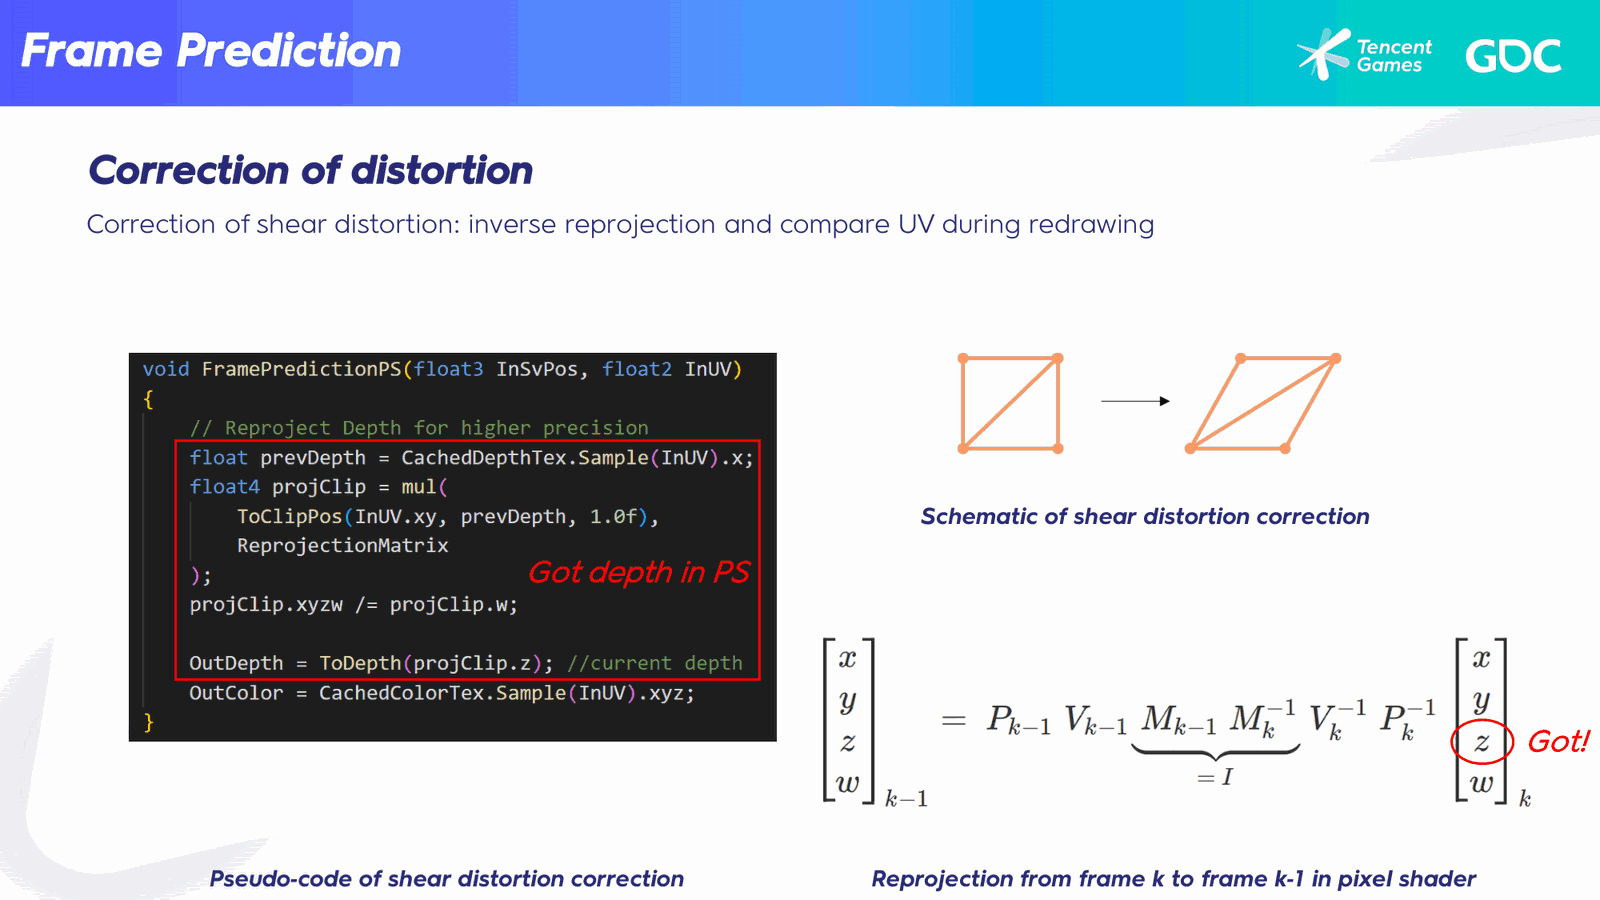
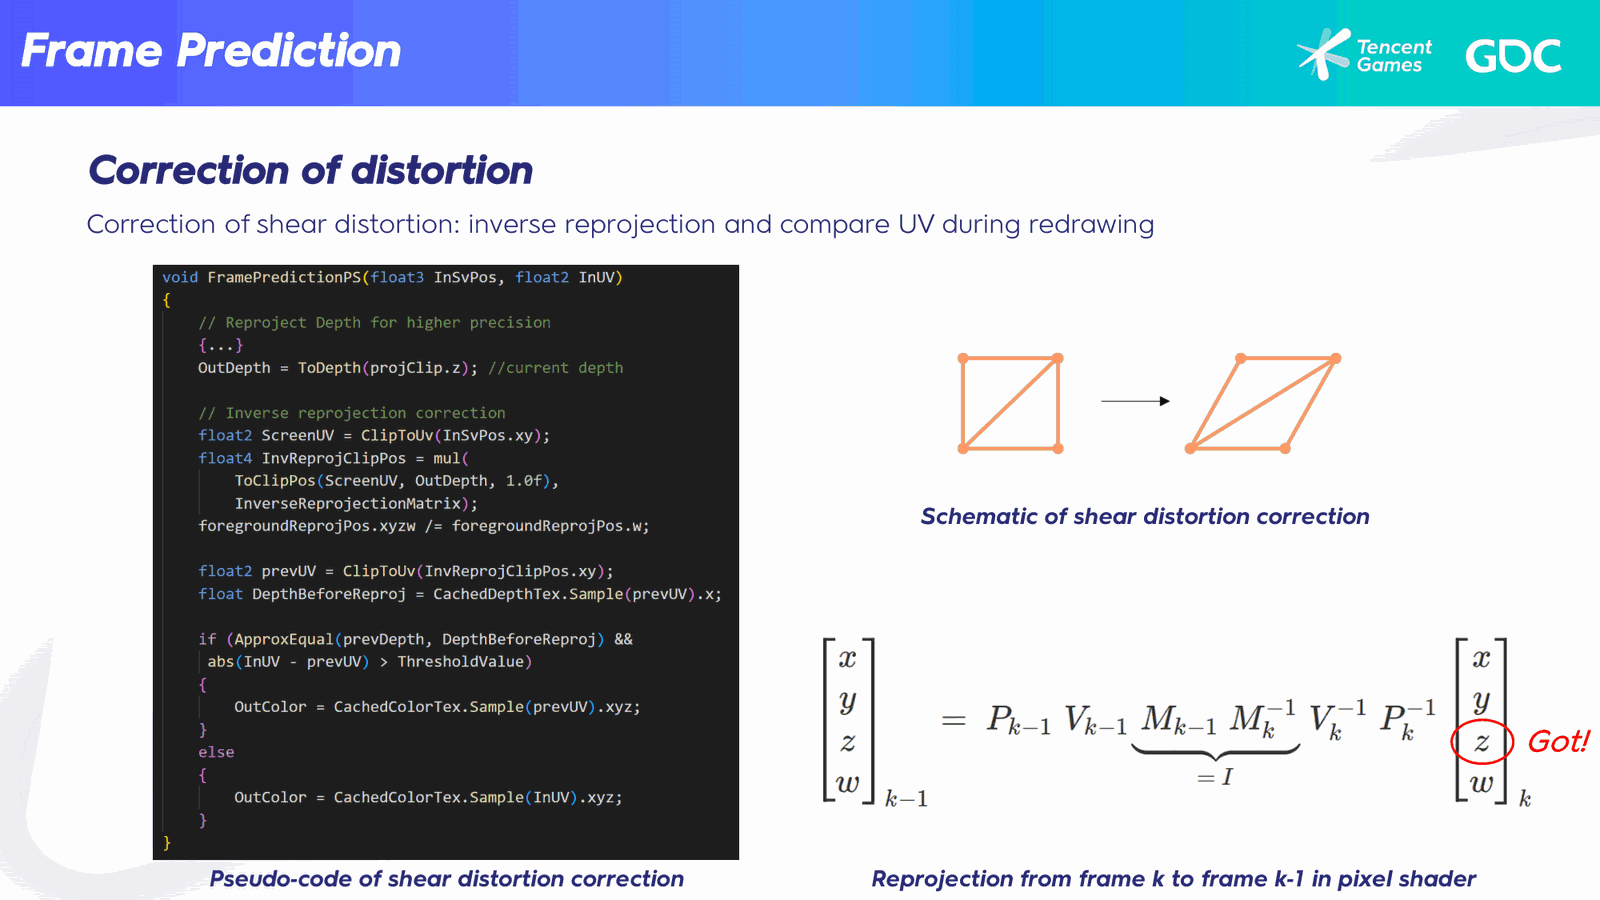
- 剪切失真校正:在SSAM重绘的像素着色器中,采样缓存深度并进行深度重投影后可获得当前帧裁剪空间位置的Z分量,再将裁剪空间位置重新投影到前一帧比较深度;若深度近似相等且UV位移大于阈值,则使用重新投影的UV替代光栅化插值的UV。
3. 准确性分析
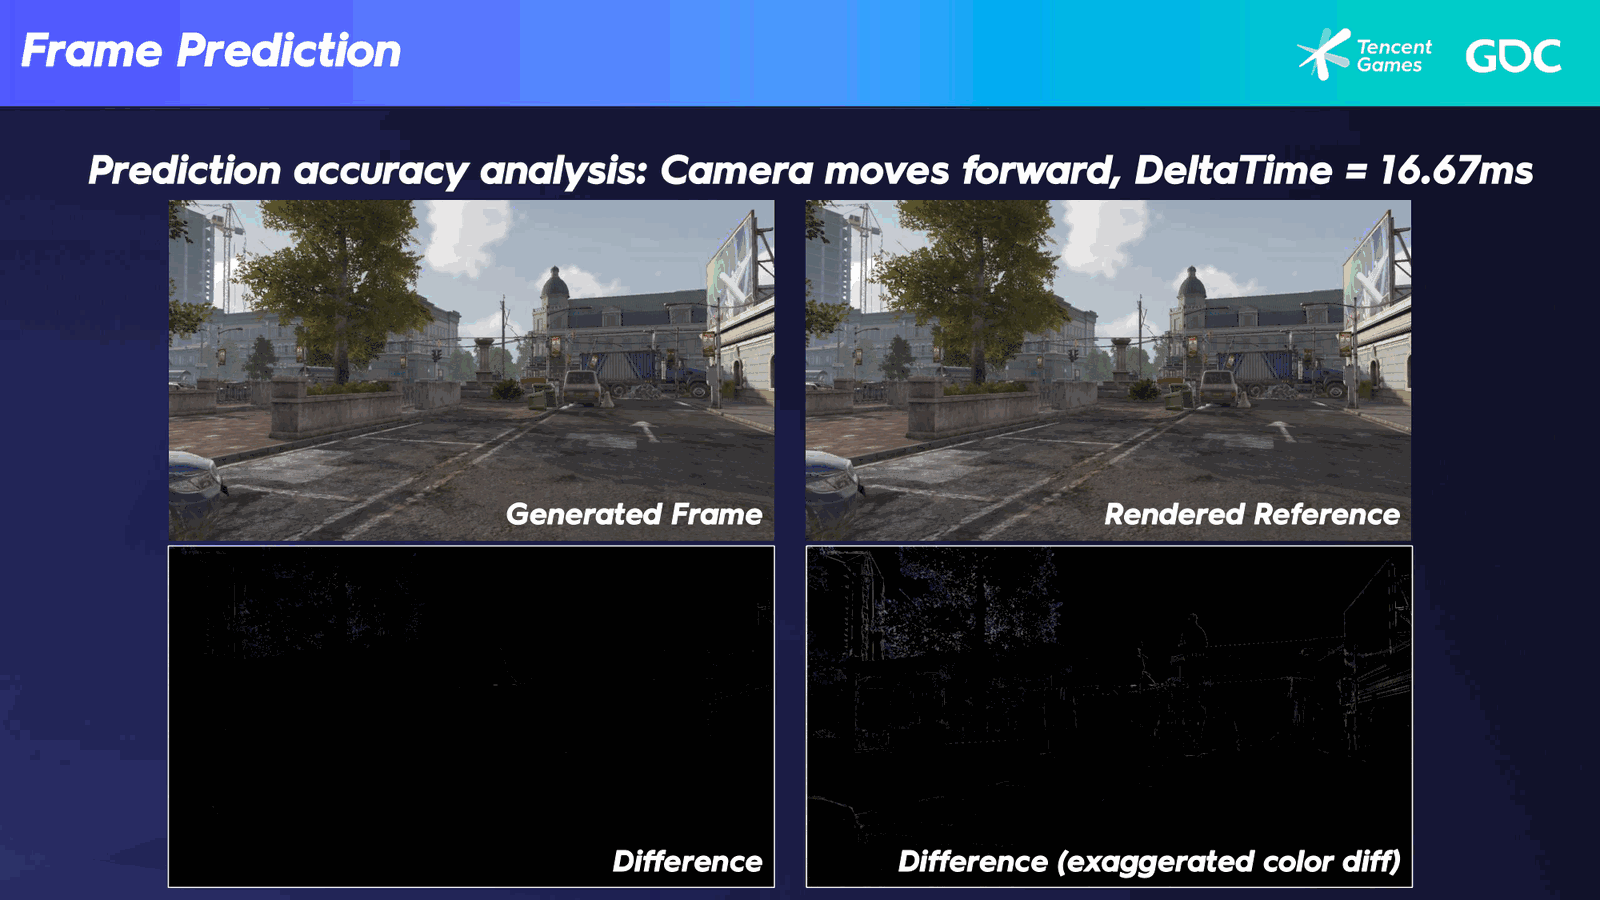
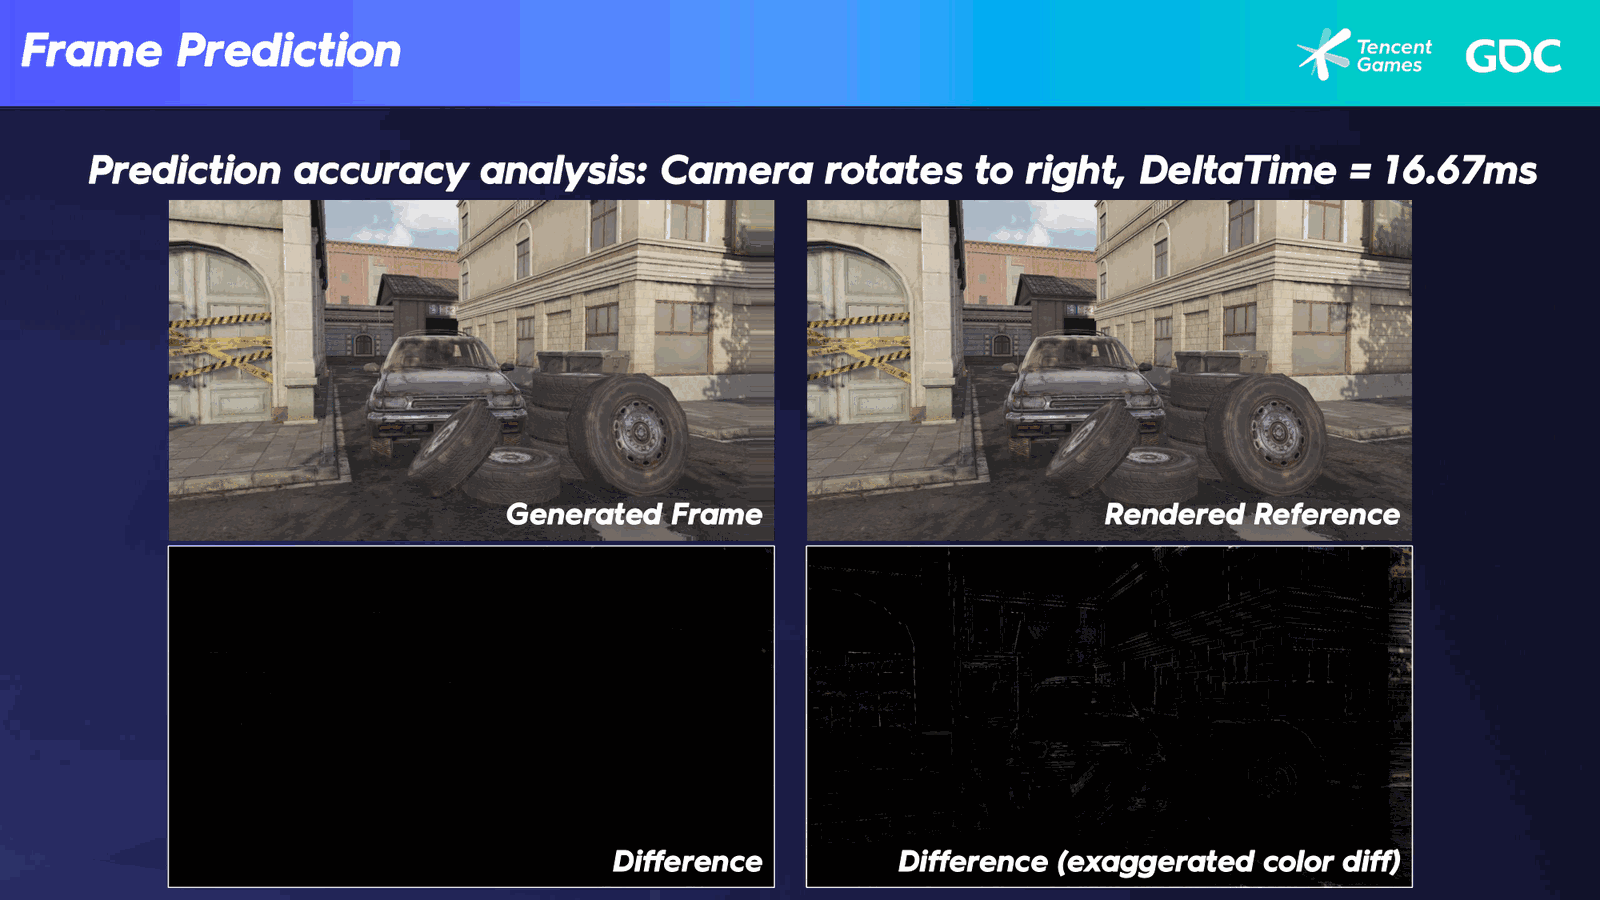
- 相机向前移动、DeltaTime为16.67ms(对应60FPS)的场景中,人眼已无法区分生成帧与渲染参考帧,差异极小。
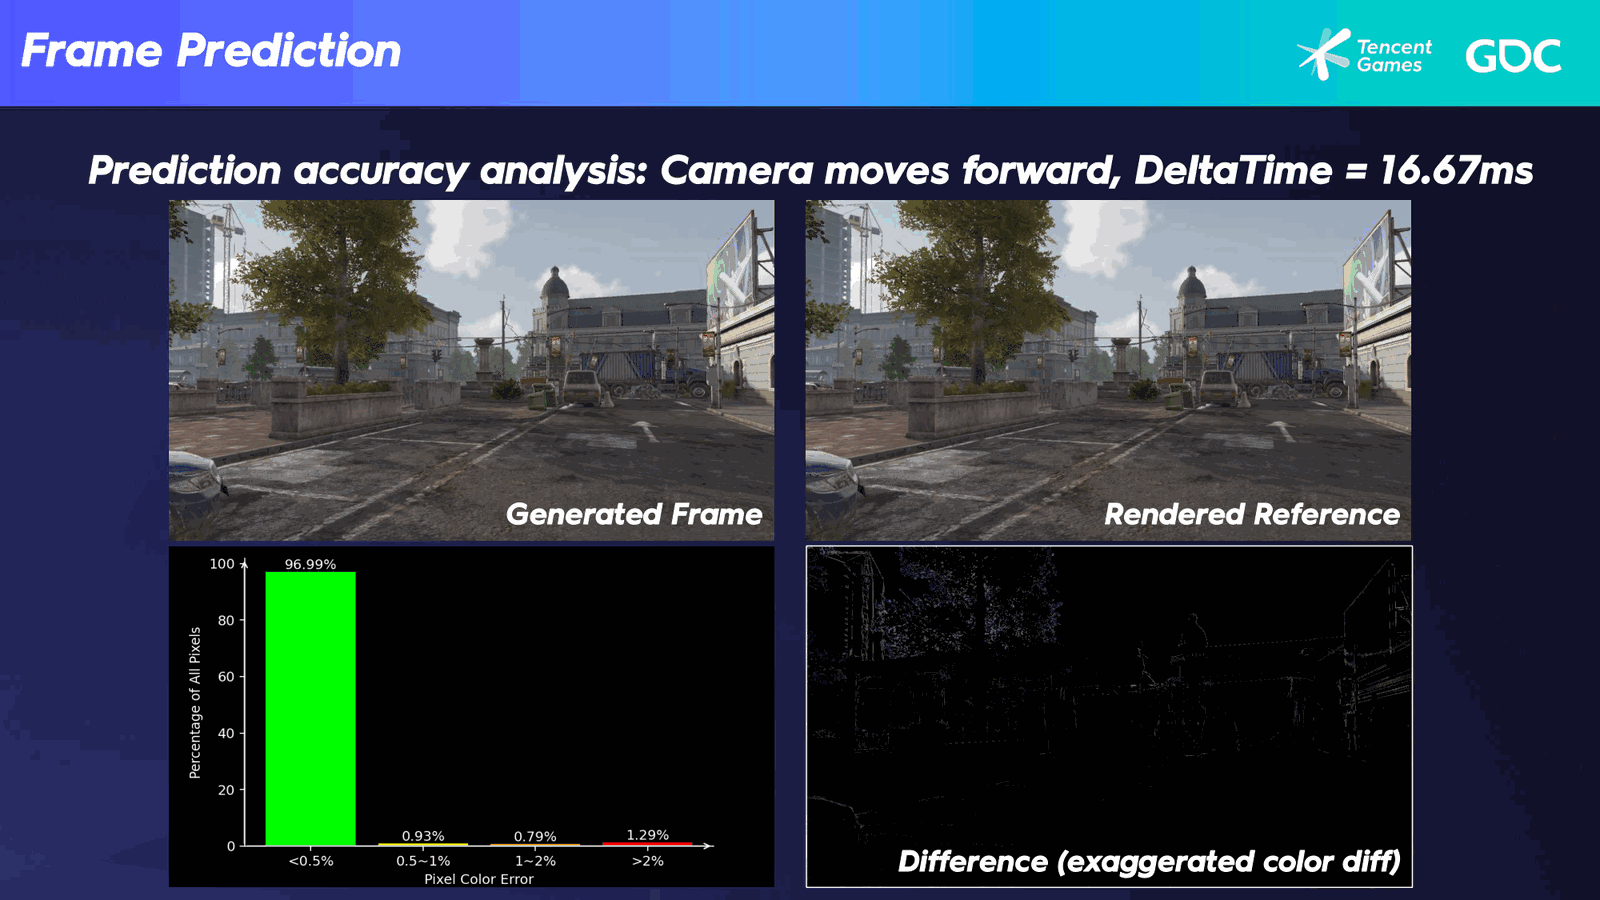
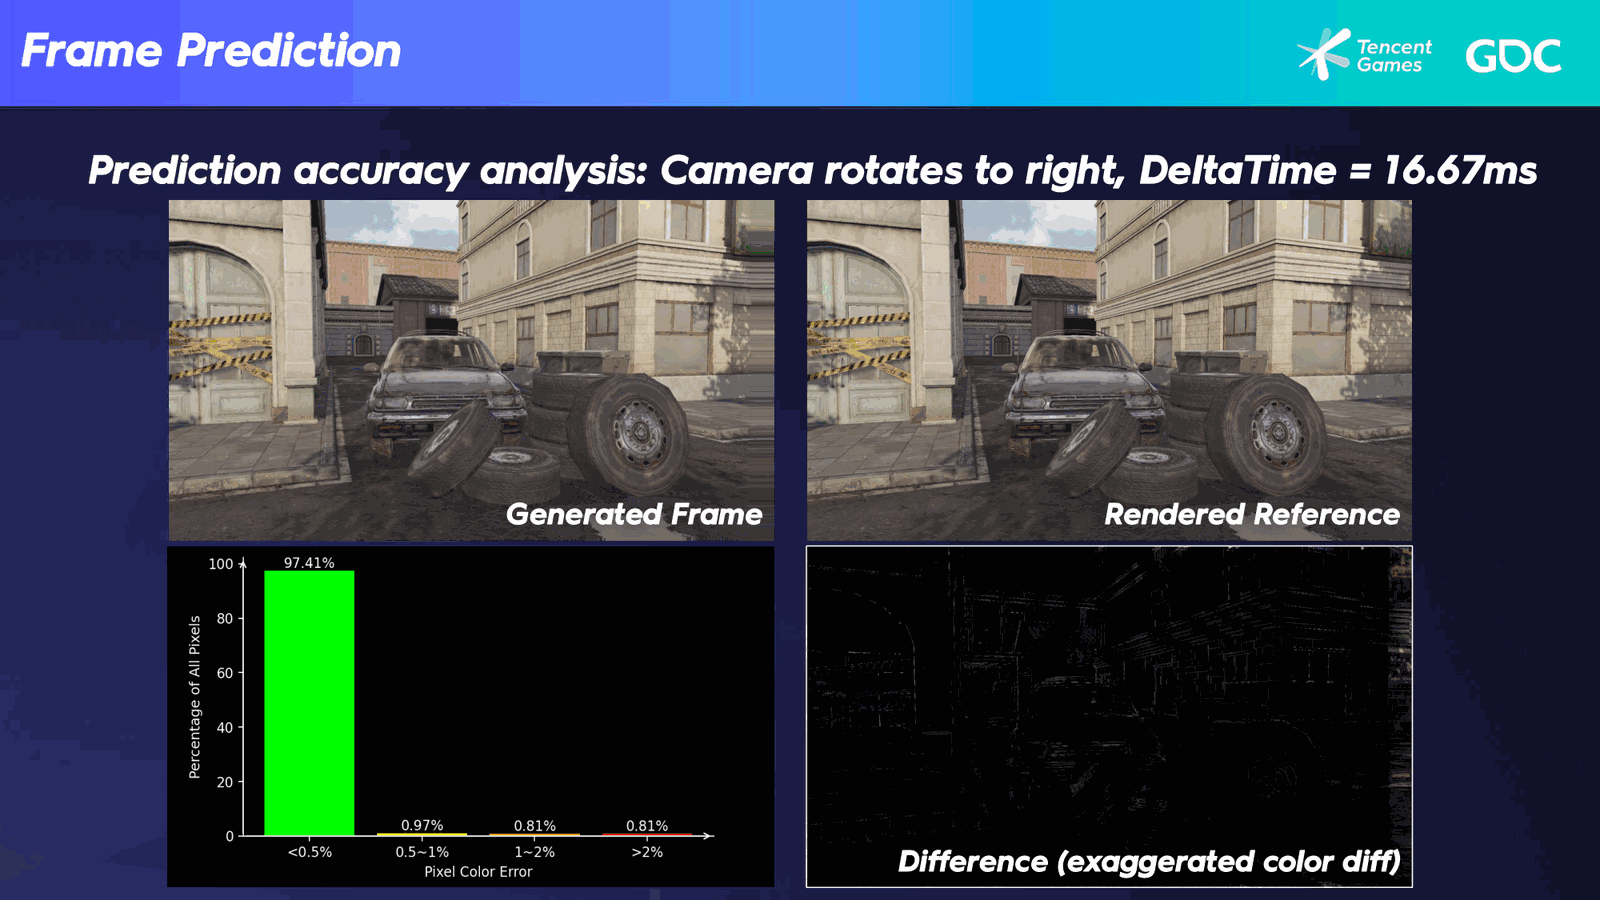
- 直方图显示仅1.29%的像素颜色差异大于2%,准确性极高。
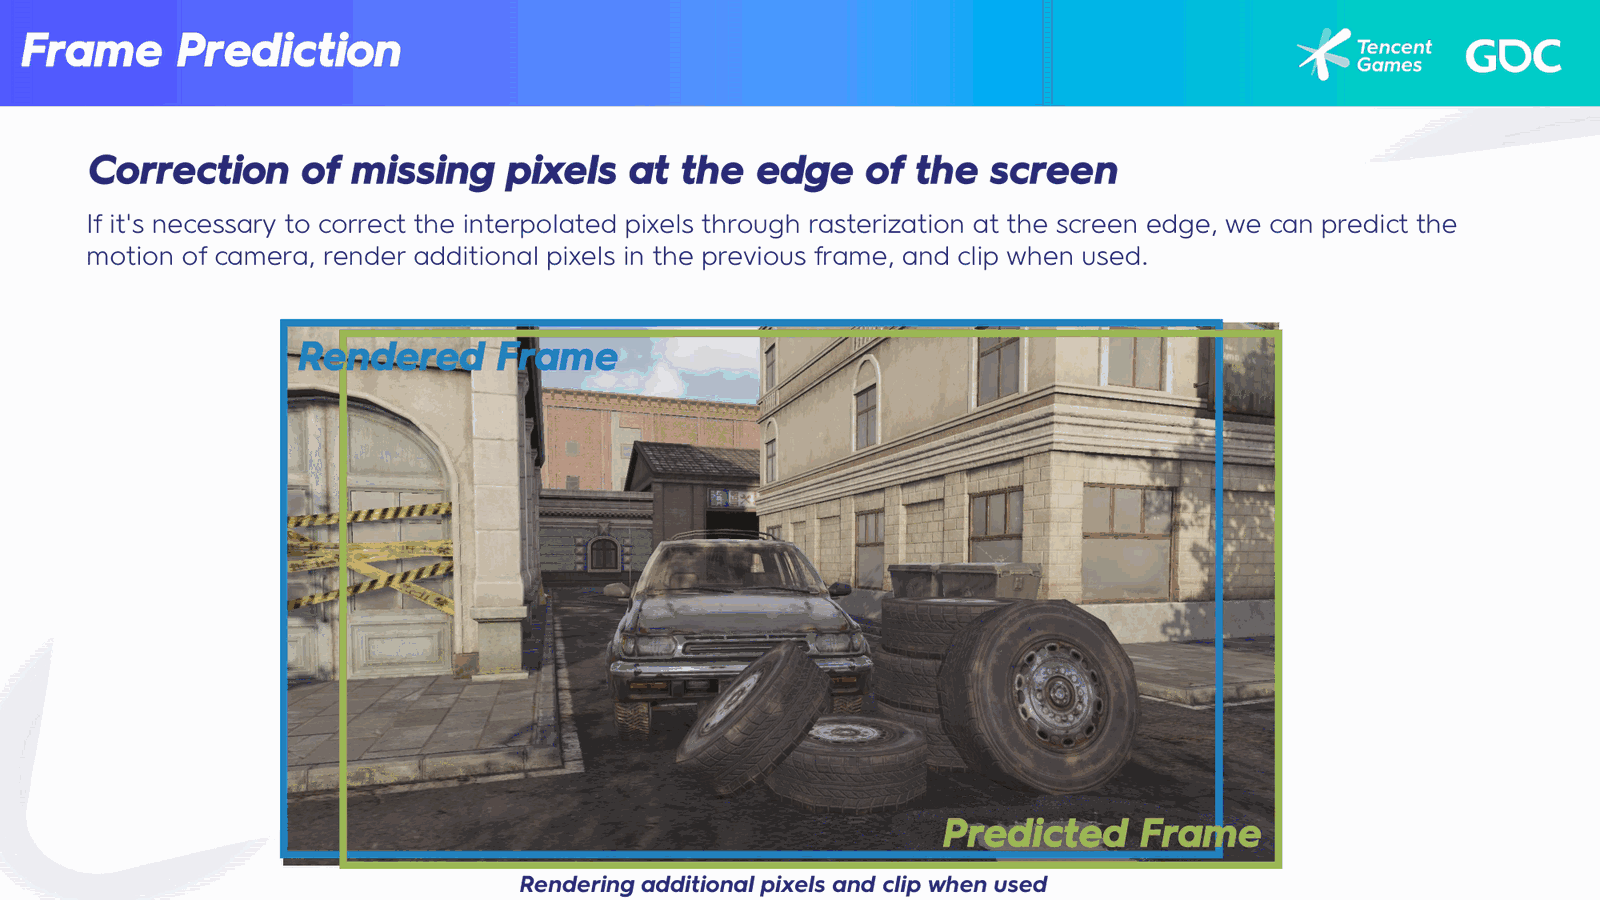
- 相机旋转时右侧会出现小区域模糊,高帧率模式下几乎不可察觉;可通过预测相机运动、扩大视锥体渲染额外区域、使用渲染目标时裁剪来校正。
4. 渲染管线
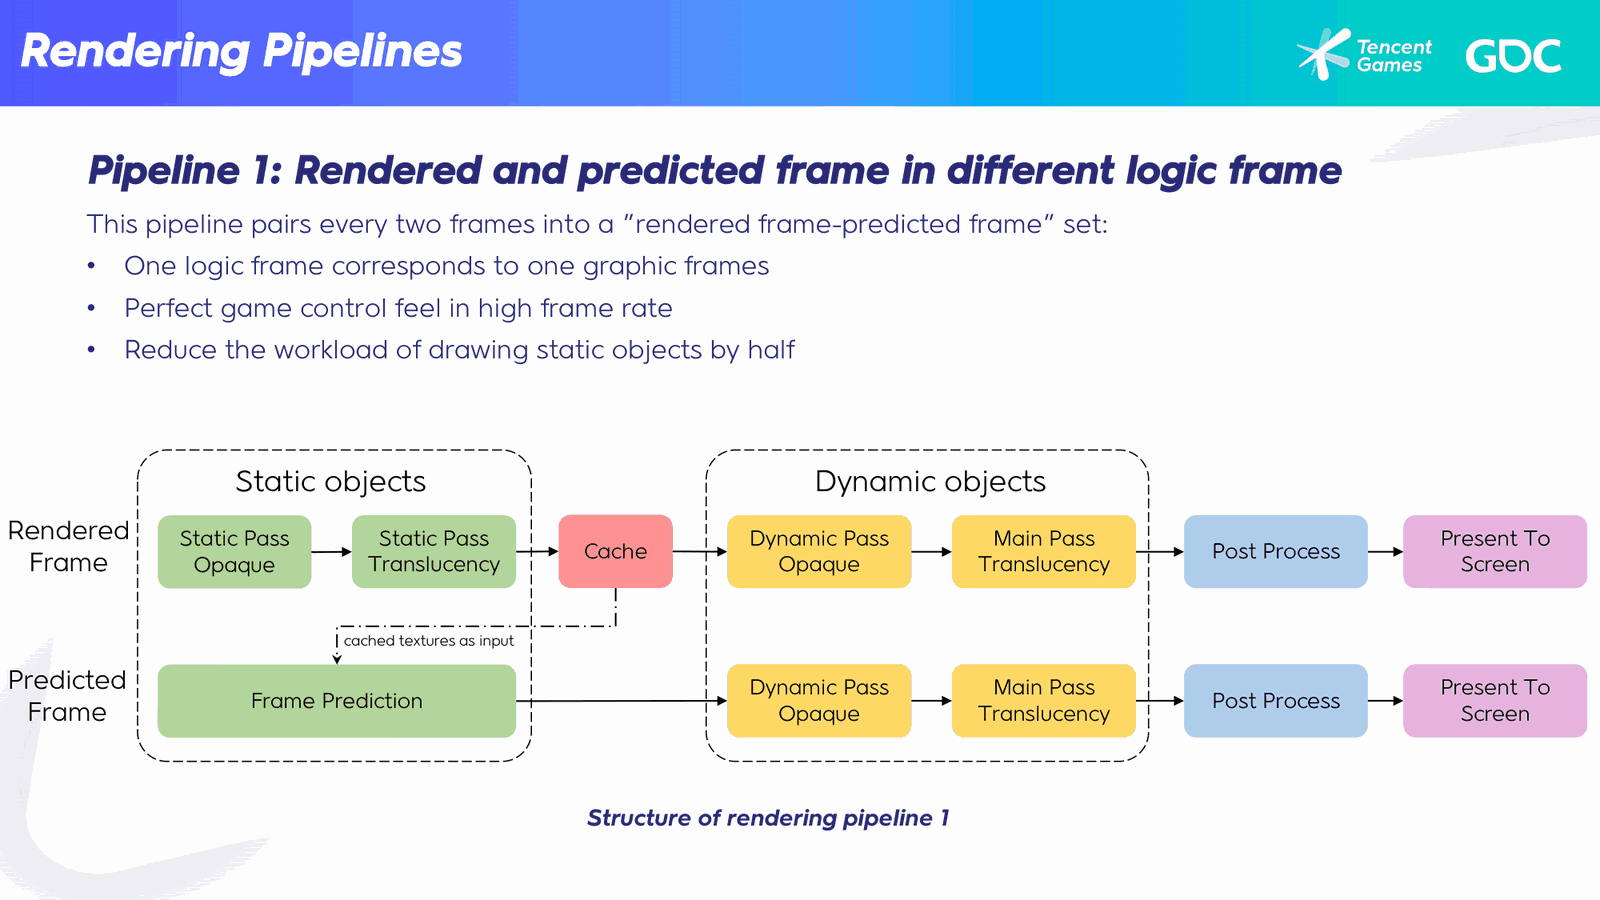
- 管线一(不同逻辑帧):渲染帧和预测帧处于不同逻辑帧,预测帧中使用帧预测代替静态对象绘制。确保高帧率下完美的游戏操控感,绘制静态对象工作量减半。
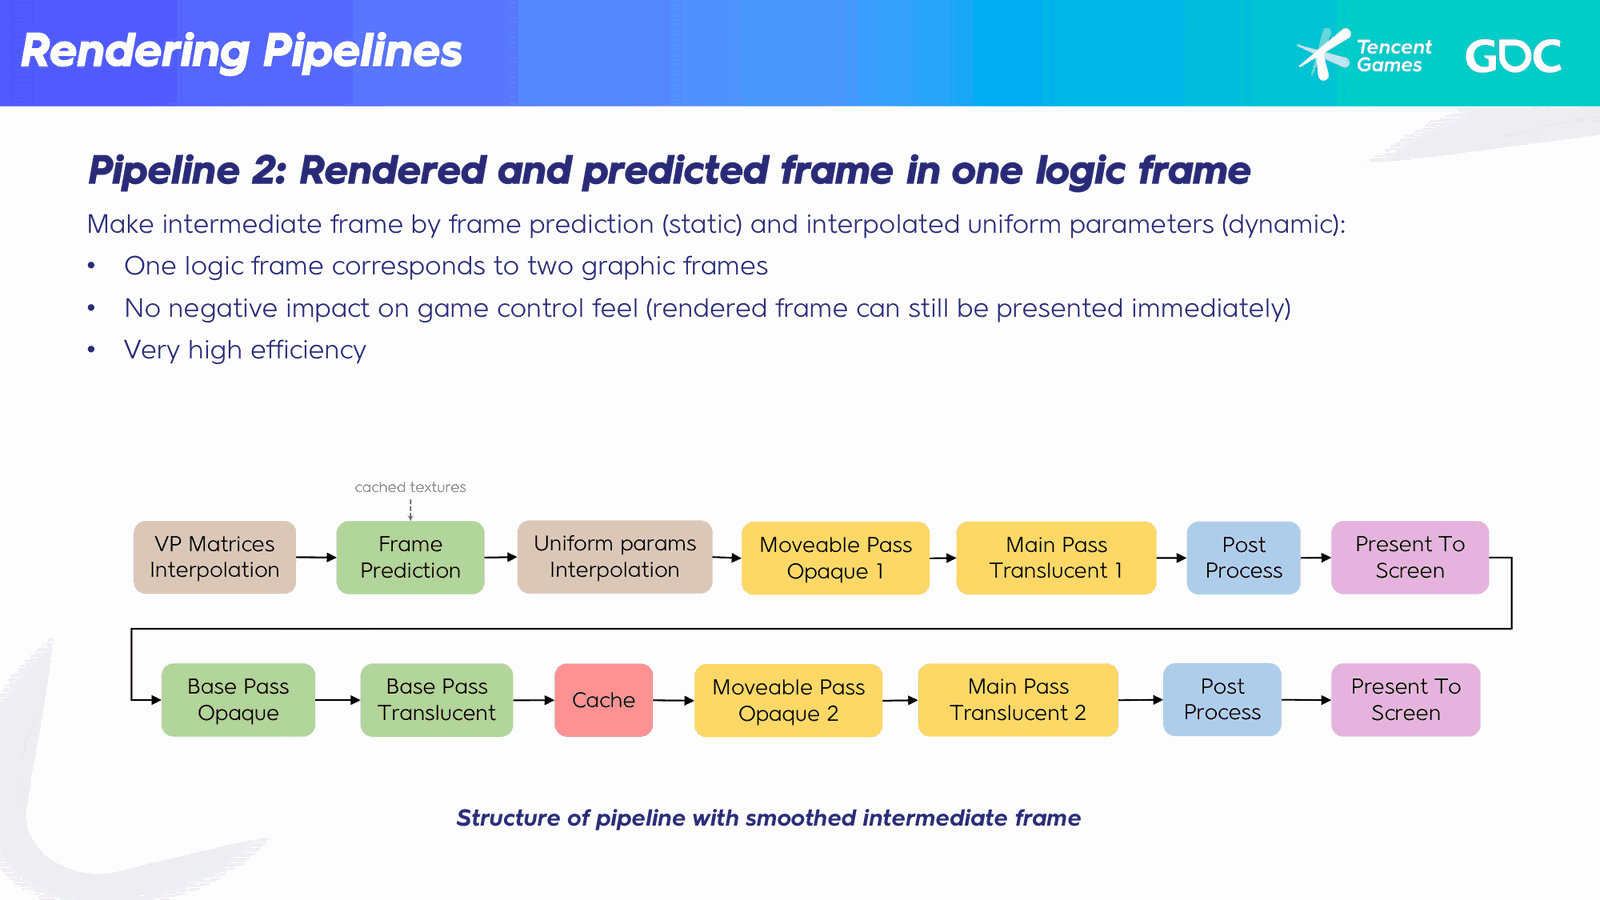
- 管线二(同一逻辑帧):渲染帧和预测帧处于同一逻辑帧,需插值VP矩阵(用于帧预测)和Uniform参数(用于动态对象),而非从完整逻辑帧计算。提供高帧率视觉体验且不影响操控感,逻辑帧率减半,效率极高。
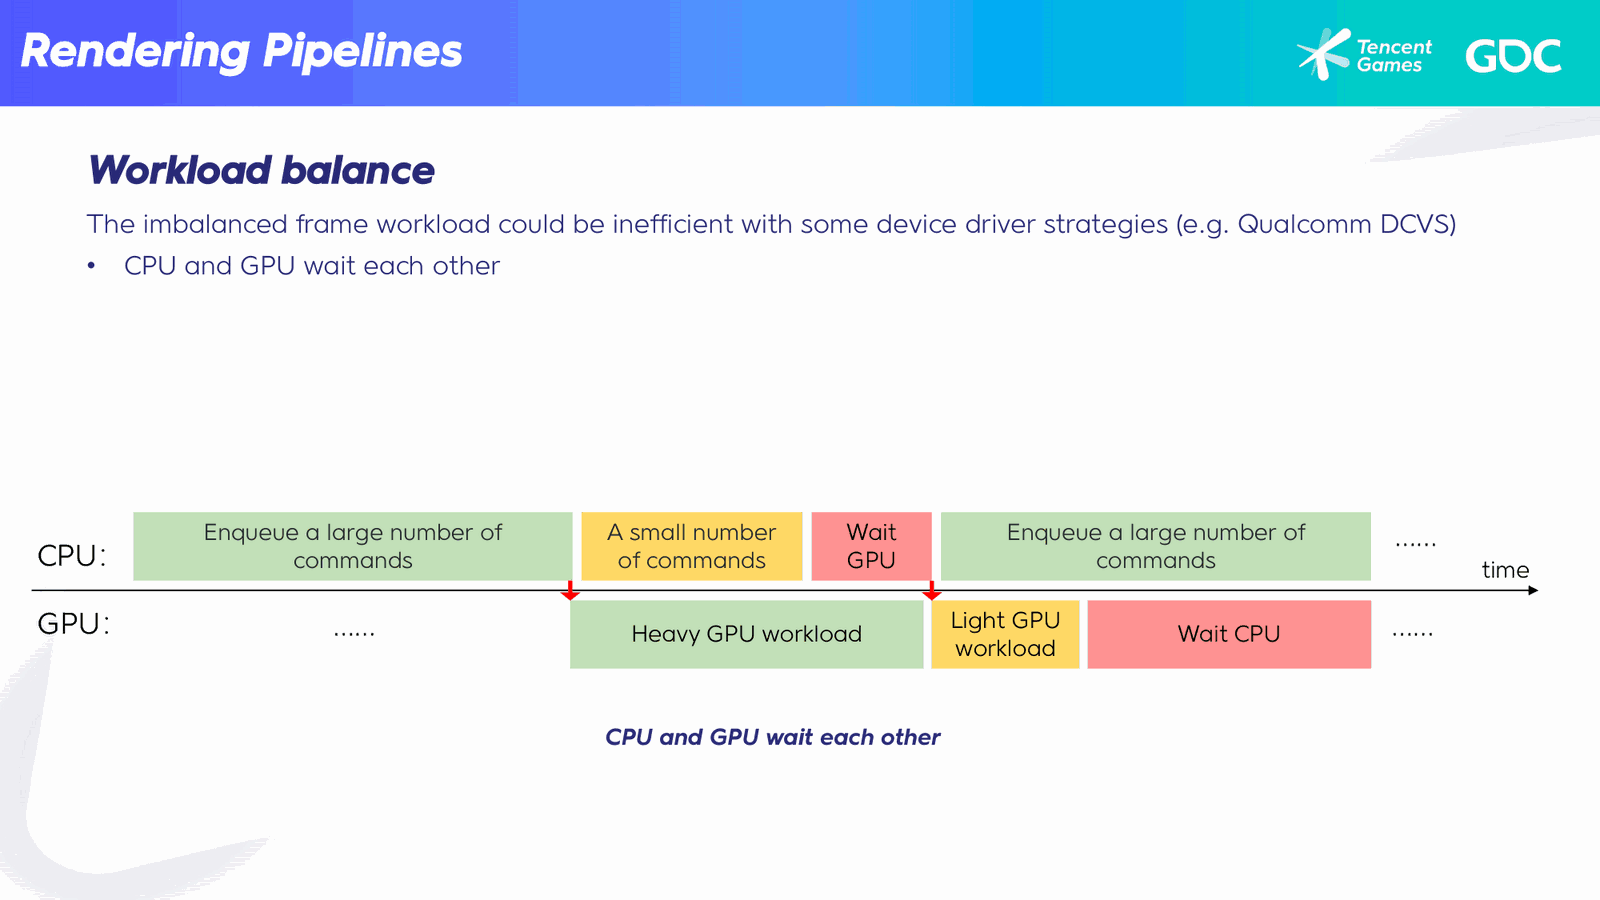
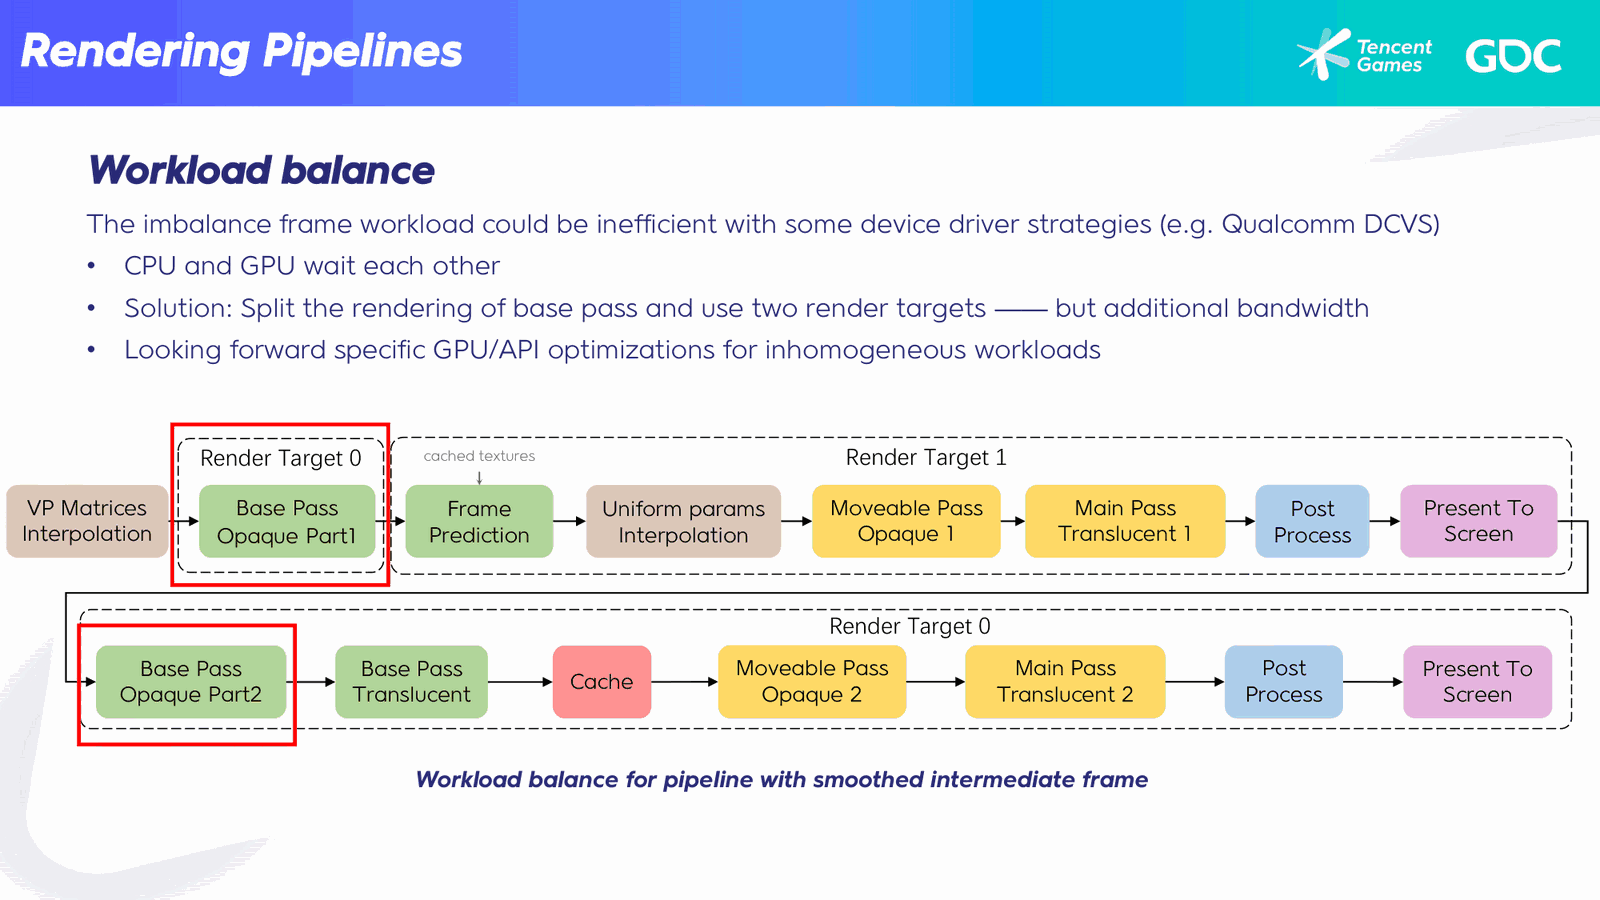
- 工作负载均衡:不平衡的帧工作负载可能导致CPU和GPU互相等待(如Qualcomm DCVS策略)。解决方案是将Base Pass渲染分为两个渲染目标,在第一帧上屏前执行第一部分,但会增加带宽成本。
5. 实际效果
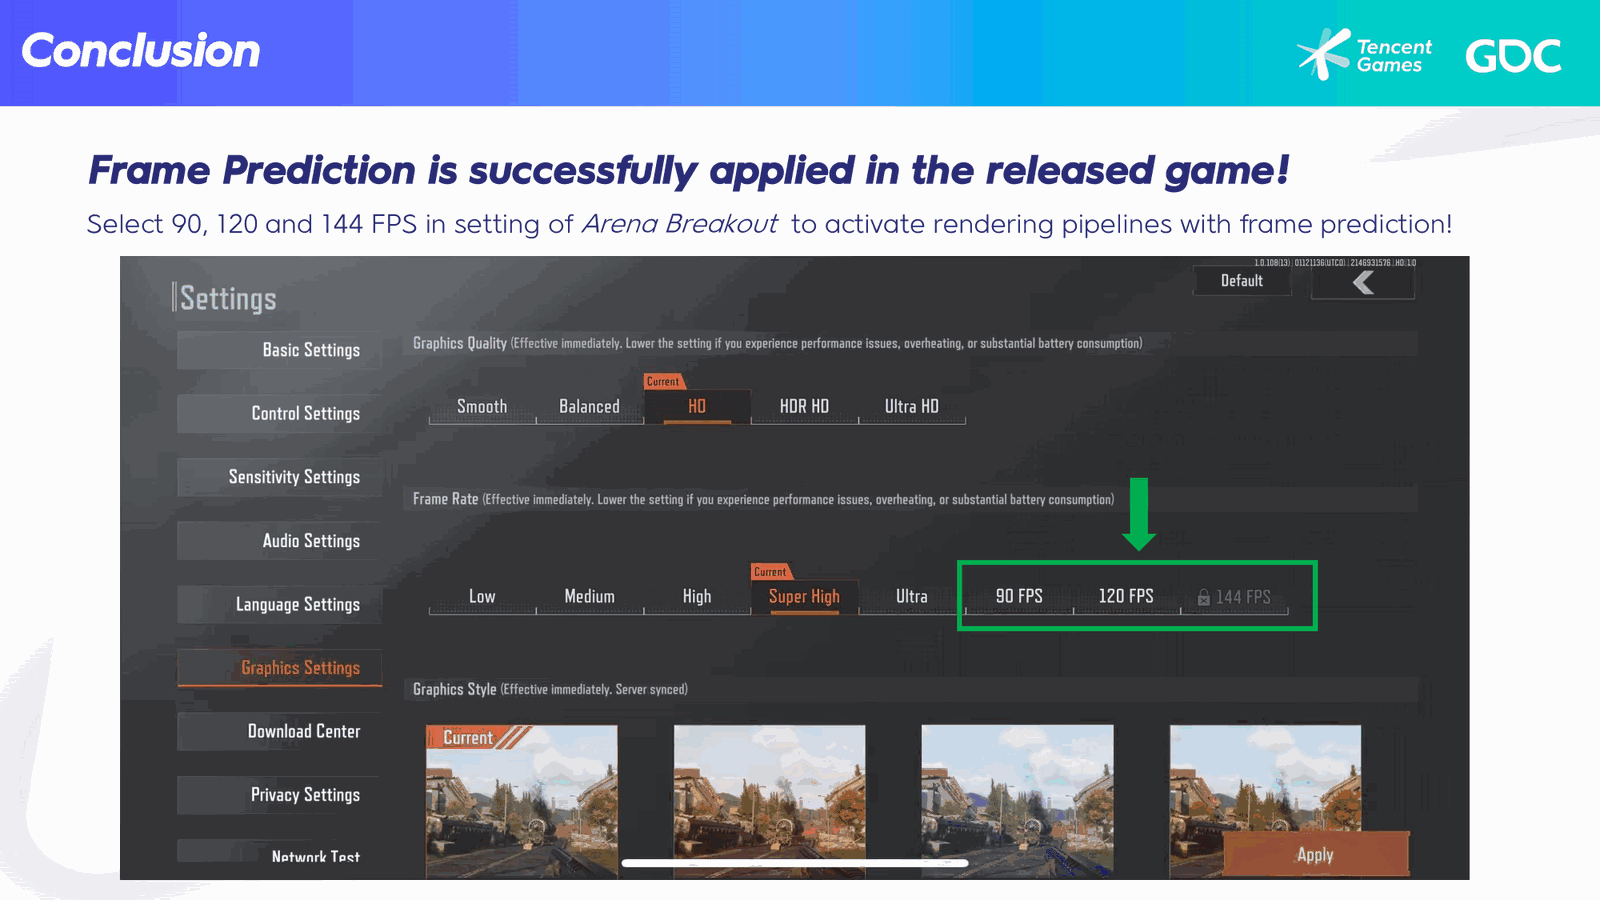
- 已成功应用于发布的《Arena Breakout》游戏,可通过设置菜单选择90/120/144 FPS激活。
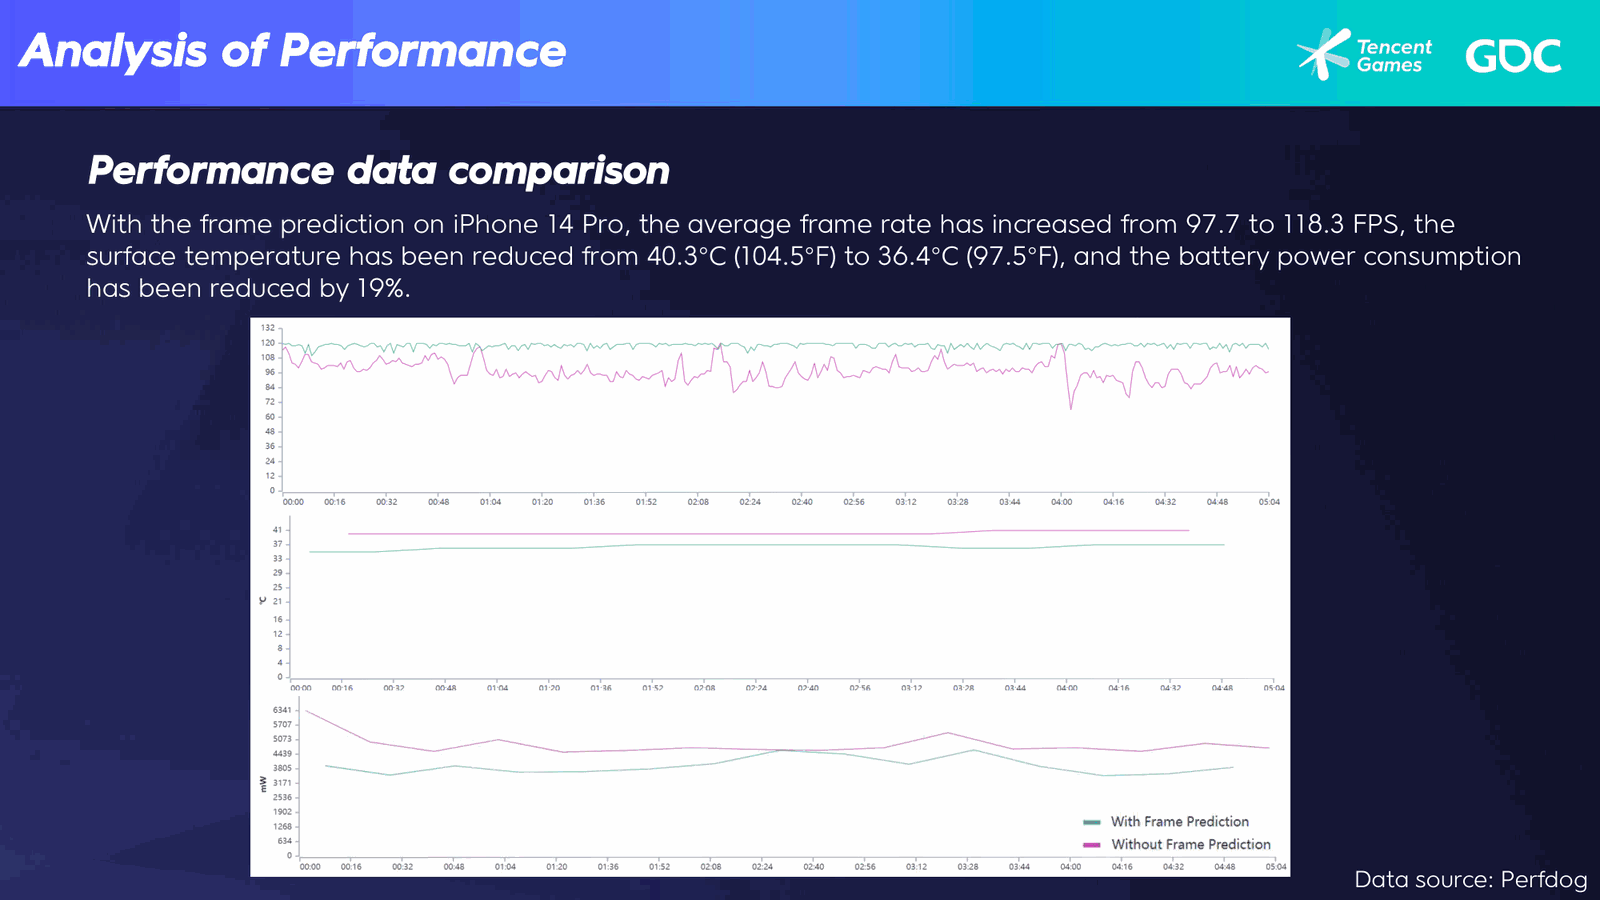
- iPhone 14 Pro:平均帧率从97.7提升至118.3 FPS,表面温度下降约4°C,电池功耗减少19%。
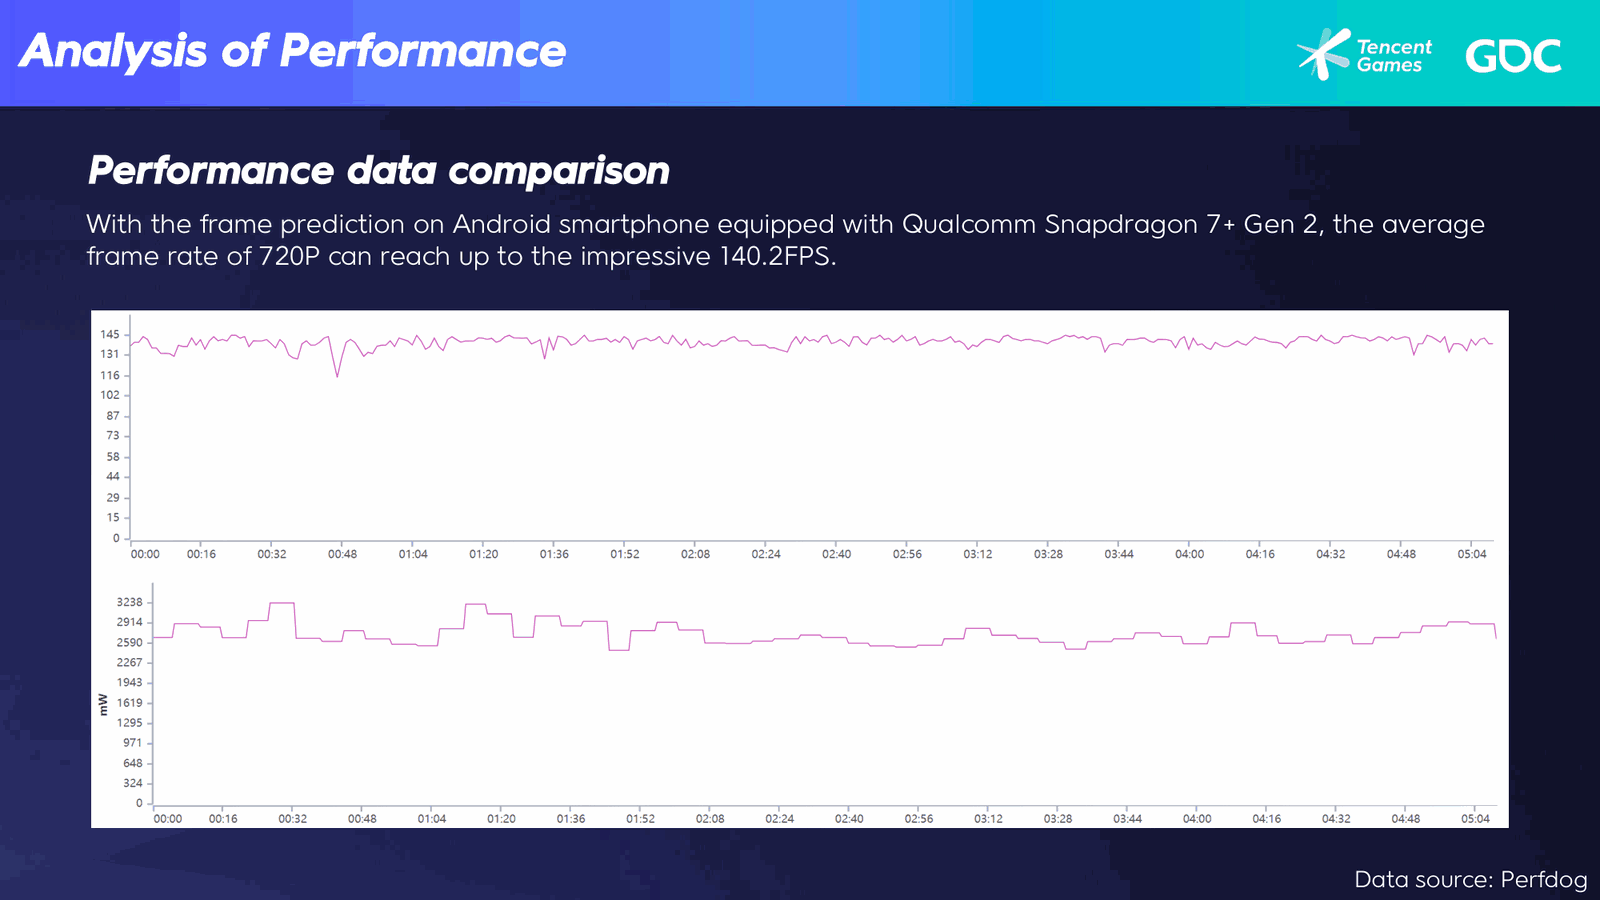
- 高通骁龙7+ Gen 2安卓手机(非旗舰芯片):平均帧率达140.2 FPS。
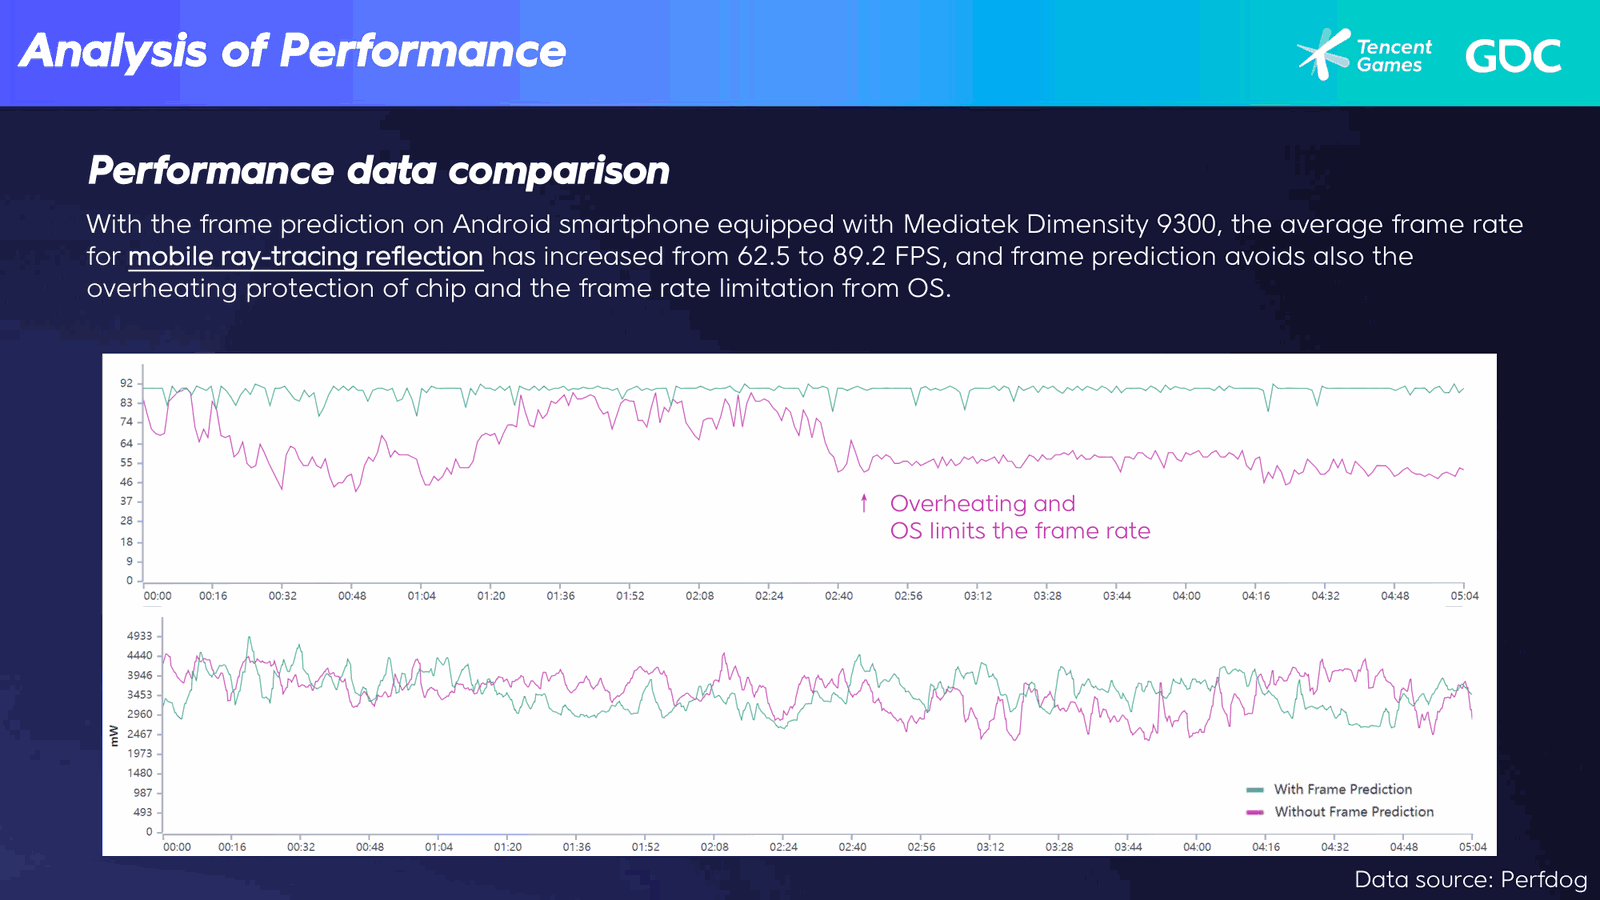
- 光线追踪场景:无帧预测时电池过热保护迅速触发,帧率被限制在约50 FPS;启用帧预测后帧率稳定运行在90 FPS。
6. 进一步应用
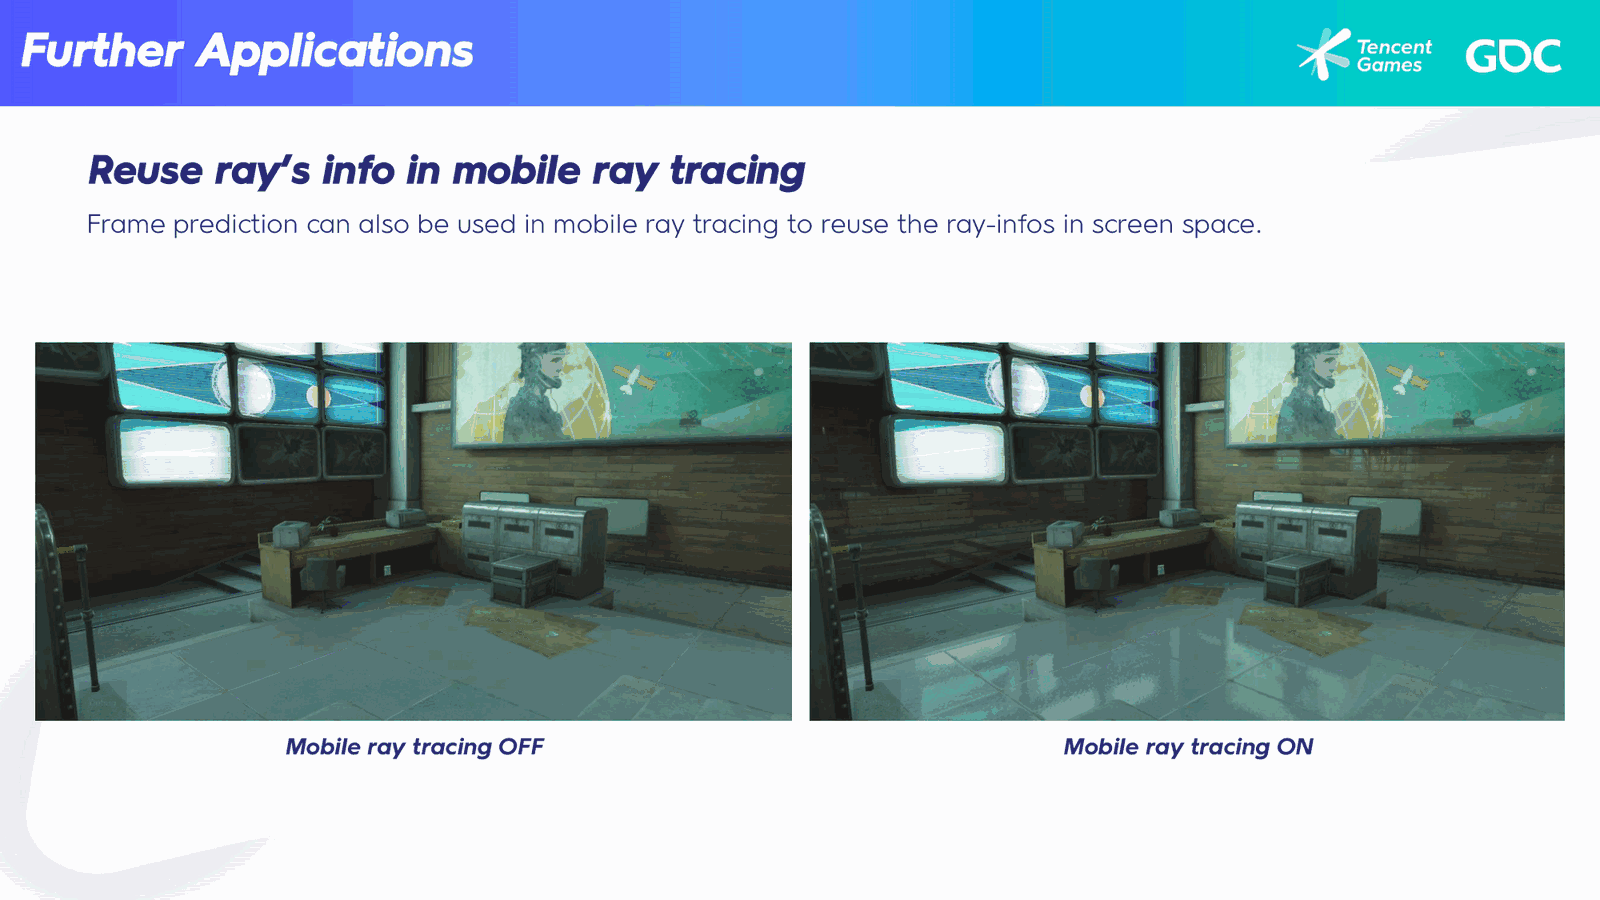
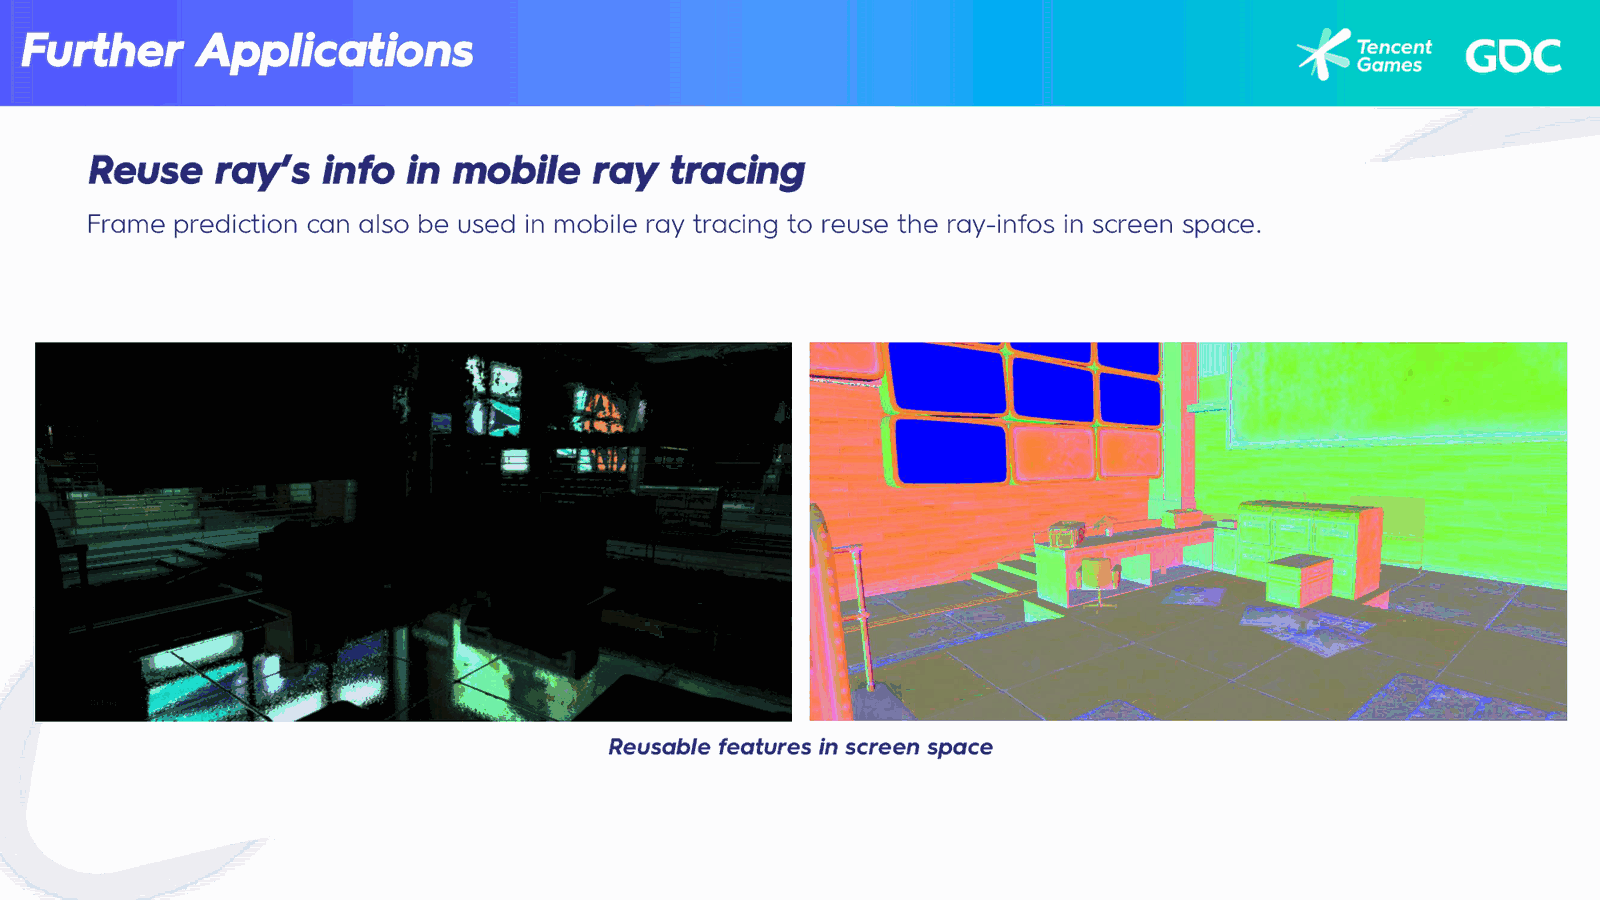
- 移动光线追踪加速:各种类型的光线信息可存储在屏幕空间中,通过帧预测高效重用。
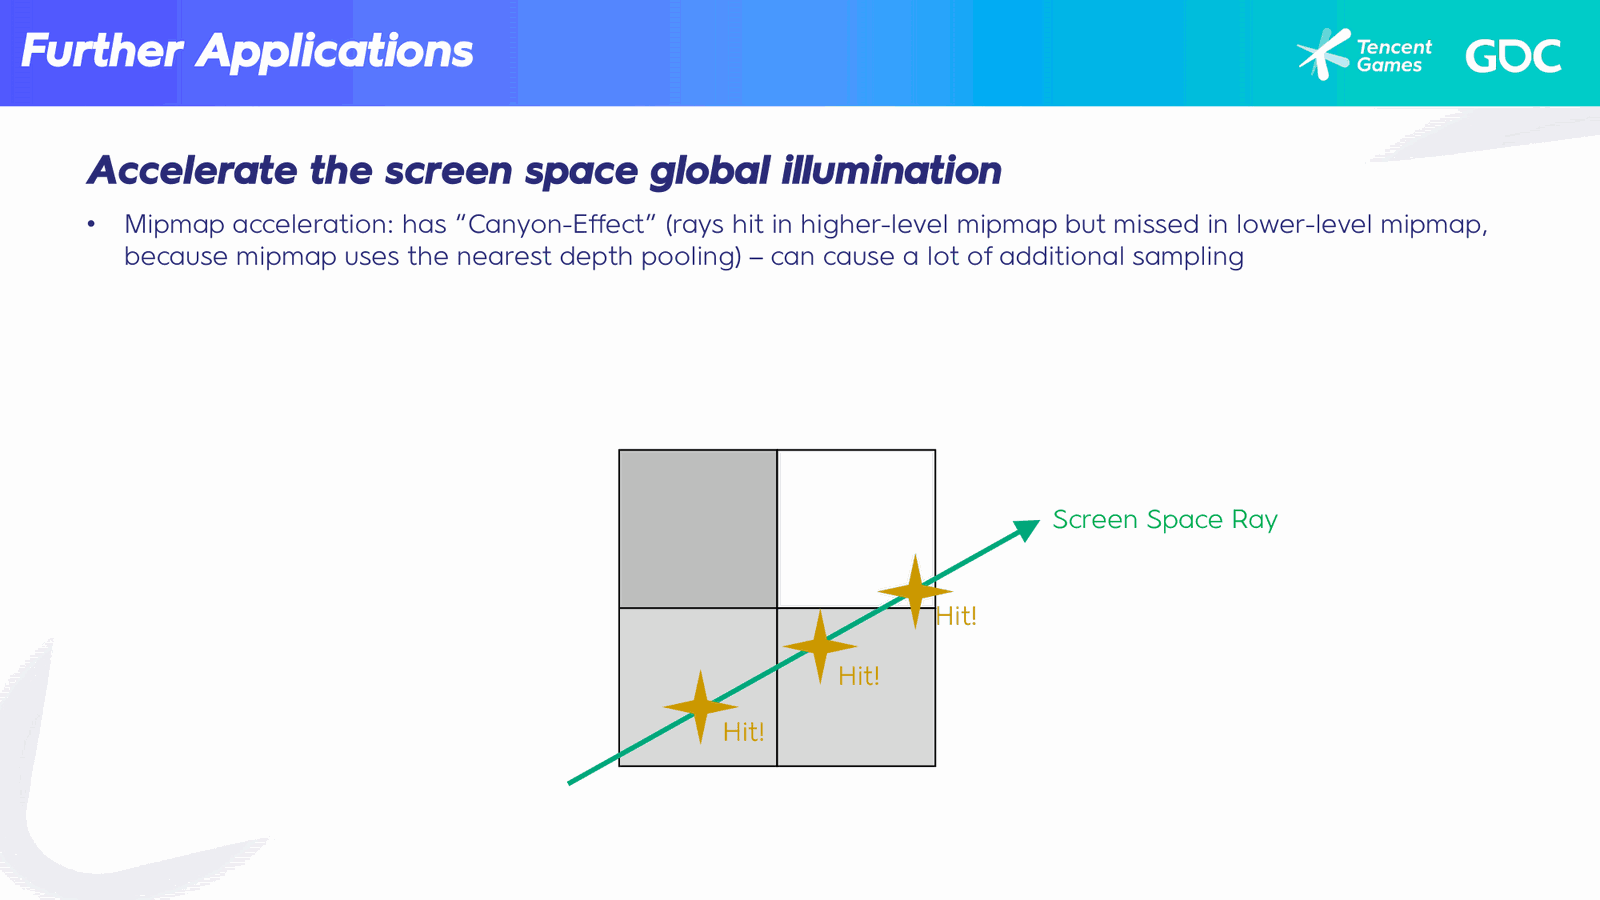
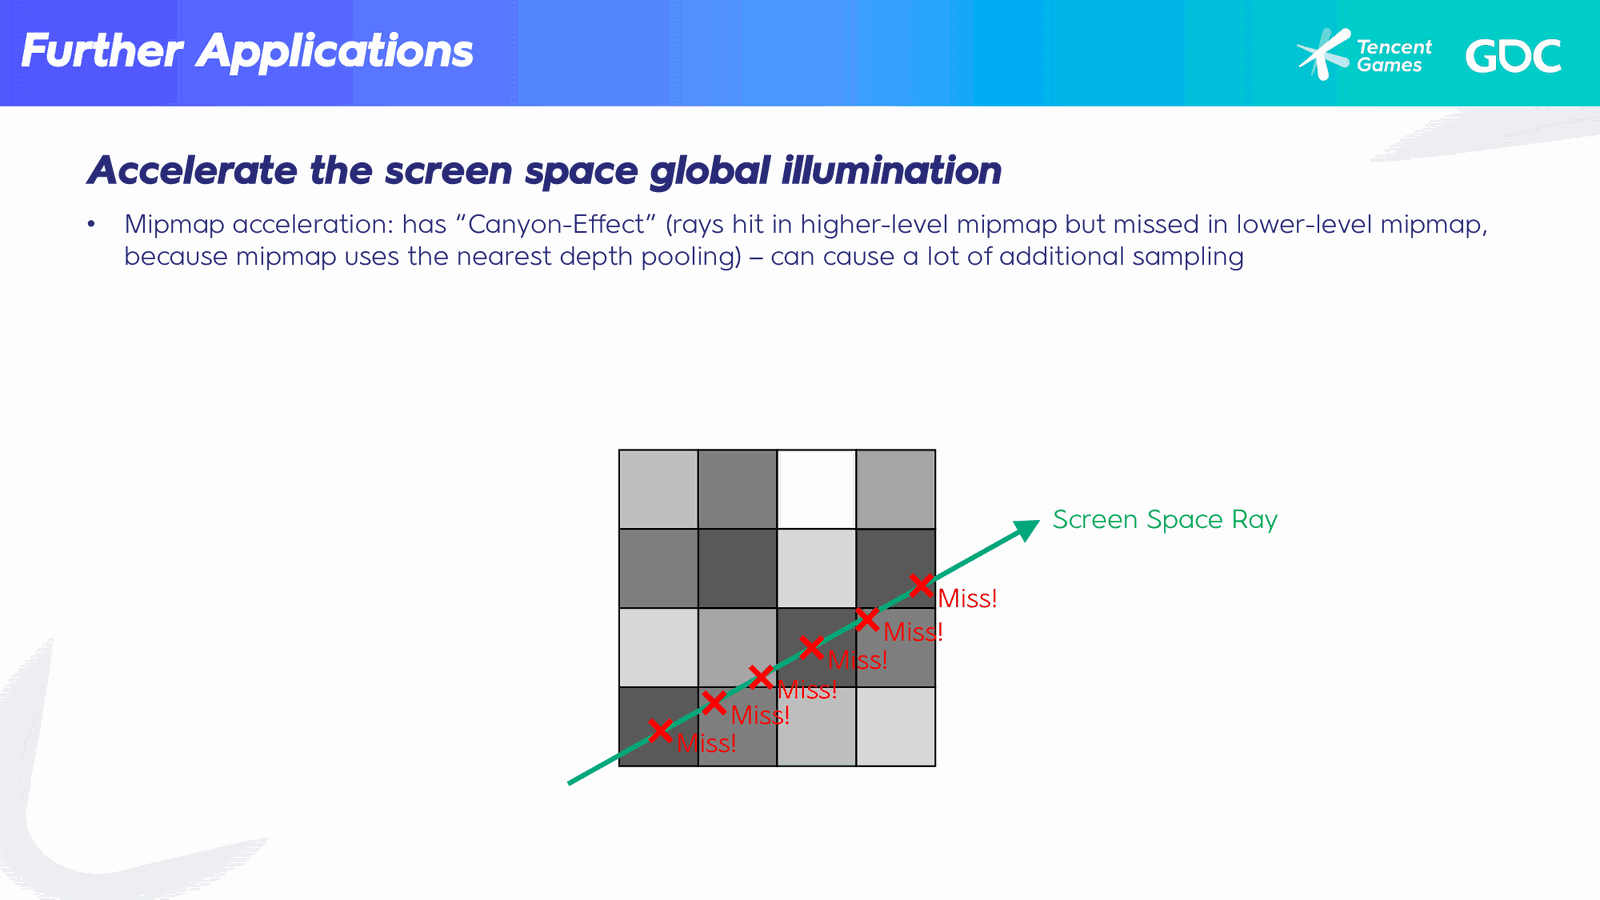
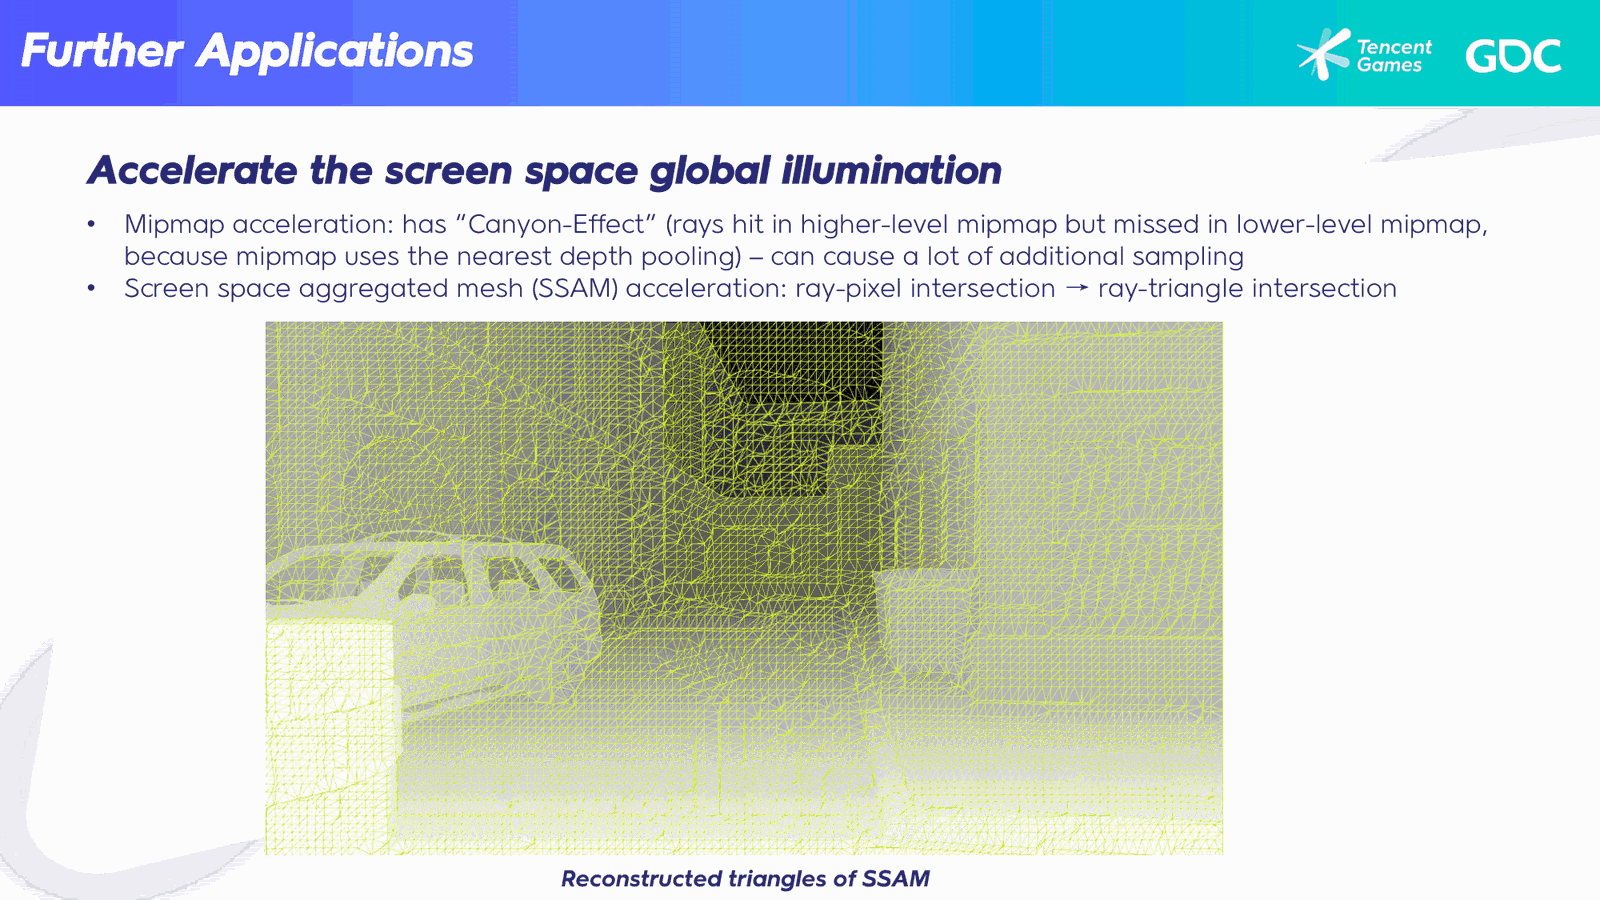
- SSGI加速:SSAM可用于加速屏幕空间全局光照中的光线交点计算。传统深度mip-map存在”峡谷效应”(Canyon-effect)导致过采样,SSAM让光线与三角形而非像素相交,可避免过采样并加速。
二、移动光线追踪(Mobile Ray Tracing)技术总结
1. 游戏背景
- 《Arena Breakout Mobile》是一款开放世界战术FPS游戏,基于UE4.26。
- 包含大量网格实例(>100,000)、流级别(>3,000),场景管理复杂。
2. 光线追踪功能
- 反射(Reflection):
- 使用光线追踪实现高质量的光泽反射,提升画面真实感。
- 软阴影(Soft Shadows):
- 通过光线追踪实现更自然的阴影效果,优于传统阴影贴图。
- 环境光遮挡(Ambient Occlusion):
- 使用光线追踪实现更真实的间接光照效果。
- 动态天气系统:
- 与光线追踪结合,实现动态光照和阴影变化。
3. 技术实现
- Vulkan API支持:
- 为Android平台启用Vulkan API。
- 使用ShaderC编译器支持最新着色器指令。
- RHI扩展:
- 扩展UE4的Vulkan和Metal RHI,支持光线追踪指令。
- 移动GPU支持:
- 最新智能手机支持硬件加速的光线追踪(Inline Ray Tracing)。
4. 优化挑战
- BLAS(Bottom-Level Acceleration Structure)内存占用:
- 需要优化内存使用,减少资源开销。
- BLAS构建成本:
- 构建过程耗时,需优化构建流程。
- TLA(Top-Level Acceleration Structure)实例过多:
- 需要优化实例管理,提升光线追踪效率。
5. 实际效果
- 画面质量提升:
- 实现高质量反射、软阴影、环境光遮挡。
- 玩家体验提升:
- 更加沉浸、逼真的游戏画面。
- 性能控制:
- 通过优化,实现高帧率下的光线追踪渲染。
三、总结
| 技术方向 | 优势 | 挑战 | 应用场景 |
|---|---|---|---|
| 帧预测 | 提升帧率、降低功耗与温度、提升操控感、不依赖特定硬件 | 需修改渲染管线、处理非均匀负载带来的CPU/GPU互相等待、拉伸/剪切失真校正 | 移动端高帧率游戏 |
| 移动光线追踪 | 提升画面真实感、沉浸感 | BLAS内存占用与构建成本、TLA实例过多、延迟渲染带宽高 | 开放世界战术FPS、高质量图形游戏 |
四、后续方向
- 帧预测:
- SSAM可加速SSGI中的光线交点计算,避免深度mip-map的峡谷效应导致的过采样。
- 帧预测可提升移动光线追踪的性能,各类光线信息存储在屏幕空间中通过帧预测高效重用。
- 探索在非游戏领域(如AR/VR)的应用。
- 移动光线追踪:
- 优化BLAS/TLAS结构,提升光线追踪性能。
- 探索在更多游戏类型中的应用(如RPG、开放世界、模拟类)。
如果您需要我将这些内容整理成PPT大纲、技术文档、演讲稿或宣传文案,我也可以继续协助!欢迎继续提问。
Slide 1 — 00:01:12

📌 要点汇总
- 随着硬件进步,主流移动设备现已支持高屏幕刷新率(90、120、144 Hz甚至更高)。
- 玩家希望在移动设备上在不降低图形质量的情况下获得更流畅的游戏体验。
- 高帧率面临三大挑战:图形质量与帧率冲突(更高图形质量需要更多渲染时间,会降低帧率)、大量电池功耗、电池过热。
- 现有方法(深度学习、软件超分辨率、帧插值)均有各自缺陷,无法兼顾性能与功耗。
首先,随着硬件的进步,现在主流的移动设备都支持高帧率,比如 90、120、144Hz,甚至更高。玩家需要流畅的游戏体验,同时又不降低移动设备上的图形质量。然而,高帧率也带来了一些挑战,例如图形质量与帧率之间的冲突:更高的图形质量需要更多的渲染时间,但会降低帧率。此外,高帧率模式下的大量电池消耗与电池过热也是令手游开发商头疼的问题。
我们曾尝试用现有的方法来解决这些问题,但它们都有各自的缺点。
Slide 2 — 00:02:02
📌 要点汇总
- 深度学习方法依赖特定硬件,无法在所有现存设备上使用。
- 运行神经网络需要大量时间开销和电池功耗,有时甚至比渲染一帧图形还要多。
- 基于软件的超分辨率(如FSR)通过计算像素周围边缘进行上采样,但需要大量邻域像素采样(FSR需12个邻域像素)。
- 大量邻域像素采样导致显著的时间和带宽成本,对移动设备不友好。
我们首先尝试使用近年来流行的深度学习方法。然而,运行神经网络需要特定的硬件,这意味着它不能在所有现存设备上使用。此外,运行神经网络也需要大量的时间开销和电池功耗,有时甚至比渲染一个图形帧还要多。
第二个解决方案是基于软件的超分辨率,它通过计算像素周围的边缘来进行上采样。但它需要大量的邻域像素采样,这导致了显著的时间和带宽成本。例如FSR,它需要12个邻域像素的采样,这种操作对移动设备很不友好。
Slide 3 — 00:02:52
📌 要点汇总
- 根据测试,超分辨率在移动设备上帧率提升很小,无法满足高帧率需求。
- 帧插值使用前一帧和后一帧生成中间帧以平滑视觉体验,但会引入额外的操作响应延迟时间(跟手延迟)。
- 响应延迟时间指从玩家输入到相应反馈在屏幕上呈现所需的时间。
- 较低的响应延迟时间可提高反应速度、改善游戏体验。
此外,根据我们的测试,超分辨率在移动设备上提升的帧率很小,这意味着它无法满足移动设备上的高帧率要求。
第三个解决方案是插帧,它使用前一帧和后一帧生成中间帧以平滑视觉体验。然而,插帧会引入额外的操作响应延迟时间。响应延迟时间是指从玩家输入到相应的反馈在屏幕上呈现所需的时间。显然,较低的响应延迟时间可以提高反应速度,改善游戏体验。
Slide 4 — 00:03:42
📌 要点汇总
- 无插帧时,每一帧在渲染后可以立即上屏。
- 使用插帧时,后一帧必须在中间帧生成后并等待一定间隔才能上屏,因为中间帧需要首先上屏。
- 这额外的响应延迟时间使得带插帧的120Hz体验比不带插帧的60Hz更差,在动作游戏中影响尤其严重。
- 由于现有方法均不适用,需要一种简单、快速、无额外延迟、稳健、高效且高度兼容的解决方案。
这个图示展示了没有插帧的上屏时间轴。我们可以看到每一帧在渲染后可以立即上屏。但是如果使用了插帧,后一帧必须在中间帧生成后,并等待一定的间隔后才能上屏,因为中间帧需要首先上屏。
这额外的响应延迟时间使得带插帧的120Hz体验比不带插帧的60Hz更差,在动作游戏中影响尤其严重。由于这些方法都不适用,我们需要一种在移动设备上提高帧率的解决方案,它应该:简单、快速,没有额外的延迟;稳健;有效和高效(过于复杂的算法会导致速度变慢,无法提高帧率);同时应具备高度兼容性,即不依赖特定硬件,可以在任何设备上使用。
Slide 5 — 00:04:32
📌 要点汇总
- 帧预测算法需有效、高效,过于复杂的算法必然速度慢,无法提高帧率。
- 算法应高度兼容,无特定硬件依赖,可在任何设备上使用。
- 因此在移动设备的软件层开发了帧预测技术。
- 核心思想:相邻两帧非常相似,大部分渲染像素可被复用。
- 预测帧可通过前一帧的渲染结果和当前帧Game线程的信息生成。
最后,有效和高效。当然,过于复杂的算法必然速度慢,无法提高帧率。而且它还应该是高度兼容的,这意味着没有特定的硬件依赖,可以在任何设备上使用。因此,我们为移动设备开发了帧预测技术。
下一部分将介绍《暗区突围》中帧预测算法的实现。我们的核心思想非常简单:如图所示,相邻的两帧非常相似,帧中大部分渲染的像素可以被复用。这意味着可以通过前一帧的渲染结果和当前帧中的Game线程的信息生成预测帧。
Slide 6 — 00:05:22
📌 要点汇总
- 实际游戏中大部分像素来自静态对象,只有少数来自动态对象(如1P的枪与手、3P角色)。
- 将静态对象和动态对象的渲染分开,以更高效地重用已渲染的像素——在所有静态对象渲染完毕后才绘制动态对象。
- 帧预测仅用于静态对象的像素,因为光流等动态对象预测方法在移动设备上既昂贵又容易出错。
- 一些动态对象运动不可预测(依赖其他玩家输入),在硬核FPS中预测错误的后果完全不可接受。
从实际游戏中可以看出,大部分像素来自静态对象,只有少数来自动态对象,如1P的枪与手,以及3P角色。因此,我们将静态对象和动态对象的渲染分开,以更高效地重用已渲染的像素。这意味着在所有静态对象渲染完毕之后才绘制动态对象,而帧预测仅用于来自静态对象的像素。
因为我们发现在移动设备上,对动态对象进行预测的方法(如光流)既昂贵又容易出错。此外,一些动态对象的运动是不可预测的,因为它依赖于其他玩家的输入。例如,在像《暗区突围》这样的硬核FPS游戏中,一帧或一颗子弹可以决定胜负。如果预测错误,我看到射击目标在这个地方,但实际上它在另一个地方,我就会因此输掉这局游戏——这是完全不能接受的。
Slide 7 — 00:06:12
📌 要点汇总
- 复用的关键是找到前一帧到当前帧的像素对应关系——来自同一对象的像素具有相同的渲染结果。
- 重投影是寻找对应关系的好方法:场景对象位置可通过MVP变换转换为裁剪空间位置。
- 对象的局部位置坐标乘以Model、View和Projection矩阵,得到裁剪空间位置。
重用的关键是找到前一帧到当前帧的像素对应关系,比如这里和这里,它们来自同一个对象并具有相同的渲染结果,而重投影是寻找对应关系的好方法。我们知道,场景对象的位置可以通过MVP变换转换为裁剪空间位置。如图所示,对象的局部位置坐标乘以M、V和P矩阵,得到裁剪空间位置。
Slide 8 — 00:07:02
📌 要点汇总
- 联立两帧的MVP方程可建立对应关系。对于静态对象,M矩阵不变,M_{k-1} × M_k^{-1}始终为单位矩阵。
- 绿色框中的矩阵乘积被用作重投影矩阵。
- 从当前帧到前一帧的重投影不可行,因为无法在未渲染时获取裁剪空间位置的Z分量(需从帧缓冲区的SceneDepth获取)。
- 因此使用从前一帧到当前帧的重投影来找到对应关系。
因此,我们可以联立上述两个方程来建立对应关系。对于静态对象来说,M矩阵不会改变,它们的M_{k-1}乘以M_k的逆矩阵始终是单位矩阵。然后,绿色框中的矩阵乘积被用作重投影矩阵。
但是,从当前帧到前一帧的重投影是不可能的,因为我们无法在没有渲染的情况下获取裁剪空间位置的Z分量,这需要从帧缓冲区的SceneDepth(场景深度)中获取。因此,我们使用从前一帧到当前帧的重投影来找到对应关系。
Slide 9 — 00:07:52
📌 要点汇总
- 逐像素重投影后存在黑色裂缝和重叠(类似Z-fighting)。
- 原因:重投影后相邻像素不再紧邻——相邻像素相互远离导致裂缝,重新投影到相同位置导致重叠。
- 填补裂缝中缺失的像素需要Mip-Maps或大范围邻域采样,两者都非常昂贵。
- 因此需要提出一种新方法以降低计算开销并改善渲染质量。
逐像素的重投影仍然存在一些问题。这个图展示了从前一帧到当前帧的逐像素重投影的结果。如图所示,我们可以看到这里有黑色的裂缝,并且渲染结果中存在重叠(类似于Z-fighting)。
这种现象的原因是在重投影后,相邻像素不再紧邻:相邻像素相互远离会导致裂缝,而重新投影到相同位置会导致重叠。为了填补这些裂缝中缺失的像素,需要使用Mip-Maps或大范围的邻域采样,而这两种方法都非常昂贵。因此,我们提出一个新的方法。
Slide 10 — 00:08:41
📌 要点汇总
- 新方案关键思想:在屏幕空间中从SceneDepth纹理重建顶点,构建网格并重投影这些顶点。
- 缓存的SceneColor纹理可看作网格的表面纹理,通过重新绘制重投影网格生成预测帧。
- 该算法在项目团队中称为Mesh Projection Estimation(网格投影估计)。
- 使用前一帧的缓存SceneDepth纹理,划分为N×N像素的Tile。
- 顶点初始状态位于Tile的左上角,通过梯度平方和搜索顶点在Tile中最可能的位置。
新的解决方案:关键思想是在屏幕空间中从SceneDepth纹理重建顶点,构建网格并重新投影这些顶点。缓存的SceneColor纹理可以看作是网格的表面纹理。通过重新绘制重投影的网格,可以生成预测帧。在我们的项目团队中,我们将这个算法称为Mesh Projection Estimation(网格投影估计)。
这是来自前一帧的缓存SceneDepth纹理。我们将SceneDepth纹理分成N乘N像素的Tile。这个图示展示了顶点的初始状态:它们都位于Tile的左上角。然后,我们使用梯度平方和来搜索顶点在Tile中最可能的位置。
Slide 11 — 00:09:31
📌 要点汇总
- 梯度平方和计算:右侧深度减去该像素并平方,加上底部深度减去该像素并平方。
- 为每个Tile分派一个CS线程,遍历Tile中所有像素,找到具有最大平方和的位置。
- 顶点已位于Tile中具有最大深度梯度的位置。
- 在SceneColor中查看网格:顶点与场景中的对象(如汽车、建筑物、楼梯)非常吻合。
然后我们使用梯度平方和来搜索顶点在Tile中最可能的位置。梯度平方和的计算非常简单:右侧深度减去该像素并平方,再加上底部深度减去该像素并平方。根据伪代码所示,为每个Tile分派一个CS线程,遍历Tile中的所有像素,并找到具有最大平方和的位置。
在这个图示中,顶点已经位于Tile中具有最大深度梯度的位置。我们还可以在SceneColor中查看网格:顶点与场景中的对象非常吻合,如汽车、建筑物、楼梯等。
Slide 12 — 00:10:21
📌 要点汇总
- 通过与重投影矩阵相乘来重投影顶点位置,并将重投影位置和顶点UV存储到UAV纹理中。
- 示例中相机向前移动,场景对象朝相机移动。
- 重建的网格称为”屏幕空间聚合网格(SSAM)”,借鉴软件工程中”聚合”概念:来自不同对象的顶点可看作单一实体。
- 重新绘制SSAM的顶点着色器从UAV读取缓存数据,并将屏幕边缘的顶点锚定以防止像素丢失。
然后,通过与重投影矩阵相乘来重投影顶点的位置,并将重投影的位置和顶点UV存储到一个UAV纹理中。图中我们可以看到顶点的重投影位置。在这个例子中,相机向前移动,我们可以看到场景对象朝相机移动。
此外,我们将重建的网格称为”屏幕空间聚合网格(SSAM)”,因为这里使用了软件工程中”聚合”的概念:这些顶点来自不同的对象,但在这里可以看作是一个单一的实体。
这里展示了重新绘制SSAM过程中的顶点着色器:它简单地从UAV中读取缓存数据,并将屏幕边缘的顶点锚定,以防止像素丢失。
Slide 13 — 00:11:11
📌 要点汇总
- 像素着色器中先采样深度,将前一帧深度值重投影到当前帧。
- 从缓存的SceneColor中采样颜色,输出颜色和深度。
- 输入UV来自光栅化的插值结果。
- 顶点和三角形作为锚点驱动像素运动,硬件光栅化和深度测试以极低成本避免裂缝和重叠。
- 生成的预测帧与前一帧对比,验证算法效果。
从UAV中读取缓存数据,并将屏幕边缘的顶点锚定以防止像素丢失。在像素着色器中,我们首先采样深度,然后将前一帧的深度值重新投影到当前帧,接着从缓存的SceneColor中采样颜色,并输出颜色和深度。
输入的UV是光栅化的插值结果。在这个算法中,顶点和三角形就像是驱动像素运动的锚点,硬件光栅化和深度测试可以以非常低的成本避免裂缝和重叠。在这里我们可以看到生成的预测帧,让我们与前一帧进行比较。
Slide 14 — 00:12:01
📌 要点汇总
- 朴素重投影整个过程包括一个CS Pass和一个Mesh Pass,已能准确预测大部分像素。
- 但存在失真问题(绿色框1和2)。
- 透视相机中,远处物体像素在屏幕上移动比近处物体慢,这种运动差异导致失真。
- 框1:剪切失真使背景中的窗户弯曲;框2:颜色从前景渗入背景。
我们可以看到预测与期望非常吻合。以上展示了朴素重投影的整个过程,包括一个CS Pass和一个Mesh Pass。这种朴素的重投影已经可以准确预测大部分像素,但它也存在失真问题,如绿色框1和2所示。
让我们将它们放大。在透视相机中,当相机移动时,远处物体的像素在屏幕上的移动速度比近处物体慢,这种运动差异会导致失真。我们可以看到在框1中,剪切失真使得背景中的窗户弯曲;在框2中,颜色从前景渗入到背景中。
Slide 15 — 00:12:51
📌 要点汇总
- 拉伸失真(颜色渗入)的原因:顶点之间的插值UV相互远离,UV边界发生位移。
- 可通过前景顶点周围邻近像素的相对位移来检测:相对位移小→同一语义层(都在前景或背景);相对位移大→不同语义层,需要校正。
首先来看拉伸失真的校正:如幻灯片所示,颜色渗入是由于顶点之间的插值UV,它们相互远离——UV边界从这里移动到这里。这可以通过前景顶点周围邻近像素的相对位移来轻松检测:如果相对位移非常小,意味着邻近像素都在前景或背景中,换句话说,在同一个语义层中;如果相对位移很大,意味着邻近像素在不同的语义层中,这种情况下需要进行校正。
Slide 16 — 00:13:41
📌 要点汇总
- 首先找到顶点周围离相机最近的深度像素作为前景像素,最远的作为背景像素。
- 分别对前景和背景像素进行重投影。
- 若前景和背景运动方向相同,且位移大于阈值,则应用一个像素大小的UV偏移:使用前景像素的裁剪空间位置和背景像素的UV。
首先,我们可以找到顶点周围离相机最近的深度像素作为前景像素,最远的像素作为背景像素。然后分别对前景和背景像素进行重新投影。如果前景和背景的运动方向相同,并且位移大于阈值,将添加只有一个像素大小的UV偏移,这意味着顶点使用前景像素的裁剪空间位置和背景像素的UV。
Slide 17 — 00:14:31
📌 要点汇总
- 剪切失真校正在顶点上不易实现,但回到从当前帧到前一帧的重投影:在SSAM重绘的像素着色器中,采样缓存深度并进行深度重投影后,已可获得当前帧裁剪空间位置的Z分量。
- 将裁剪空间位置重新投影到前一帧并比较深度:若重投影前后深度近似相等且UV位移大于阈值,则使用重新投影的UV替代光栅化的UV来校正剪切失真。
接下来是剪切失真的校正:在顶点上进行剪切失真的校正并不容易,但让我们回到从当前帧到前一帧的重新投影。我们可以看到在SSAM重新绘制的像素着色器中,在缓存深度采样和深度重投影之后,当前帧的裁剪空间位置的Z分量已经得到。
因此,我们可以将裁剪空间位置重新投影到前一帧并比较深度:如果重投影前后的深度近似相等,并且UV位移大于阈值,我们需要通过使用重新投影的UV而不是光栅化的UV来校正剪切失真。
Slide 18 — 00:15:20
📌 要点汇总
- 通过校正,剪切和拉伸失真都得到显著改善。
- 精度分析场景:相机向前移动,DeltaTime为16.67毫秒(对应60FPS),低于目标90/120/144 FPS,相邻帧间差异可能更大。
- 人眼已无法区分生成的帧与渲染参考帧,差异极小,几乎不可察觉。
通过这些校正,剪切和拉伸失真都得到了显著改善。接下来让我们关注帧预测算法的精度分析。在这种情况下,相机向前移动,DeltaTime为16.67毫秒,相当于60FPS。它低于我们的目标90、120和144FPS,并且相邻帧之间的差异可能会更大。
我们可以看到,人类肉眼已经无法区分生成的帧和渲染参考帧。正如这里所示,差异非常小,几乎不可察觉。
Slide 19 — 00:16:10
📌 要点汇总
- 直方图显示准确性非常高:仅1.29%的像素颜色差异大于2%。
- 相机向右旋转时,精度仍然很好,但右侧因像素缺失出现小区域模糊。
- 高帧率模式下这种模糊几乎不可察觉。
- 可选校正:预测相机运动,扩大视锥体渲染额外区域,使用渲染目标时进行裁剪——渲染帧使用蓝色框区域,预测帧使用绿色框区域。
直方图也显示准确性非常高:只有1.29%的像素颜色差异大于2%。在下一个示例中,相机向右旋转。我们可以看到准确性仍然很好,但右侧有一个小区域模糊:在高帧率模式下,这种模糊几乎不可察觉。
但是,如果您认为有必要进行校正,我们可以预测相机的运动,在相机移动或旋转期间使视景体变大,渲染额外的区域,并在使用渲染目标时进行裁剪。如图所示,我们可以在渲染帧中使用蓝色框中的部分,并在预测帧中使用绿色框中的部分。
Slide 20 — 00:17:00
📌 要点汇总
- 渲染管线概述:第一帧是渲染帧,静态和动态对象分别绘制,静态对象的SceneColor和Depth被缓存。
- 下一帧相机向前移动,使用缓存的SceneDepth重建SSAM,生成预测帧中静态对象的渲染结果。
- 接下来绘制预测帧中的动态对象。
这就是关于帧预测算法的全部内容。在下一部分中,将介绍带有帧预测的相应渲染管线。
这个图示展示了渲染管线的概述:第一帧是渲染帧,静态和动态对象分别绘制,并将静态对象的SceneColor和Depth缓存起来。然后相机在下一帧向前移动,使用缓存的SceneDepth来重建SSAM,并生成预测帧中静态对象的渲染结果。接下来,绘制预测帧中的动态对象。
Slide 21 — 00:17:50
📌 要点汇总
- 管线一:渲染帧和预测帧处于不同逻辑帧中,预测帧使用帧预测代替静态对象绘制。确保高帧率下完美的游戏操控感(逻辑帧也在高帧率下运行),并将绘制静态对象的工作量减少一半。
- 管线二:渲染帧和预测帧可处于同一逻辑帧中,此时需插值VP矩阵(用于帧预测)和Uniform参数(用于动态对象),而非从完整逻辑帧计算。提供高帧率视觉体验且不影响操控感,逻辑帧率减半,效率极高。
这张幻灯片展示了第一个管线的结构:渲染帧和预测帧处于不同的逻辑帧中,在预测帧中,我们使用帧预测而不是绘制来处理静态对象。这个管线可以确保在高帧率下完美的游戏控制感觉,并将绘制静态对象的工作量减少了一半。
渲染帧和预测帧也可以处于同一个逻辑帧中。在这个管线中,我们需要对帧预测进行插值计算VP矩阵,以及对动态对象的Uniform参数进行插值,而不是从完整的逻辑帧进行计算。这个管线可以提供高帧率的视觉体验,而不会对游戏控制感觉产生负面影响。由于逻辑帧率也减半,这个管线非常高效。
Slide 22 — 00:18:40
📌 要点汇总
- 不平衡的帧工作负载可能导致CPU和GPU互相等待(如Qualcomm DCVS策略):轻负载CPU帧对应重负载GPU帧,CPU等GPU,反之亦然。
- 解决方案:将Base Pass渲染分为两个渲染目标,在第一帧上屏前执行第一部分,但会增加带宽成本。
- 仍在期待针对不均匀工作负载的特定GPU/API优化。
还有一件值得一提的事情,不平衡的帧工作负载可能会在某些设备驱动策略(例如高通DCVS)中效率低下,因为它可能导致CPU和GPU互相等待。如图所示,轻负载的CPU帧与重负载的GPU帧相对应,CPU等待GPU,反之亦然。
我们的解决方案也很简单,我们将Base Pass渲染分为两个渲染目标,并在第一帧上屏之前执行第一部分。但这会增加带宽成本。我们仍在期待针对不均匀工作负载的特定GPU/API优化。
Slide 23 — 00:19:30
📌 要点汇总
- 帧预测及相应管线已成功应用于发布的《Arena Breakout》游戏,可通过设置菜单选择90/120/144 FPS激活。
- 帧预测也可在GDC展位S1127体验。
让我们在第一帧上屏之前执行第一部分,但这会增加带宽成本。我们仍在期待针对不均匀工作负载的特定GPU/API优化。这就是关于管线的所有信息。
下一部分将讨论帧预测的性能分析和进一步应用。目前,带有相应渲染管线的帧预测已经成功应用于发布的游戏《Arena Breakout》中,并可以通过在设置菜单中选择90、120或144 FPS来激活,也可以在我们的展位S1127上体验。
Slide 24 — 00:20:20
📌 要点汇总
- iPhone 14 Pro性能:平均帧率从97.7提升至118.3 FPS,表面温度下降约4°C,电池功耗减少19%。
- 所有图表坐标轴均从零开始,无数据作弊。
- 帧率显著提高,同时温度和电池功耗都大幅下降。
这个截图是我手机上的。我的手机屏幕不支持144Hz,但实际上,它可以在其他手机上使用。这些图表展示了在iPhone 14 Pro上的性能比较。通过帧预测,平均帧率从97.7提高到了118.3 FPS,表面温度下降了约4摄氏度,电池功耗减少了19%。请注意,这些不是作弊图,因为每个轴都从零开始。正如我们所看到的,帧率显著提高,同时温度和电池功耗都大幅下降。
Slide 25 — 00:21:10
📌 要点汇总
- 另一款搭载高通骁龙7+ Gen 2芯片的安卓智能手机(非旗舰芯片),平均帧率可达140.2 FPS。
- 光线追踪可显著提升游戏图形质量,帧预测同样可以提升移动光线追踪的性能。
- 各种类型的光线信息可以存储在屏幕空间中,然后通过帧预测进行高效重用。
温度和电池功耗都大幅下降。这里展示了另一款搭载高通骁龙7+ Gen 2芯片的安卓智能手机的性能,这并非一款旗舰芯片。我们可以看到平均帧率可以达到令人印象深刻的140.2 FPS。
正如我们都知道的,光线追踪可以显著提升游戏图形的质量。同样,帧预测可以提升移动光线追踪的性能。例如,各种类型的光线信息可以存储在屏幕空间中,然后通过帧预测进行高效重用。
Slide 26 — 00:22:00
📌 要点汇总
- 无帧预测时,电池过热保护迅速触发,操作系统将屏幕帧率限制在约50 FPS。
- 启用帧预测后,帧率可稳定运行在90 FPS。
- 屏幕空间聚合网格(SSAM)也可用于加速屏幕空间全局光照(SSGI)。
- SSGI中常在深度图上进行光线交点计算,mip-map通常用于加速。
从这个比较中,我们可以看到,如果没有帧预测,由于电池过热,保护机制会迅速触发,操作系统会将屏幕帧率限制在约50 FPS左右。然而,启用帧预测后,帧率可以稳定运行在90 FPS。
屏幕空间聚合网格(SSAM)也可以用于加速屏幕空间全局光照。深度图上的光线交点通常用于SSGI,而mip-map通常用于加速。
Slide 27 — 00:22:49
📌 要点汇总
- 深度mip-map存在”峡谷效应”(Canyon-effect):mip-map使用最近深度池化来避免丢失,较高级别的mip在较低级别的mip中使用最近深度。
- 光线在较高级别mipmap中击中每个像素,但在较低级别mipmap中却错过,就像光线穿越峡谷一样反复在不同mip层级间跳转。
- 这导致在较高级别mip上进行大量额外采样,增加性能开销。
深度mip-map存在一个问题,我们称之为”峡谷效应”(Canyon-effect):就像幻灯片上所示,箭头表示光线方向,光线在较高级别的mipmap中相交。但是,mip-map使用最近的深度池化来避免丢失,这意味着较高级别的mip在较低级别的mip中使用最近的深度。
就像光线穿越峡谷一样,光线在较高级别的mipmap中击中每个像素,但在较低级别的mipmap中却错过了。在这种情况下,mip-map会导致在较高级别的mip上进行大量额外的采样,从而增加了性能开销。
Slide 28 — 00:23:39
📌 要点汇总
- 为避免过采样,使用SSAM加速光线交点计算:光线不再与像素相交,而是与SSAM中的三角形相交。
- 这样可以在不进行过采样的情况下加速光线交点的计算。
为了避免这种过采样,可以使用屏幕空间聚合网格(SSAM)来加速光线交点的计算:光线不再与像素相交,而是与SSAM中的三角形相交。在这种情况下,光线交点的计算可以在不进行过采样的情况下加速。
Slide 29 — 00:24:29
📌 要点汇总
- The presentation will cover ray tracing in “Arena Breaker Mobile” by Wang Junhong, lead programmer of the rendering team at Mo Fan Studio.
- Wang has over 12 years of experience in PC and mobile game development at Tencent.
- The talk will begin with an overview of “Arena Breaker Mobile” and mobile ray tracing.
- Topics include ray tracing in “Arena Breakout,” such as ray tracing management, reflections, soft shadows, ambient occlusion, and optimization.
大家好。感谢您参加本次会议。我将讨论《Arena Breaker Mobile》中的光线追踪。我叫王俊红。我是莫凡工作室渲染组组长程序员。我在腾讯从事 PC 和移动游戏开发工作超过 12 年。
我们先从背景开始,介绍了《Arena Breaker Mobile》和移动回溯。然后我会介绍《Arena Breakout》中的回溯,包括回溯主题管理、反射、软阴影、环境光遮挡和优化。
Slide 30 — 00:25:19
📌 要点汇总
- Arena Breakout 是一款基于虚幻引擎 4.26 的开放世界战术 FPS,支持 Android 和 iOS 平台,2022 年 7 月发布。
- 最新关卡 Mine 的规模约为 4 公里 x 4 公里,包含超过 100,000 个网格实例和 3,000 个流级别,对场景管理提出了较高要求。
- 游戏在渲染方面实现了多项关键技术,以支持大规模开放世界的高效表现。
最后,有一些结论。Arena Breakout 是一款可在 Android 和 iOS 设备上运行的下一代沉浸式战术 FPS。该游戏已于 2022 年 7 月发布,我的同事孙一民去年在 GDC 上介绍过该游戏的玩法。它基于虚幻引擎 4.26,也是一款开放世界游戏。
例如,名为 Mine 的最新关卡大约为 4 公里 x 4 公里。有超过 100,000 个网格实例和超过 3,000 个流级别,因此管理场景具有挑战性。
以下是我们游戏中的一些重要渲染功能。
Slide 31 — 00:26:09
📌 要点汇总
- 渲染管线采用前向渲染和基于物理的渲染,包括材质、光照、相机和着色,视频展示了自动曝光效果
- 动态天气系统由贾明晨在 GDC 2022 展示,视频中阳光、天光和云随时间变化
- 全局照明基于预先计算的辐射传输,视频展示了间接光效果
首先,渲染管线是前向渲染,第二是基于物理的渲染,包括基于物理的材质、光照、相机和着色。例如,该视频展示了我们游戏中的自动曝光。
第三个重要特征是动态天气系统。我的同事贾明晨在 GDC 2022 上展示了它。在这段视频中,阳光、天光和云都随着时间的推移而变化。
最后,全局照明基于我们游戏中预先计算的辐射传输。那么,看看这个视频。间接光。
Slide 32 — 00:26:59
📌 要点汇总
- Mobile devices now support hardware-accelerated re-tracing, also known as inline re-tracing, for shader stages like vertex, pixel, and compute shaders.
- Debugging re-tracing on mobile remains challenging due to limited support for mobile Vulkan recording in most frame capture tools and analyzers.
- Preparations before integrating ray tracing included enabling Vulkan API on Android and updating the shader cross-compiler to the latest shader compiler.
当天气系统发生变化时,情况会有所不同。然后我会介绍移动回溯。现在,最新的智能手机已准备好进行硬件加速重新查询,也称为内联重新跟踪。重新查询可用于任何着色器阶段,例如顶点着色器、像素着色器或计算着色器。
然而,在移动设备上调试回溯仍然具有挑战性,因为大多数帧捕获工具和分析器不支持移动 Vulkan 记录。以下是我们集成光线追踪之前的一些准备工作。首先,我们为 Android 启用 Vulkan API。然后将着色器交叉编译器更新为最新的着色器导体。
Slide 33 — 00:27:49
📌 要点汇总
- 扩展了 UE4 的 Vulkan 和 Metal RHI 以支持新的着色器指令
- Unreal Breakout Mobile 的回溯功能已在 Android 平台(中国)发布,iOS 版本正在开发中
- 回溯功能包括反射、软阴影和弯曲遮挡技术
- 后续幻灯片将展示在智能手机上拍摄的屏幕截图,用于演示回溯反射效果
为了支持所需的着色器指令,我们最后扩展了 UE4 Vulkan 和 Metal RHI。现在,我将介绍 Unreal Breakout Mobile 中的回溯功能。在中国,带回溯功能的 Android 版本已于 2023 年发布,iOS 版本的回溯功能正在开发中。
如本视频所示,我们介绍了集成回溯反射。这是回溯软阴影和弯曲遮挡的反射。我将在下面的幻灯片中向您展示在智能手机上拍摄的屏幕截图。
Slide 34 — 00:28:39
📌 要点汇总
- 禁用查询时,大理石地板反射率较低,启用后可实现高光泽反射效果
- 启用环境光遮挡查询可提升轮胎、箱子和地板的间接光照真实感
- 禁用软阴影查询时,使用硬件 PCF 级联阴影贴图,但分辨率不足影响阴影清晰度
这是在智能手机上拍摄的屏幕截图。如果禁用查询,大理石地板的反射率较低。但如果启用查询,我们将在这里实现令人印象深刻的光泽反射。
这是在户外拍摄的另一张截图。轮胎、箱子和地板的环境遮挡程度较低。当启用环境光遮挡查询时,间接光更加真实。
当查询软阴影被禁用时,我们使用带有硬件 PCF 的级联阴影贴图。但阴影贴图分辨率不足以为主渲染清晰的阴影。
Slide 35 — 00:29:28
📌 要点汇总
- 启用查询软阴影可生成高质量软阴影,提升沉浸感和真实感。
- 管理撤退场景面临三大挑战,其中第一个是底层加速结构(BLAS)的内存使用问题。
- 构建 BLAS 的过程成本高昂,是第二个主要挑战,影响性能和效率。
金属栅栏和其他薄物体。启用查询软阴影后,我们将得到近乎完美的软阴影。所有这些都为玩家创造了身临其境的真实体验。
正如我之前提到的,管理撤退场景对我们来说是一个挑战。我将介绍我们所面临的挑战和优化。这是三个主要挑战。第一个挑战是底层加速结构的内存使用。底层加速结构也称为 BLAS,它代表查询中的一个对象。
第二个挑战是构建 BLAS 的过程成本高昂。
Slide 36 — 00:30:18
📌 要点汇总
- 第三个挑战是基于移动GPU时,顶级加速结构(TLA)实例过多导致的昂贵跟踪问题。
- TLA代表整个场景,用于光线追踪,但实例数量过多会影响性能。
- 使用NVIDIA Nsight Graphics在PC上捕获的截图展示了游戏中的TLA实例部分。
- 关卡由关卡流系统管理,加载包时会加载网格的LOD(细节层次)。
- 更高的LOD由网格流系统加载,部分网格带有掩模以控制渲染。
基于移动GPU,第三个挑战是实例过多的顶级加速结构的昂贵跟踪。顶层结构又称为TLA,代表整个场景。这是 NVIDIA Nsight Graphics 在 PC 上捕获的屏幕截图。它展示了我们游戏中TLA实例的一部分。
我先介绍一下世界概况。关卡由关卡流系统管理。加载包时会加载网格的 LOD。更高的LOD由网格流系统加载,并且一些网格带有掩模。
什么立场?
Slide 37 — 00:31:08
📌 要点汇总
- 偏移或透明材料不会生成 BLS,因此不能在加载网格 LOD 时创建 BLS。
- 加载时创建 BLS 会导致超过 4700 个 BLS,消耗高达 4400MB 的视频内存,最终导致崩溃。
- 使用简单算法管理 BOS,根据摄像机与物体的距离动态创建或销毁 BOS。
- BOS 创建半径(R1)和破坏半径(R2)用于控制 BOS 数量,有效避免内存溢出问题。
偏移或透明材料不会产生 BLS。那么,我们可以在加载网格 LOD 时创建 BLS 吗?答案是否定的,因为加载时它将创建超过四千七百个 BLS,并且视频内存高达四千四百兆字节。然后因为内存不足而崩溃。
我们用一个简单的算法来管理 BOS。图中,P 为摄像机位置,R1 为 BOS 创建半径,R2 为 BOS 破坏半径,d 为摄像机到物体(弹跳球体)的距离。如果 d 小于 R1,BOS 将被创建;如果 d 大于 R2,BOS 将被销毁。这种机制有效地控制了 BOS 的数量,从而避免了内存溢出的问题。
Slide 38 — 00:31:58
📌 要点汇总
- 当 d 大于 r1 且小于 r2 时,对象被标记为待创建或待定储备,以减少频繁创建和销毁操作
- 对于待创建或保留量较低的 BOS,销毁操作会被延迟,以优化性能和资源使用
- 所有参数均可调整,以适应不同场景和需求
- 优化后 BLS 数量从 4700 减少到约 700,显存使用从 4.4G 降低到约 1.1G
如果 d 大于 r1 且小于 r2,它将被标记为待创建。它将被标记为待定储备。然后我将立即处理待处理的创建请求。但对于待创建或保留量较低的 BOS,销毁将会延迟。这可以避免当对象靠近边缘时频繁创建和销毁。
这里,所有参数都是可伸缩的。优化后,BLS 数量从 4700 个减少到 700 个左右,显存从 4.4G 减少到 1.1G 左右。对于层。
Slide 39 — 00:32:48
📌 要点汇总
- TOS 每帧更新,并启用快速跟踪位以提高性能
- 使用距离计数和投影角度计数优化实例计数
- TOS 实例计数约为 600,vivo X90 智能手机性能数据
- TOS 构建成本小于 0.5 毫秒,实际约为 1 毫秒
- 接下来将介绍回溯反射,重点在渲染管道,具有较高挑战性
TOS,我们每帧更新它,并在构建时启用更倾向于快速跟踪的位。我们还使用距离计数和投影角度计数来优化实例计数。最后,在此屏幕截图中,TOS 实例计数约为 600。这是 vivo X90 智能手机的性能数据。构建 TOS 的成本小于 0.5 毫秒,构建 TOS 的成本约为 1 毫秒。
接下来,我将介绍回溯反射,特别关注渲染管道。这是一个非常具有挑战性的事情。
Slide 40 — 00:33:38
📌 要点汇总
- The first challenge involves shading reflected pixels, as a low-backtrack pipeline is used for object queries in the game. Low-bandwidth textures are used, but the scene contains thousands of different materials, making a super shader impractical.
- The second challenge is the current forward rendering pipeline, which needs to be replaced with a hybrid rendering pipeline to support reflections.
- The third challenge is performance, particularly energy consumption and frame rate, as the reflection pipeline must be optimized for mobile devices like Arena Breaker. A first pass has been completed.
查询反思。第一个挑战是如何对反射像素进行着色。这个低回溯管道是工作查询中的对象。我在游戏中使用低带宽纹理,但场景中有数千种不同的材质。不可能使用超级着色器来对其进行着色。
第二个挑战是当前的渲染管道是前向渲染。我们应该创建一个混合渲染管道用于反射。
第三个挑战是性能。例如,能源成本和帧速率。这是 Arena Breaker 移动设备所需的反射管道。第一遍是基础遍。它得到了。
Slide 41 — 00:34:28
📌 要点汇总
- 第二遍通过发射光线获取屏幕空间中每个像素的网格和三角形信息
- 第三遍对每个像素的反射颜色进行着色,称为可行性解析遍
- 使用联合双边滤波器处理光泽反射纹理,提升视觉质量
- 光泽反射纹理最终混合到场景颜色中以增强渲染效果
- 着色器在内容烹饪期间生成,确保与光照模型和材质属性正确交互
- 预处理步骤优化着色器性能,提高渲染效率和视觉质量
必要的像素信息。第二遍是查询遍,我们发射光线来获取屏幕空间中每个像素的网格和三角形信息。第三遍称为可行性解析遍,此通道将对每个像素的反射颜色进行着色。接下来的两遍使用联合双边滤波器来获得光泽反射纹理。最后,光泽反射纹理将混合到场景颜色中。稍后我会介绍关键步骤。
以下是一些准备工作。用于对反射颜色进行着色的着色器是在内容烹饪期间生成的。当时,我们通过预处理步骤确保着色器能够正确地与光照模型和材质属性进行交互,从而提高渲染效率和视觉质量。
Slide 42 — 00:35:18
📌 要点汇总
- 网格文档收集后,每帧重新分配网格实例 ID 和命中组 ID
- 基础通道中渲染额外目标,存储法线、粗糙度和标志,称为同步缓冲区
- 中间图像即同步缓冲区,用于后续处理
- 延迟读取渲染管线可更高效利用同步缓冲区
- 查询通道用于避免回溯管线状态对象,提升查询效率
我们将收集所需的网格文档,并在每一帧重新分配网格实例 ID 和命中组 ID。然后,我将介绍管道中的关键通道。在基础通道中,我们将渲染一个额外的渲染目标,它存储法线、粗糙度和标志。我们将此称为渲染目标同步缓冲区。中间图像是同步缓冲区。
如果你的 render pipeline 是延迟读取,它会工作得更加完美。然后,应用查询通道,因为查询中没有回溯管道状态对象,所以我们使用查询通道和可行性。
Slide 43 — 00:36:07
📌 要点汇总
- 通行证问题通过重建世界位置和反射重定向解决,光线从屏幕空间发出并记录击中点的实例 ID、三角形 ID 和重心坐标。
- 数据包中存储三角形 ID 和重心坐标用于后续处理,右图展示了存储的网格 ID。
- 可行性解析通道通过调度绘制调用实现,绘制 ID 由统一缓冲区提交,确保 GPU 正确处理像素。
- 全屏绘制调用中,若绘制 ID 不匹配,像素将被丢弃,使用值获取方式实现此过程。
解决通行证问题。在查询过程中,我们重建世界位置并进行反射重定向,然后从屏幕空间发出光线。如果光线击中任何实例,我们将存储击中点的实例 ID、三角形 ID 和重心坐标。左图展示了数据包中存储的三角形 ID 和重心坐标,右图则展示了存储的网格 ID。
对于可行性解析通道,我们需要调度可行性解析的绘制调用,并且绘制 ID 由统一缓冲区提交。每次绘制调用都是全屏调用。对于 GPU 来说,如果绘制 ID 不匹配,该像素将被丢弃。我们使用值获取的方式来实现这一过程。
Slide 44 — 00:36:57
📌 要点汇总
- 使用重心插值获取 PBR 参数,提高像素着色器精度
- 发射阴影射线计算阴影值,增强光照效果
- 计算反射颜色并写入反射渲染目标,提升画面真实感
- 算法硬件兼容性好,易于集成到现有系统中
- 过多绘制调用导致性能透支,影响渲染效率
- 使用 GPU 遮挡查询删除不可见网格,减少冗余绘制
- 深度测试结合深度缓冲区存储网格 ID,优化过度绘制问题
获取并进行重心插值,以计算像素着色器中的像素 PBR 参数。然后,发射阴影射线以获得阴影值。最后,计算反射颜色并写入反射渲染目标。该算法的优点是硬件兼容性好,易于集成。但缺点是,绘制调用过多,导致透支。
因此,我们使用 GPU 遮挡查询来删除不可见网格的绘制命令,并使用深度测试来删除过度绘制。这就是深度测试。这是深度缓冲区,它存储网格绘制 ID。
Slide 45 — 00:37:47
📌 要点汇总
- 可行性解决后,绘制调用从 600 多个减少到约 110,消除了过度绘制问题
- 使用“血路”联合双侧过滤器实现图像可行性解决
- 输入包括薄 G 缓冲区反射、反射纹理和深度纹理,用于生成光泽反射纹理
- 颜色偏移用于调整颜色面,粗糙度控制红色纹理的光泽反射效果
- 蓝色通道使用更大的滤镜颜色偏移,以增强最终光泽反射纹理的质量
之后,可行性解决的绘制调用从 600 多个减少到 110 左右。根本不存在过度绘制。这就是该图像可行性解决的结果。这里的血路是联合双侧过滤器。
输入是薄 G 缓冲区反射、反射纹理和深度纹理。我们使用颜色偏移来调整颜色面。通过粗糙度,红色纹理是光泽反射纹理。
第二个蓝色通道与第一个蓝色通道几乎相同,但它使用更大的滤镜颜色偏移。最后,我们可以获得这个光泽反射纹理。
Slide 46 — 00:38:37
📌 要点汇总
- 混合结果保留了边缘,光滑地板反射锐利,粗糙墙壁反射模糊,完全粗糙材料不发射射线
- 实现了良好的硬件兼容性和高性能,密度线为零时可达到每秒约60帧
- 透明或掩模材料在处理上存在难度,需特别注意
- 接下来将介绍回溯软件
这是混合结果。我们可以看到这里保留了边缘,并且对于光滑的地板来说,反射很锐利。对于粗糙的墙壁来说,它是模糊的。对于完全粗糙的材料,此处不发射任何射线。所以最终我们获得了良好的硬件兼容性和高性能。
对于密度线为零的情况,我们几乎每秒可以获得 60 帧。这里也有一些需要注意的地方,例如,透明或掩模的材料很难加工。好的。
接下来我就来介绍一下回溯软件。
Slide 47 — 00:39:27
📌 要点汇总
- 软阴影和 AO 需要大量光线计算,导致边缘出现噪音
- 使用四个预通道获取几何法线和深度信息以优化渲染
- 查询通道发射射线,输出嘈杂的阴影和 AO 结果
- 特殊的延迟路径用于处理复杂的光照和阴影信息
- 基本路径最终对延迟路径、阴影和 AO 进行采样以生成最终图像
影子和 AO(环境光遮挡)在一起。软阴影和 AO 都需要大量的光线计算。这是使用一束光线阴影和一束光线 AO 的结果。这里充满了噪音,尤其是在边缘。这是软阴影和环境光遮挡的渲染管道。
我们使用四个预通道,以获得几何法线和深度信息。查询通道会发射射线,这里会输出嘈杂的阴影和 AO。以下路径是特殊的延迟(deloist)路径。最后,基本路径将对延迟路径、延迟阴影和 AO 进行采样。
Slide 48 — 00:40:17
📌 要点汇总
- 阴影和 AO 使用独立光线通道,阴影光线未在背面发射
- 渲染目标中 R 通道为阴影,G 通道为 AO,均存在噪声
- 采用低分辨率以提升性能
- 左图是无噪声图像,右图是时间噪声处理后的图像
- 应用两次滤波器处理噪声后获得最终结果
对于查询通道,我们为阴影发射一束光线,为 AO 发射一束光线。背面没有发出阴影光线。对于渲染目标,通道 R 是阴影,通道 G 是 AO。两者都充满了噪音。我们使用较低的分辨率来提高性能。
左边是没有噪声的图像,右边是经过时间噪声后的图像。在这里,大部分噪音都被消除了。然后,这里也应用两个滤波器来处理噪声。应用两次之后,我们得到了正确的结果。
Slide 49 — 00:41:07
📌 要点汇总
- Shadow 算法在边缘柔和度和环境光遮挡质量方面表现优异,适用于游戏场景
- 密度从 9 到 0 时,帧率可稳定超过 70.70 帧/秒,性能表现良好
- 带有遮罩的材质不适用于 Shadow 算法,需采用其他阴影技术
- 级联阴影贴图在透明表面存在阴影和 AO 计算不准确的问题,需注意使用场景
好了,这是 Shadow 和 L 的结果,左边的是 Shadow;它的边缘非常柔和,环境光遮挡质量也非常高。这是游戏中的结果。
对于从 9 到 0 的密度,我们可以达到每秒超过 70.70 帧。这里也有一些缺点。例如,带有遮罩的材质应使用其他阴影算法。
这里我们使用级联阴影贴图。对于透明表面,阴影和 AO 不正确。
Slide 50 — 00:41:57
📌 要点汇总
- 表面渲染中玻璃阴影不正确,可能影响视觉效果
- 过多的渲染路径和纹理采样会显著增加功耗
- 使用帧预测等优化方法可改善性能和功耗问题
- 流畅运行达到每秒60帧,帧速率表现良好
- 平均功耗约为3000毫瓦,需关注能效优化
表面在这里,玻璃阴影不正确。事实上,过多的渲染路径和纹理采样会导致较高的功耗。在这里,我们使用了一些其他的优化,例如帧预测。我的同事悦琪介绍过。
现在,我将提出一些结论。这是查询的详细性能数据。它可以流畅地以每秒60帧的速度运行。这是帧速率。平均功耗约为3000毫瓦。
Slide 51 — 00:42:47
📌 要点汇总
- (Transitional content, no key points)
这是在 MTK Dimensity 9200 上拍摄的。最后是致谢。项目成员包括钟建斌、凯耿高、岳琪、施文翠。上述工作的完成,离不开整个团队的共同努力。
也感谢我们的合作伙伴联发科和 Vivo。这里有一些参考。好的,谢谢您今天来到这里。
Slide 52 — 00:43:36
📌 要点汇总
- (Transitional content, no key points)
是否有疑问?好的,请。所以,感谢你们接受我们的演讲。当我们重新投影时,我确实对第一部分有疑问。我们如何处理被遮挡的区域?因此,举例来说,如果您正在向后移动,则会出现更多区域,或者如果您正在快速转身,您将如何解决此类问题?
我可以使用我的幻灯片吗?我正在使用该软件。我使用我的苍蝇。哦,在这里。请等一下。好的。在这里,我相信。
Slide 53 — 00:44:26
📌 要点汇总
- 可以通过预测相机运动并在游戏线程中渲染额外区域来避免屏幕边缘丢失像素。
- 增大视锥体可确保渲染所需区域,但需根据实际运动方向调整。
- 若仅向右转,只需渲染右侧区域,而非所有方向。
- API 剪刀功能可有效移除不需要的渲染区域,提高性能。
我只是说,如果您认为屏幕边缘丢失的像素是必要的,您可以在游戏逻辑中预测游戏线程中的相机运动并进行渲染,并使视锥体更大,从而渲染额外的区域。因此,对于预测帧的较新帧,您仍然需要渲染至少需要的东西。
是的,如果您向后工作,所有方向都是必要的。但如果您只右转,则只需要右侧的区域。而且我们不能在一个方向上将视锥体混合得更大。
但 API 剪刀和 GL 剪刀一样,可以剪掉没用的东西。
Slide 54 — 00:45:16
📌 要点汇总
- The speaker is being asked to compare ray tracing performance and power consumption with screen space techniques like SSAO and traditional shadow maps.
- The question specifically refers to FPS and power consumption metrics shown earlier in the presentation.
- The response indicates that the comparison is being revisited, focusing on low-detail scenarios.
谢谢。还有其他问题吗?嘿,谢谢你的谈话。非常有趣,尤其是在光线追踪方面。我有一个关于光线追踪部分的问题。最后显示 FPS 数和功耗数。您能回顾一下比较吗?
光线追踪技术与屏幕空间技术(如 SSAO 或传统阴影贴图)相比,性能或功耗如何?是的。这种低细节。这是低细节。
Slide 55 — 00:46:06
📌 要点汇总
- 使用了缺乏植被的火星材质,无法使用回溯方法获取更多材质或纹理
- 采用 CSM(Cascaded Shadow Maps)处理阴影,未使用 SSAO 或其他 AO 技术
- 所有环境光遮挡均通过光线追踪实现,而非传统方法
- 光线追踪与传统方法(如 SSAO)在性能和效果上存在差异,需进一步比较分析
数据在这里,但是,这个大概增加了 1000 毫瓦,800 毫瓦,就这个应该这么说。是的,我可以提供一些额外的信息。实际上,我们使用的是军红所说的缺乏植被的火星材质,这种材质不能使用回溯,因为重新查询无法获取太多材质或纹理。因此,对于这个对象,我们使用的是 CSM(Cascaded Shadow Maps),并且现在没有 SSAO 或其他 AO(Ambient Occlusion)。所有环境光遮挡均来自光线追踪。
正确的。我想我的问题是,你们比较过光线追踪和传统方法吗?
Slide 56 — 00:46:56
📌 要点汇总
- 基于跟踪的技术在非重写和性能方面表现良好
- 普通手机的使用速度足以支持相关技术
- 回溯技术提供更好的图形质量,但会显著增加电池消耗
- 电池消耗增加约 1,000 毫瓦每秒,无论是否使用回溯技术
- 电池消耗是需要重视的关键问题,影响实际应用
基于跟踪的技术具有非重写技术和性能。基本问题是:普通手机的使用速度够吗?是的,当然够。回溯技术具有更好的图形质量,但当然会带来更高的电池消耗或其他问题。是的,因为我们在实际游戏中并没有使用 SAO 或其他类似的技术,所以无法给出真实的数字。但无论是否使用回溯技术,电池消耗都会增加约 1,000 毫瓦每秒。是的,这是事实。电池消耗确实是一个需要重视的问题。
Slide 57 — 00:47:46
📌 要点汇总
- The speaker mentions using prime numbers for prediction but does not elaborate on the technical details.
- The discussion shifts to real-time lighting techniques and forward rendering, with a question about the use of forward plus or on-tile deferred approaches.
- The response indicates that forward rendering is used without mentioning forward plus or deferred techniques.
- The conversation appears to be transitional and lacks specific implementation details or metrics.
我们使用素数预测来改进。好的,谢谢。我会来的。谢谢。这很有趣。实际上,我对《竞技场突围》中的其他一些事情很好奇。我有两个问题,一个是实时光照。你呢?是这样吗?你用的是 forward plus 吗?你的做法像 on-tile deferred 一样吗?那里有什么技术?我们只使用前向渲染。不,没有向前传球。
Slide 58 — 00:48:36
📌 要点汇总
- The speaker is discussing object lighting, noting a maximum of four lights per object.
- The conversation includes uncertainty and hesitation, suggesting the topic is complex or not well-defined.
- The speaker mentions forward addition and delayed movement as potential performance improvement methods.
- There is a mention of exploring alternative approaches, though details are unclear or incomplete.
向前加。不,这是前瞻性运行,但不是前瞻性计划。哦,好吧,好吧,好吧。因此,就每个对象而言,就像照明的选择一样。哦好的。就,就,嗯,就最多,呃,我们这个物体的光的最大数量是四个。好的。只有四盏灯。是的。好吧,好吧。
您是否尝试过使用 um、with like?其他两种方法,例如可能提高性能的方法。爸爸,原谅吗?哦,对不起,对不起。您是否尝试过其他两种方法中的任何一种(使用前向加法或使用延迟的移动方式)以进行类似的改进?
Slide 59 — 00:49:26
📌 要点汇总
- 延迟渲染方案因高带宽消耗尚未用于发布版本
- G缓冲区仅在芯片上开启时无法用于后处理
- 启用G缓冲区用于后处理会带来3到4倍的带宽成本
- 高带宽消耗会显著影响电池续航,是移动开发的重要挑战
渲染性能的表现。而且我们也尝试过延迟渲染,但是到目前为止带宽都非常高。所以到目前为止,我们还没有在发布版本中使用它。
好的。如果G缓冲区仅在芯片上打开,那么是的,不能用于后处理。但如果G缓冲区在后处理中可用,那么带宽成本将是三到四倍。
是的,这会消耗电池。好的。是的,电池始终是令移动开发者头疼的问题。这是。这是。
Slide 60 — 00:50:15
📌 要点汇总
- The team uses a pre-pass technique to optimize rendering and reduce draw calls.
- Software occlusion culling is implemented to improve performance and reduce overdraw.
- Custom techniques are applied to manage the complexity of many leaves in the scene.
- Pre-pass rendering helps in efficiently handling visual elements before the main rendering stage.
我很好奇。另外,《竞技场突破》有很多叶子,我很好奇是否有任何自定义技术可以减少透支。
是的,我们使用预通道。您在预通道中渲染所有内容吗?
什么是,它是像前向预通道设置一样的标准吗?
嗯,其实,为了减少 draw call,我们使用了软件遮挡。
Slide 61 — 00:51:05
(该幻灯片时间段内未检测到语音内容)
Slide 62 — 00:51:55
📌 要点汇总
- Speed buffer technique predicts pixel movement based on velocity for frame prediction.
- SSAM (Screen Space Aggregation Matching) is a more advanced method for motion prediction.
- Speed buffer may require additional resources like larger render targets.
- SSAM likely addresses limitations of speed buffer in accuracy or performance.
- The speaker has experimented with speed buffer and acknowledges its limitations.
就像使用速度缓冲区,并根据像素的速度预测下一帧,然后将像素移动到该位置并用于下一帧。我感觉你提到的 SSAM(屏幕空间聚合匹配)更高级。我的意思是,我仍然没有完全理解它,但听起来它更先进。那么,SSAM 解决了速度缓冲区无法解决的问题。我假设你尝试过速度缓冲区。是的,我能理解。是的,速度缓冲器。是的,我已经提到过太多次了。嗯,需要速度缓冲区。是的,嗯,多一张或一张大渲染图块。
Slide 63 — 00:52:45
📌 要点汇总
- 频段成本和电池消耗与顶点深度恢复相关,通过重建静态对象网格并重新投影可优化性能。
- 使用 100、300、400 个绘制调用处理静态对象,但帧预测仅需 1 个绘制调用,显著减少负载。
- 顶点数量远少于像素数量,因使用了 n 个 tile 的 n 次处理,提升效率并降低资源消耗。
因此,这会导致频段成本和电池消耗。通过从深度恢复顶点,可以看出我们可以重建屏幕空间中静态对象的所有网格,并重新投影网格。所以它也可以用于减少正常情况下的绘制调用。我们对所有静态对象使用 100、300、400 个绘制调用,但对于帧预测,仅使用 1 个绘制调用。这是静态对象的 SSAM 绘制调用。
顶点的数量比像素的数量少得多,对吗?好的,因为我们使用了 n 次 n 个 tile。
Slide 64 — 00:53:35
📌 要点汇总
- The system’s resolution range is between 888×8 and 16×16.
- Bandwidth costs have decreased by a factor of 100.
- The focus is on improving performance and frame rate for a smoother visual experience, especially for FPS games.
- This is the team’s first presentation at GDC.
- The speaker is interested in finding academic papers or documentation about the technology online.
实际上,它在八八八乘八到十六乘十六之间。是的,带宽成本降低了一百倍。好的。所以,一切都是为了性能。所以我们想要尝试把帧率调高一些,让体验更好,达到流畅的视觉体验。因为我们认为这对于 FPS 游戏来说非常重要。
凉爽的。是的,它非常有趣,而且听起来非常有效。我想知道,我可以在网上或互联网上找到类似的关于这项技术的论文或文档吗?
实际上,这是我们的第一个 GDC。
Slide 65 — 00:54:25
📌 要点汇总
- (Transitional content, no key points)
发表一下,我发现没有找到参考资料。这些都是可以的,所有的方法都是我提出的。所以,你可以记录一下伪代码,也可以尝试自己实现。因为我认为它确实非常简单、强大,并且确实有效。很酷。我的意思是,您打算在某个地方发布此演示文稿吗?我只是想知道。因为在这次演示之后,我无法找到更多信息,这样我们学习起来就会很困难。但无论如何,这是一次很好的交流。这个话题超级有趣。好的,好的。希望我们可以继续讨论这个问题。我听不到对这项业务的肯定,但实际上,有一个是的,就是它了。
Slide 66 — 00:55:15
📌 要点汇总
- The content will be published as a book, similar to Tencent Games’ previous book release.
- The speaker is a developer on the project and cannot disclose further details due to business reasons.
- The speaker acknowledges the possibility of using AI translation for non-Chinese versions.
这也将出版成书。腾讯游戏也出自一本书。我不能提及游戏和书名。但是,是的,它也将被发布。但由于业务原因,我无法提供更多信息,因为我不是,是的,我只是这个项目的开发人员。是的,非常感谢你。
哦,那太好了。哦,那真是太好了。我认为这只是中文版本,但是,是的,你可以使用人工智能翻译,可能有用,或者是的,学习。
Slide 67 — 00:56:05
📌 要点汇总
- 动态光照变化会影响帧预测的准确性,需特别处理
- 若相邻帧光照相似,可直接复用像素以提高效率
- 光照差异明显时,需采用光照补偿算法或引入额外光照信息
- 简化光照处理可提升预测性能,尤其在光照变化较大的场景中
我想说这也很酷,对吧?好的。更多的细节、更多的代码、更多的结构你可以在书中找到。谢谢。这是一个很棒的演讲,但我有一个关于帧预测的问题。好的,请。
那么,如果你有动态光照呢?如果两帧之间的光照不同,如何使预测正确?是的,在我们的是。我的组长洪军已经说过,我们的灯光不是动态的。是的,其实很简单。所以我们可以检查两个相邻帧之间的照明是否相似或相同。如果我们发现它们是相似或相同的,就可以直接复用像素。
但如果我们发现两帧之间的光照有明显差异,就需要采取其他方法来处理这种情况。例如,可以使用光照补偿算法,或者引入额外的光照信息来辅助预测。这有助于提高预测的准确性,尤其是在光照变化较大的场景中。
Slide 68 — 00:56:55
📌 要点汇总
- The rendering pipeline uses a base pass with G-buffer caching, reprojection, and SSAA for frame prediction.
- Additional bandwidth costs are incurred, but optimization options like G-buffer compression are available.
- The structure is flexible and modifiable for custom implementations.
- The solution achieved 144 frames per second, demonstrating high performance.
- The approach uses direct mode rendering rather than tiling mode, with no hardware dependency.
- The technique is implemented in Unreal Engine 4.26 but can be adapted to other engines with pipeline modifications.
- It is a software-layer solution, not limited to a specific engine or platform.
灯光变化很快。你可以使用。我们来看看渲染管线的结构。你可以,好吧,你能看到我的“是”吗?您可以在基础通道中使用不同的渲染并缓存 G 缓冲区,并且重新投影并使用 SSAA 重新投影 G 缓冲区,并在预测帧中重新点亮。好的,谢谢。这是一个解决方案。它会花费额外的带宽成本,是的,但它也可以工作,你可以阅读,是的,你也可以压缩 G 缓冲区或其他方法,是的,进行优化。是的,它是一个灵活的结构,所以你可以自己修改。好的,谢谢。好的,谢谢你的介绍。太棒了。一百四十四帧。很难相信这一点。
所以我想根据一些人提出的问题来确认一个问题。所以看起来您正在使用直接模式进行渲染,而不是平铺模式。因为对于 GPU 来说,对于移动 GPU 来说,其实你可以控制它是平铺模式还是直接模式。是的,我说实话,是的,它是一个软件层掩码。先生,我们仅将它用于移动设备,但实际上它可以在每个设备上使用,因为没有硬件,是的,没有光栅化就没有硬件依赖性。是的,我认为每个图形 GPU 都有光栅化,对吗?好的,明白了。谢谢。
另一个问题。那么,你们的技术是否集成了虚幻引擎或 Unity?我们的引擎使用 Unreal for 0.26,是的,我们已经在 Unreal Engine 4 中实现了,但是,是的,我认为它可以在所有引擎上使用,或者是,因为它也很简单。我认为它可以用在你的玩具引擎中。哦,不,不,抱歉,我的问题我的问题是这样的:好好考虑一下,假设我是游戏开发者,对吗?所以我想在这里使用你们的技术。这些东西。是准备好在 Unreal Engine 还是 Unity 中使用了吗,还是我必须使用你们的引擎?是的,我们是同一个游戏。我们使用虚幻引擎四点二六。他们想问你,你的技术适用于其他游戏引擎,还是只适用于你自己的游戏引擎?是的,是的。我刚刚解释过。是的,这是一个软件,软件层的方法。所以是的,如果您想在您的项目中使用它,您可以修改管道,因为我们放置了静态和动态对象的渲染。是的,帧预测必须与管道的修改一起使用。好的。是的,我明白了。这意味着我必须自己编码。所以它不能在所有当前所有引擎上可用,但可以在所有引擎上使用。好的。是的。如果你修改管道,是的,没关系。我想我知道你在说什么。谢谢。非常感谢。