【GDC 2022】Adventures with Deferred Texturing in Horizon Forbidden West
来源:D:\迅雷下载\GDC 2022 - Adventures with Deferred Texturing in Horizon Forbidden West.pptx 提取时间:2026-05-12 10:14:42
📋 全文内容摘要
演讲主题与背景
Guerrilla团队在《Horizon Forbidden West》中针对开放世界树叶渲染性能瓶颈,提出基于延迟纹理的优化方案,解决PS4/PS5平台高复杂度几何体与动态着色需求的兼容性问题,应对艺术表现与硬件限制的双重挑战。
核心技术方案
- 可见性缓冲区系统:通过32位
Slide 1

📌 要点汇总
- 名言引用:强调发现新视角比探索新风景更重要
- 游戏背景:《Horizon Forbidden West》包含全新冒险场景
- 技术主题:需重构渲染管道实现视觉创新
“真正的发现之旅不在于寻找新的风景,而在于拥有新的眼睛。” ——马塞尔·普鲁斯特
在《Horizon Forbidden West》中,Aloy 在遥远的土地上进行了一场伟大的冒险,有许多新的风景,但为了实现其中一些,我们必须重新审视我们的渲染管道,这就是我今天要讨论的内容。
Slide 2
📌 要点汇总
- 演讲者身份:Guerrilla高级首席技术程序员James McLaren
- 技术主题:延迟纹理系统优化树叶渲染性能
- 核心目标:提升开放世界植被渲染效率
你好,谢谢你的到来。 我叫 James McLaren,是 Guerrilla 的高级首席技术程序员。
在本次演讲中,我将详细介绍我们制作的延迟纹理系统的一些细节,该系统主要是为了加速《Horizon Forbidden West》的树叶速度。
Slide 3
📌 要点汇总
- 演讲结构:问题分析→系统概述→技术细节→性能验证
- 技术重点:可变速率着色实现与性能数据展示
- 内容层次:从宏观架构到微观实现的递进解析
我将首先讨论渲染树叶的问题并回顾我们之前的系统,然后我将继续讨论延迟纹理的实际含义。然后,我将对我们的系统进行高级概述,然后深入研究它的一些细节,并讨论一下我们的可变速率着色实现,最后我们将给出一些性能数据。
Slide 4
📌 要点汇总
- 游戏定位:PS4/PS5平台开放世界冒险游戏
- 时间信息:2022年2月发布,零之曙光续作
- 玩法核心:通过战斗拯救世界的叙事框架
但在此之前,如果你对此一无所知,我先介绍一下《地平线禁西》。 Horizon Forbidden West 是一款适用于 PS4 和 PS5 的开放世界冒险游戏,于今年 2 月推出 地平线零之曙光的后续。
在其中,你扮演诺拉勇敢者阿洛伊,他必须拯救世界,主要是通过与许多危险的机器战斗。
这是一个预告片,让大家了解一下。
Slide 5
📌 要点汇总
- (无内容):此幻灯片无演讲内容
Slide 6
📌 要点汇总
- 环境多样性:包含森林、丛林等复杂场景,渲染挑战显著
- alpha测试几何体:植物多由alpha测试构成,存在大量透支问题
- 运动矢量需求:需生成正确运动矢量以支持TAA和运动模糊
- 动画限制:无法通过简单剪切处理,需完整几何体动画
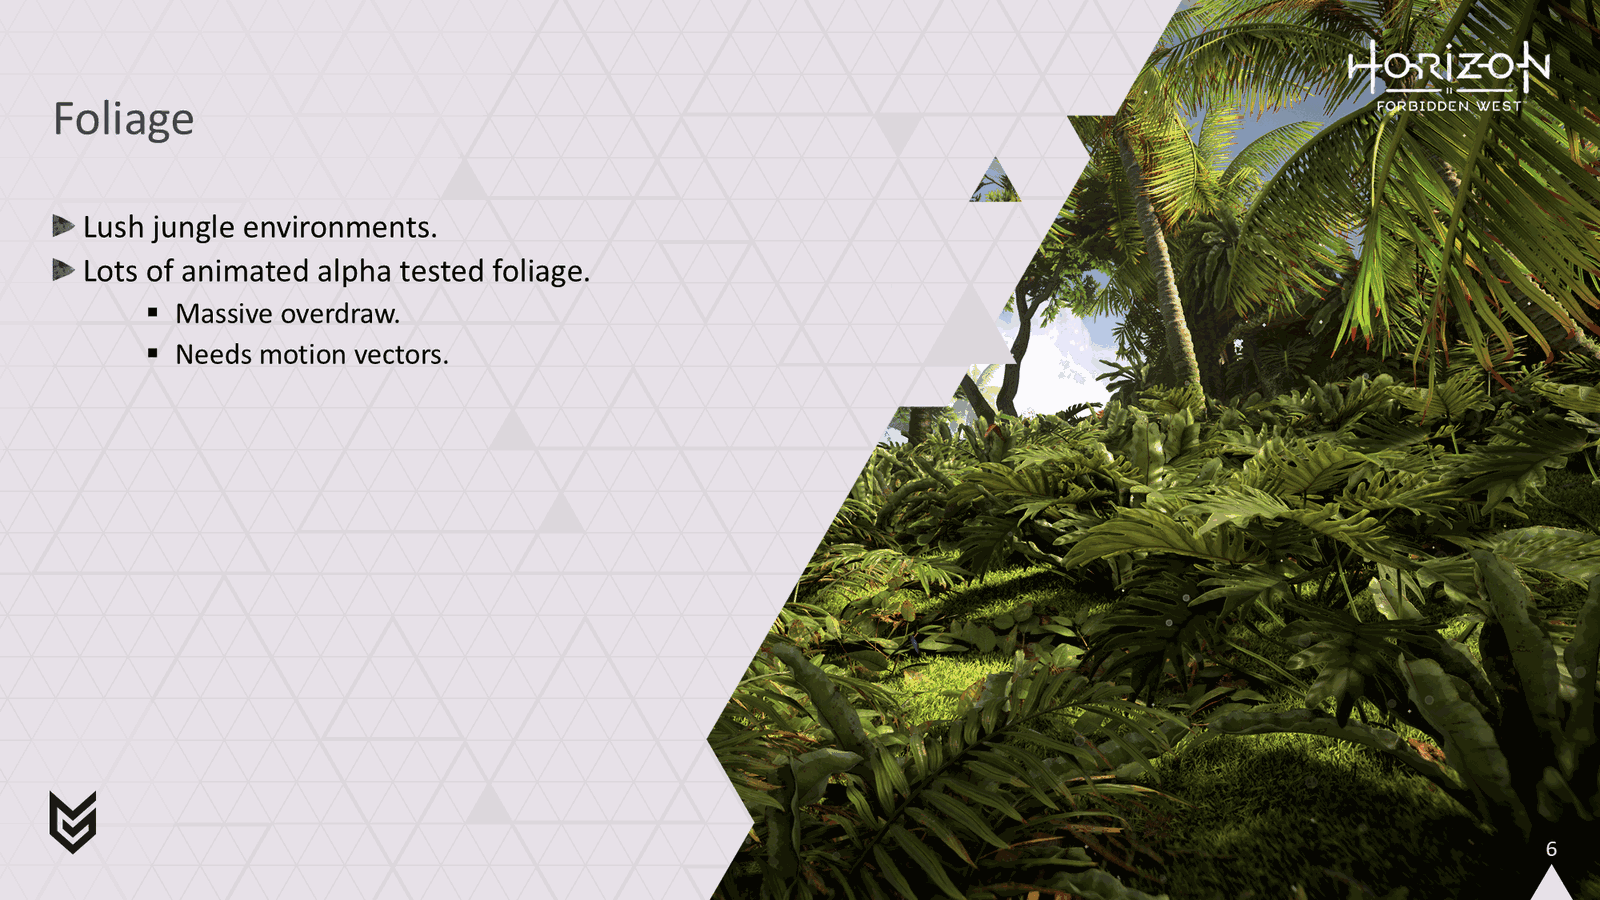
在《地平线》的世界中,我们有各种各样的环境,包括森林和茂密的丛林等地方。 高效渲染这些通常是一个挑战。我们的大多数植物都是由 alpha 测试的几何体组成的,并且可能存在大量的透支。 几何体也是动画的,我们需要生成正确的运动矢量,以将其输入到我们的 TAA 和运动模糊中,因此我们无法进行简单的剪切。
Slide 7
📌 要点汇总
- 资源密度提升:艺术部门要求更高细节密度,性能压力剧增
- PS4目标限制:需在PS4硬件上实现更高画质,时间紧张
- 戏剧性重演:艺术需求与技术限制的冲突成为项目关键挑战
在《地平线零之曙光》中我们已经有了高度优化的树叶系统, 但对于《Horizon Forbidden West》,艺术部门想要更高的资源密度,这让我们想知道如何找到这所需的额外毫秒数。 这对项目中他们想要的一切来说都是非常紧张的,特别是因为我们仍然需要以 PS4 为目标。 如果您想知道艺术部门在要求更多所有东西时对我们的看法。 这是游戏中戏剧性的重演。
Slide 8
📌 要点汇总
- 探索优化方案:团队积极寻找提升性能和画质的新方法
- 创新动力:通过技术突破满足艺术部门的高要求
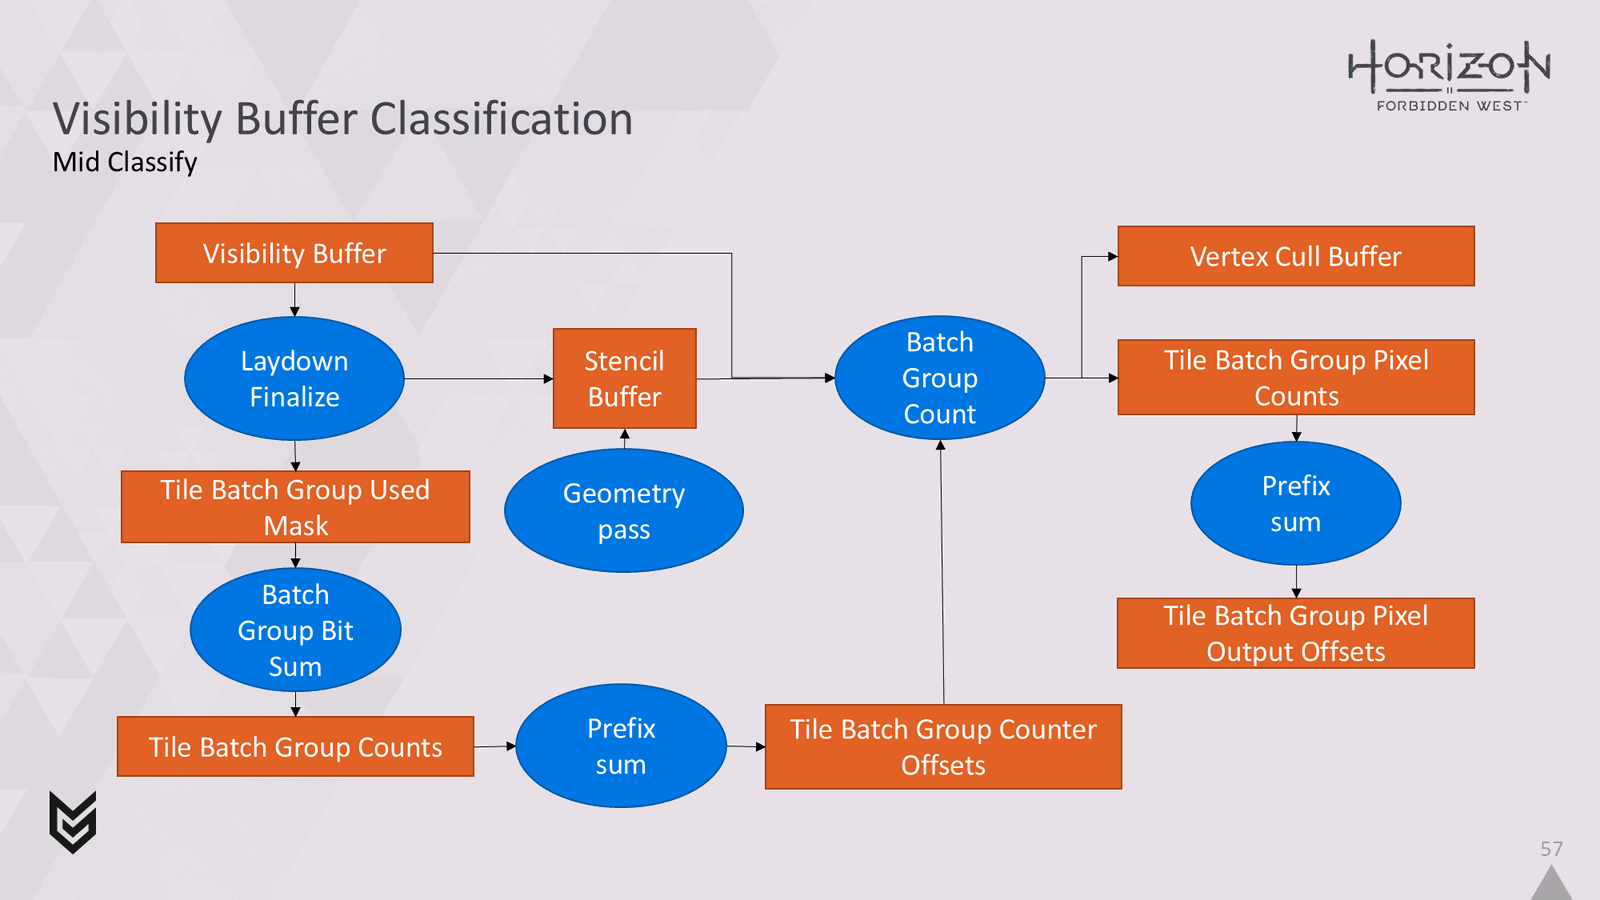
所以我们非常有动力去看看可以做什么。
Slide 9
📌 要点汇总
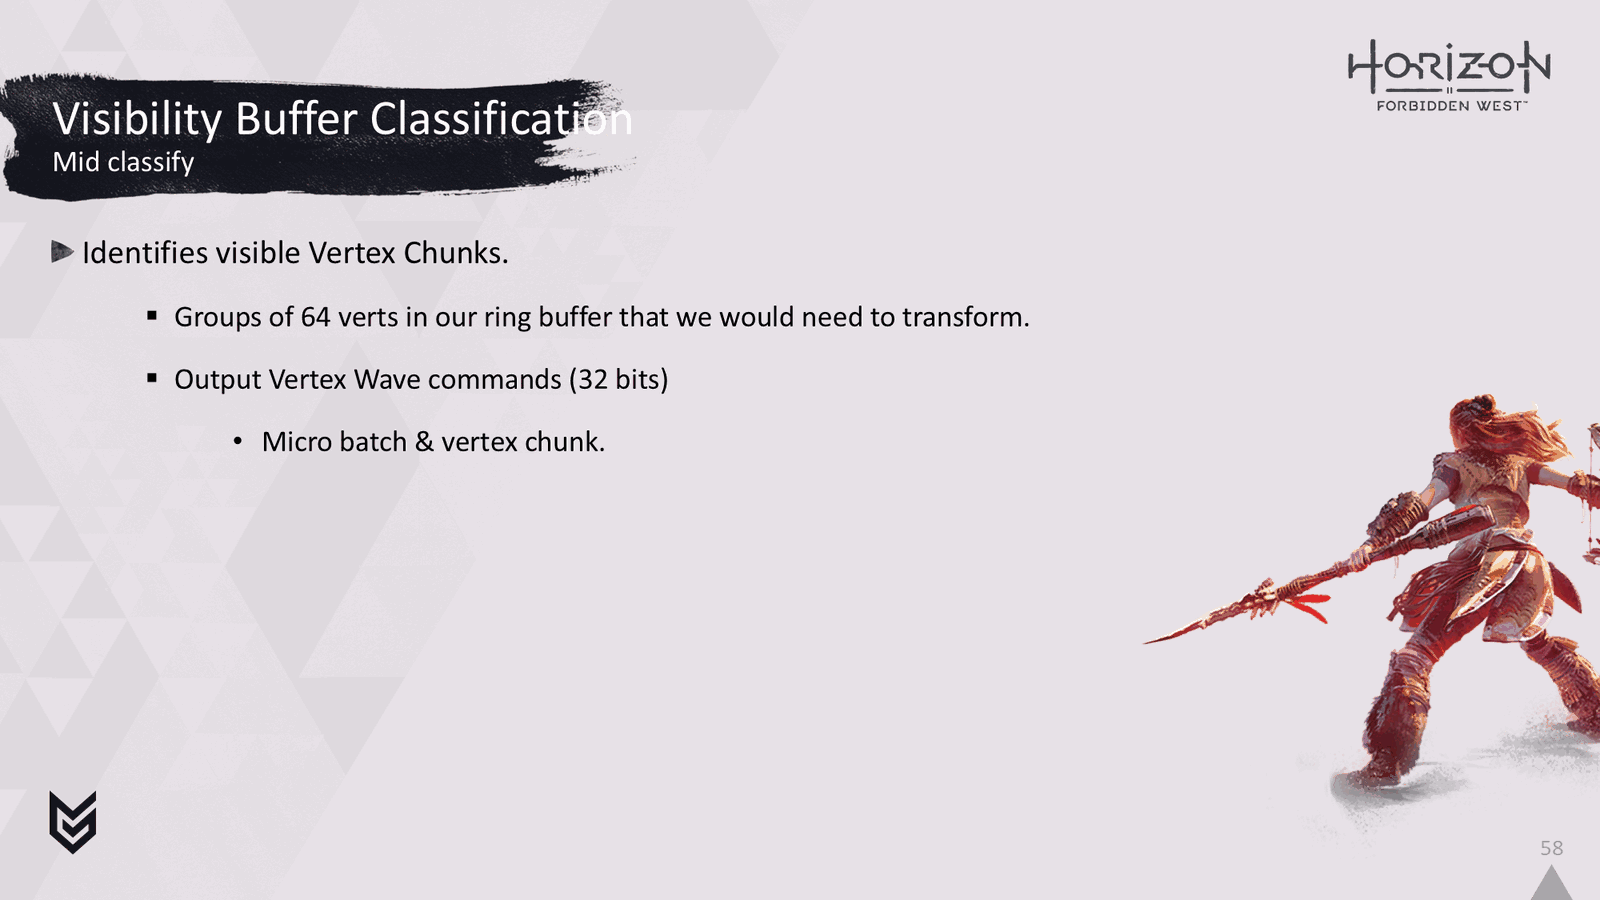
- 渲染成本高:alpha测试导致硬件早期Z
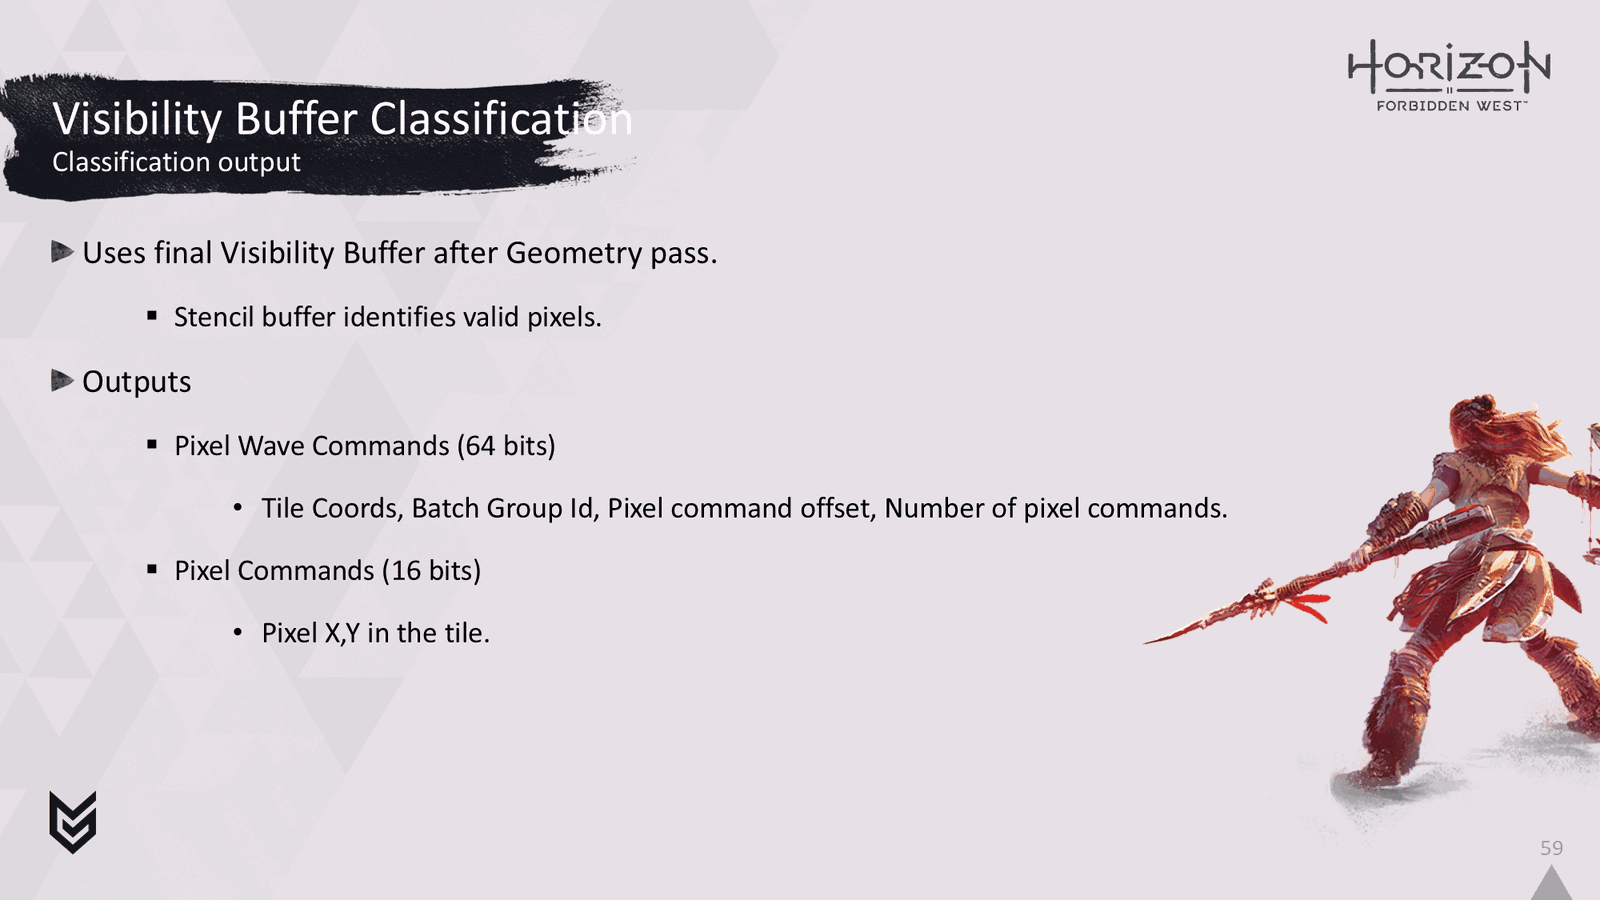
渲染树叶可能会很昂贵。 有很多透支,而且往往会进行 alpha 测试,这会带来额外的费用,因为它会禁用一些硬件的早期 Z 优化。
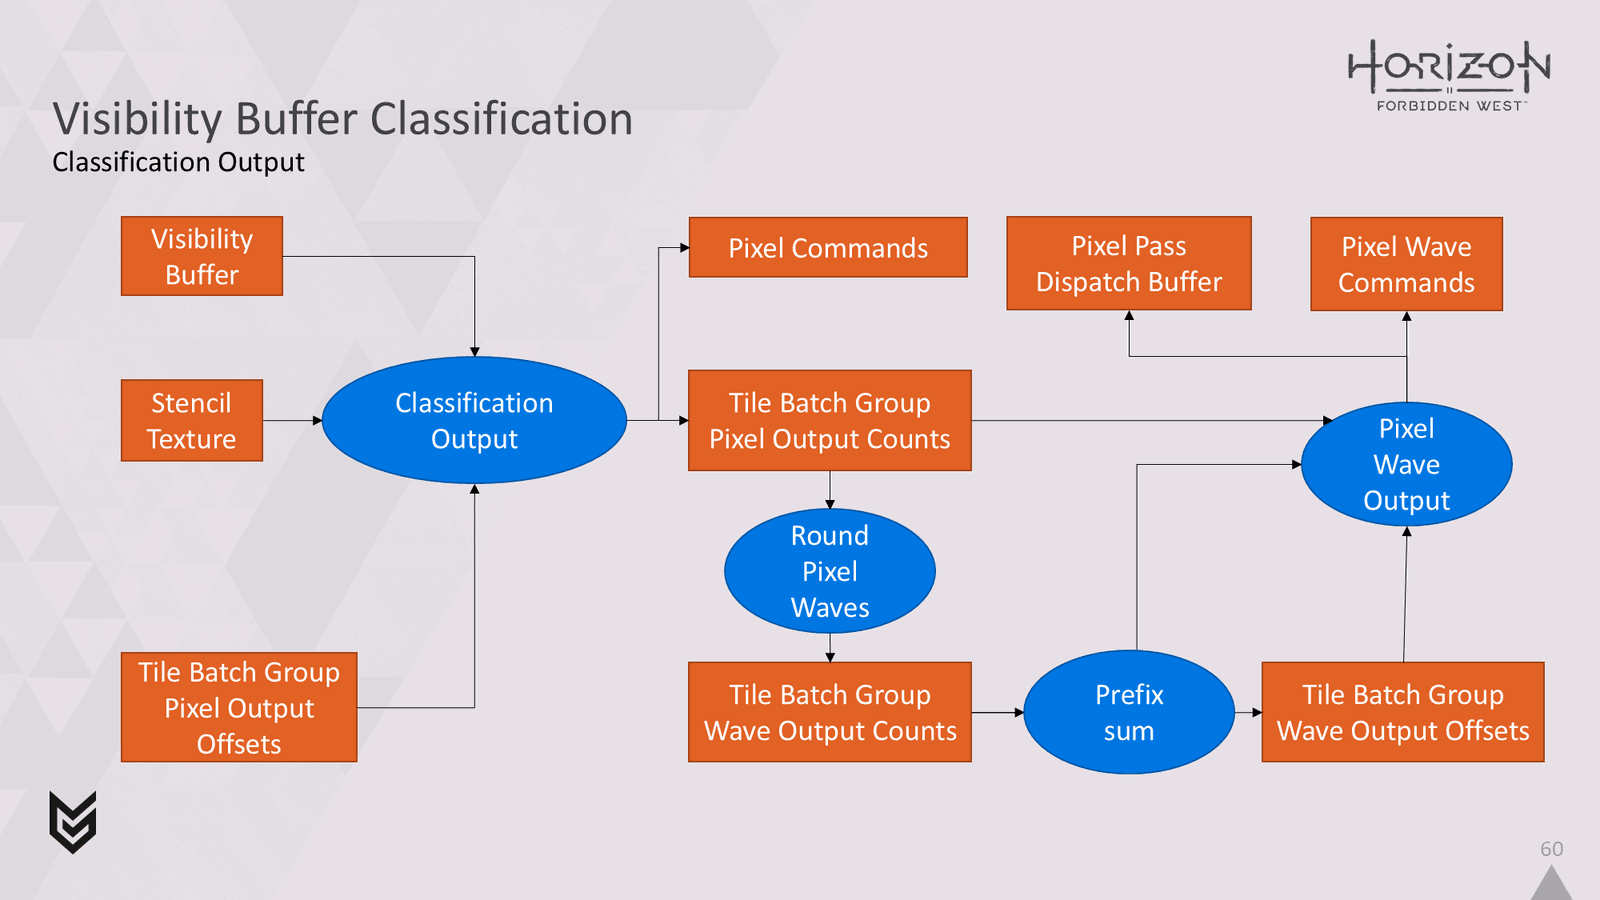
在《地平线零之曙光》中,我们通过使用深度预通道进行 Alpha 测试来解决这个问题,然后在不进行 Alpha 测试的几何通道中再次渲染树叶,但使用深度等于测试来确保我们只对可见像素进行着色。 这是一个非常好的解决方案,因为它避免了我们多次写入 G 缓冲区中的树叶像素。
Slide 10
📌 要点汇总
- GPU双重变换:几何图形需被GPU变换两次,影响效率
- 渲染间隙:二次渲染存在大量顶点无效像素工作间隙
- 四边形过度绘制:树叶细节导致大量四边形重复绘制
然而,这种方法存在一些问题。 所有几何图形必须由 GPU 变换两次。 因此,在再次渲染所有内容时,GPU 通常也很难保持满载,因为存在大量间隙,顶点被变换但在第二遍中不生成任何像素工作。 此外,由于树叶中典型的精细细节,这种方法可能会遭受大量四边形过度绘制。
Slide 11
📌 要点汇总
- Quad overdraw概述:GPU像素着色需计算导数以正确采样纹理
- 2x2四边形着色:硬件强制使用四边形进行有限差分计算
- UV坐标差值计算:通过相邻通道UV差值推导纹理采样导数
如果您不熟悉 Quad overdraw,那么让我给您一个快速概述。 GPU 中的像素着色硬件需要能够自动计算导数,以便在采样时能够选择正确的 mip 贴图并正确过滤纹理。 为此,它始终以 2x2 四边形进行着色。 这样,它就可以使用有限差分从一个通道中减去另一个通道中的 UV 坐标,并计算纹理采样所需的导数。
Slide 12
📌 要点汇总
- 硬件安排四边形:实际着色单元为四边形而非三角形
- 光栅化三角形:黄色像素为理论光栅化结果
- 像素着色差异:硬件处理与预期光栅化结果不匹配
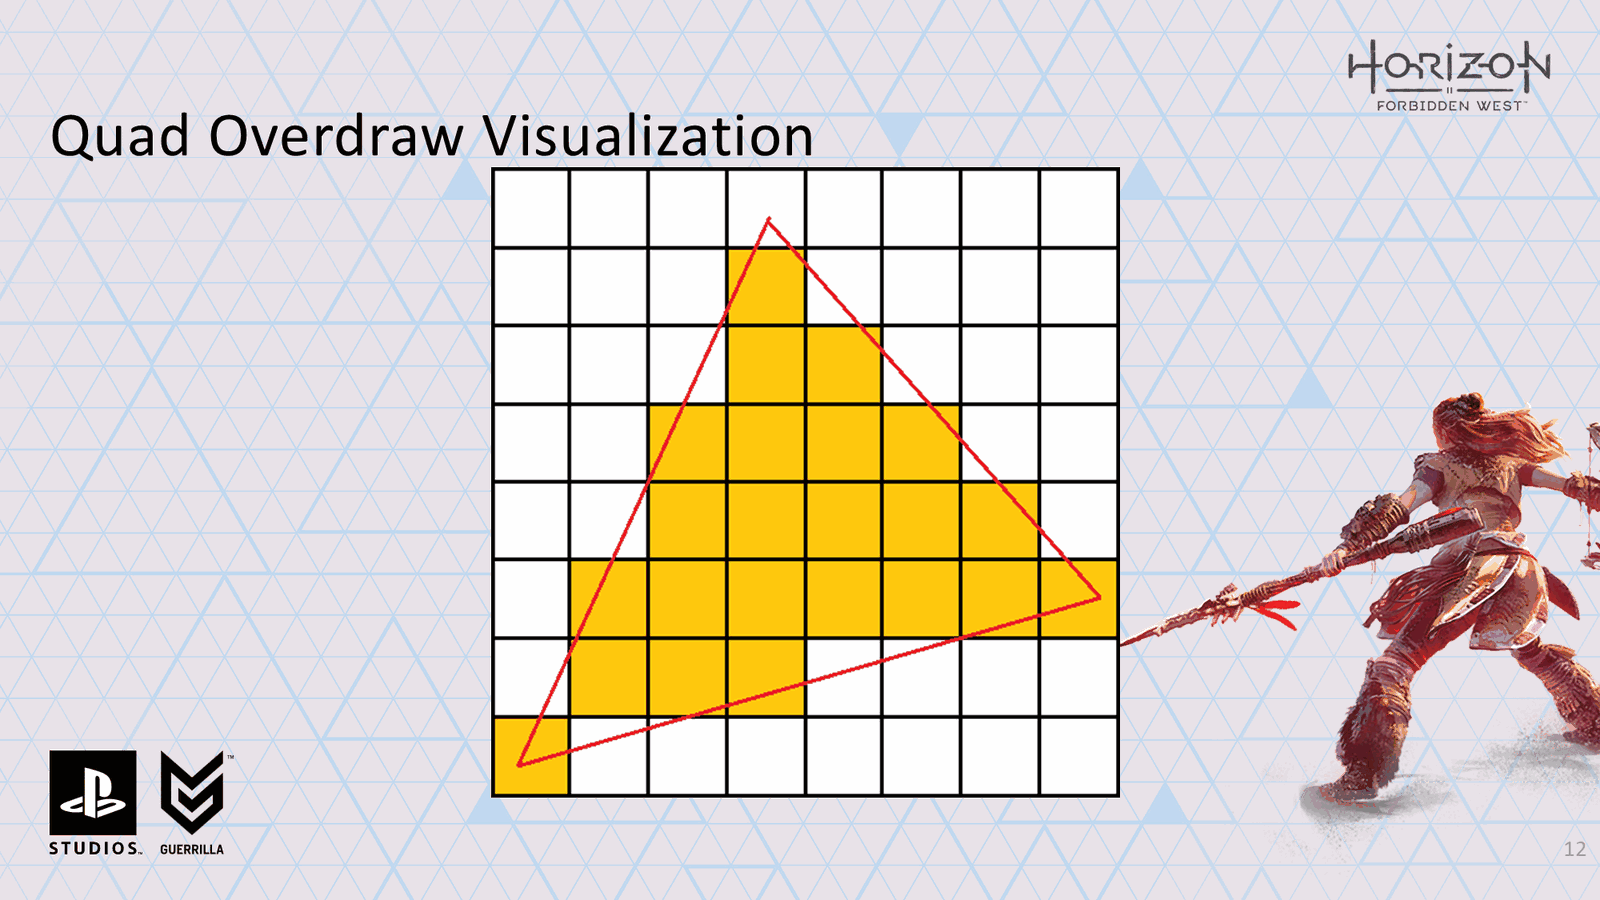
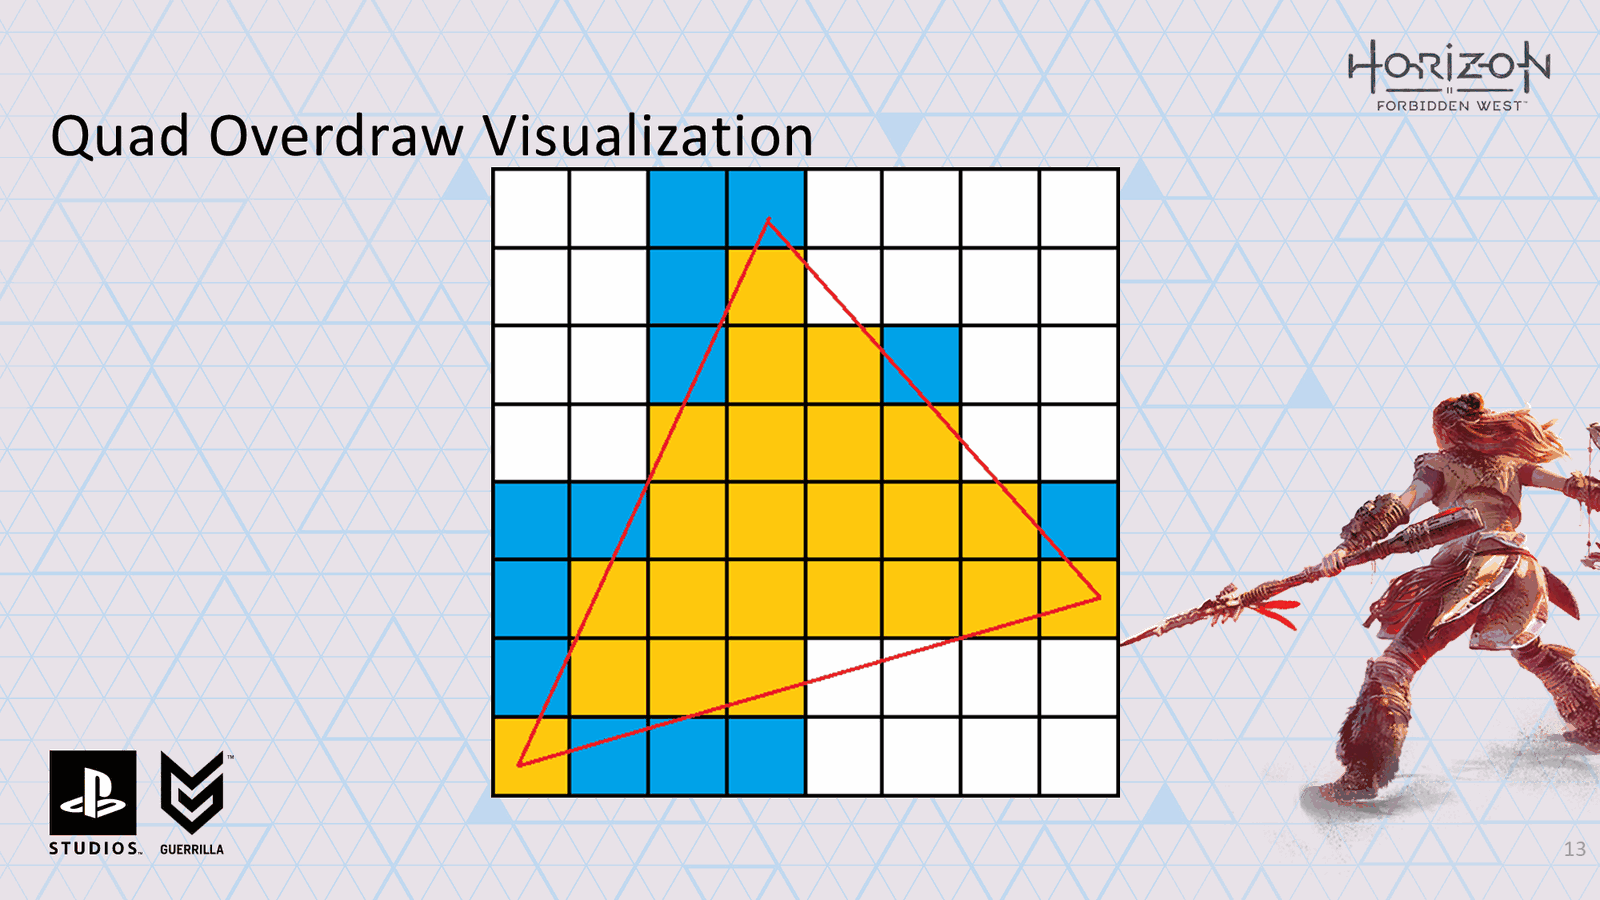
让我们花点时间想象一下这一点。这是一个我们要假装正在光栅化的三角形。 黄色像素显示光栅化的结果。 不幸的是,硬件不会安排要着色的像素,而是安排四边形
Slide 13
📌 要点汇总
- 额外着色蓝色像素:四边形覆盖区域需全部着色
- 硬件处理冗余:超出目标三角形区域的像素被着色
- 着色效率问题:非目标区域着色导致性能浪费
因此,我们最终也对这里的所有蓝色像素进行着色工作。
Slide 14
📌 要点汇总
- 四边形透支问题:小三角形需着色16像素仅输出4像素
- 小三角形高开销:右三角形着色量是输出量的4倍
- alpha测试问题:大三角形加alpha测试仍存在过度绘制
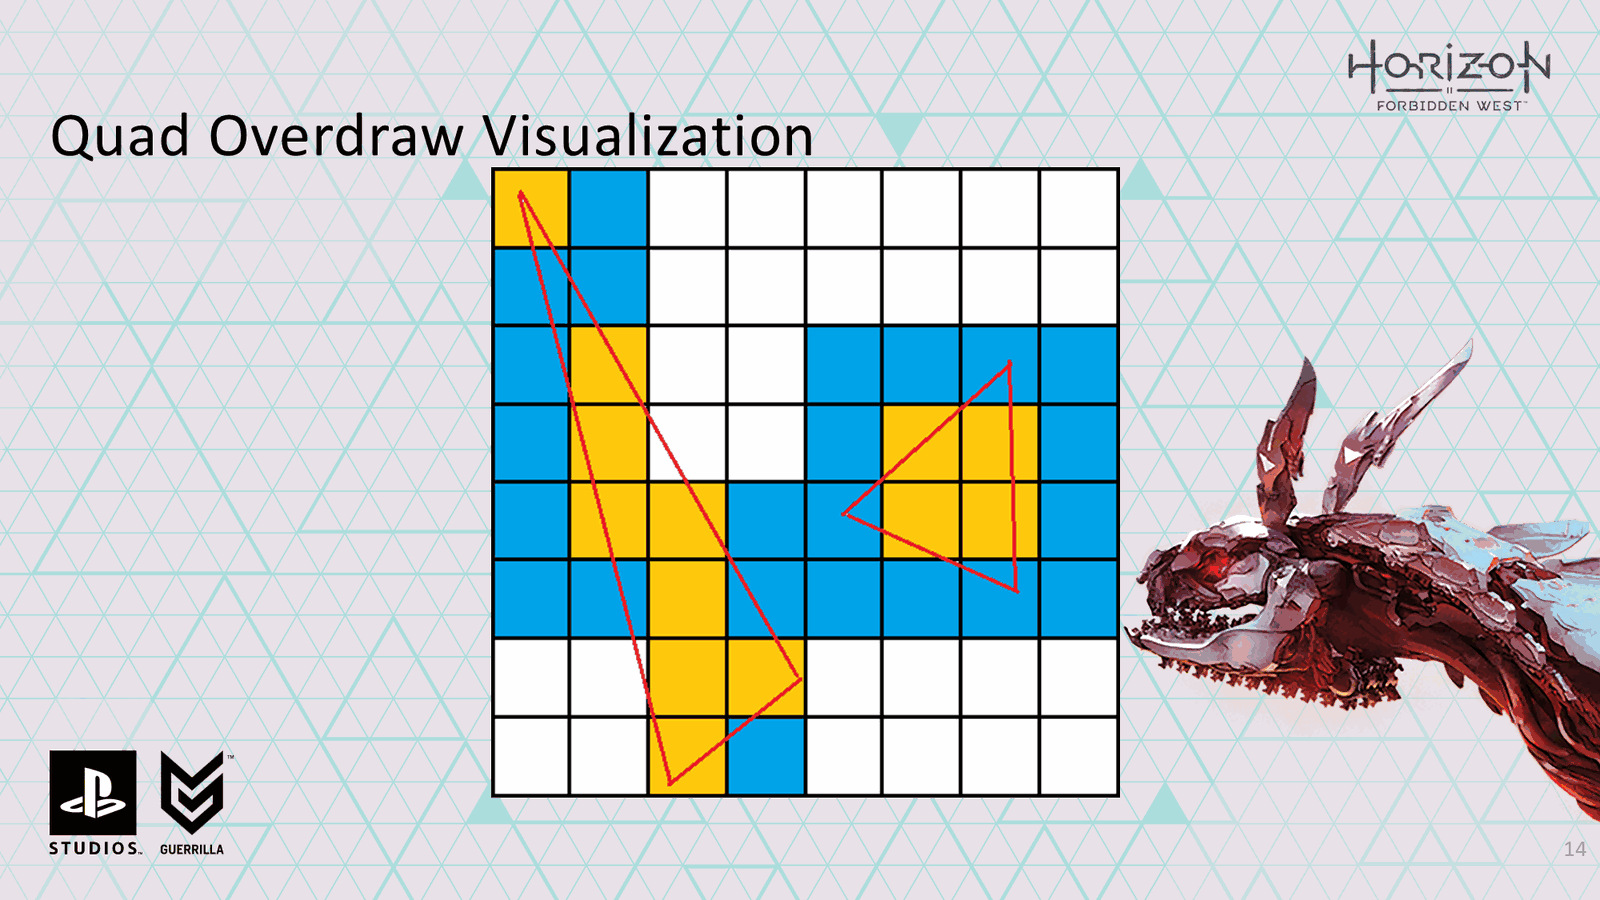
正如你所看到的,当我们深入到小三角形时,这个问题变得更糟。 右边的三角形特别悲伤。它输出 4 个像素,但我们必须对 16 个像素进行着色工作才能计算导数。 这就是我们在谈论四边形透支时所指的内容。
对于树叶,我们有时可以使用大三角形,但通常伴随着 alpha 测试,以模仿精细的细节。 当在几何通道中进行深度相等测试时,这会在我们的旧系统中遇到完全相同的四边形过度绘制问题。
Slide 15
📌 要点汇总
- 探索新解决方案:基于四边形透支问题寻找优化方向
- 应对四边形透支:需要改进渲染管线减少冗余着色
- 优化渲染性能:通过新方案降低过度绘制带来的开销
因此,有了这些知识,我们现在就可以开始新的冒险,寻找更好的解决方案。
Slide 16
📌 要点汇总
- (无内容):此幻灯片无演讲内容
阿洛伊准备好踏上她的冒险之旅了。
Slide 17
📌 要点汇总
- 延迟纹理实现:通过预传递生成可见性缓冲区,记录每个像素最顶部三角形的Primitive ID
- 可见性缓冲区:包含场景中所有可见图元的ID信息,用于后续像素着色
- 渲染优化:避免对不可见像素进行着色,减少过度绘制问题
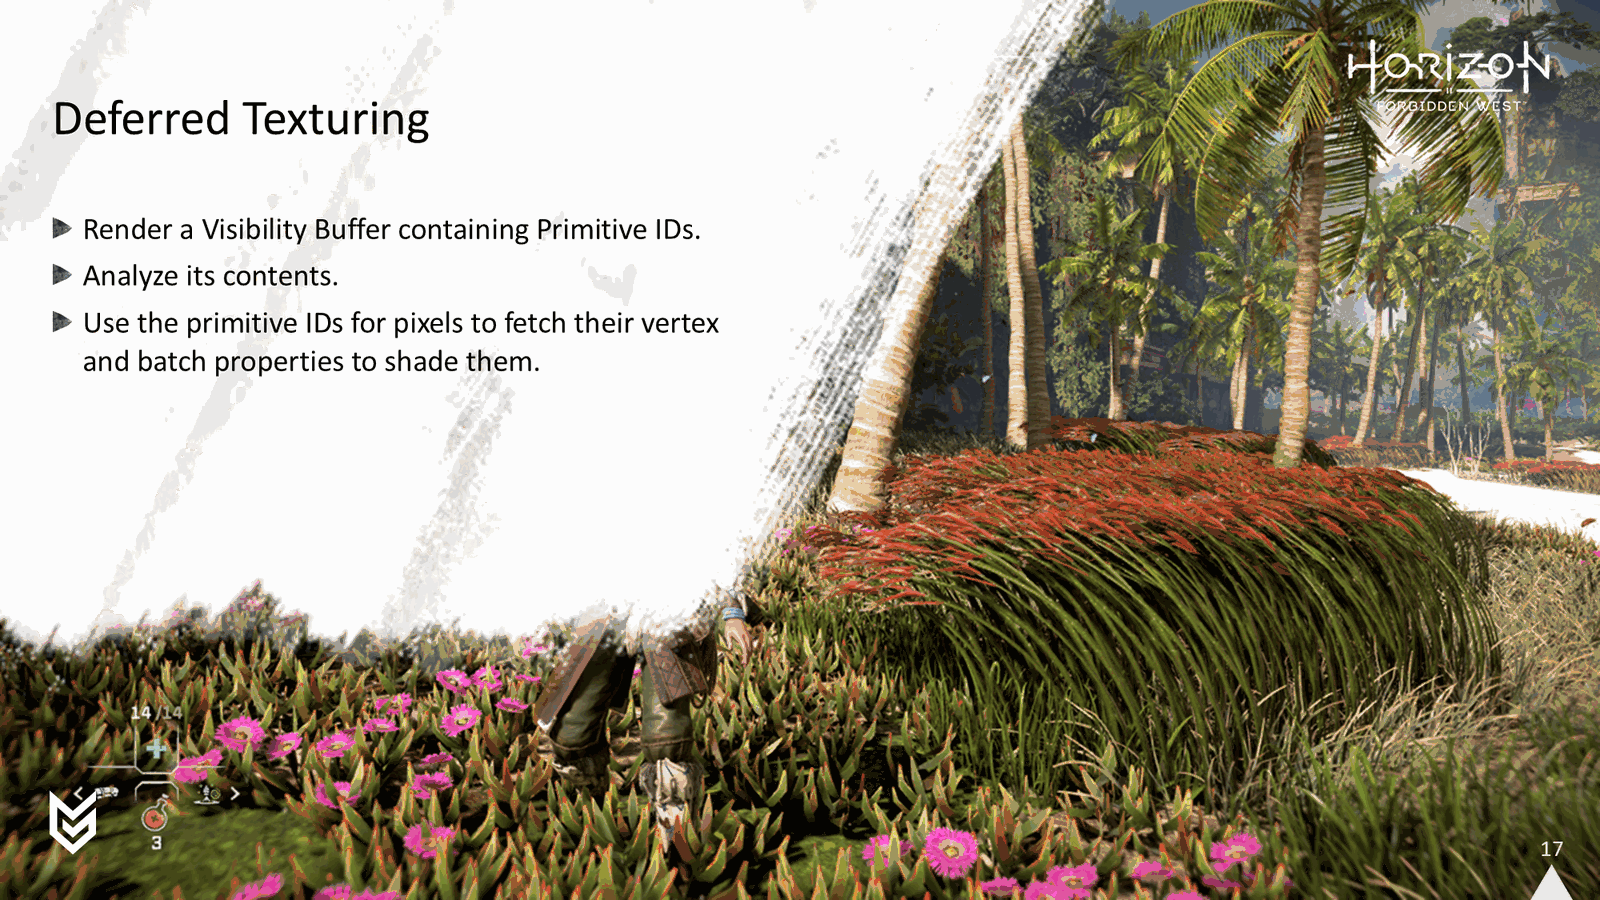
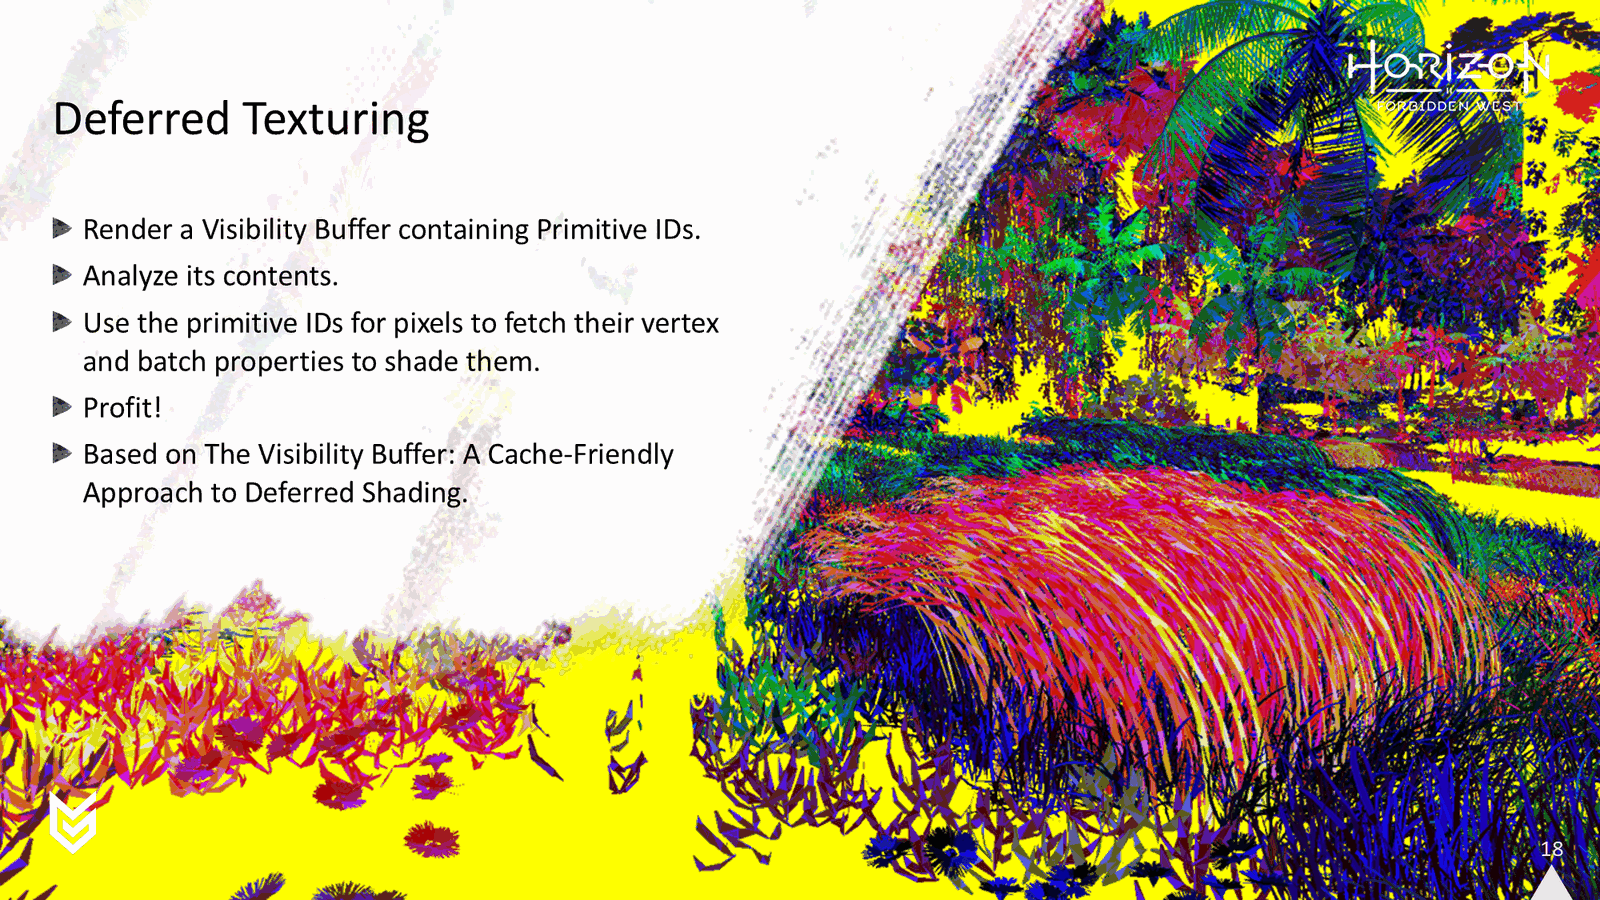
我们决定开始的伟大冒险是尝试实现延迟纹理。 这里的基本思想是,在渲染任何不透明几何体之前,我们对场景进行预传递以生成可见性缓冲区。 这与深度预通道非常相似,只是我们还将 Primitive ID 写入附加渲染目标。 完成后,可见性缓冲区将包含每个像素最顶部三角形的 Primitve ID。 然后我们可以分析该缓冲区并使用基元 ID 来对像素进行着色。
Slide 18
📌 要点汇总
- 英特尔论文来源:可见性缓冲区技术最早由英特尔提出
- 渲染器兼容性:适用于前向渲染器和延迟渲染器(如HFW中的延迟渲染器)
- Gbuffer生成:通过像素着色过程直接生成Gbuffer数据
这个想法最初在英特尔的一篇论文中描述:可见性缓冲区:延迟着色的缓存友好方法。
这可以应用于前向渲染器和延迟渲染器。 在 HFW 中,我们有一个延迟渲染器,因此对像素进行着色的过程将生成我们的 Gbuffer。
Slide 19
📌 要点汇总
- 图元ID可视化:颜色编码显示可见性缓冲区中图元ID的分布情况
- 有效像素识别:黄色像素表示未包含有效图元ID的不可见区域
- 数据稀疏性:可见性缓冲区中仅有部分像素包含有效图元信息
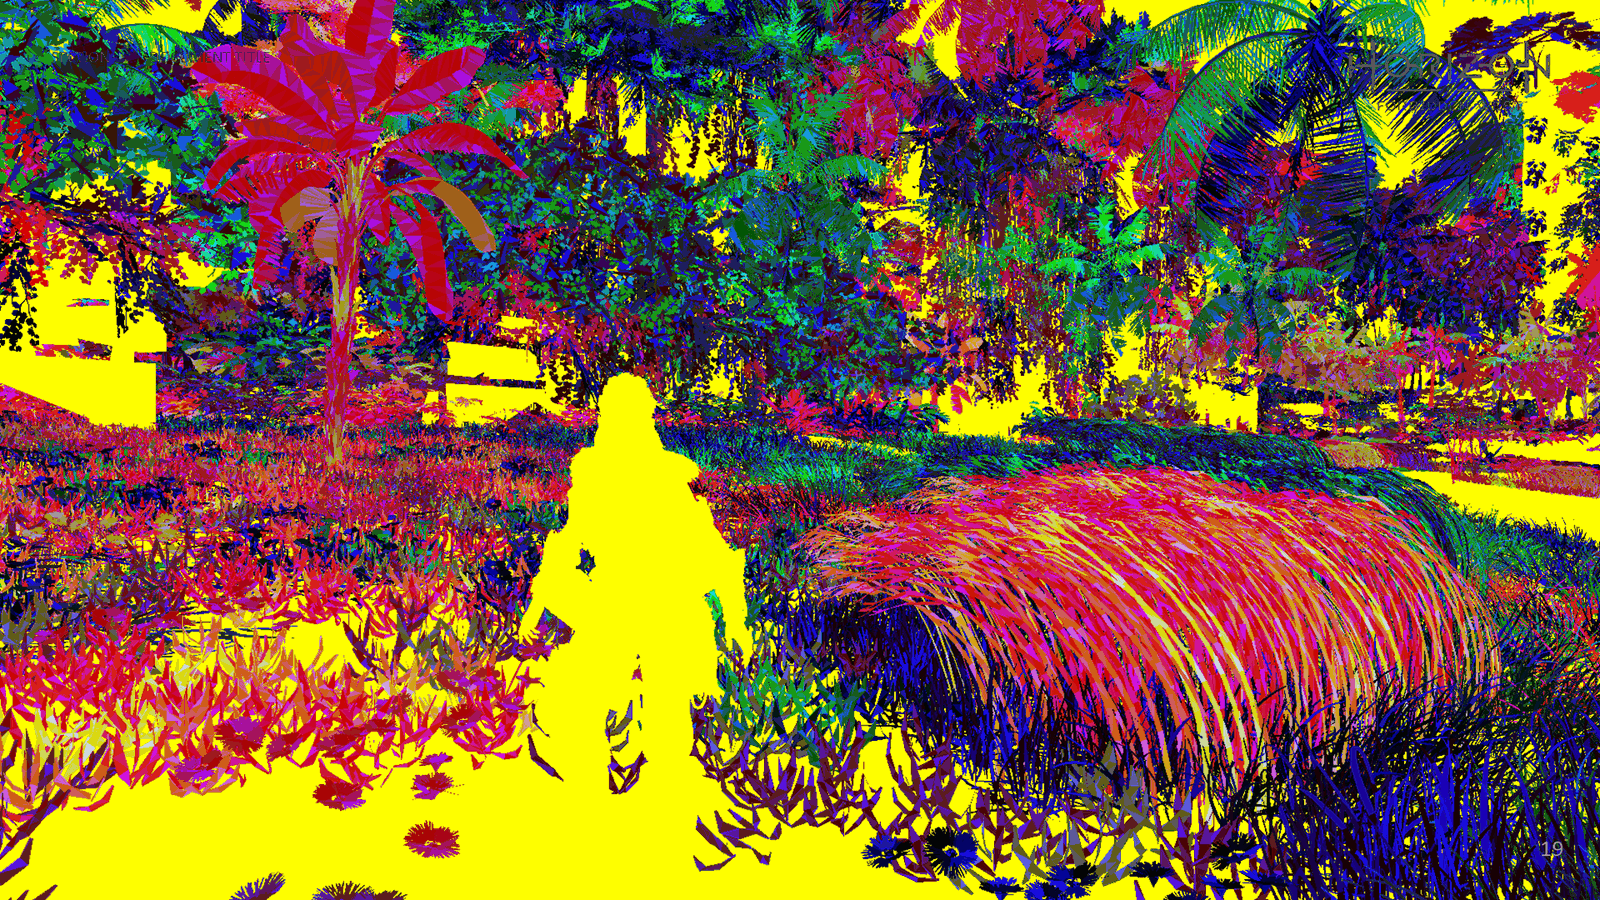
这是同一场景的颜色编码可视化,显示了我们将放入可见性缓冲区中的所有图元 ID。 正如您所看到的,只有一些像素实际上具有有效的图元 ID,这里的黄色像素是未包含在我们的可见性缓冲区中的像素。
Slide 20
📌 要点汇总
- 性能优化:减少对不可见像素的着色操作,避免四边形透支问题
- 几何处理优化:可能无需重复转换几何数据,降低GPU负载
- 带宽节省:相比简单延迟方案减少显存带宽占用
- 技术局限:并非完美方案,存在潜在实现复杂度和性能权衡问题
那么我们为什么要这样做呢? 好吧,一方面我们希望只对可见像素进行着色,这样就不会出现过度绘制。 理论上,我们也可以摆脱任何四边形透支问题,具体取决于我们处理事物的方式。 此外,我们不需要再次转换所有几何图形,可能只是屏幕上的几何图形,也可能根本不需要,具体取决于我们如何实现事物。 至少与简单的延迟解决方案相比,它还有助于节省带宽。 但这并不全是阳光和玫瑰。
Slide 21
📌 要点汇总
- 手动计算导数:有限差分无法使用,需手动计算像素导数
- 可见性缓冲区调度:需高效调度可见性缓冲区像素解析材质
- 技术风格多样化:不同实现方案开始呈现多种技术风格
由于硬件无法为我们创建四边形,因此我们无法再使用有限差分来生成导数,而必须自己计算它们。 此外,我们现在面临着一项重要任务,即弄清楚如何有效地调度或绘制可见性缓冲区中的所有像素来解析我们的材质。
与任何好的技术一样,这种技术已经开始出现各种不同的风格。
Slide 22
📌 要点汇总
- 可见性缓冲区编码:三角形/实例ID以32位uint编码
- 计算着色器处理:通过间接调度启动计算着色器处理图块
- 手动导数计算:在计算着色器中手动计算属性导数
- 低带宽输出:直接输出阴影/照亮结果无需中间GBuffer
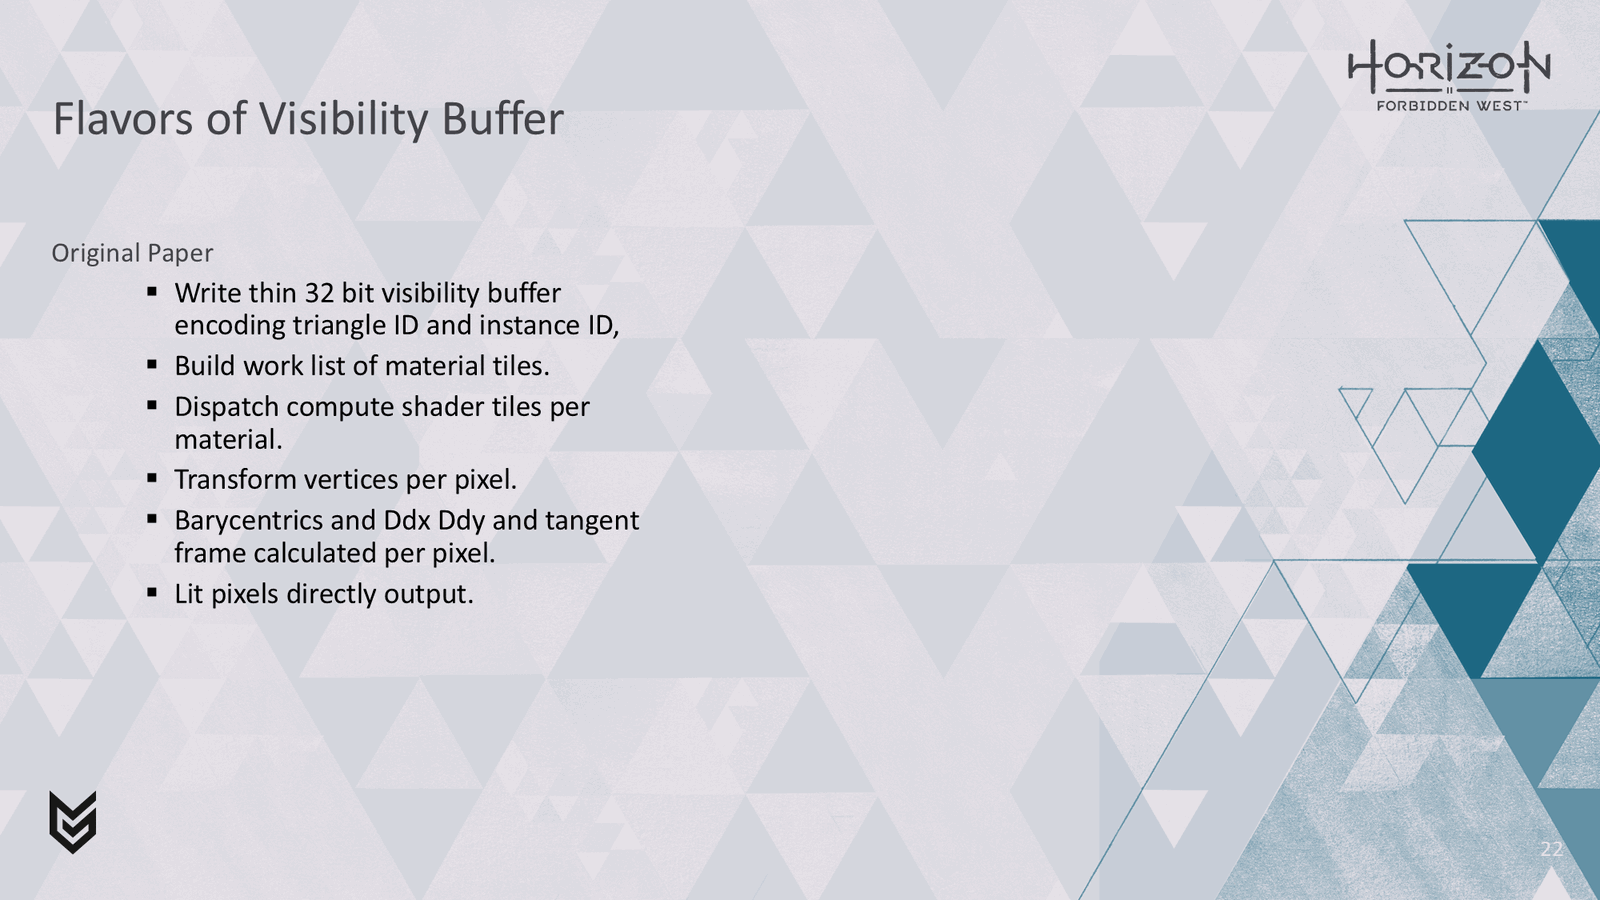
在原始论文中,他们编写了一个简单的可见性缓冲区,其中三角形 ID 和实例 ID 以单个 32 位 uint 编码。 然后他们对此进行一些分析,并构建一组包含每种独特材质的屏幕空间图块。 然后,他们使用间接调度来启动计算着色器来处理他们为每种材质记录的图块集, 读取图元 ID 并用于读取顶点信息,计算重心,并且任何顶点变换工作与像素工作一起完成,因此对每个像素重复进行。 任何属性的导数也会在计算着色器中手动计算,如果需要,计算着色器会处理图块以及切线框架。 最后,阴影和照亮的结果在没有中间 Gbuffer 的情况下被写出,这使得它的带宽非常低。
Slide 23
📌 要点汇总
- 前端数据加载:UV/导数/切线空间等数据在前端打包
- 深度缓冲区滥用:将材质ID复制到深度缓冲区进行着色
- 材质ID深度测试:通过深度测试选择对应材质像素着色
- 四边形限制绘制:用屏幕四边形限制材质对象绘制范围
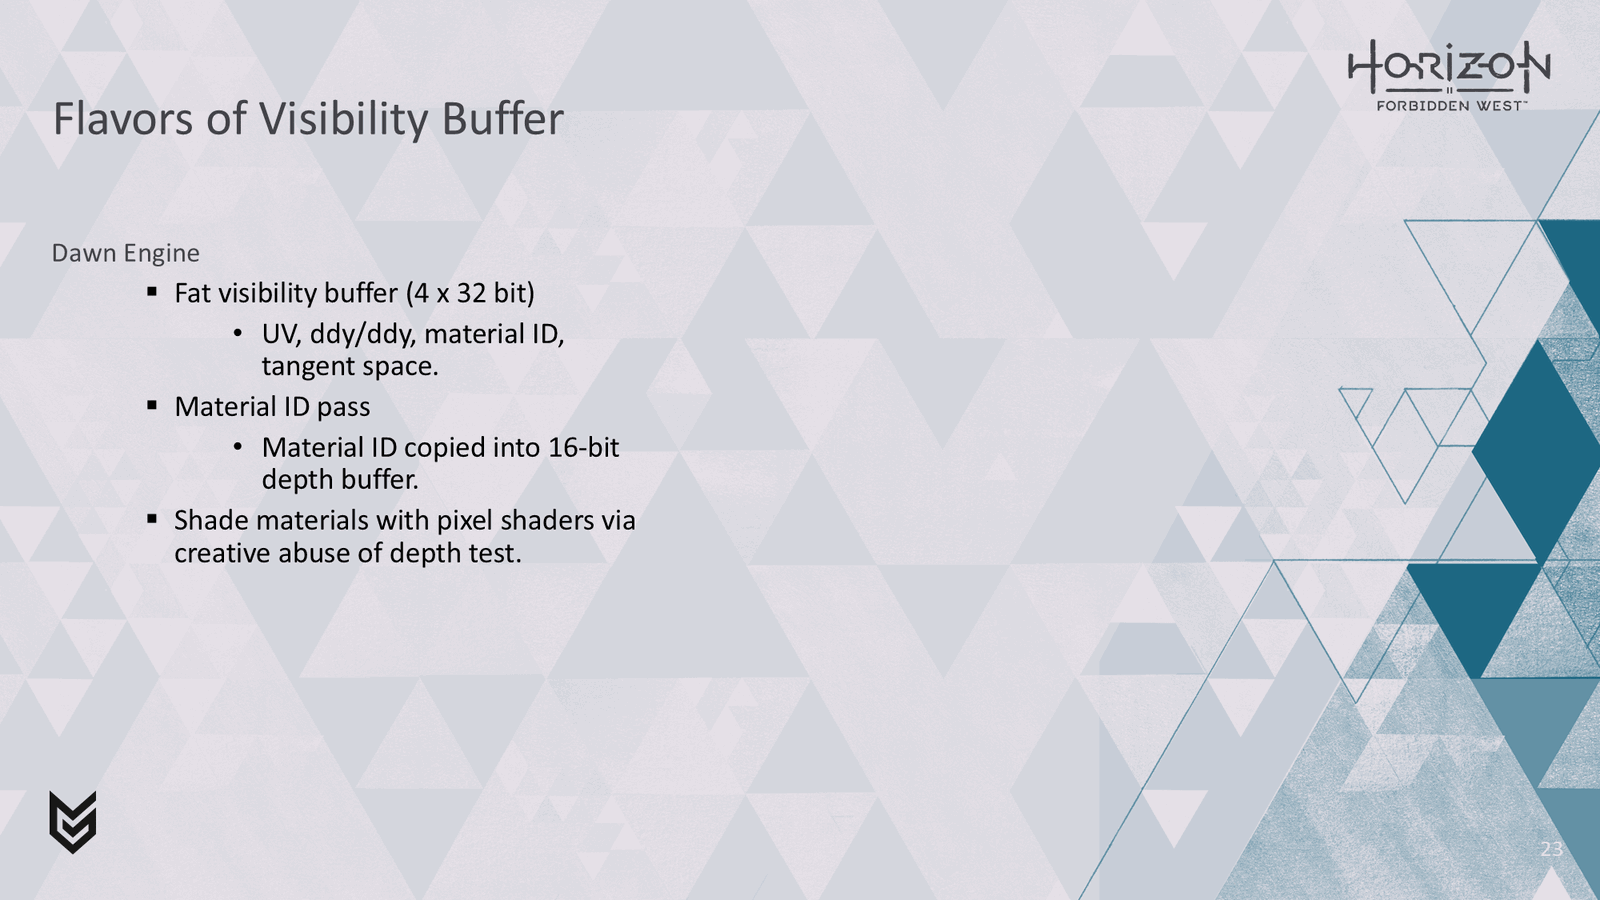
在光谱的另一端,我们有类似黎明引擎的东西 在这里,他们采用了类似的方法,但在解析材质时,不是在后端计算导数、重心和切线框架 ,该工作是前端加载的,因此 UV、导数、材质 ID 和切线空间在放置期间被打包到非常大的可见性缓冲区中。 然后分析可见性缓冲区,并将材质 ID 复制到 16 位深度缓冲区中。 然后,他们使用我所说的“深度缓冲区的创造性滥用”来对每种材质进行着色, 然后,他们使用每个材质 ID 的深度等于测试来选择适当的像素并使用像素着色器对它们进行着色 通过绘制一个屏幕空间四边形来限制使用该材质的所有对象,并将四边形的深度设置为与材质 ID 相同。
Slide 24
📌 要点汇总
- 延迟材质系统:生成材质像素列表并输出重心/ID信息
- Nanite压缩光栅化:使用64位UINT打包簇/三角形信息
- 深度缓冲区变体:采用深度滥用技巧输出GBuffer
- 几何管道优化:对树叶使用双渲染目标编码法线/UV等信息
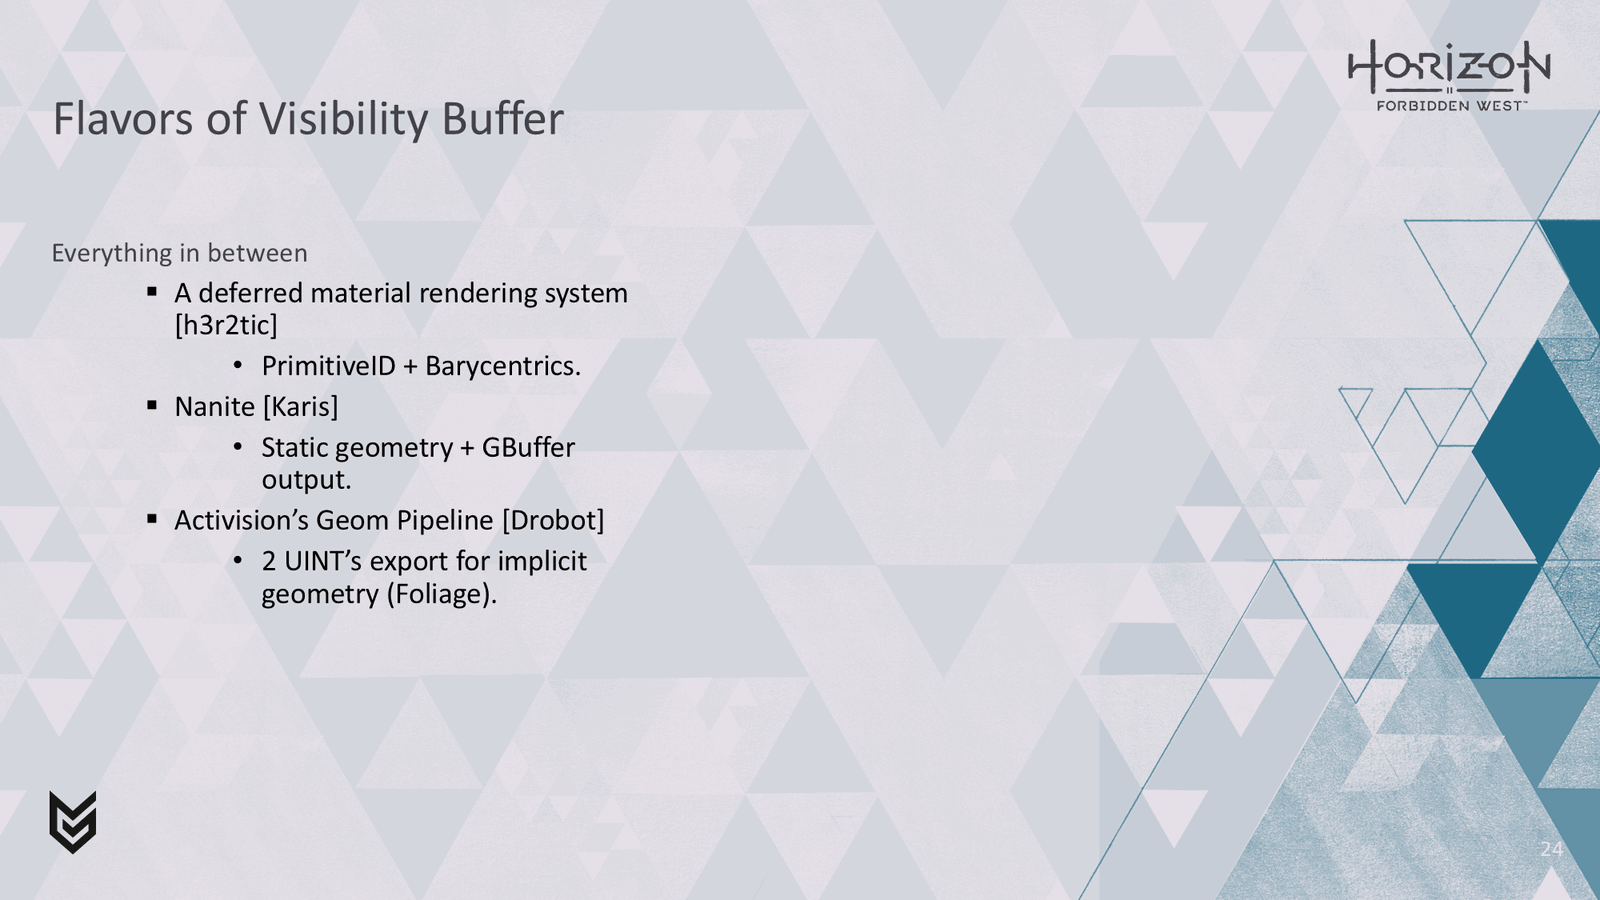
还有一些介于这两者之间的其他变体。 Tomasz Stachowiak 的延迟材质系统通过生成每种材质的像素列表,在计算阴影中写出重心以及原始 ID 和阴影。 最近我们有来自动视的 Nanite 和几何管道 Nanite 使用压缩软件光栅化几何簇,生成相对较薄的可见性缓冲区,其中簇和三角形信息与深度一起打包在 64 位 UINT 中。然后,在解析其材质时,它使用创造性深度缓冲区滥用技巧的变体,通过像素着色器写出 GBuffer。 Activision 的几何管道也适用于几何集群,并为大多数几何体写出薄可见性缓冲区,但对于树叶,它们在两个渲染目标中写出 64 位信息来编码法线、纹理 LOD 和 UV,从而通过限制材质复杂性,将材质解析步骤中所需的工作量降至最低。
- 如果您有兴趣阅读该主题,我也强烈建议您查看 John Hable 的博客文章使用材质图进行可见性缓冲区渲染
Slide 25
📌 要点汇总
- 动态几何支持:必须支持所有动画树叶的动态几何
考虑到建立延迟纹理系统的可能性范围,我们开始研究我们需要它做什么,并试图找出什么适合我们的要求。 我们所有的树叶都是动画的,所以对动态几何的支持是必须的。 我们还为不同类型的树叶提供了几种不同的材质,因此我们需要有效地支持它们之间的切换。 该方法还必须适用于 PS4 和 PS5,因为我们要在这两种平台上发布。 因为我们将在 PS4 上运行,所以无论我们做什么都必须占用很少的内存。我们可以负担得起 10 Mb,而不是 100 Mb。 此外,树叶通常有大量透支,因此可见性缓冲区的放置需要非常便宜,最好只是单个 32 位导出。 我们还希望它能够与其他非延迟纹理几何体很好地集成,因此我们希望它输出到我们的 G 缓冲区。
Slide 26
📌 要点汇总
- 原型方法:初始使用像素着色器并手动修改生成着色器测试延迟纹理
- 方法疑虑:对手动修改着色器的可靠性存在怀疑
- 框架观察:发现渲染级联阴影存在大量顶点工作而非像素工作
现在,在我们的思考过程中,我们也开始审视我们的框架,看看所有这些工作将适合在哪里。
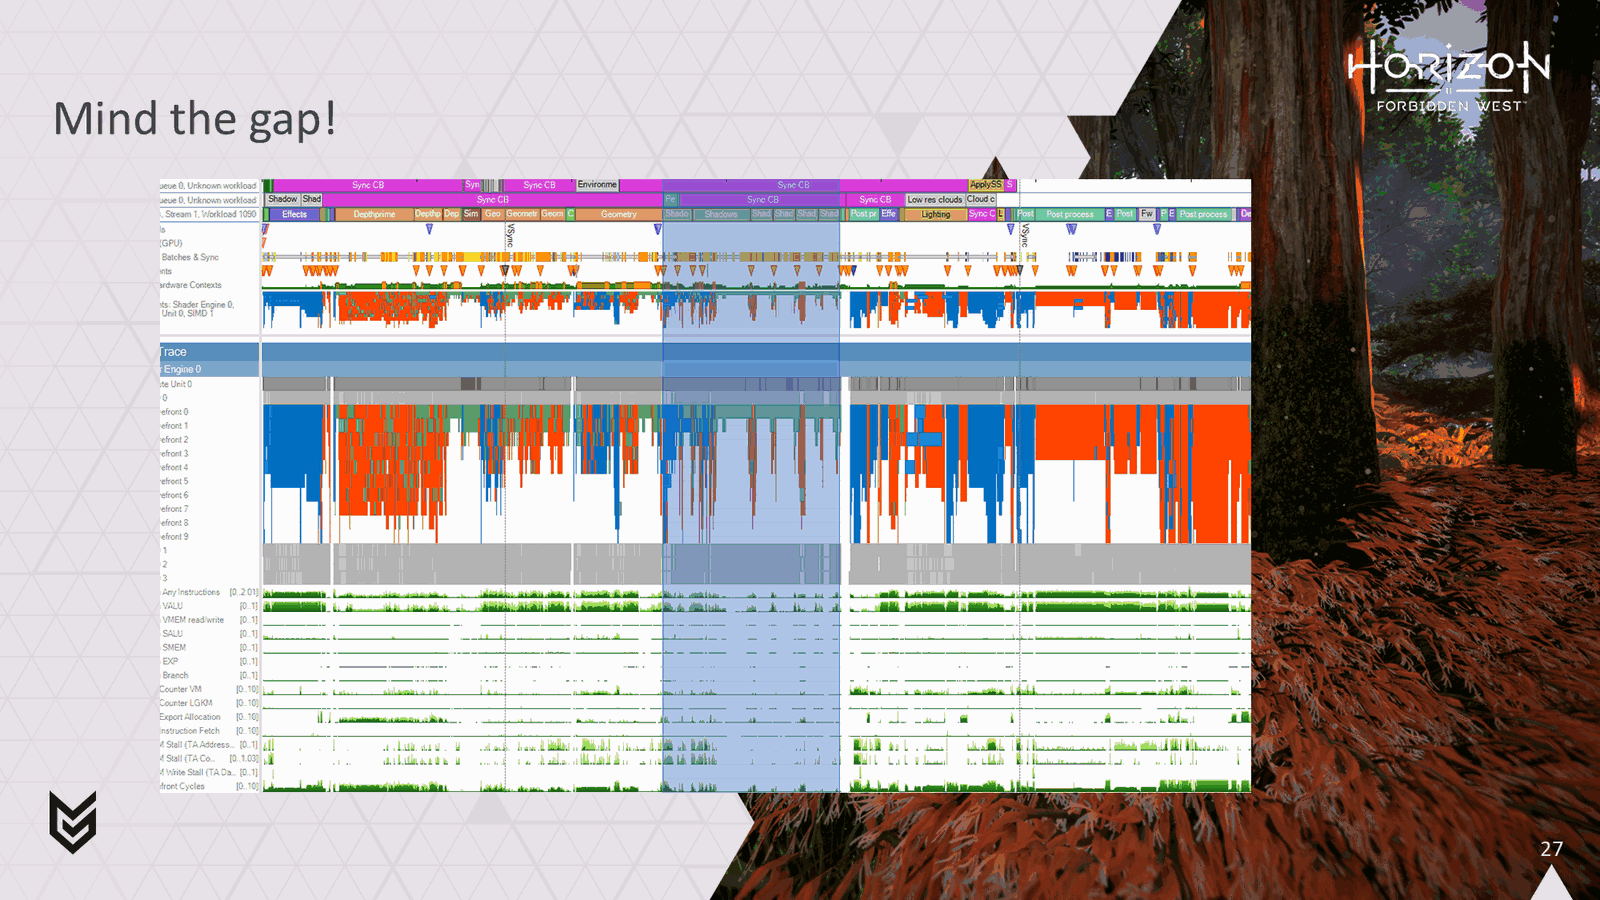
我最初的原型使用了像素着色器。 我通过手动修改一些生成的着色器来开始这个过程,以弄清楚如果我们要使用延迟纹理,它们需要发生什么。 这很有希望,但我并不完全相信这是正确的方法。 无论如何,当我开始查看框架时,我看到的是……
Slide 27
📌 要点汇总
- 性能瓶颈:级联阴影渲染依赖顶点处理而非像素处理
- 技术方案:考虑使用异步计算管道和计算着色器填充G缓冲区
- 遮蔽目标:探索在顶点处理间隙遮蔽树叶材料的可能性
所以,你可以看到我们有一个很好的地方,渲染级联阴影,通常充满了大量的顶点工作,而不是大量的像素工作。 所以,我开始想知道我们是否可以在这个间隙中遮蔽我们的树叶材料? 然而,这意味着我们需要使用异步计算管道来进行着色并使用计算着色器来填充我们的 G 缓冲区。
Slide 28
📌 要点汇总
- 计算着色挑战:简单分块遮蔽方案存在大量无效车道问题
- 可见性缓冲:原始方案依赖硬件识别相同材质四边形打包
- 性能缺陷:未打包四边形导致计算资源浪费比像素着色更严重
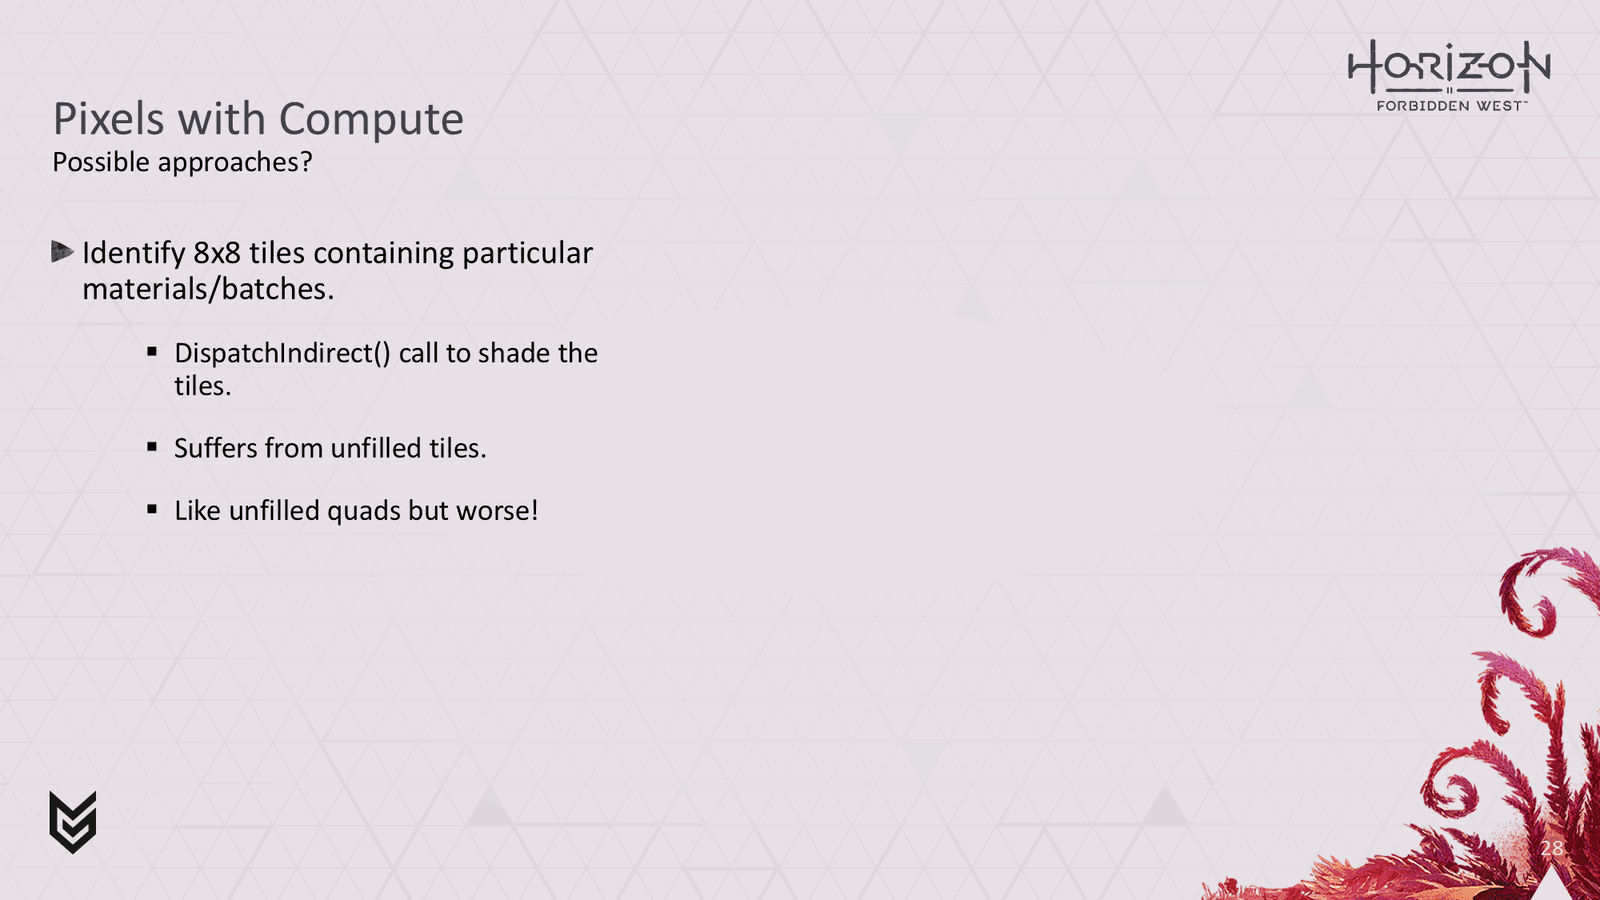
因此,考虑到这一点,我开始思考我们将如何使用计算来进行像素着色 这并不像乍看起来那么简单。 一种简单的天真的方法是尝试识别至少部分覆盖相同材质的小图块,并执行一组对图块列表进行遮蔽的间接调度。 这就是原来的可见性缓冲纸所做的 然而,很明显,如果没有硬件识别相同材料的四边形并将它们打包成波,这将导致每个图块中的大量车道不起作用。 这就像像素着色器在使用小三角形时可能遇到的未填充四边形问题,但实际上更糟糕!
Slide 29
📌 要点汇总
- 像素分组问题:随机处理顺序导致屏幕空间内存重复拉取
- 批次处理限制:混合批次导致L2缓存效率低下
- 调度成本:多批次着色器组合导致计算管道调度开销剧增
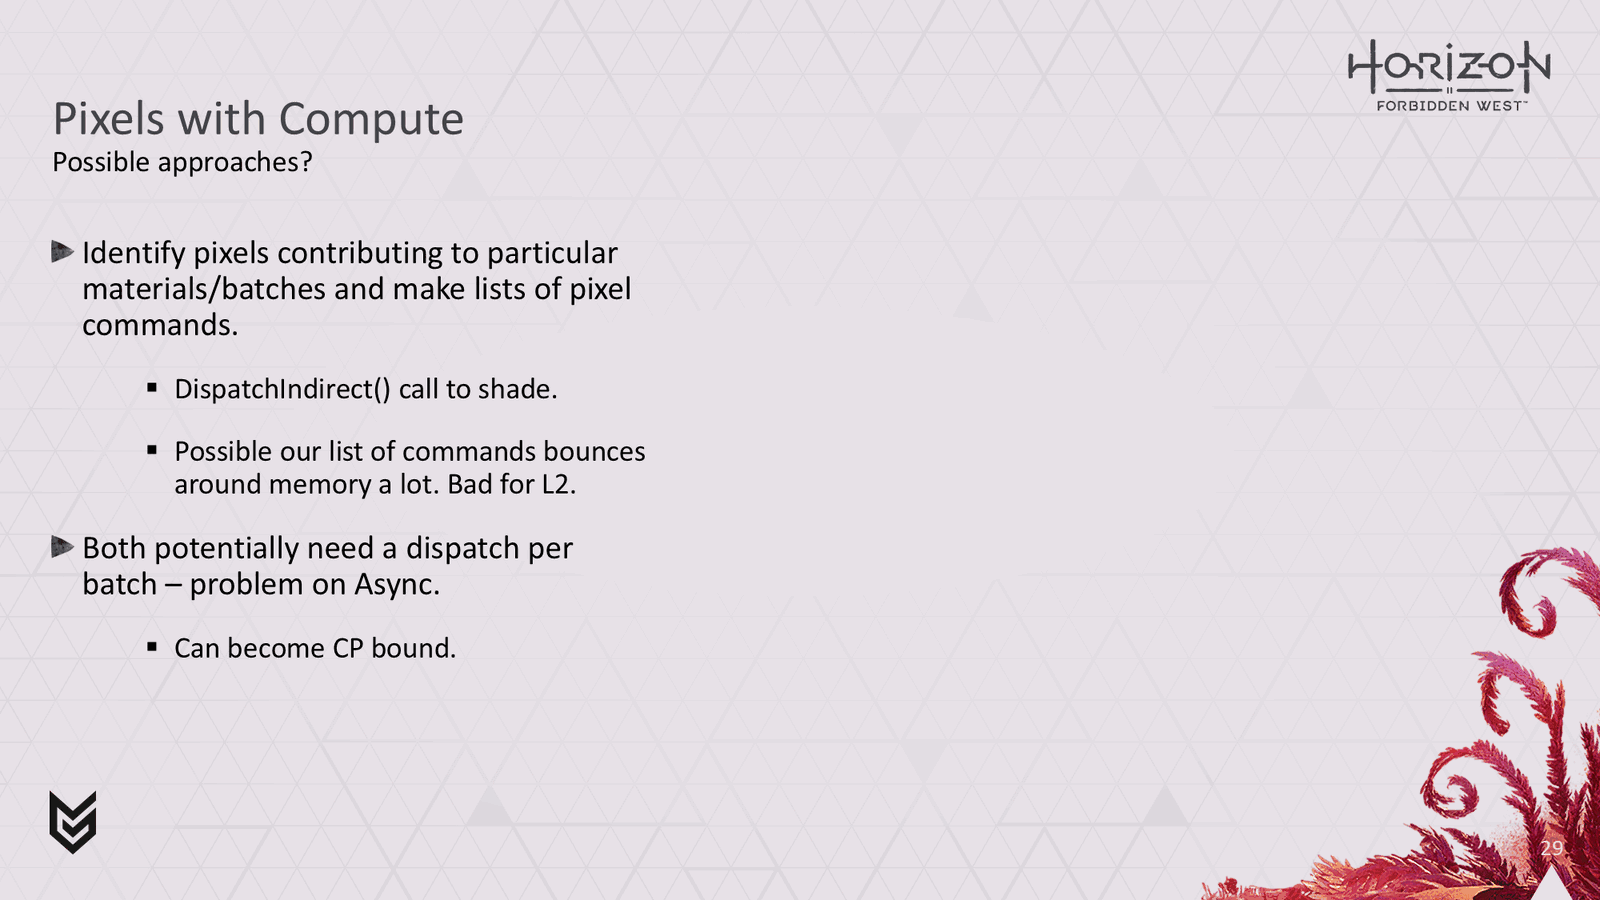
另一个简单的选择是识别相同材质的像素并形成要着色的像素列表。 这是一个更好的选择,但这种方法仍然存在一些问题。 因为我们以有效随机的顺序处理材质,所以我们可以在屏幕空间中多次反弹。 如果我们处理具有相同材质和批次的大组像素,这并不是什么大问题,但对于树叶来说,很容易在同一屏幕空间区域中混合许多批次。 这意味着当我们进行着色时,我们可能会一次又一次地将相同的内存拉入和拉出 L2。 另一个问题是,如果我们有很多批次,每个批次都有自己的着色器、制服和纹理组合,那么它们每个批次都需要单独的调度(当然,除非我们希望允许波中存在分歧)。 如果我们使用计算管道,这也可能变得非常昂贵,因为 CP 处理每次调度的时间可能比 GFX 管道上的处理时间长得多,因此这可能导致我们变得相当受 CP 束缚。
Slide 30
📌 要点汇总
- (无内容):此幻灯片无演讲内容
Slide 31
📌 要点汇总
- 松散平铺方法:结合空间局部性与像素打包灵活性的创新方案
- 图块处理:采用128x128像素大图块进行批量处理
- 波分类机制:按相同着色器但不同常量/纹理的像素分组
- 波命令存储:记录图块、批次及像素命令起始位置
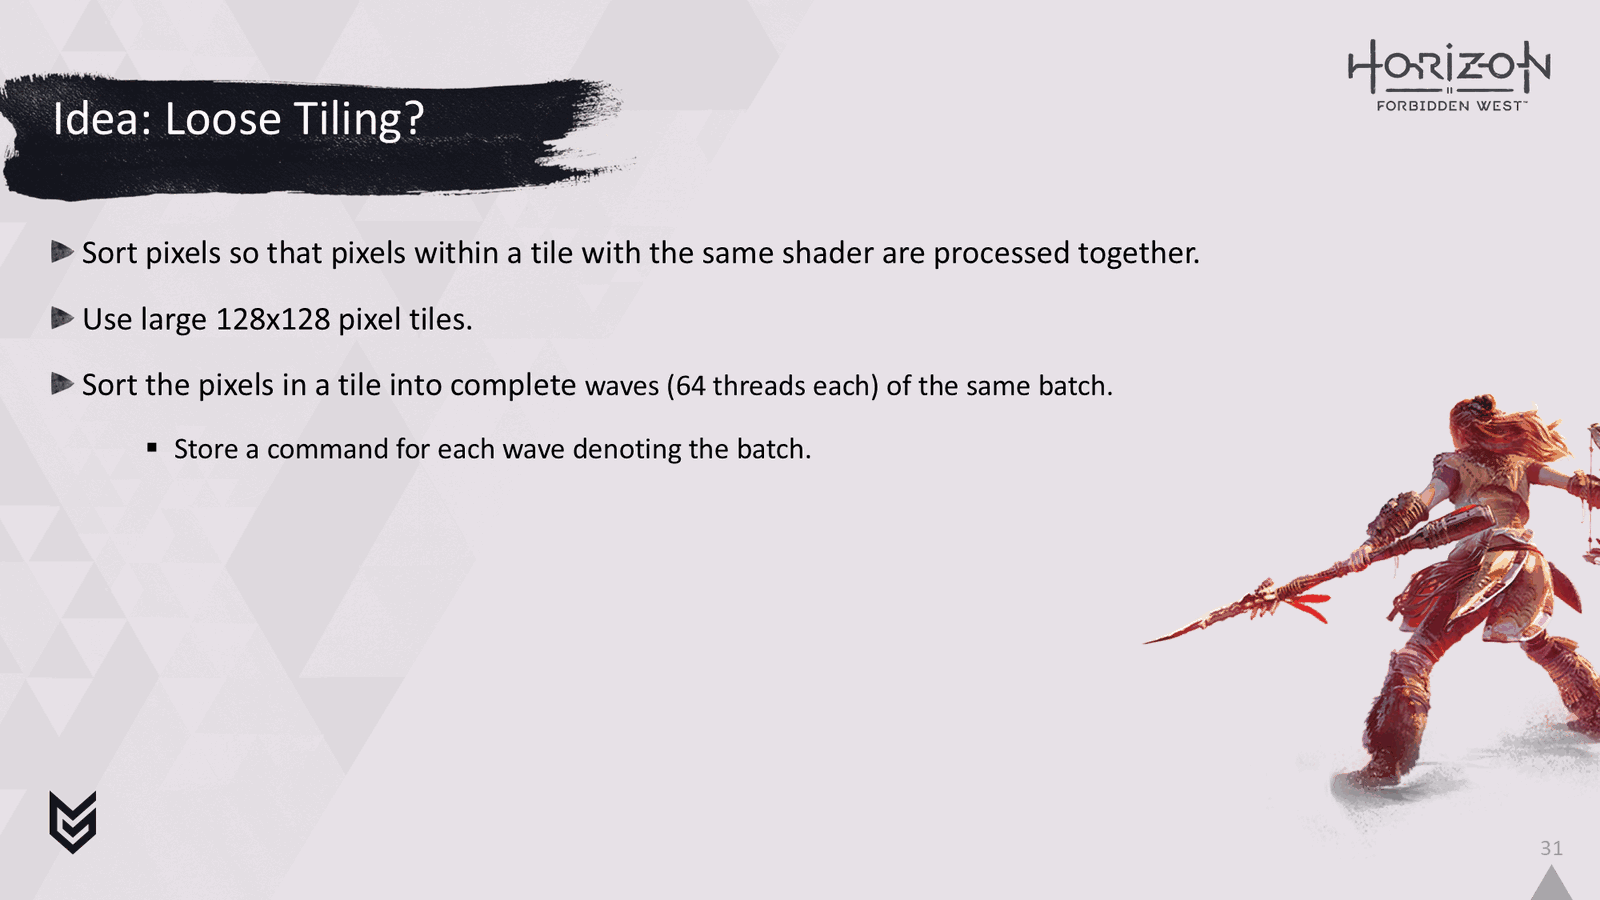
所以本着冒险的精神…… 我们决定尝试将这两种方法结合起来。 我们想要图块具有良好的空间局部性,并且我们想要像素列表的打包灵活性。 我们想出了我所说的“松散平铺”方法。 基本思想是处理 128x128 像素的大图块。 在图块中,我们识别使用相同着色器的像素,但不一定使用相同的常量和纹理。 这意味着它们可以来自不同批次。 然后我们可以将这些像素分类为具有相同常数和纹理的完整波。 除了每个像素的命令之外,我们还为每个波存储一个“波命令”,它告诉我们正在处理的图块、正在处理的批次以及像素命令的开始位置。
Slide 32
📌 要点汇总
- 多批次处理:单个dispatchIndirect()调用可处理多个批次
- 内存局部性:像素命令集中存储提升L2缓存命中率
- 发散避免:相同常量/纹理的完整波消除线程发散
- 波浪舍入:可能产生未填充波浪但影响较小
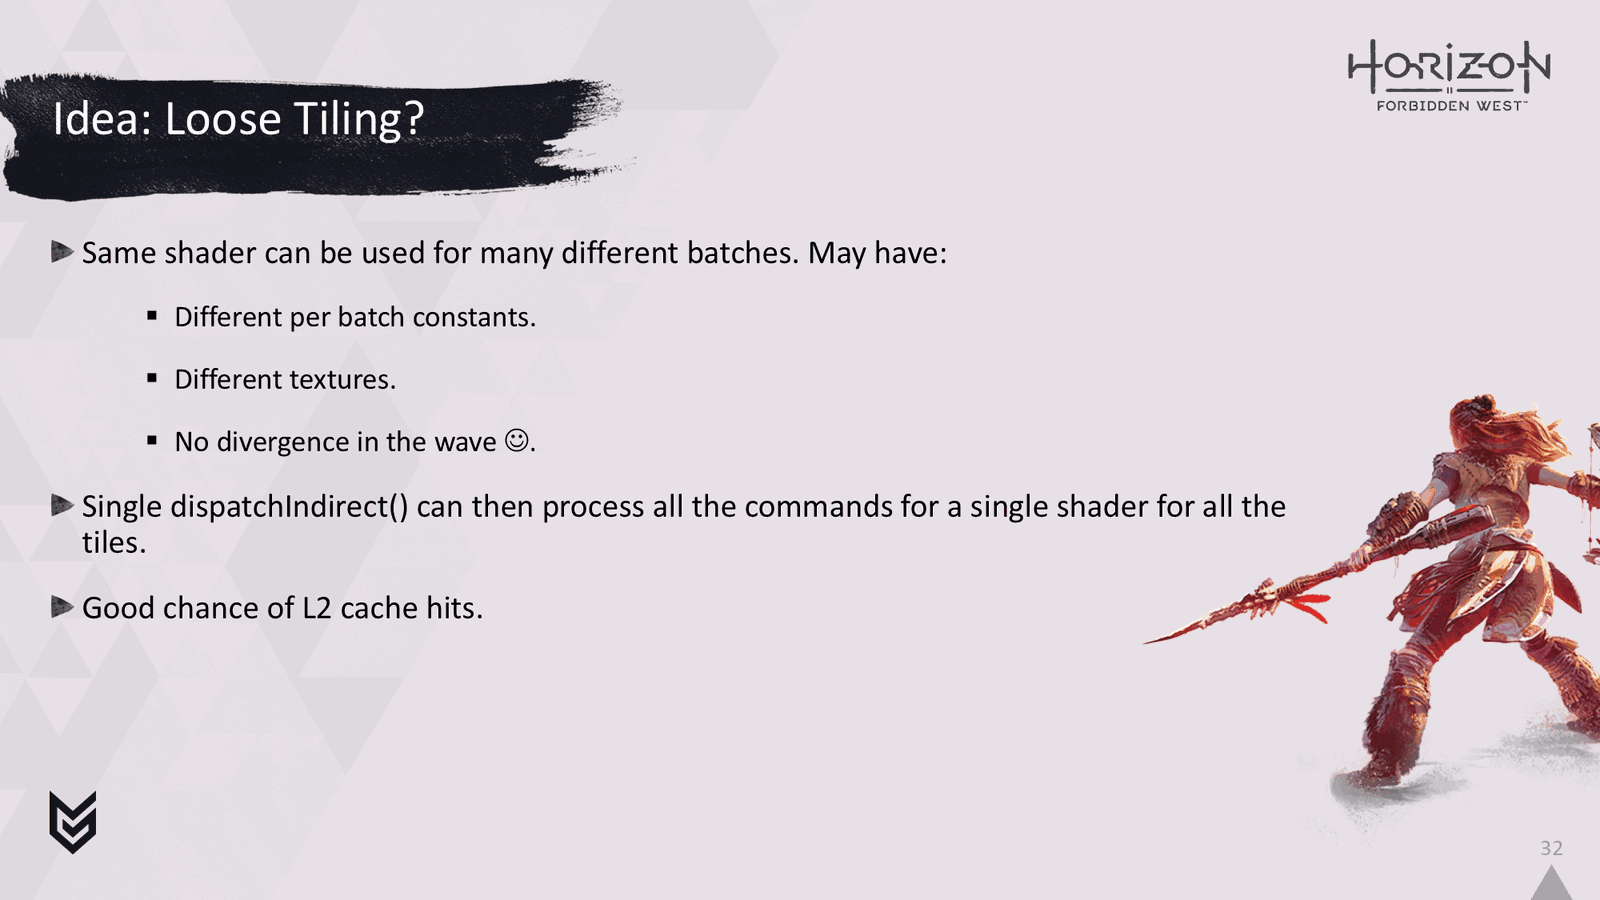
如果我们对屏幕上的所有图块执行此操作,那么对于每个着色器,我们最终可以得到一次处理多个批次的单个dispatchIndirect()调用。 而且因为我们确保每个图块的像素命令存储在一起,所以它们很可能在彼此接近的时间局部性中进行处理,这意味着当它们执行内存请求来填充 Gbuffer 时,内存更有可能仍处于 L2 中。 此外,因为我们正在处理具有相同常数和纹理的完整波,所以我们不必担心发散。 这里有一个小小的警告,我们可能会得到“未填充的波浪”,因为我们必须舍入像素命令以适合特定的图块。然而,实际上这往往是一个非常小的问题。
Slide 33
📌 要点汇总
- 简化示例:16x16图块演示松散平铺概念
- 批次组定义:相同着色器/纹理/几何但不同实例的集合
- 波形组合:8线程波形大小下同批次组像素聚合
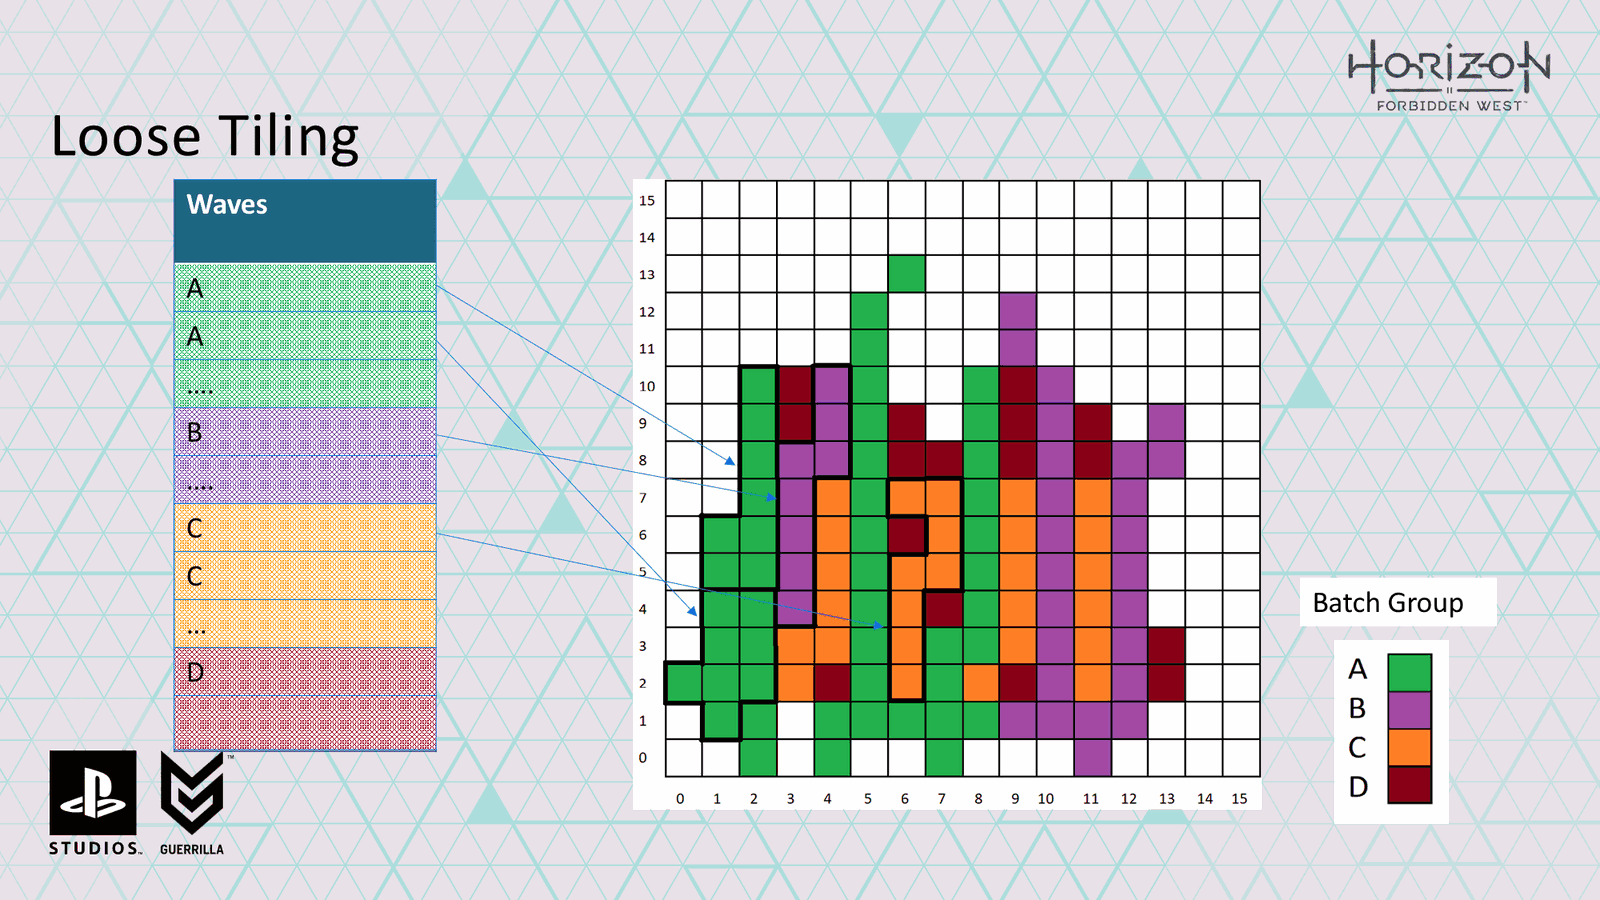
这是实践中这种松散平铺想法的简化示例。 假设这是我们正在渲染的场景中的一个图块。 它只有 16x16 而不是 128x128,但它可以完成工作。 所有彩色像素都使用相同的着色器。 不同的颜色代表来自我们称之为不同批次组的像素。
就我们而言,批处理组是一组具有相同着色器、纹理、常量和几何形状的批处理,但该组中的批处理将具有不同的实例集。 …… 为了这个例子,我们假设我们使用的是一个 GPU,其中一个波形的大小只有 8 个线程。 我们要做的是将来自同一批次组的像素组合在一起,形成波浪。
Slide 34
📌 要点汇总
- 像素命令列表:记录所有需要着色的像素信息
- 着色描述:明确每个像素的渲染参数与位置
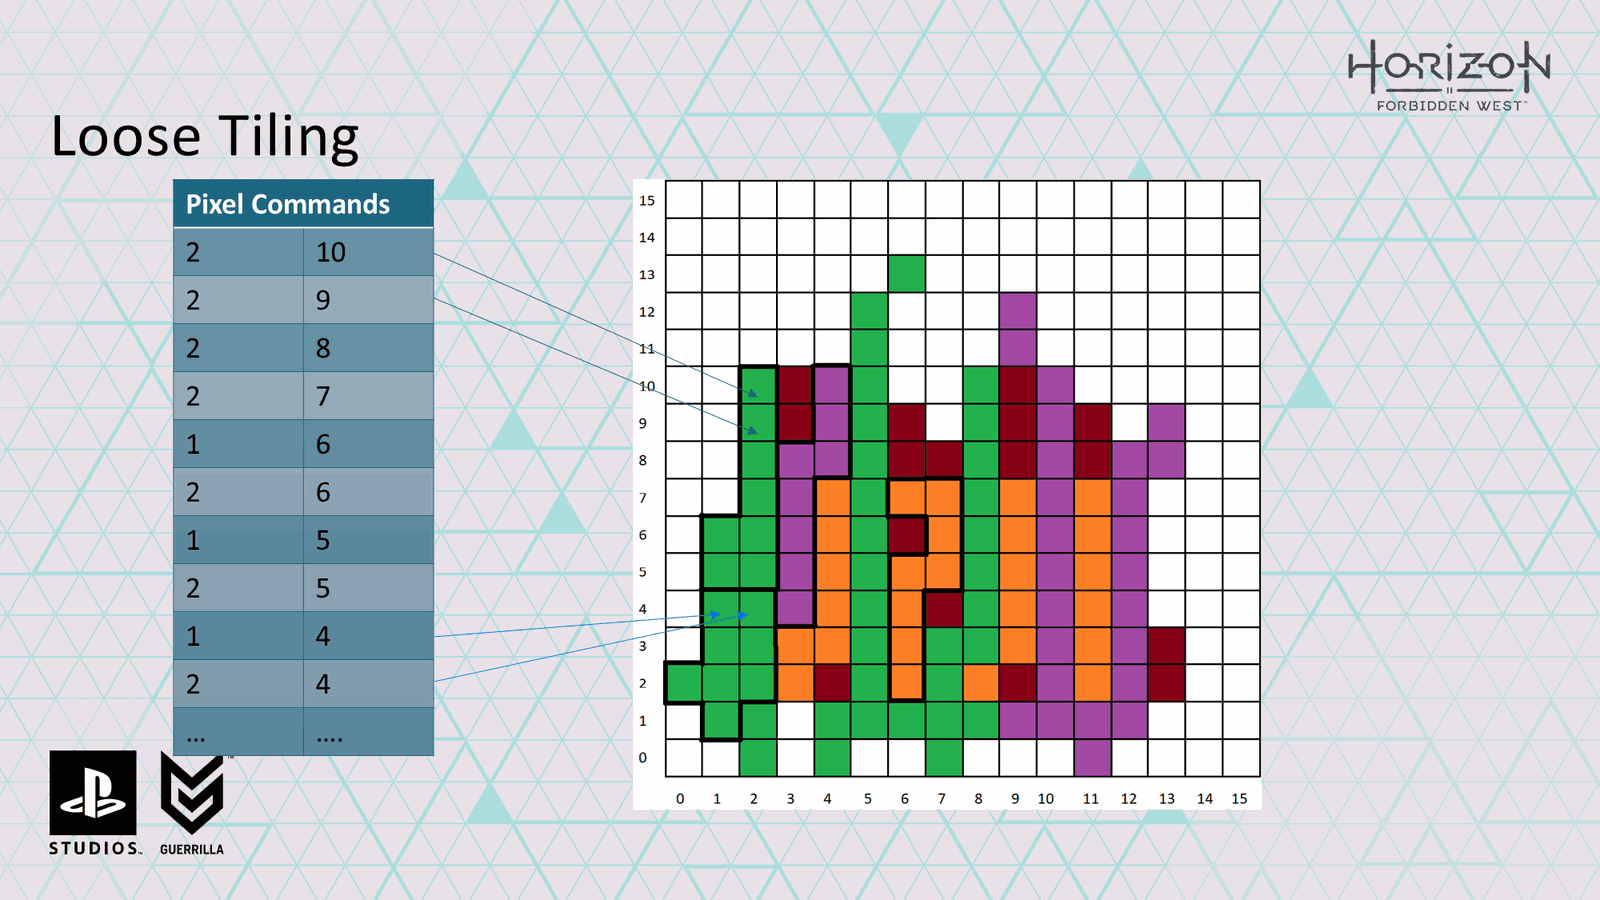
我们还将建立一个像素命令列表,描述要着色的像素。
Slide 35
📌 要点汇总
- 波形命令生成:定义波形处理的批次组及像素命令范围
- 命令关联:建立波形与像素命令的映射关系
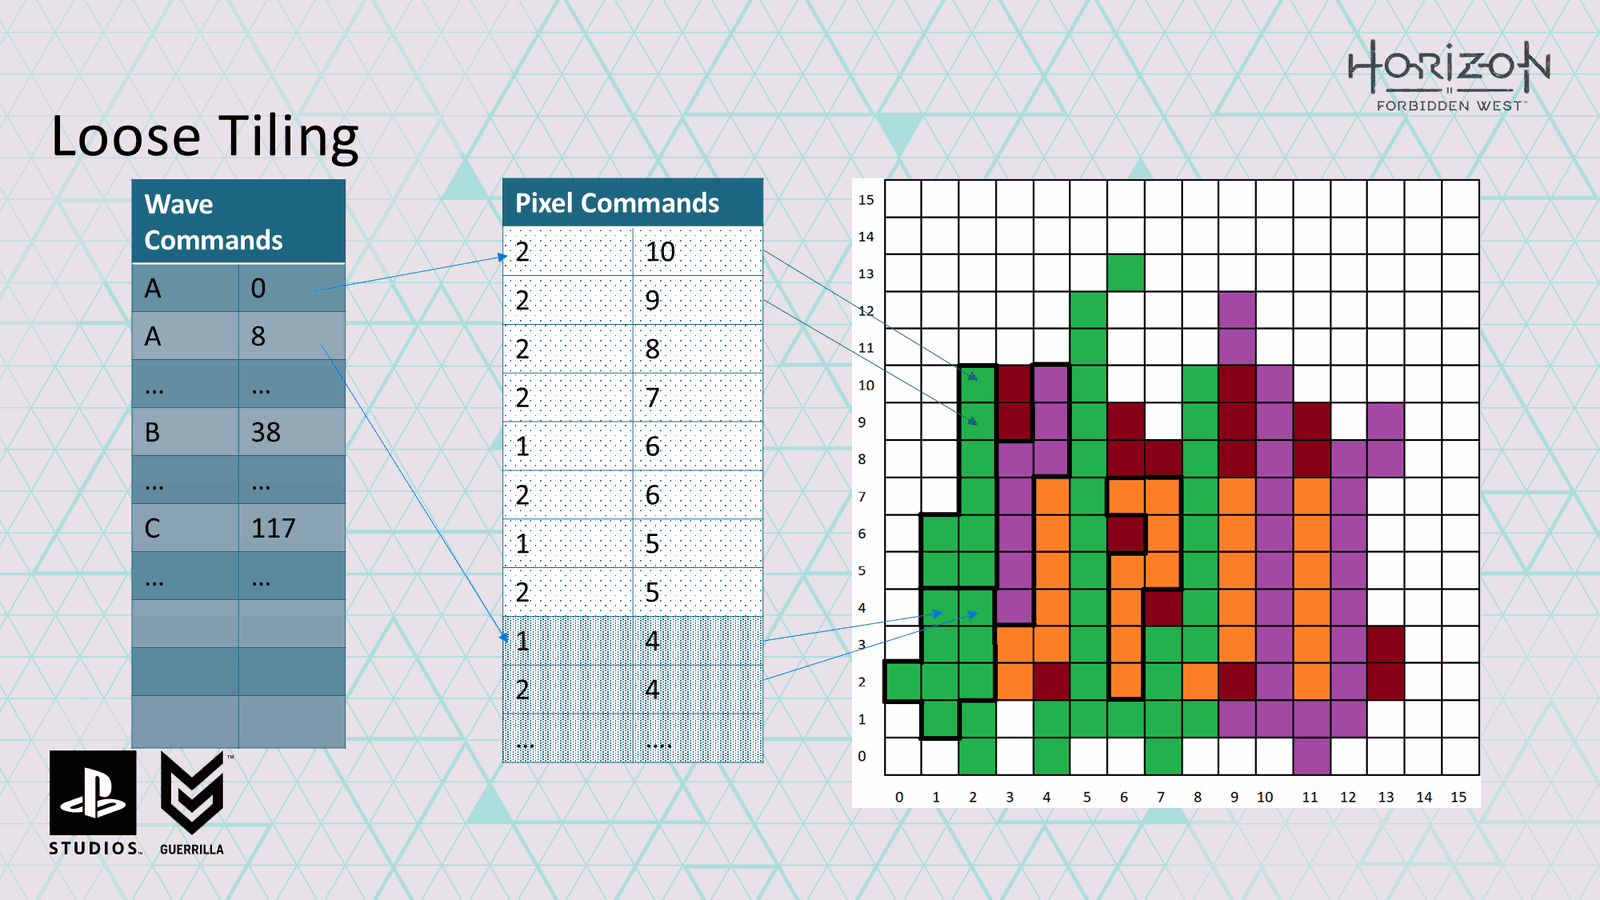
然后生成一组波形命令,定义波形将在哪个批处理组上工作,并且还将指向它的一组像素命令。
Slide 36
📌 要点汇总
- wave命令功能:记录图块信息及像素命令数量,支持多批次着色
- 图块处理机制:通过波形命令实现空间局部性优化,提升缓存性能
- 缓冲区设计:128x128图块对应16位缓冲区,支持四边形编码
- 四边形编码:12位编码四边形,4位标记像素,为可变速率着色预留空间
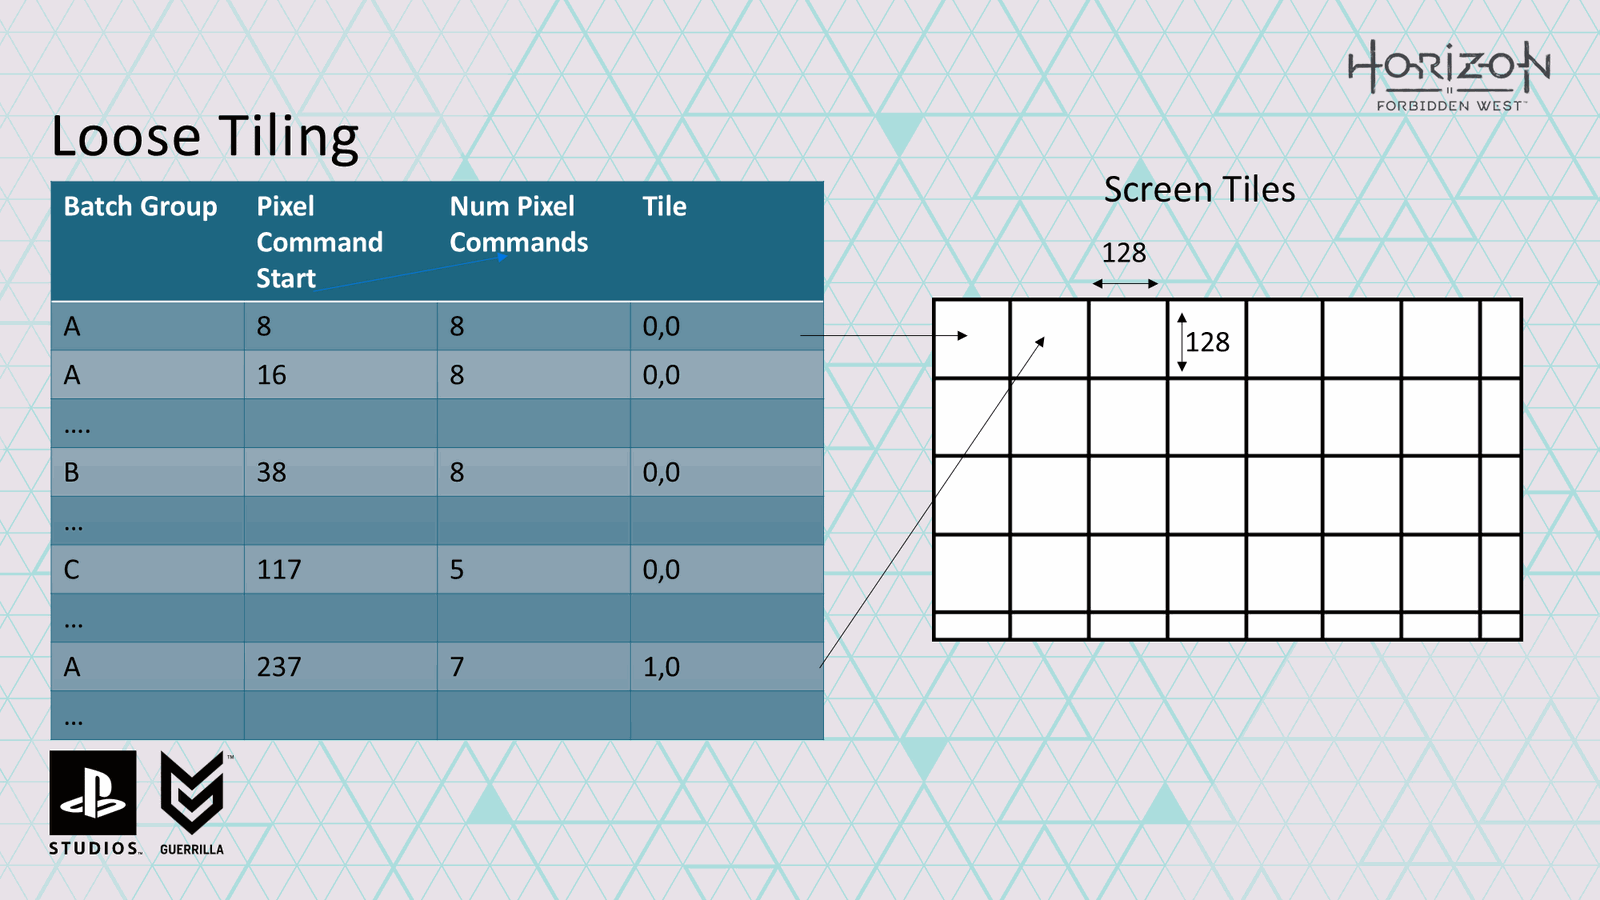
让我们仔细看看wave命令 波形命令还将记录它们所在的图块以及波形应处理的像素命令的数量。 因此,一旦我们为该图块上的特定着色器生成了所有波形和像素命令,我们就可以开始为下一个图块附加命令。 通过这种方式,对于单个着色器,我们可以构建一组波和像素命令,对多个批次进行着色,同时避免任何分歧,并尝试保留空间局部性以获得良好的二级缓存性能。
该方案的一个好处是,由于我们正在使用 128x128 图块,因此我们用于保存像素命令的缓冲区只需为 16 位。
此外,128x128 的图块大小是经过精心选择的,因此如果我们愿意,我们可以使用这 16 位中的 12 位来编码像素四边形,并使用 4 位来编码这些四边形中设置的像素,这在稍后我们讨论可变速率着色时非常重要。
Slide 37
📌 要点汇总
- 顶点处理挑战:PS4大三角形导致像素级顶点变换冗余
- 顶点缓存系统:对象空间缓存减少冗余变换,支持运动向量访问
- 缓存溢出处理:需设计可扩展方案应对有限缓存空间限制
现在我们大致知道如何在计算上处理像素。那么顶点呢? 理论上,我们可以在着色像素时进行变换,就像英特尔最初的论文所做的那样。 然而,特别是在 PS4 上,我们仍在处理相对较大的三角形,这可能会导致大量冗余工作,因为每个像素必须遮蔽 3 个顶点。
从《地平线零之曙光》开始,我们就有了一个对象空间顶点位置的缓存系统,可以帮助我们避免深度等于通道中的大量冗余变换工作,并且还可以轻松访问运动向量的最后一帧的顶点位置。我们本可以尝试在此基础上进行构建,但它的大小有限并且可能会溢出,我们必须能够优雅地处理缓存空间不足的情况。
Slide 38
📌 要点汇总
- 环形缓冲区设计:顶点转换独立管道使用环形缓冲区存储中间结果
- 批次排序机制:按着色器通道分类批次,实现顶点批量变换
- 顶点波命令:驱动顶点转换,指定需处理的顶点块范围
- 处理限制:最大顶点数限制为环形缓冲区容量的1/2
因此,我们所做的是将顶点转换为单独计算管道上的环形缓冲区,同时仍然使用顶点缓存。 为了使这种方法发挥作用,我们需要将 baches 排序为具有相同着色器的通道,并一次性为该通道变换顶点。 为了驱动它并传递有关要着色的顶点的信息,我们还需要生成顶点波命令,它告诉我们需要着色的顶点块。 当我们这样做时,我们的像素计算着色器可能会消耗之前通道的顶点。 因为我们总是希望能够以这种方式重叠事物,所以我们将一次处理的最大顶点数限制为环形缓冲区大小的 1/2。 这个环形缓冲区在 PS4 上为 12mb,在 PS5 上为 24mb。
Slide 39
📌 要点汇总
- 系统流程概述:CPU分类批次→生成可见性缓冲区→驱动像素/顶点着色
- 可见性缓冲区:32位编码三角形信息,支持后续命令生成
- 双管道协同:像素侧与计算管道并行处理,利用环形缓冲区内存
- 可变速率着色:最终阶段引入动态着色优化技术
那么,让我们快速了解一下系统的外观。 首先,我们需要一些 CPU 工作来将批次按材料分类为通道。 然后我们将填充一个薄的 32 位可见性缓冲区来编码有关我们想要着色的三角形的信息。 之后,我们将分析可见性缓冲区并对其进行一些分类,以生成像素和像素波命令来驱动像素侧的着色 ,以及顶点波命令来驱动单独计算管道上的顶点转换,该计算管道将在被我们的像素工作消耗之前使用环形缓冲区反弹内存。 最后,我们将添加一点可变速率着色魔法,以尝试从事物中挤出更多东西。
Slide 40
📌 要点汇总
- (无内容):此幻灯
Slide 41
📌 要点汇总
- 场景图优化:通过高度优化场景图确定每帧绘制内容
- 遮挡剔除:场景图执行遮挡剔除生成可见性列表
- 批次定义:批次包含相同着色器/几何体的实例集合
- 动态变化:帧间批次可能因剔除/合并而变化
在进一步讨论之前,我想简要描述一下 Decima 引擎的输入。 在 Decima 中,我们查询高度优化的场景图以确定每帧需要绘制什么。 场景图对当前帧执行遮挡剔除,并生成一个可见性列表,其中包含打包成批次的可见对象的实例,每个批次包含 1 个或多个实例。 场景图中的批次通常将渲染为单个绘制调用,因此其中的所有实例将共享相同的着色器、几何体和纹理,但每个实例的某些参数可能会有所不同。 当我们四处移动时,批次不一定从帧到帧一致,因为我们最终可能会剔除不同的实例,并且批次也可以在场景图查询内部合并。
这可能看起来是简单显而易见的事情,但我认为在我详细介绍我们为避免混淆而所做的更多细节之前,我认为值得在这里大声疾呼,因为我们稍后会回来讨论批次。
Slide 42
📌 要点汇总
- 批次排序:按着色器哈希值和Morton代码排序
- 通道拆分:将批次拆分为不同渲染通道
- 树叶系统:程序化树叶生成大量实例批次
- 顶点限制:环形缓冲区无法容纳大量顶点数据
因此,在开始在 GPU 上渲染之前,我们根据着色器的哈希值、每批数据以及其位置的量化 Morton 代码对 CPU 上的批次进行排序,并将它们拆分为通道。
不过,我们确实对这种方法存在一些问题。 主要的一点是我们有一个程序化的树叶放置系统,可以放置世界上大部分的树叶。 这通常可以创建包含数百个实例的批次。 如果每个实例都使用大量顶点,那么我们就会遇到麻烦,因为我们无法在环形缓冲区中容纳所有顶点,更不用说一半了!
Slide 43
📌 要点汇总
- 几何限制:强制使用16位索引和64k基元
- 微批次划分:将大批次拆分为64k三角形微批次
- 实例范围:微批次包含1-64k实例
- 多阶段处理:原始批次可能被多次拆分处理
为了解决这个问题,我们首先对几何体的大小设置一些合理的限制,让所有单独的几何体位都使用 16 位索引和最多 64k 基元。 这会阻止几何体的各个位需要太多的环形缓冲区空间。 然后我们必须将从放置系统获得的批次分成可管理的部分,我们称之为微批次。 每个微批次最多有 64k 个三角形,并包含 1 到 64k 个实例。 然后,我们通过微批次而不是批次进行传递。 因此,如果一个批次包含太多顶点而无法容纳,那么它将被分解为多个微批次。 这意味着我们收到的原始批次最终可能会经过多次处理。
Slide 44
📌 要点汇总
- 信息表创建:为每个微批次生成MicroBatchInfoTable
- 信息存储:记录顶点数、实例起始位置等信息
- GPU缓冲区:信息表存储在GPU可访问缓冲区
- 着色使用:着色过程通过表恢复微批次信息
对于我们生产的每个微批次,我们都会在所谓的 MicroBatchInfoTable 表中填写一个条目。 其中包含有关微批次的信息,例如它的几何体使用了多少个顶点、它开始于批次的哪个实例以及它属于哪个通道。 它被放置在 GPU 可访问的缓冲区中,然后可以在着色过程中使用它来恢复有关我们正在着色的微批次的信息。
<也许在继续之前先看看奖励幻灯片 108……>
Slide 45
📌 要点汇总
- 流程概述:批次经排序
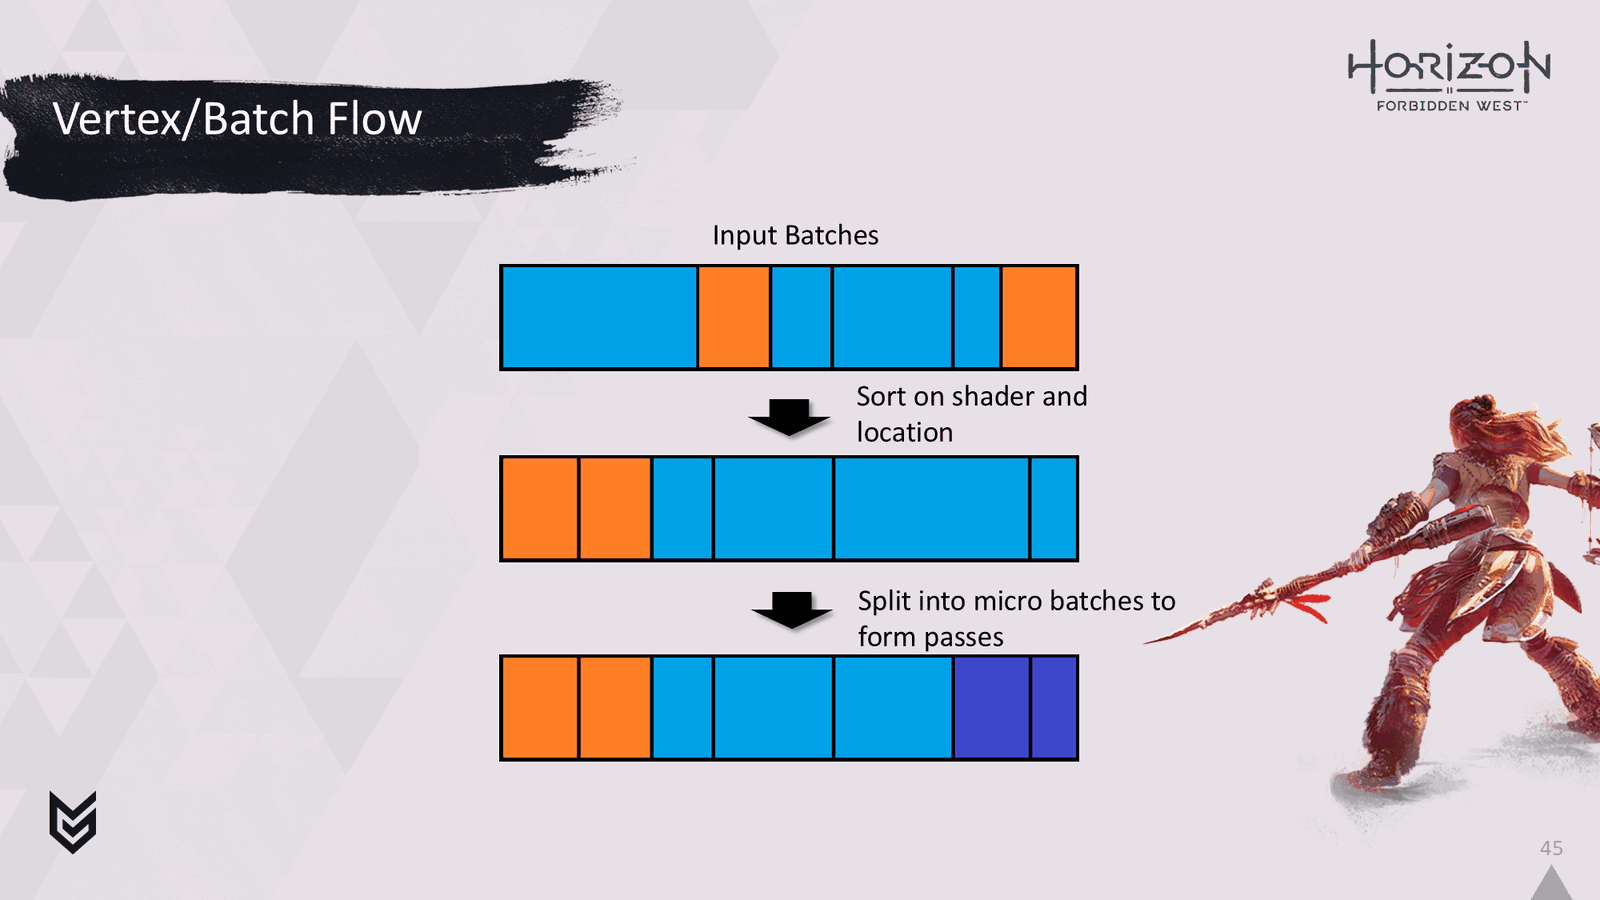
所以在这里你可以看到批次的大致流程。 它们在着色器上排序, 然后分成微批次以形成通道。
Slide 46
📌 要点汇总
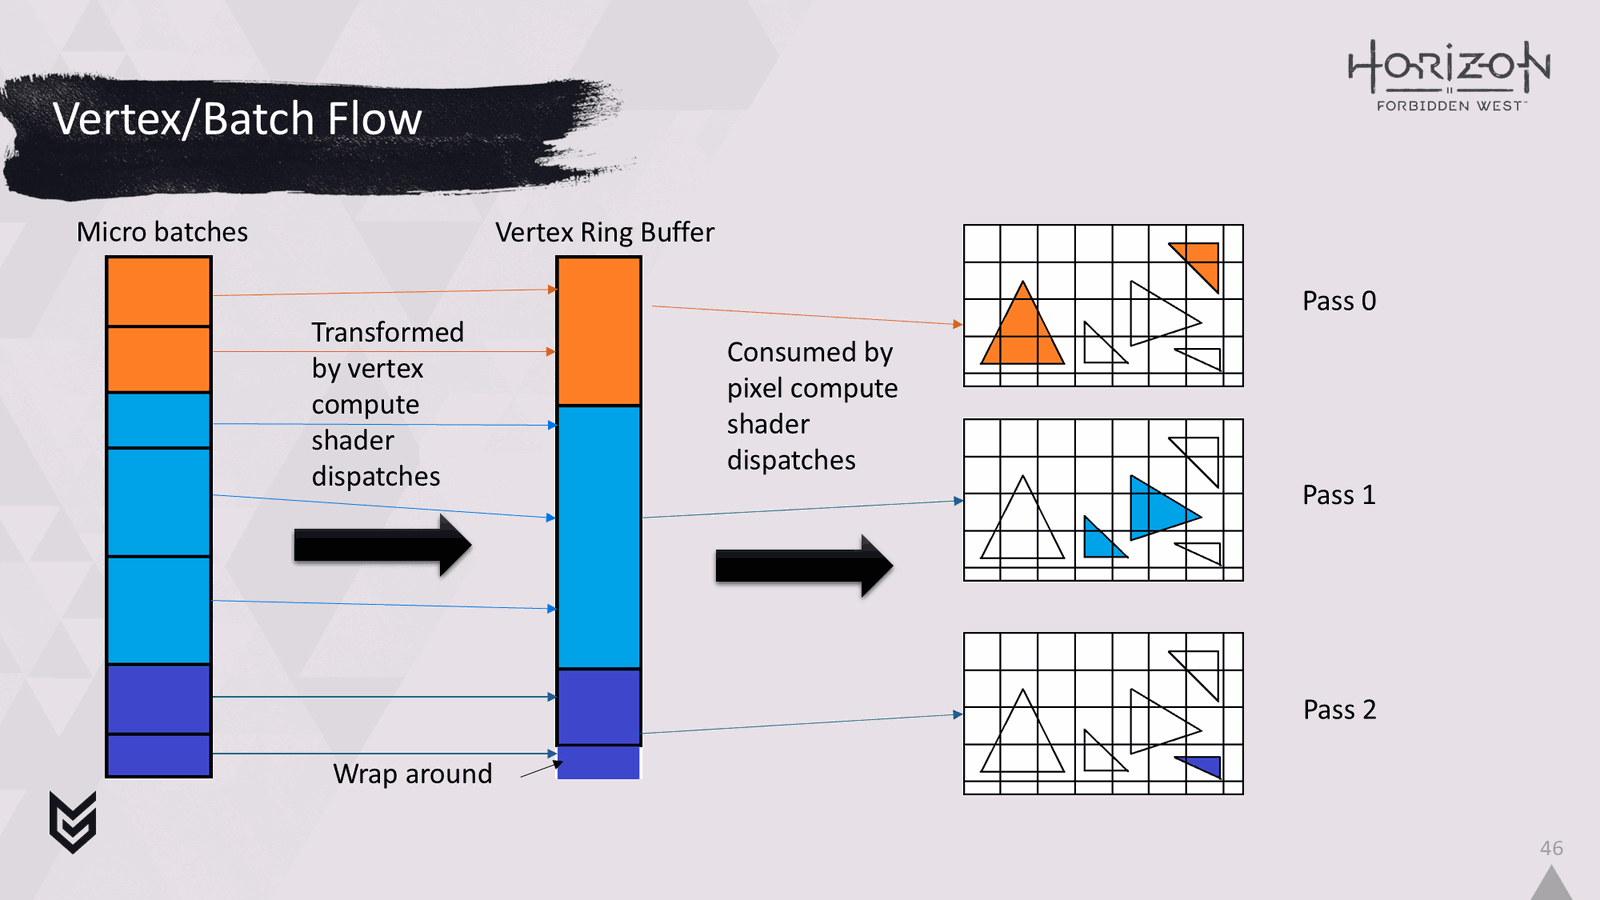
- 微批次转换:顶点计算着色器将微批次转为环形缓冲区
- 像素着色器消耗:每个通道的像素着色器处理变换后的顶点数据
然后,微批次将由顶点计算着色器转换为环形缓冲区 这些变换后的顶点将被与每个通道关联的像素计算着色器消耗。
Slide 47
📌 要点汇总
- CPU设置概述:需了解CPU端可见性缓冲区的构建方法
- 可见性缓冲区:核心在于可见性信息的生成与优化策略
好的,现在您希望对我们在 CPU 上的设置工作有一个高层次的了解。让我深入探讨一下我们如何制定可见性缓冲区。
Slide 48
📌 要点汇总
- 深度预通道增强:通过附加深度/可见性通道扩展原有功能
- 32位基元ID:需记录三角形/实例/批次的完整信息
- PS4 Base限制:专用硬件方案不兼容PS4 Base平台
Decima 已经有一个深度预通道,因此我们通过写入可见性缓冲区和深度缓冲区的附加深度和可见性通道来增强它。 对于每个像素,此过程需要以 32 位基元 ID 的形式写出有关三角形、实例和批次的信息。 理论上,我们可以使用 PS4 Pro 和 PS5 中的专用硬件来实现此目的,但不幸的是,这会使 PS4 Base 受到冷落,因为它没有正确的方法来在不使用几何着色器的情况下获取图元 Id。
Slide 49
📌 要点汇总
- XOR编码方案:通过3顶点值组合唯一重建基元ID
- 顶点顺序无关:仅依赖有效负载组合而非顶点顺序
- 附加索引机制:需根据编码需求新增索引数据
最初的计划是在三角形索引的前 16 位中对图元 ID 进行编码,然后在像素着色器中读取激发顶点,以从顶点着色器传递图元 ID,但在开发早期,我们遇到了硬件旋转顶点的问题。 我相信现在有一个解决方法,但是,我们最终使用了完全避免此问题的解决方案。 如果我们使用 XOR,我们可以从我们在 3 个顶点中的每一个中编码的 3 个值唯一地重建一个基元 ID。 通过这个方案,我们不关心顶点的顺序,只关心它们的有效负载的组合。
*这也要求我们引入附加索引,但不会比我们在激发顶点方案中必须引入的索引更多。 因此,现在当我们预处理网格时,我们根据要编码的图元 Id 以及我们已经在其他索引中编码的数据来确定要在激发顶点索引中存储哪些数据。 如果所有指数都已经确定了数据,那么我们必须添加一个新的指数。
Slide 50
📌 要点汇总
- ID组合生成:像素着色器整合微批次/基元/实例ID
- 可变位数编码:基元ID位数根据几何复杂度动态调整
- 缓冲区构建:最终生成包含完整可见性信息的缓冲区
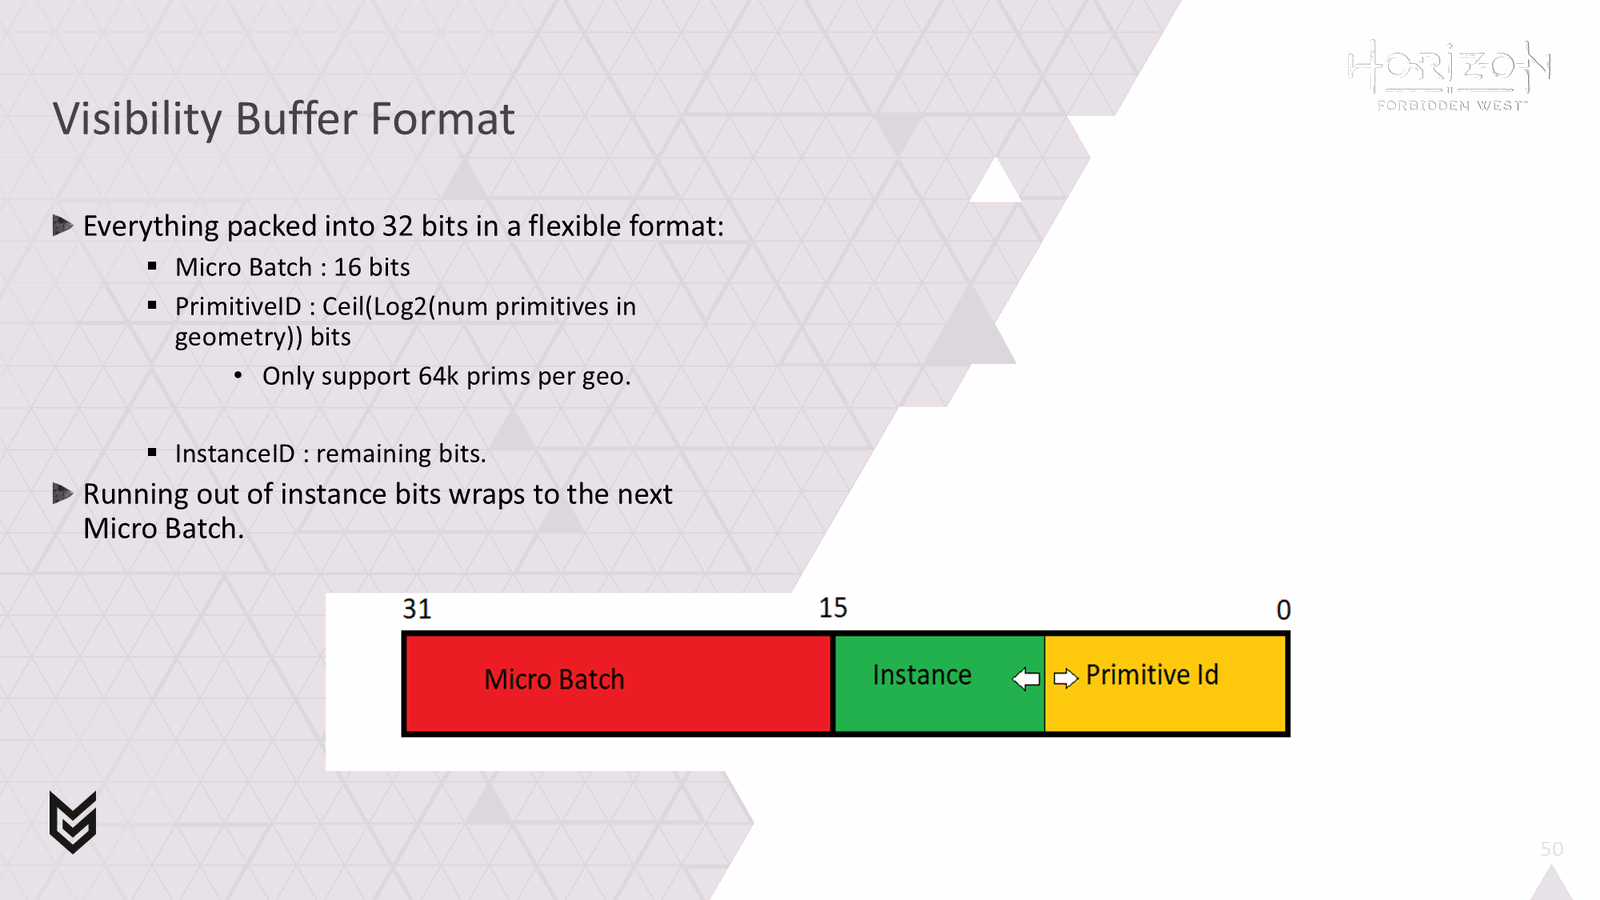
然后,在像素着色器中,我们可以将重建的图元 Id 与 Micro Batch ID 和实例 ID 结合起来,以生成可见性缓冲区。 前 16 位编码微批次 ID。 我们使用可变的位数来编码基元 ID,具体取决于我们正在渲染的几何图形中有多少基元。 其余位用于实例 ID。
Slide 51
📌 要点汇总
- 可见性缓冲区处理:完成可见性缓冲区释放后需进行分类处理
- 分类目的:识别需要着色的顶点和像素
- 技术阶段:进入分类处理流程
好的,现在我们已经成功地放下了可见性缓冲区。 接下来,我们需要对其进行一些分类,以找出需要着色的顶点和像素。
Slide 52
📌 要点汇总
- 分类三阶段:布局最终确定/中间分类/分类输出
- 流程划分:明确分类处理的三个技术阶段
- 阶段命名:定义分类处理的关键技术节点
我们将分类分为三个阶段。 布局最终确定、中间分类和分类输出
Slide 53
📌 要点汇总
- 最终确定阶段:读取可见性缓冲区生成批次组掩码
- 模板缓冲区:用模板位标记可见性缓冲区有效性
- 无人机写入:通过无人机避免透支成本写入模板位
- 几何覆盖:几何通道覆盖模板位确保数据有效性
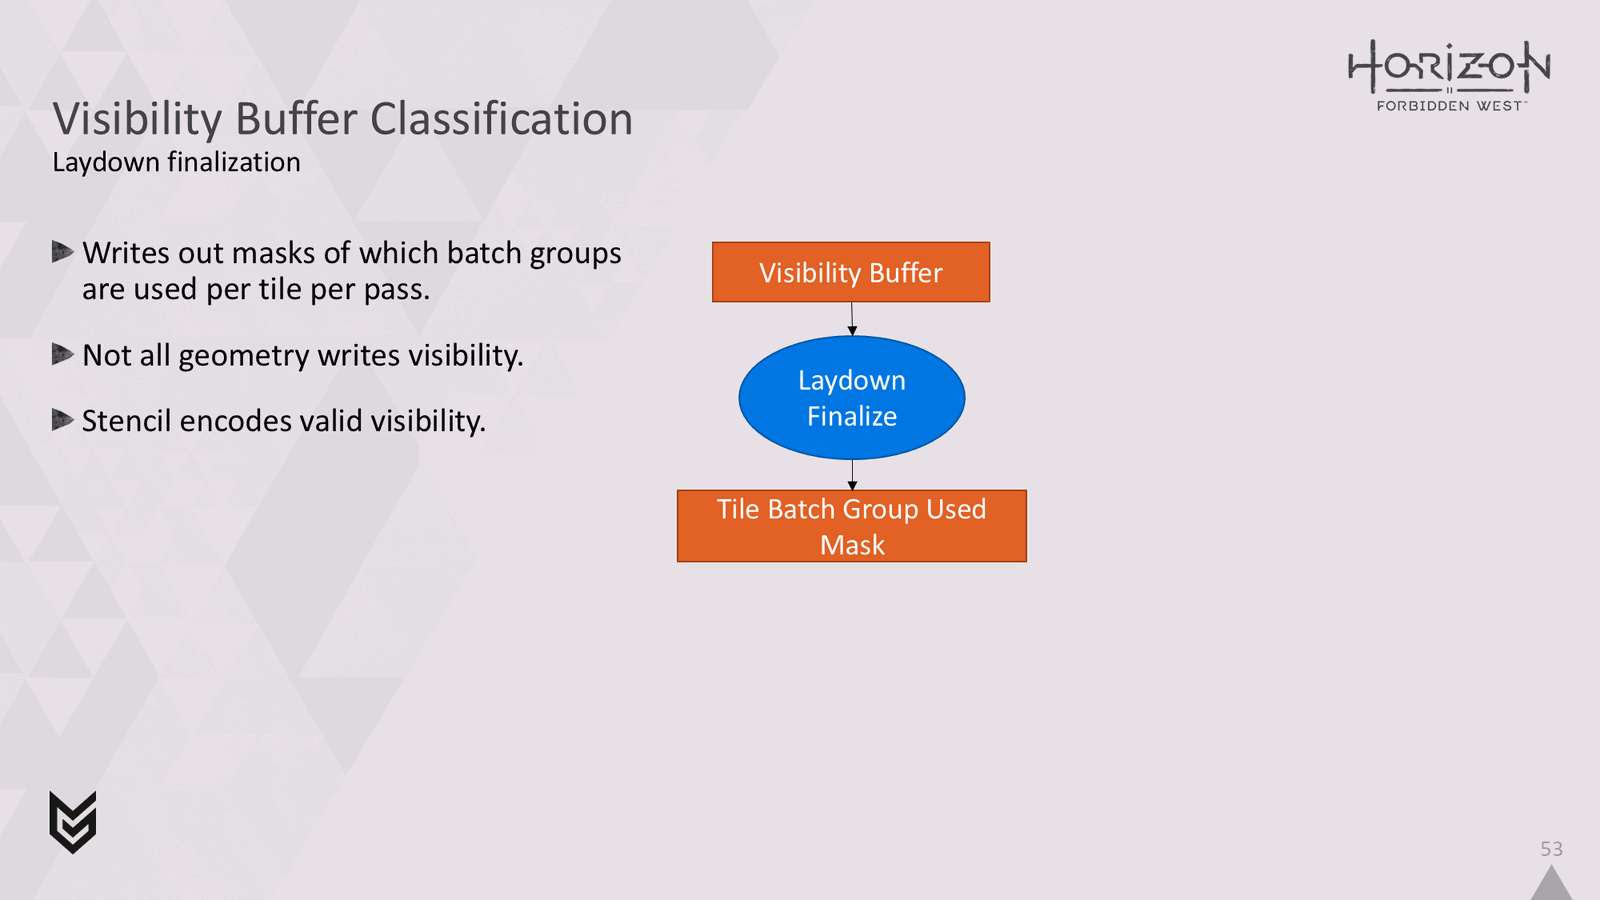
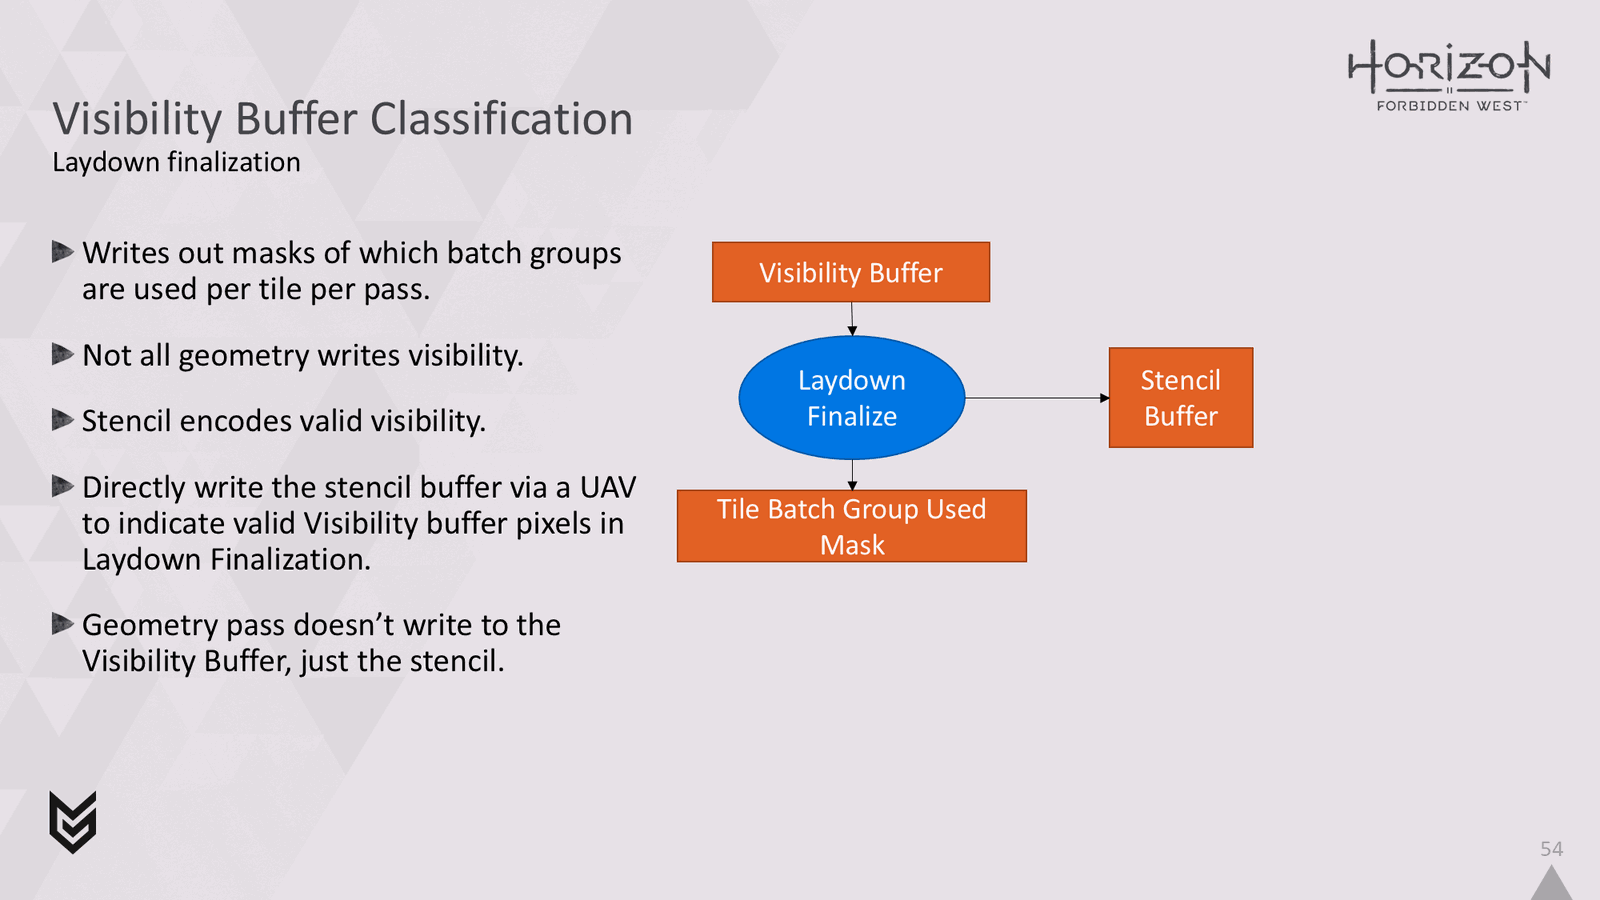
首先,我们有所谓的最终确定 这会读取可见性缓冲区,然后写出每个通道的每个图块中使用哪些批次组的掩码 这里需要注意的一件事是,并非所有内容都会写入可见性缓冲区。 我们有一个随后运行的几何通道,它用常规的延迟几何填充我们的 Gbuffer。 我们不想添加另一个导出来将可见性缓冲区写入所有这些着色器。 因此,我们利用模板缓冲区中的一个位来指示可见性缓冲区的内容是否有效。 如果我们在放置可见性缓冲区时写入此模板位,那么由于透支量,它会产生不小的成本。
因此,我们在运行放置最终着色器时通过无人机编写此代码。 然后,几何体通道中的批次会覆盖该模板位。 几何通道完成后,只有具有模板位集的像素才包含有效的可见性缓冲区信息。
Slide 54
📌 要点汇总
- 模板位机制:几何通道覆盖后仅保留有效像素数据
- 数据有效性:模板位集像素包含有效可见性信息
- 流程验证:确保分类处理结果的准确性
因此,我们在运行放置最终着色器时通过无人机编写此代码。 然后,几何体通道中的批次会覆盖该模板位。 几何通道完成后,只有具有模板位集的像素才包含有效的可见性缓冲区信息。
Slide 55
📌 要点汇总
- 中期分类阶段:与几何通道并行处理批次组统计
- popcount计算:统计每个图块批次组使用数量
- 前缀求和:生成计数器偏移量优化存储
- 空间优化:通过实际使用量减少计数器缓冲区需求
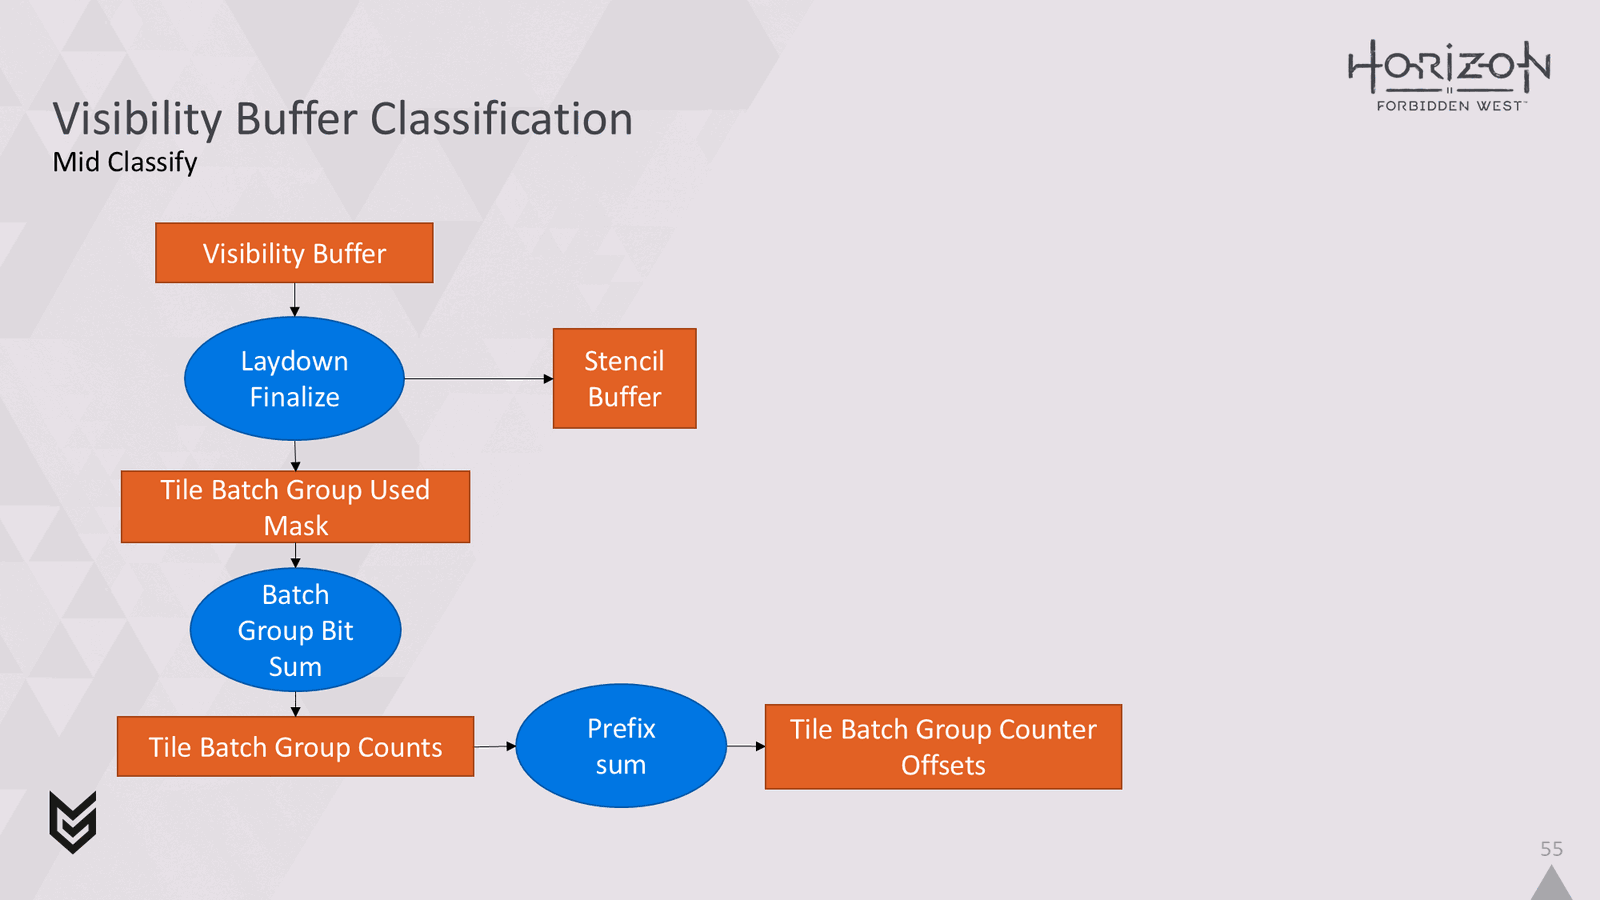
<注意,可能值得在本幻灯片之前阅读附加幻灯片 108,以了解每次传递 32 个批次组的限制> 然后我们进入中期分类阶段。 这可以与几何通道一起运行。 我们已经让批处理组使用了掩模,并在铺设完成时填充了模板缓冲区。 接下来,我们采用使用的掩码并使用 popcount 对位进行求和,以获得每次传递中每个图块使用了多少个批次组的计数。 我们对其进行前缀求和以获得计数器的偏移量。 这一切都完成了,这样我们就不必为每次传递的每个图块拥有一整套 32 个批次组计数器,因为要在 4K 下进行 256 个传递(这是我们当前支持的最大值),需要我们为计数器提供 16mb 的空间。 然而,由于大多数批处理组并未在所有图块中使用,因此通过计算实际使用的计数器集并将其偏移量存储在全局计数器缓冲区中,我们可以得到比这要少得多的结果。
Slide 56
📌 要点汇总
- 几何通道并行处理:几何通道运行时同步更新模板缓冲区
- 像素计数计算:读取模板/可见性缓冲区计算批处理组像素数
- 顶点剔除记录:通过图元ID解码顶点并记录到剔除缓冲区
- 粒度优化:采用64顶点块粒度控制内存占用
- 动态调整机制:高估像素命令数量不影响后续几何通道
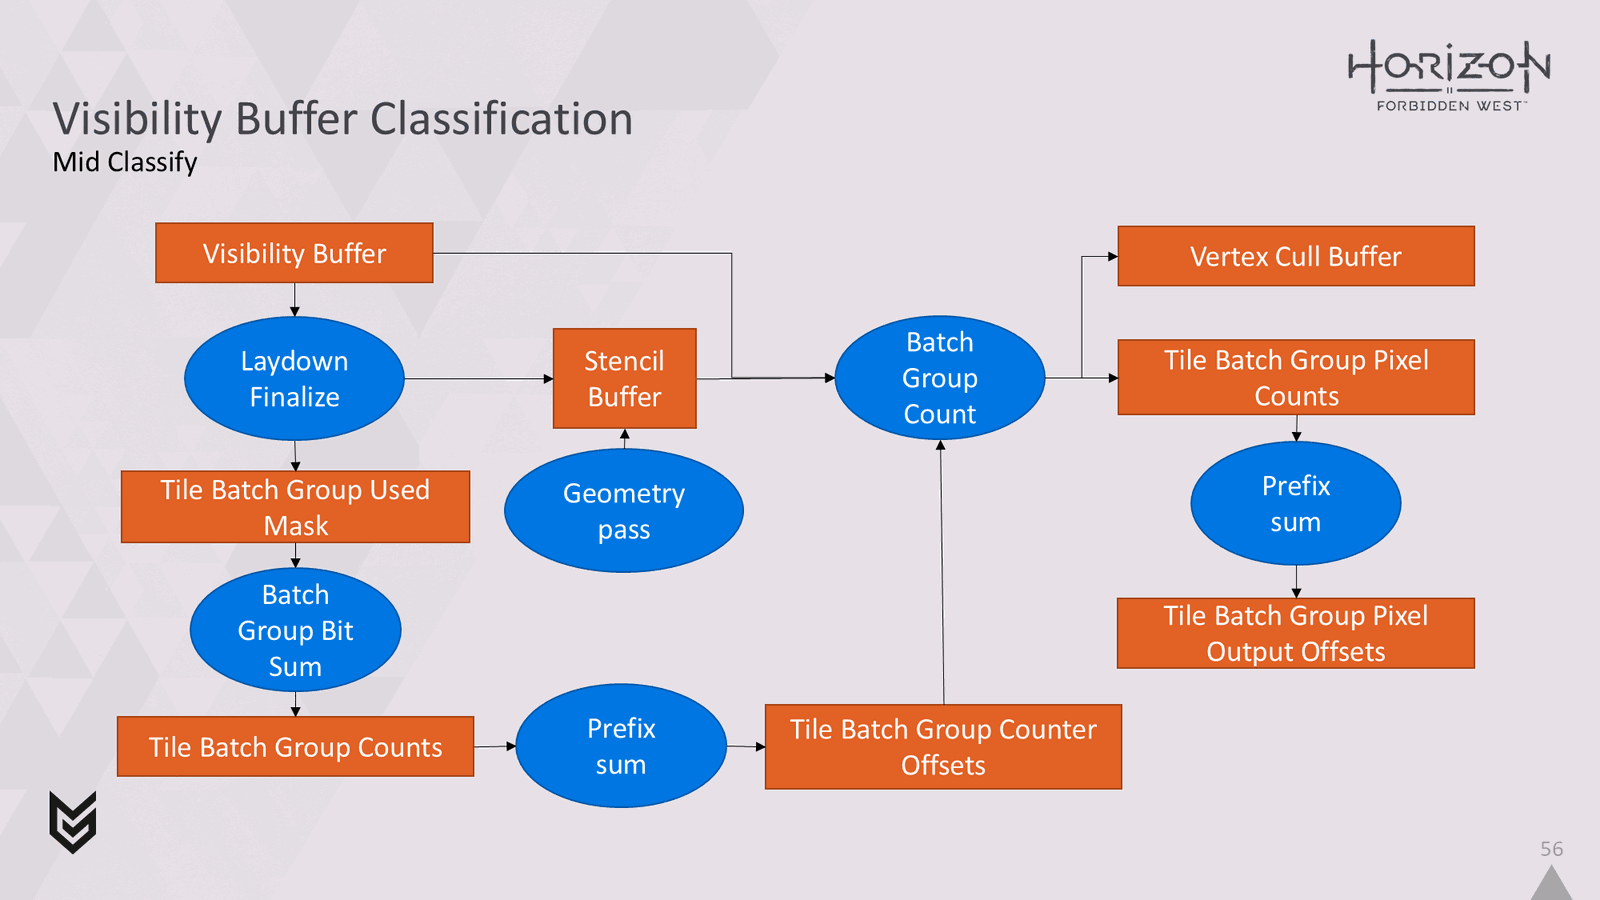
当所有这些发生时,几何通道仍在运行,并将更新模板缓冲区。 然后,我们读取模板缓冲区、可见性缓冲区和图块批处理组计数器偏移量,并计算每次传递中每个图块的每个批处理组中有多少像素。 同时我们还使用图元 ID 来解码使用了哪些顶点并将其记录在顶点剔除缓冲区中。 我们目前仅在 64 个顶点块的粒度上执行此操作,以保持简单并节省空间,因为在某些情况下,我们可以在场景中拥有数十百万个顶点。 然后,我们获取图块批处理组像素计数,对它们执行前缀总和,并吐出一组偏移量,以便我们开始记录每次传递每个图块的每个批处理组的像素命令。
重要的是要记住,这一切都可以在几何通道仍在运行时运行,因此我们可以高估每个批处理组需要多少像素命令,但这不是问题,因为我们只会减少进一步进入几何通道的有效可见性像素的数量。
Slide 57
📌 要点汇总
- (无内容):此幻灯片无演讲内容
重要的是要记住,这一切都可以在几何通道仍在运行时运行,因此我们可以高估每个批处理组需要多少像素命令,但这不是问题,因为我们只会减少进一步进入几何通道的有效可见性像素的数量。
Slide 58
📌 要点汇总
- 顶点波命令生成:中间分类阶段需处理顶点波命令生成
- 输入来源:依赖顶点剔除缓冲区数据作为主要输入
- 可见性标记:每个顶点块使用字节集标记可见性状态
- 附赠内容:顶点命令生成细节见演示文稿末尾附赠幻灯片
现在,在中间分类步骤中,我们还需要处理生成顶点波命令,这些命令将告诉我们在每次传递中需要执行哪些顶点工作。 此计算的主要输入是我们之前生成的顶点剔除缓冲区。 每个顶点块都有一个字节集来指示它是否可见。 由于时间原因,我不会在本演示文稿中介绍如何创建顶点命令,但如果您感兴趣,可以在本演示文稿末尾的附赠幻灯片中找到一些有关它的幻灯片。
Slide 59
📌 要点汇总
- 分类输出阶段:几何通道结束后运行在可见性缓冲区
- 有效性验证:模板缓冲区用于验证可见性缓冲区条目
- 像素命令输出:生成包含图块坐标和像素位置的命令
- 波命令编码:对图块
因此,完成中间分类后,我们就可以在几何通道完成后在可见性缓冲区上运行分类输出阶段。 在几何通道中更新的模板缓冲区用于告诉我们可见性缓冲区中的哪些条目实际上是有效的。 然后我们可以用它来写出我们的各种命令。 这些是包含图块中像素 X 和 Y 的像素命令。 此外,我们还编写像素波命令,对图块坐标、批次组 ID 以及像素命令的偏移量和数量进行编码。
Slide 60
📌 要点汇总
- 可见性缓冲区处理:整合可见性/模板缓冲区与像素偏移量
- 像素命令输出:分类着色器生成像素命令及通道计数
- 波对齐计算:计数向上舍入后计算波数需求
- 前缀和调度:通过前缀和确定波形命令输出位置
- 波形命令生成:最终输出波形命令与调度缓冲区
让我们更详细地看看这一步。 因此,在这里您可以看到我们采用了之前计算的可见性缓冲区、模板缓冲区和图块批处理组像素输出偏移量,并使用分类输出着色器处理每个像素。 这将输出我们的像素命令,以及每个批处理组中每个通道的每个图块使用的像素数量的最终计数。 然后,我们可以将这些计数向上舍入到波对齐,并使用它们来计算每个批次每个图块每次传递所需的波数。 然后我们可以执行前缀和来确定我们需要在哪里输出像素波命令。 最后,我们可以对所有通道和图块进行调度,并输出波形命令和调度缓冲区以用于像素通道。
Slide 61
📌 要点汇总
- GPU时间线:深度/可见性传递后立即启动放置最终确定
- 并行执行:放置最终确定可与渲染水立方贴图面并行
- 几何通道:中间分类为最终分类和顶点剔除做准备
- 流程顺序:几何通道完成后启动最终分类和像素着色
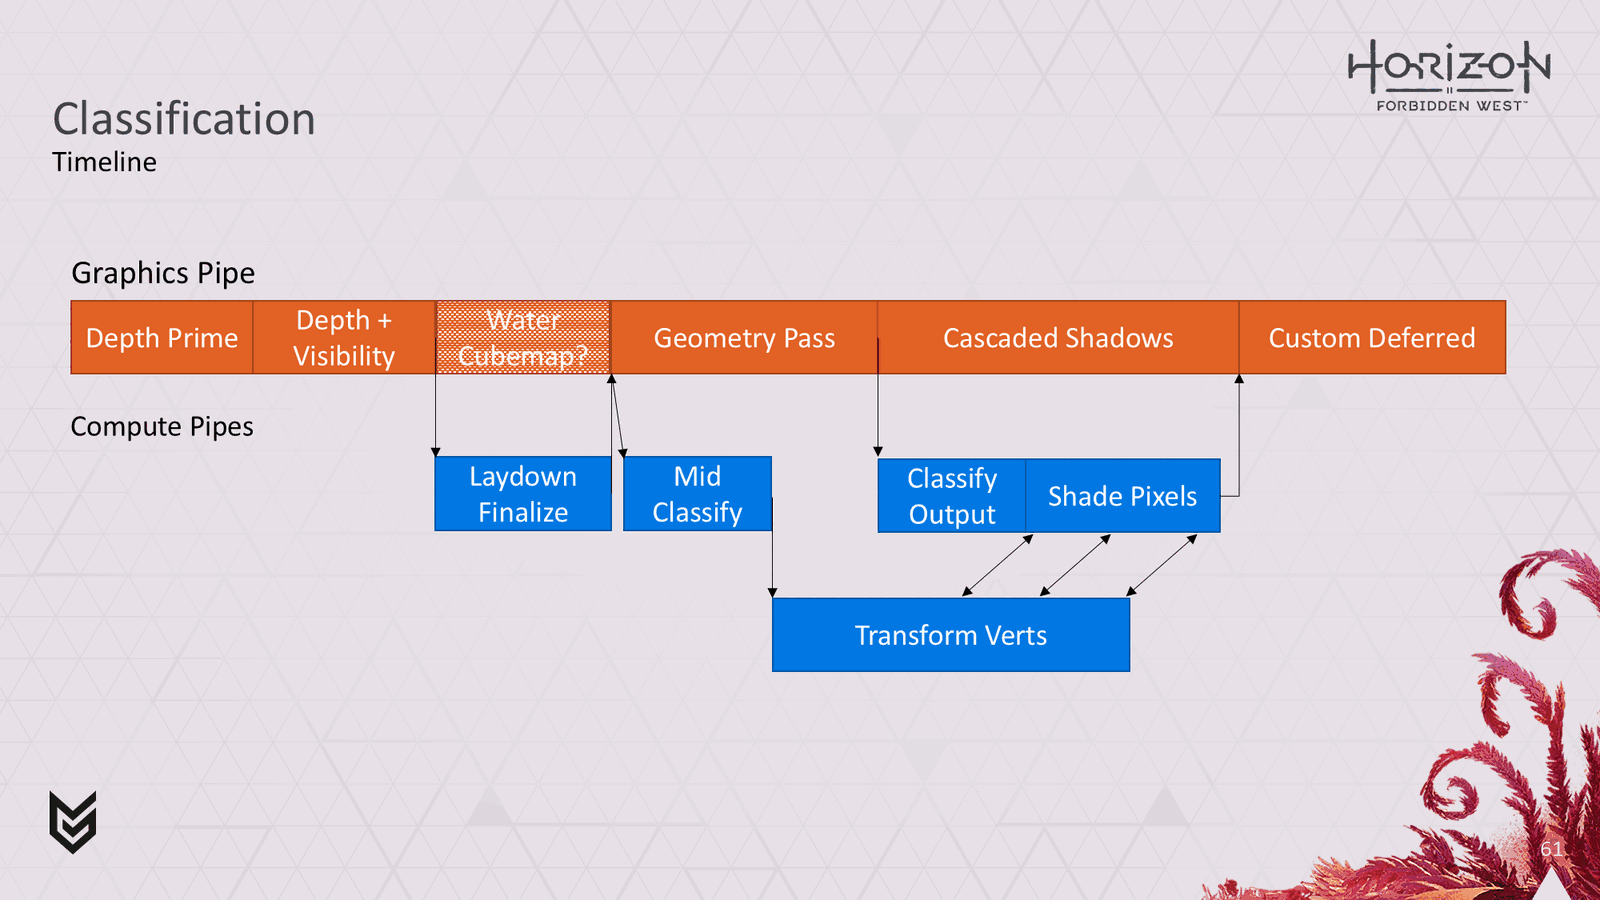
下面来看看这一切如何融入我们的 GPU 时间线。 正如您所看到的,我们在深度和可见性传递之后立即开始我们的放置最终确定。 如果我们幸运的话,那么这可以与渲染水立方贴图的面并行运行。 之后几何通道开始,我们可以开始中间分类步骤。 这些让我们为最终的分类输出步骤做好准备,同时也为剔除顶点和输出顶点波命令做好准备。
Slide 62
📌 要点汇总
- 中间分类时机:在几何通道运行时进行分类导致结果保守
- 顶点变换风险:可能变换被遮挡顶点但依赖深度通道遮挡器
- 并行优势:几何通道运行时可提前转换延迟纹理顶点
- Gbuffer处理:最终分类后通过自定义延迟通道修改Gbuffer
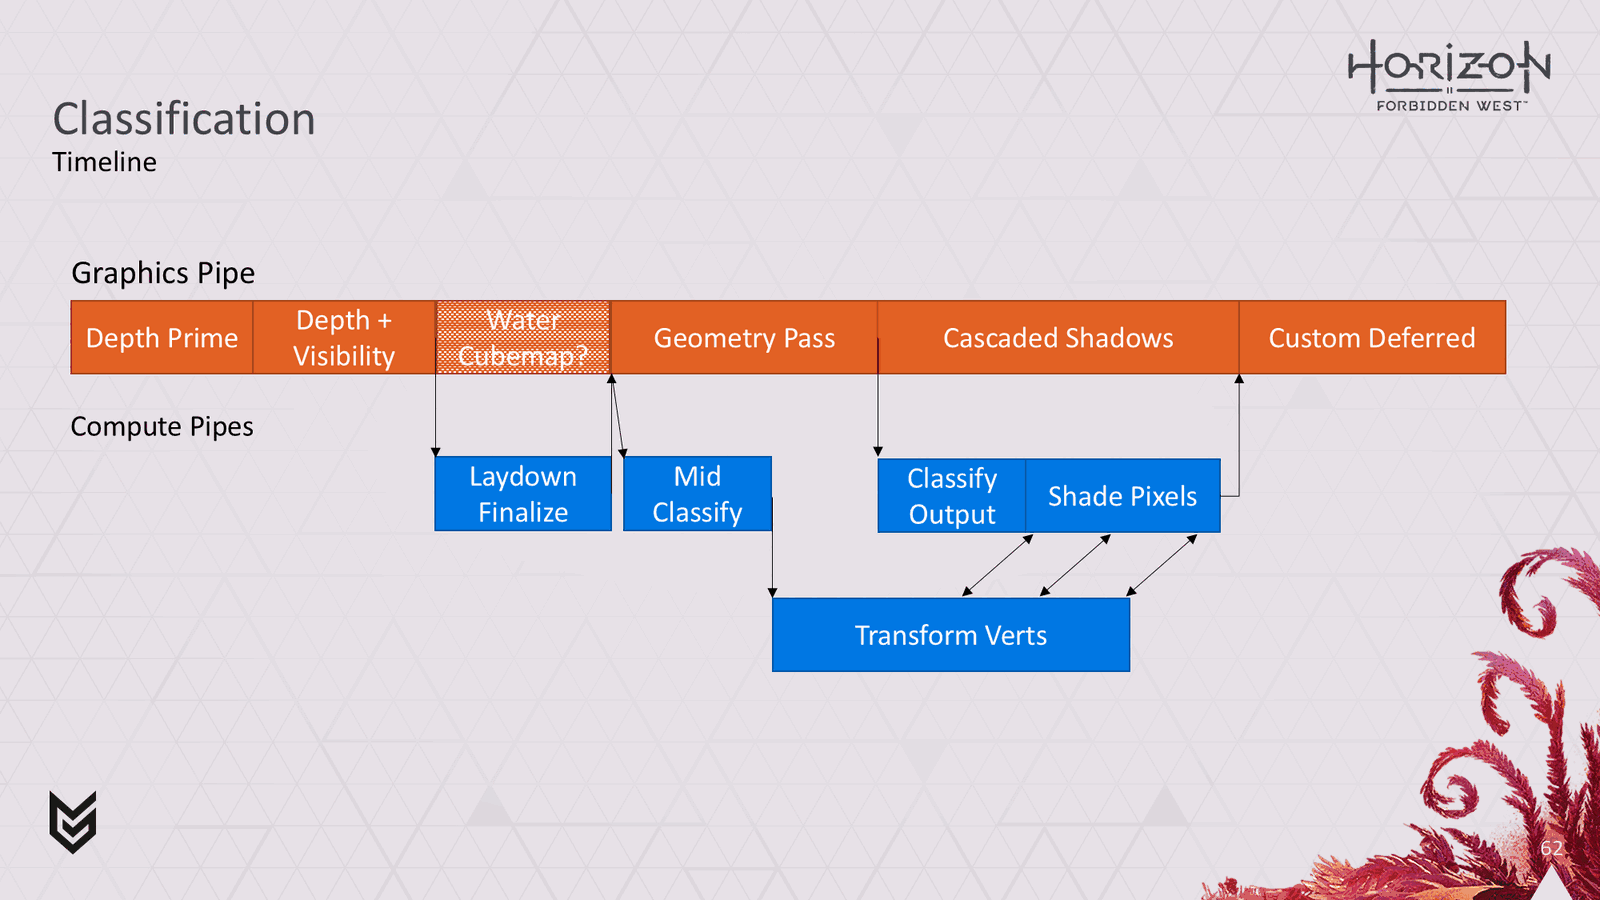
由于中间分类发生在几何通道在图形管道上运行时,因此我们得到的一些结果是保守的。 所以我们最终可能会变换一些可能被遮挡的顶点。 然而,由于我们的大多数主要遮挡器都位于深度主要通道中,因此我们通常发现与几何通道并行运行该通道比等待其后的准确结果更好。 它还允许我们在几何体通道完成之前开始转换延迟纹理通道的顶点。 几何通道完成后,我们进行最终分类,输出像素和波形命令,并在渲染阴影时开始对像素进行着色。 然后,我们使用自定义延迟通道完成 Gbuffer 放置,该通道用于贴花等,可以修改已写入的 Gbuffer 值。
Slide 63
📌 要点汇总
- 替代模式:将中间分类移至几何通道末尾
- 性能优化:减少并行工作量提升顶点剔除率
- PS5实验:针对高几何密度场景进行验证
- 结构调整:改变中间分类与几何通道的执行顺序
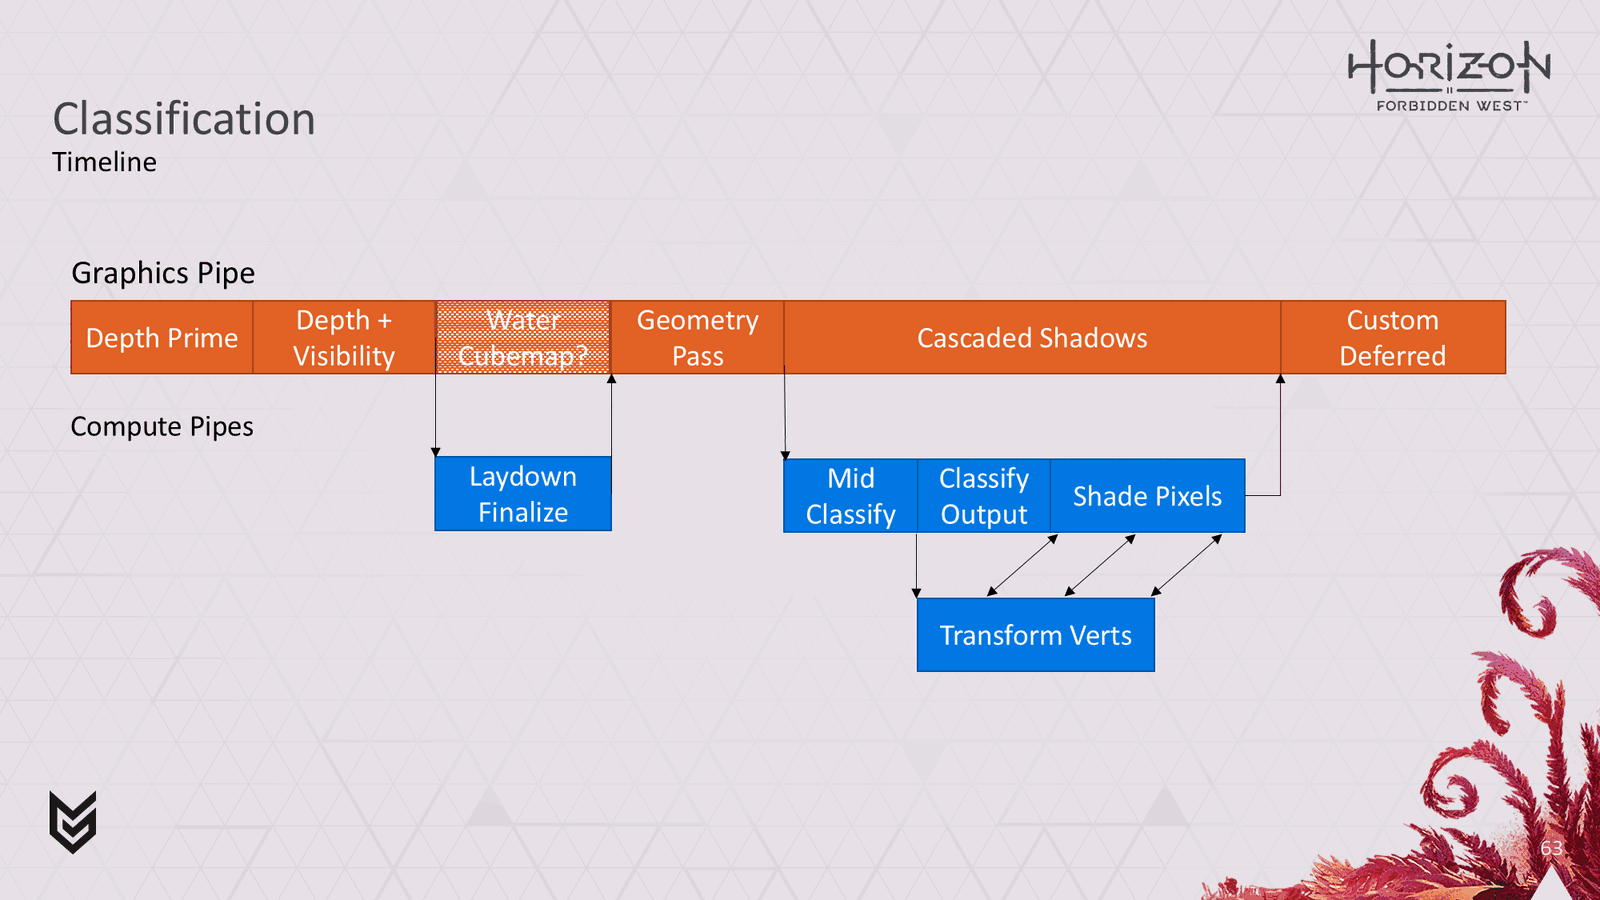
还可以在替代模式下运行系统,其中中间分类移动到几何通道的末尾。 这样可以减少与几何传递并行的工作量,同时获得更高的顶点剔除率,我们正在 PS5 上进行实验,其中几何密度要高得多。
Slide 64
📌 要点汇总
- (无内容):此幻灯片无演讲内容
关于环形缓冲区中的顶点如何编码的几句话
Slide 65
📌 要点汇总
- 编码格式:32字节顶点编码包含HPOS/UV/颜色等数据
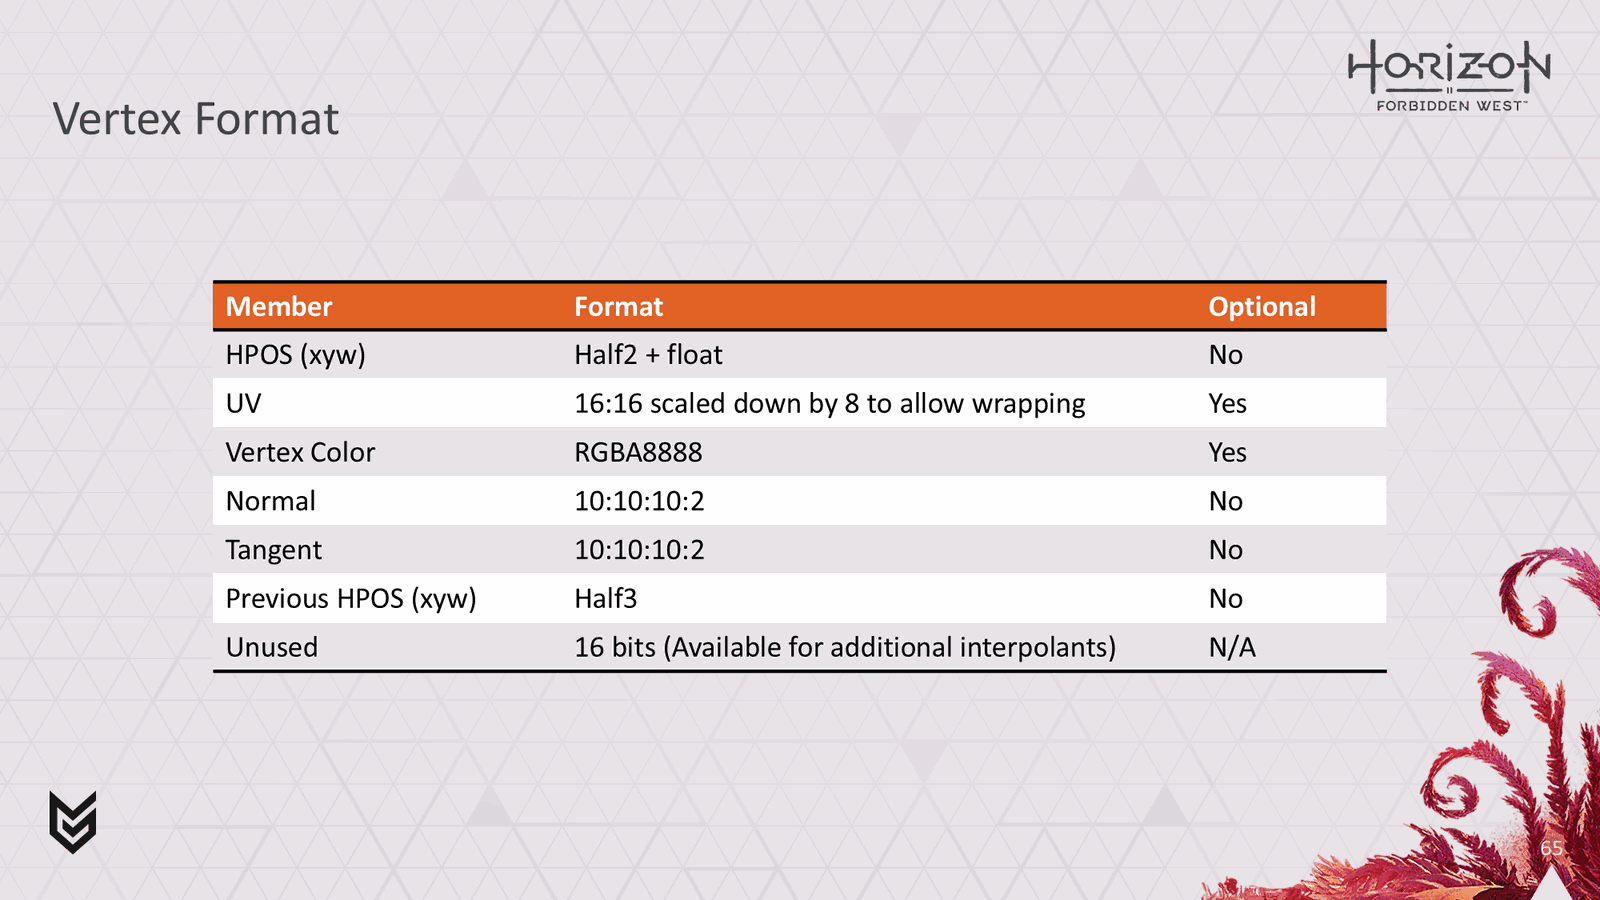
这就是我们使用的格式。总共 32 个字节长。 对于 HPOS,我们将 x 和 y 编码为半浮点数,但发现出于准确性原因,我们需要将 w 保留为浮点数,并且 z 不需要发送,因为它可以轻松从 w 中恢复。 我们将 UV 存储为固定点 16:16,但按比例缩小了 8 以支持某些 UV 环绕。 我们还有顶点颜色、法线、切线和之前的 HPOS 空间,以便我们可以构造运动向量,您会看到我们还有 16 位未使用。
Slide 66
📌 要点汇总
- 非固定格式:允许动态调整插值槽以优化像素处理
- 顶点格式优化:通过顶点读取减少像素阶段缓冲区访问
- 插值槽扩展:支持5x16位附加插值器,兼容半浮点/8位颜色
- 数据重用:释放UV/顶点颜色空间用于自定义插值数据
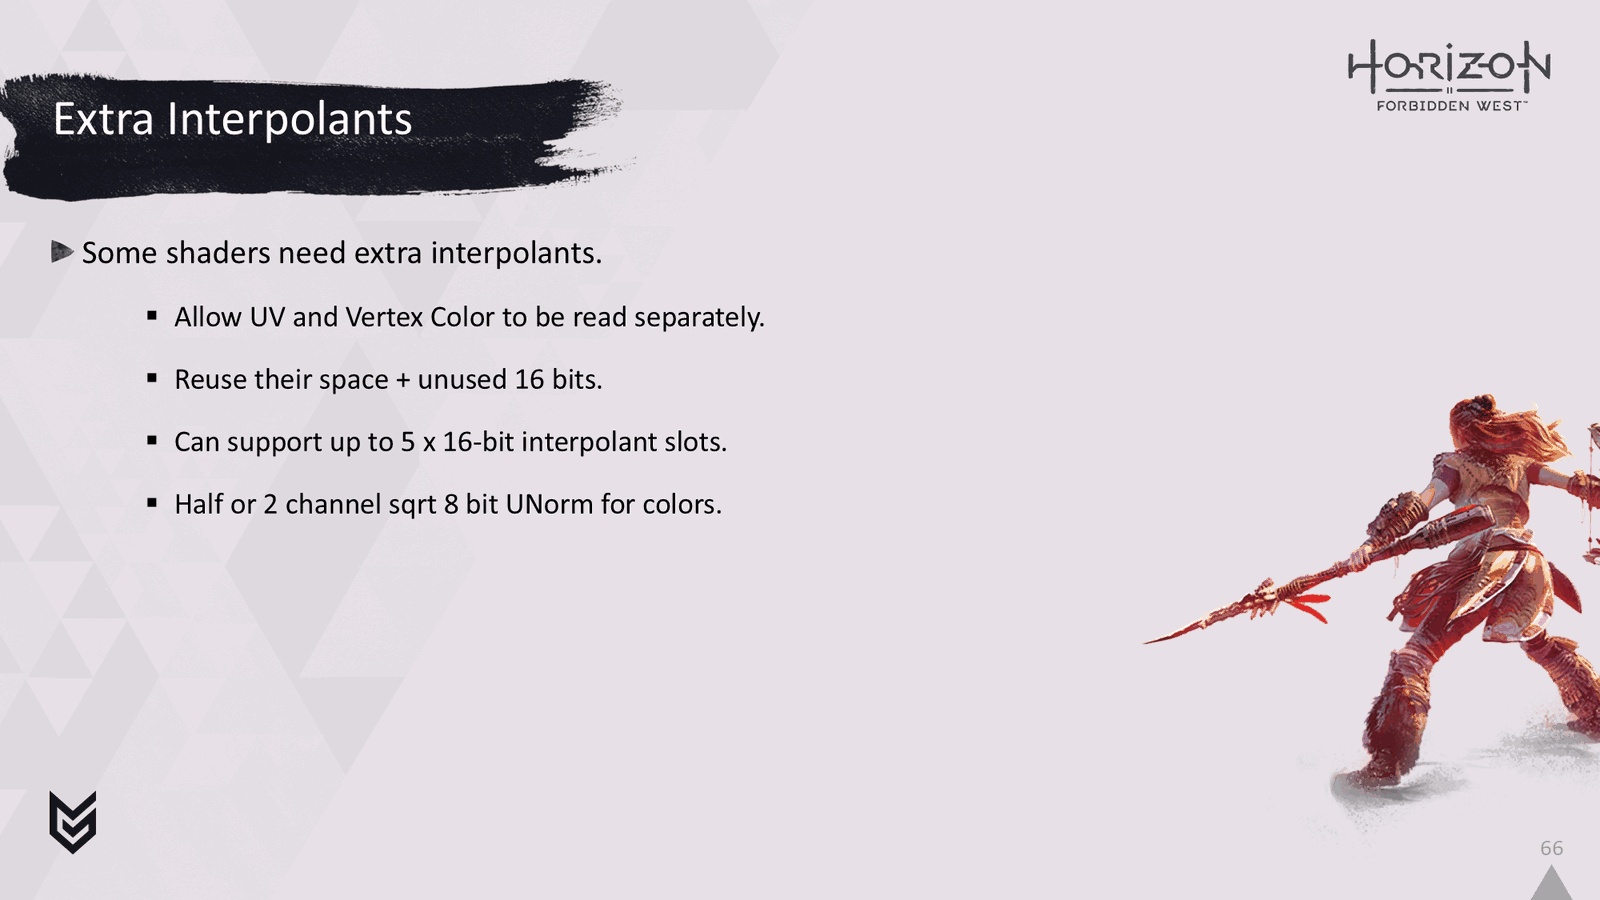
因此,这不是完全固定的格式,对于某些着色器,我们需要额外的插值,特别是如果我们想尝试将一些像素工作移动到顶点着色器以进行优化。 我们不对 UV 和顶点颜色进行动画处理,但在顶点程序中读取它们并以顶点格式放置通常会更有效,以帮助减少每个像素的缓冲区读取数量。 然而,为了考虑额外的插值,我们允许将 UV 和顶点颜色从固定格式中剔除,并直接读取它们的数据缓冲区。然后我们将它们的空间重新用于我们的附加插值器。 使用这种方案,我们可以支持多达 5x16 位的额外插值槽。 目前,一个槽可以填充半浮点数,或 2 通道平方根 8 位 unorm 颜色值,您可以将其视为穷人的 sRGB。
好的,这就是我要介绍的有关系统核心的所有信息。 希望您现在对这一切是如何运作的有所了解, 我知道我已经很快地完成了其中的一些内容并引入了许多新概念 所以,如果你认为这已经很多了,那就相信我。
Slide 67
📌 要点汇总
- (无内容):此幻灯片无演讲内容
….. 我知道!我也不能一半时间把这一切都记在脑子里。
Slide 68
📌 要点汇总
- (无内容):此幻灯片无演讲内容
所以,让我们和阿洛伊一起在森林里放松几秒钟,欣赏这一切的目的 ……好吧,大家都喘口气了吗?
Slide 69
📌 要点汇总
- VRS支持:项目后期添加可变速率着色技术
- 性能目标:通过动态调整着色精度提升整体性能
- 技术扩展:在现有架构基础上实现新特性
所以现在我要谈谈我们在项目结束时添加的可变速率着色支持,以尝试从系统中挤出更多的性能。
Slide 70
📌 要点汇总
- VRS实现:通过可见性缓冲区位字段编码着色率
- 硬件兼容:在非原生支持硬件上实现VRS功能
- 驱动方式:当前仅支持顶点着色器驱动的VRS方案
- 性能增益:PS4 Base平台增益依赖具体场景表现
到目前为止我所描述的可能非常有效,但我们想看看是否可以更快地获得结果。 我们渲染的许多树叶最终都会呈现出各种深浅的绿色,因此我们并不总是能从全速着色中受益。 因为我们自己有效地管理像素导出,而不是通过 ROP,所以我们能够将我们的方案修改为 即使在本身不支持可变速率着色的硬件上也支持可变速率着色。 我们从微批量偏移中窃取可见性缓冲区的前 2 位,并用它来编码着色率。 理论上,我们可以支持通过屏幕空间着色率纹理来驱动它,但目前我们选择仅从顶点着色器驱动它。 我们支持所有 Direct X Tier 1 VRS 着色率。 我们仅在 PS4 Base 上启用此功能,并且增益在很大程度上取决于场景。
Slide 71
📌 要点汇总
- (无内容):此幻灯片无演讲内容
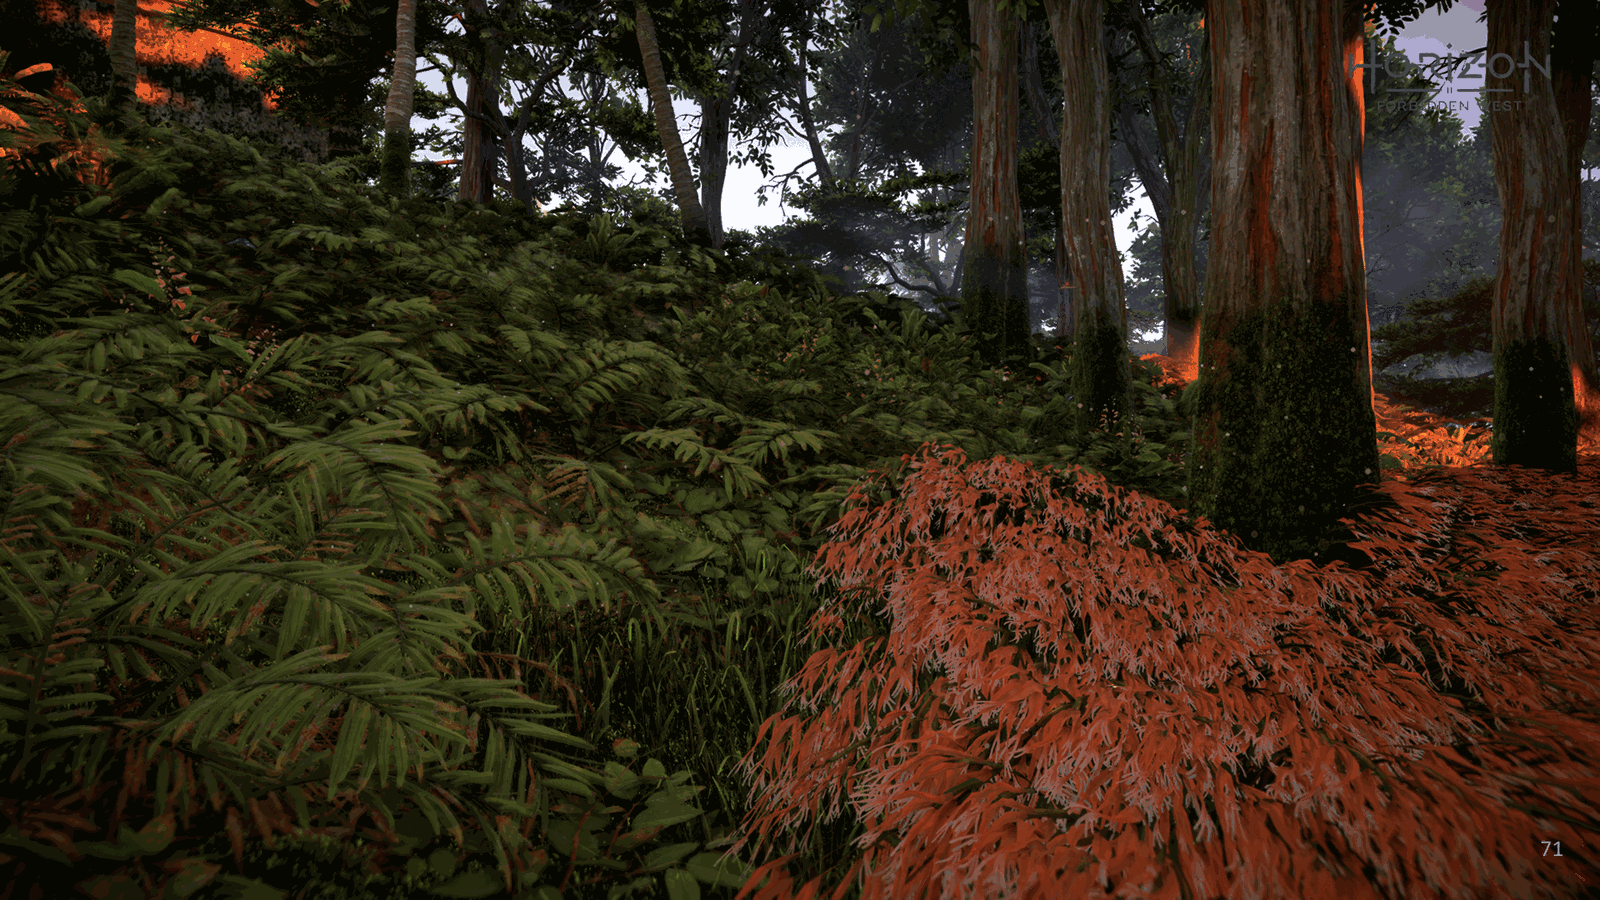
在这里我们可以看到美丽的森林景色
Slide 72
📌 要点汇总
- VRS标准设置:混合比例从1x1到2x2动态调整
- 延迟优化:非重叠纹理时延迟约0.2毫秒
- 混合机制:基于距离的多级分辨率混合方案
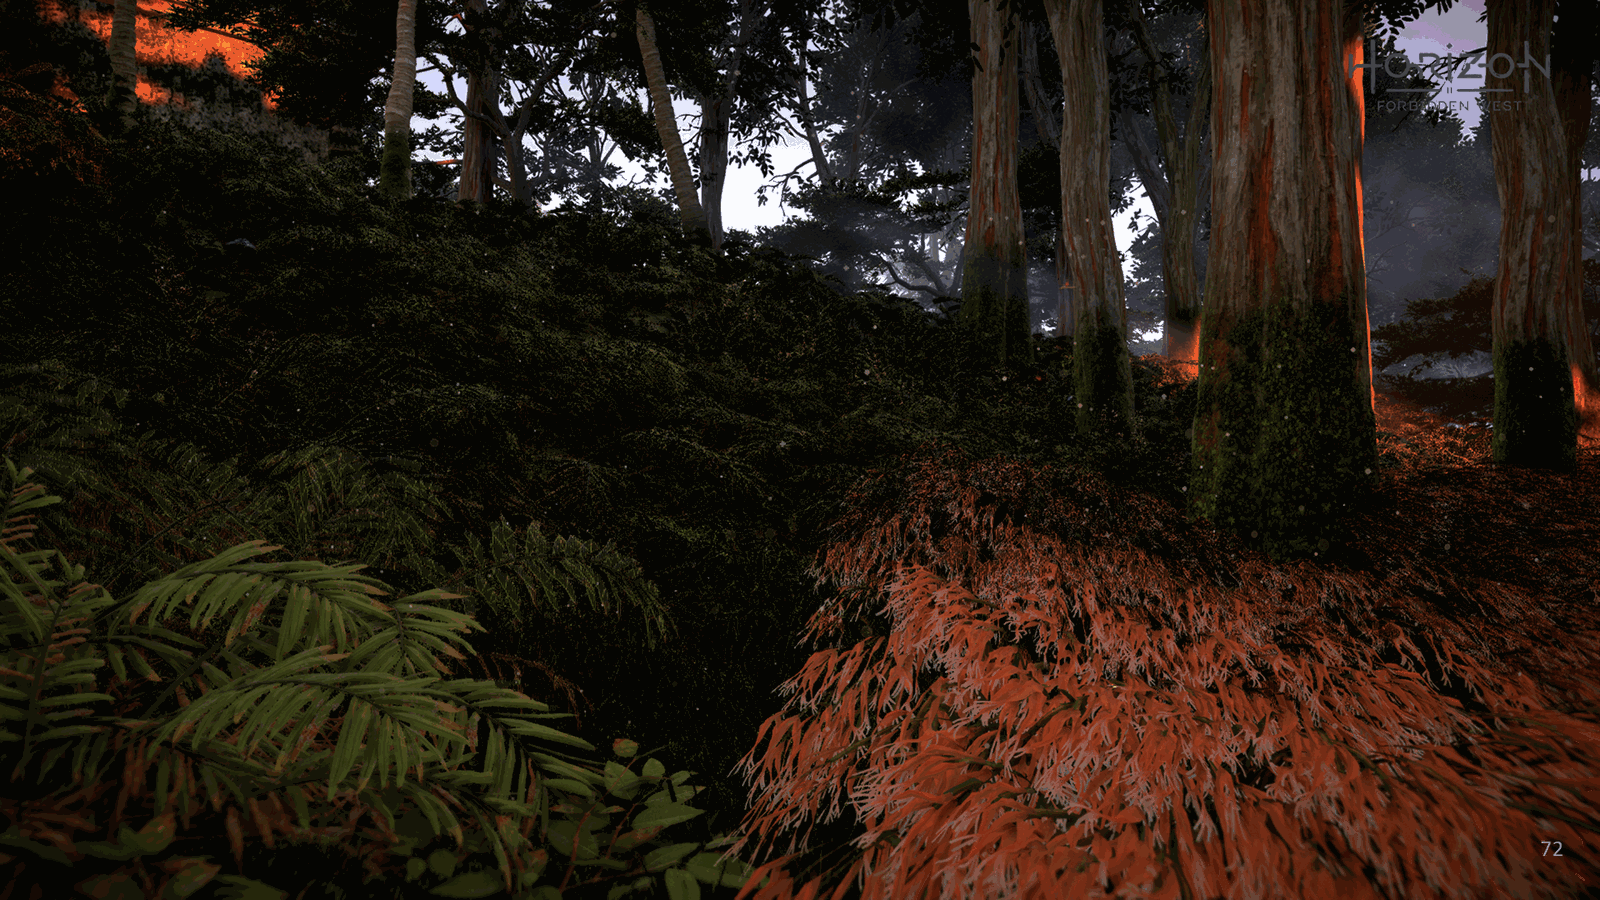
这是我们静止时 VRS 的标准设置,根据距离从 1x1 和 2x1 到 2x2 进行混合。 在这个场景中,当延迟纹理未重叠时,这会让我们延迟大约 0.2 毫秒
Slide 73
📌 要点汇总
- 动态着色速率:顶点速度驱动分辨率切换
- 运动优化:高速移动强制2x2模式
- 性能代价:2x2模式带来0.5毫秒延迟
然而,我们在顶点着色器中使用顶点的屏幕空间速度来驱动着色速率 因此,当我们快速移动时,一切都倾向于使用 2x2,在这个场景中,这为我们带来了近 0.5 毫秒的时间,因此更值得我们花时间。
Slide 74
📌 要点汇总
- QuadSwizzle技术:快速识别可并行着色像素
- 像素命令优化:12位标识128x128图块
- 广播控制:前4位定义四边形像素分布
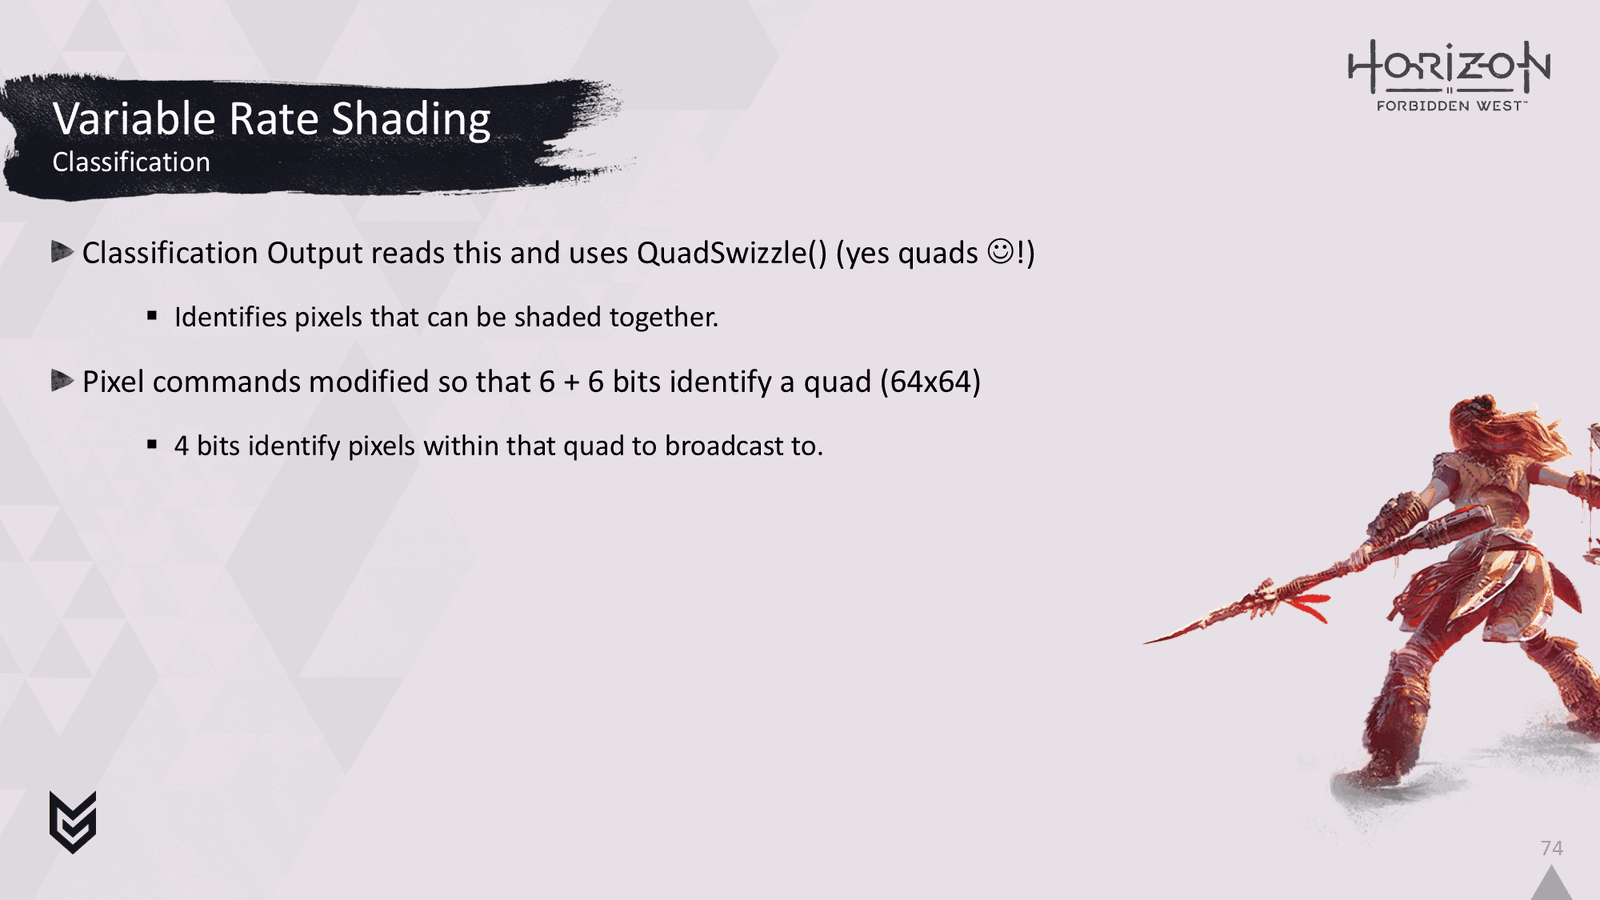
我们的分类输出阶段可以读取此着色率信息,并使用 QuadSwizzle 快速确定可以一起着色的像素。 正如我之前提到的,我们还更改了像素命令,以便 12 位识别要在 128x128 图块中着色的特定四边形。 然后,命令的前 4 位用于识别我们需要广播到四边形中的哪些像素。
Slide 75
📌 要点汇总
- 波形广播机制:需要扩展工作列表处理
- LDS优化:构建扩展像素命令列表
- UAV同步:着色器结束时执行广播
- 内存优化:避免线程循环播放方案
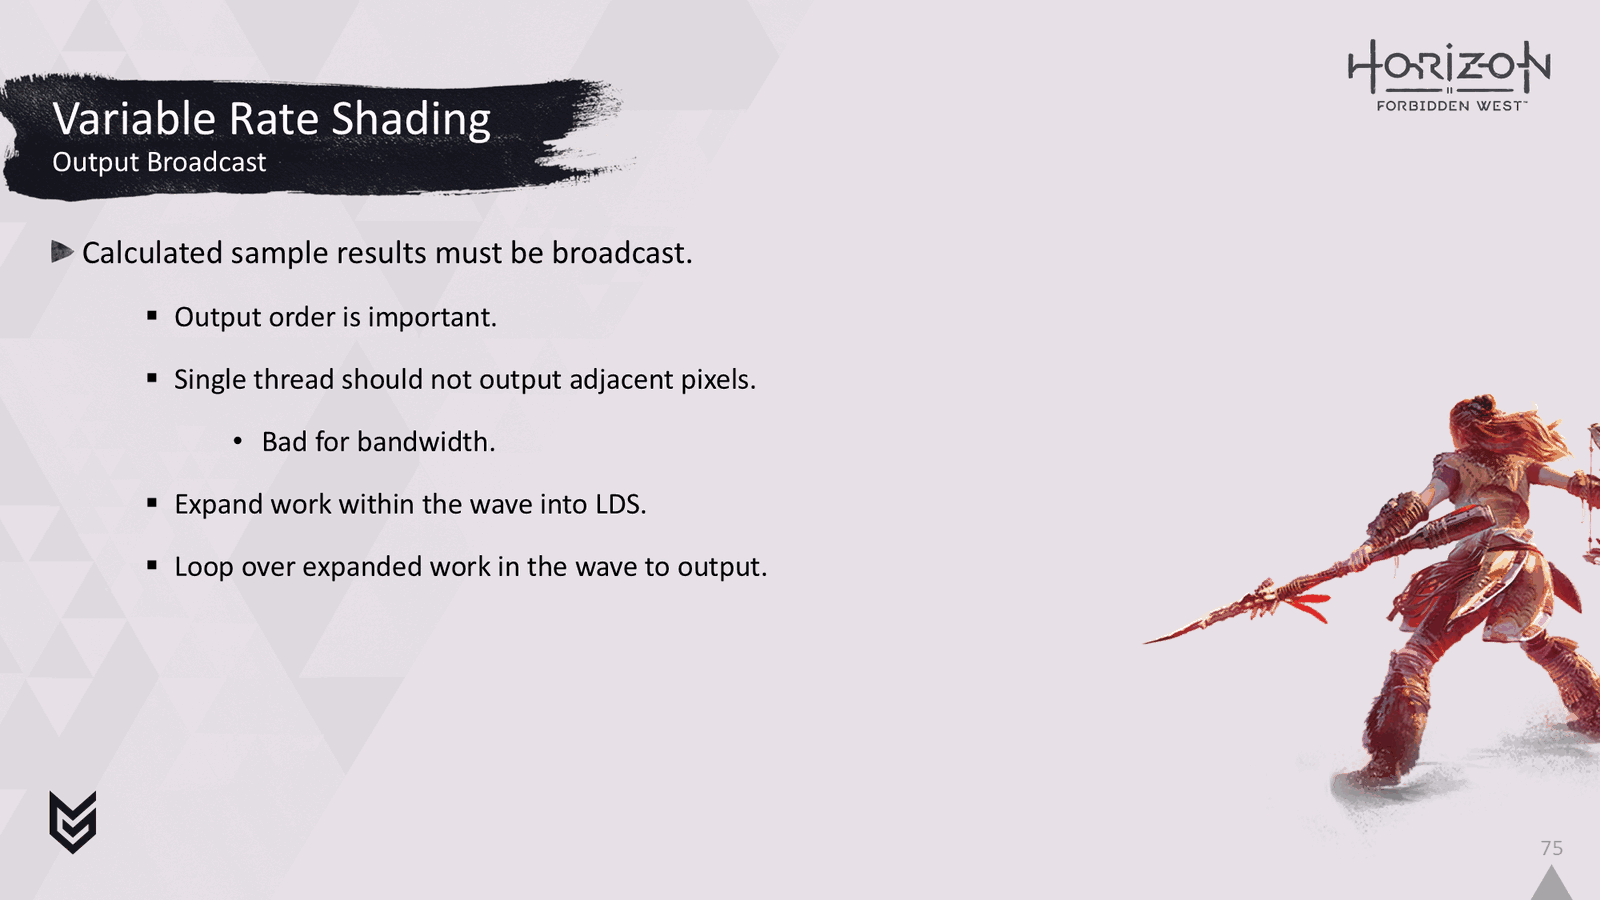
在生成材质输出的着色器中,我们需要广播波形中任何可变速率样本的结果。 只需让每个线程循环播放它应该广播到的样本,就可以天真地做到这一点,但这对内存不太友好,并且性能不佳。 相反,我们需要做的是在每一波中进行一些工作扩展。 我们获取所有样本并在 LDS 中构建扩展像素命令的列表。 如果波形中的任何像素命令需要广播,则这是在着色器启动时完成的。 在 G 缓冲区中每个 UAV 的着色器结束时,我们将使用这个扩展的工作列表来进行广播。
Slide 76
📌 要点汇总
- 手动转换着色结果:将着色结果转换为内存中的最终原始形式并缓存到LDS
- 循环遍历命令集:通过扩展命令集循环实现指令处理
- 解码获取LDS结果:解码命令并提取与命令关联的LDS存储结果
- 通道定位输出位置:每个通道根据计算确定图像输出目标位置
- 打包图像存储输出:通过图像存储内部函数完成最终输出打包
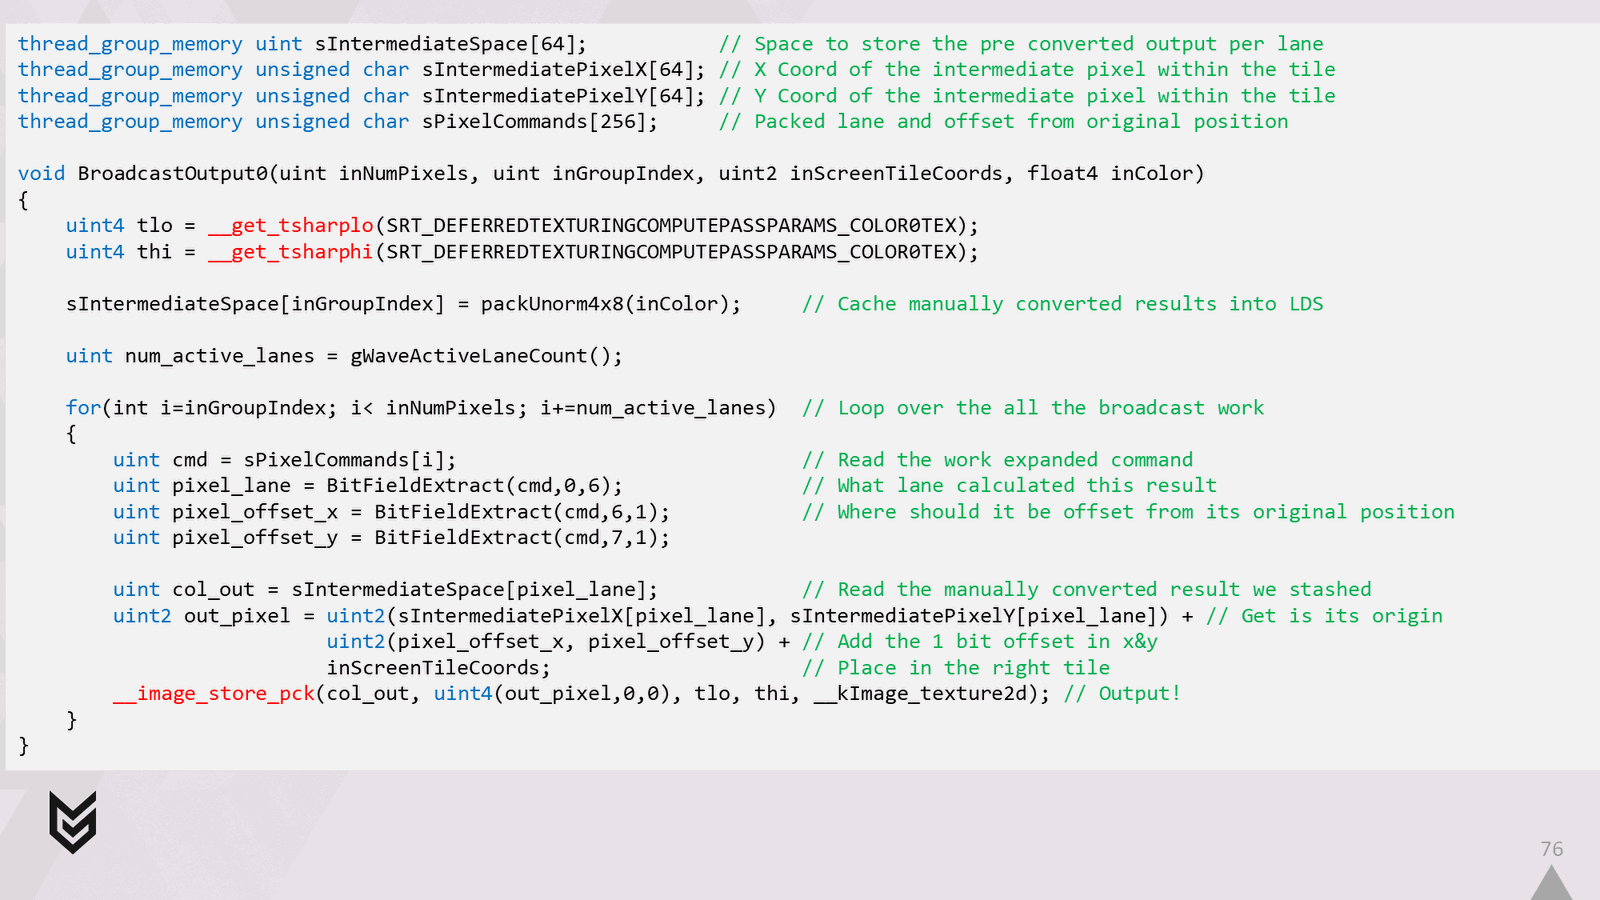
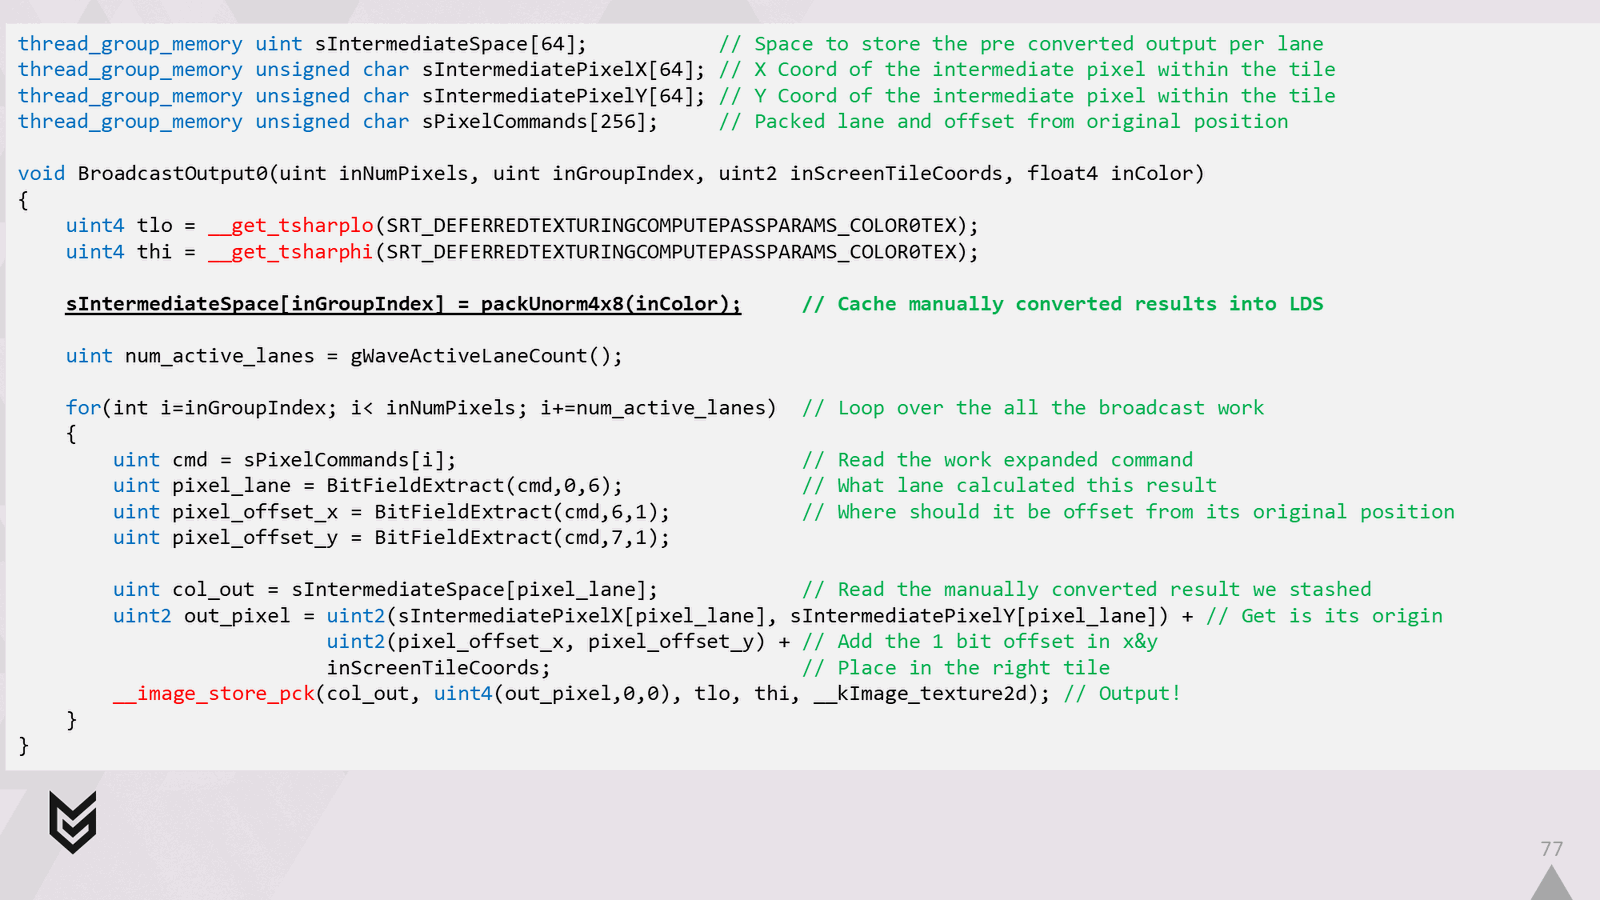
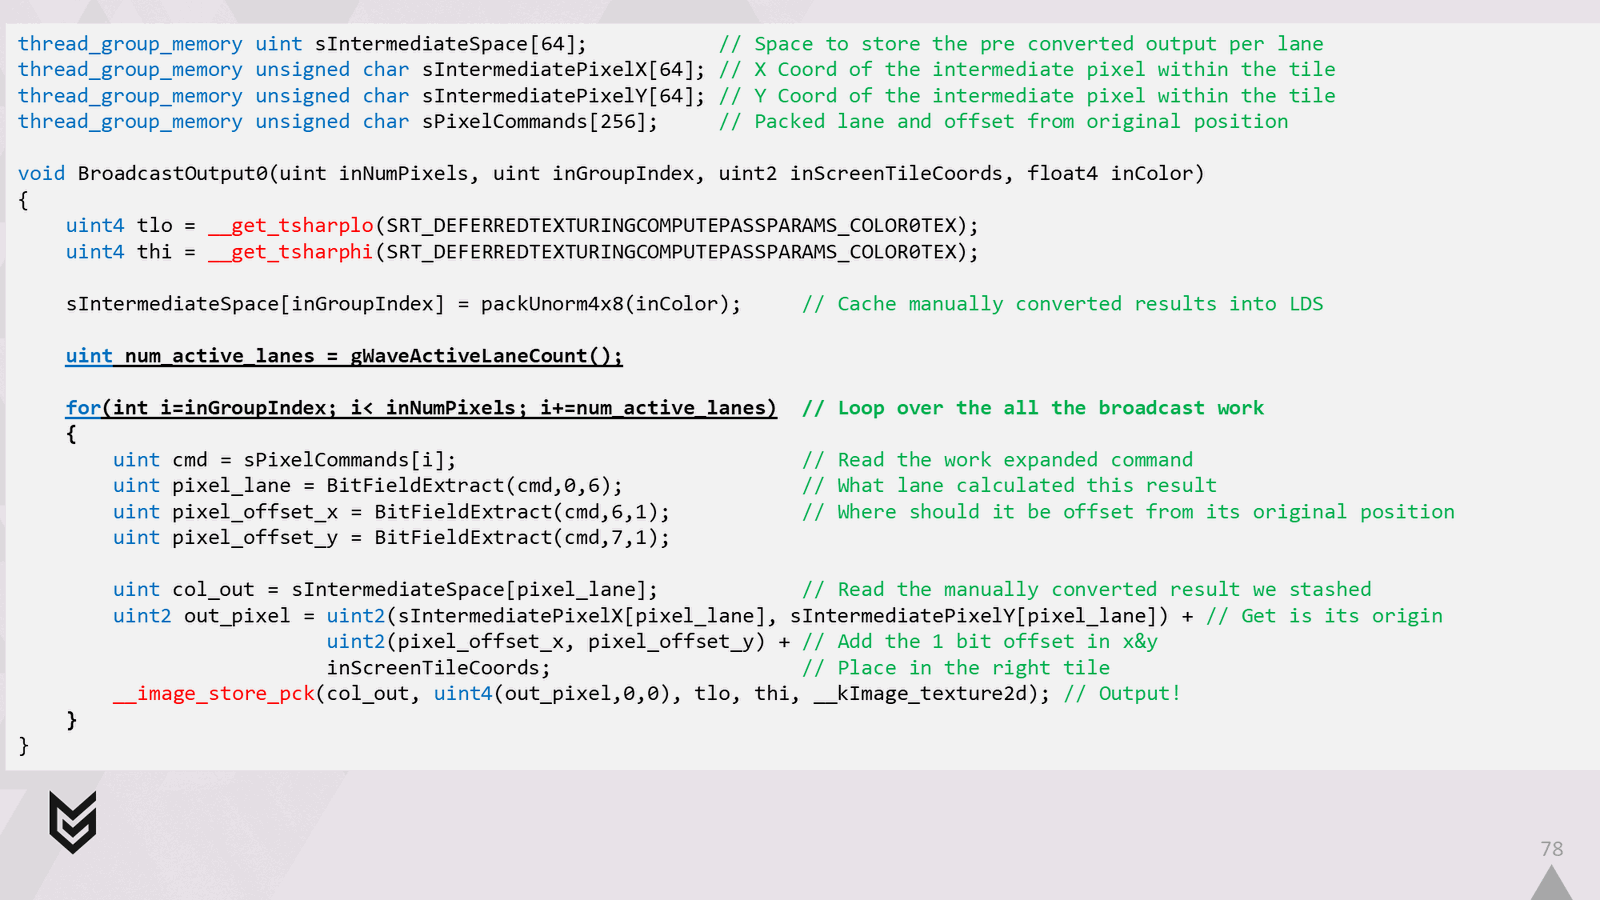
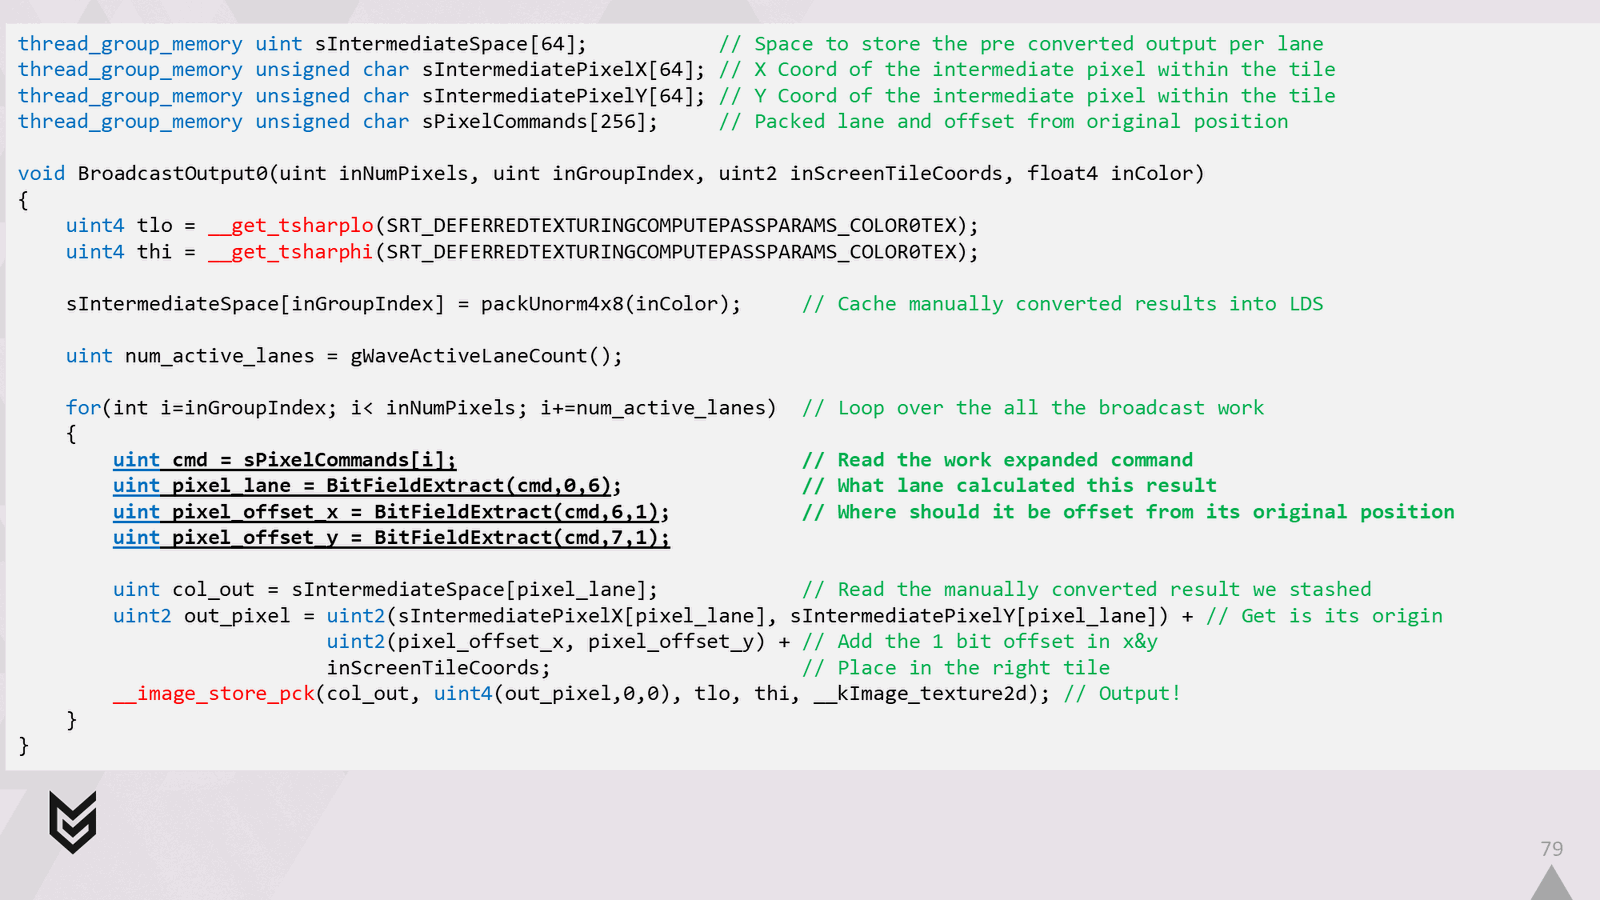
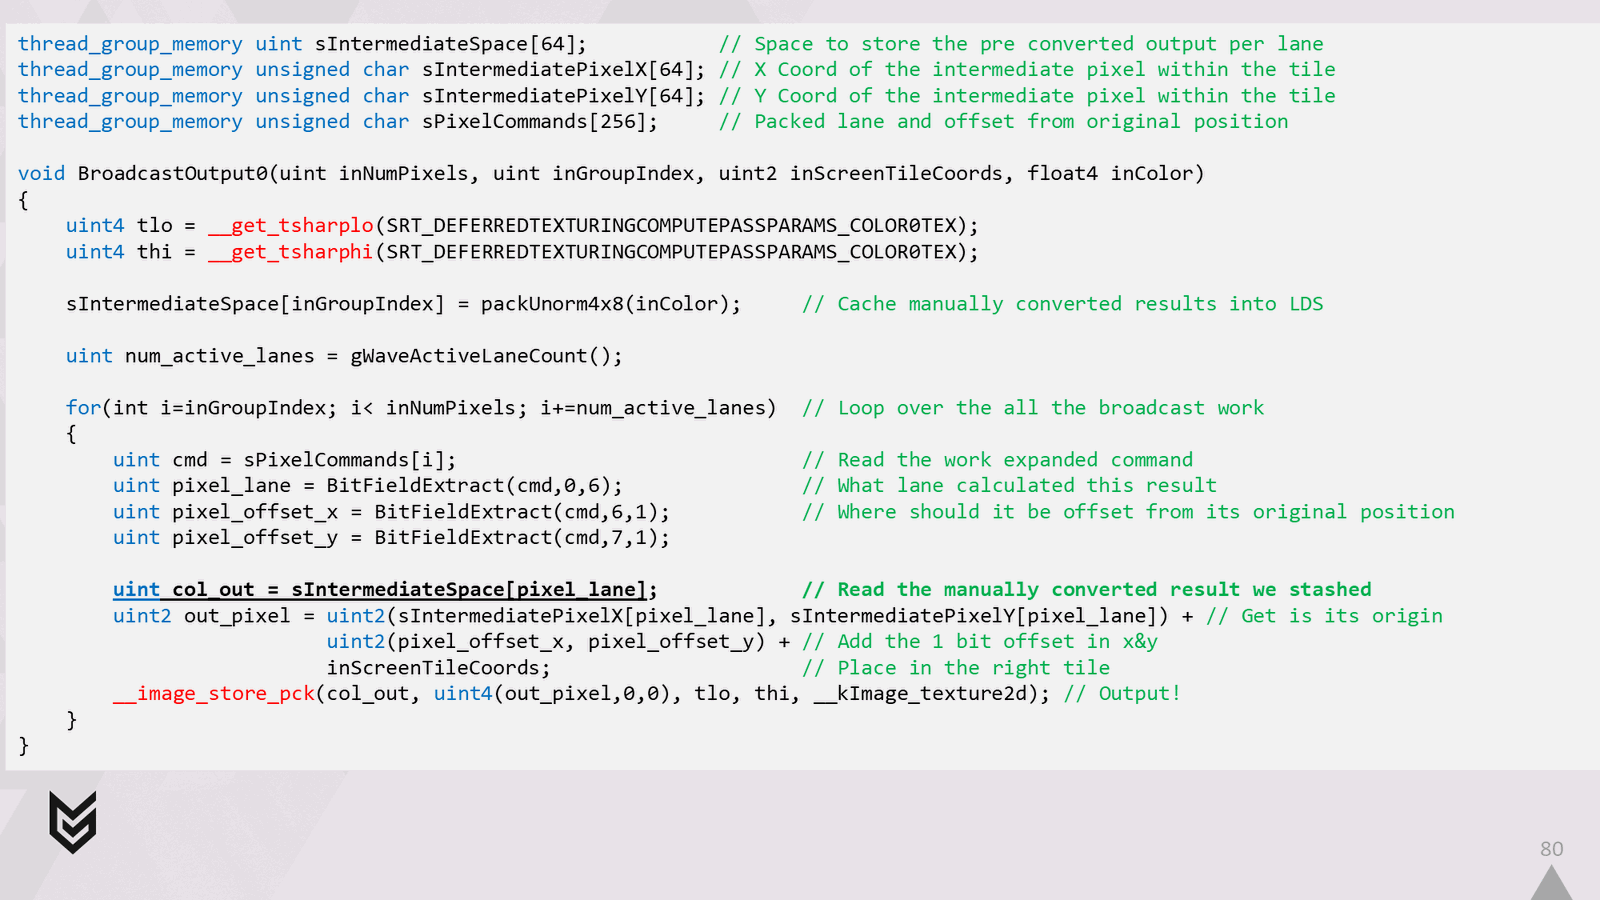
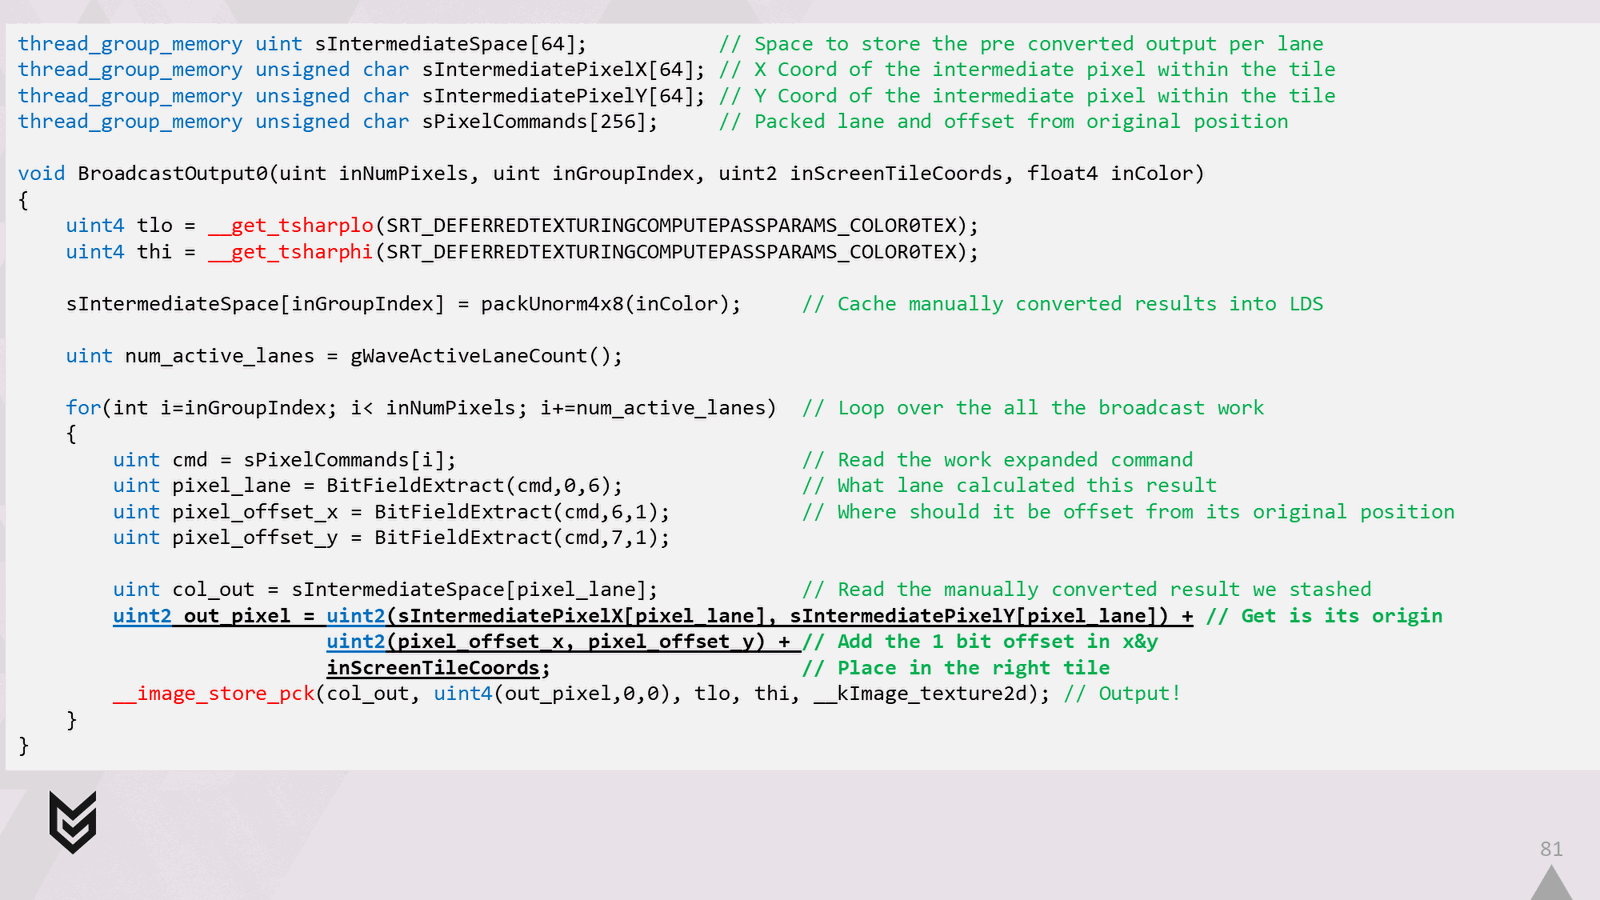
将输出广播到单个无人机的代码如下所示。
您可以看到,我们通过手动将着色结果转换为内存中的最终原始形式并将结果缓存在 LDS 中来启动 。 然后我们可以循环遍历扩展的命令集,解码它们并获取我们保存在与每个命令相关的LDS中的结果。 最后,,每个通道都可以准确地确定其输出应该去哪里,并通过打包图像存储内部函数输出它。
Slide 77
📌 要点汇总
- 手动转换着色结果:将着色结果转换为内存中的最终原始形式并缓存到LDS
- 循环遍历命令集:通过扩展命令集循环实现指令处理
- 解码获取LDS结果:解码命令并提取与命令关联的LDS存储结果
- 通道定位输出位置:每个通道根据计算确定图像输出目标位置
- 打包图像存储输出:通过图像存储内部函数完成最终输出打包
将输出广播到单个无人机的代码如下所示。
您可以看到,我们通过手动将着色结果转换为内存中的最终原始形式并将结果缓存在 LDS 中来启动 。 然后我们可以循环遍历扩展的命令集,解码它们并获取我们保存在与每个命令相关的LDS中的结果。 最后,,每个通道都可以准确地确定其输出应该去哪里,并通过打包图像存储内部函数输出它。
Slide 78
📌 要点汇总
- 手动转换着色结果:将着色结果转换为内存中的最终原始形式并缓存到LDS
- 循环遍历命令集:通过扩展命令集循环实现指令处理
- 解码获取LDS结果:解码命令并提取与命令关联的LDS存储结果
- 通道定位输出位置:每个通道根据计算确定图像输出目标位置
- 打包图像存储输出:
将输出广播到单个无人机的代码如下所示。
您可以看到,我们通过手动将着色结果转换为内存中的最终原始形式并将结果缓存在 LDS 中来启动 。 然后我们可以循环遍历扩展的命令集,解码它们并获取我们保存在与每个命令相关的LDS中的结果。 最后,,每个通道都可以准确地确定其输出应该去哪里,并通过打包图像存储内部函数输出它。
Slide 79
📌 要点汇总
- 手动内存转换:着色结果转为内存原始形式并缓存LDS
- 命令解码循环:遍历扩展命令集并解码LDS结果
- 输出位置确定:通道精准定位输出位置
- 图像存储打包:通过内部函数打包输出图像数据
将输出广播到单个无人机的代码如下所示。
您可以看到,我们通过手动将着色结果转换为内存中的最终原始形式并将结果缓存在 LDS 中来启动 。 然后我们可以循环遍历扩展的命令集,解码它们并获取我们保存在与每个命令相关的LDS中的结果。 最后,,每个通道都可以准确地确定其输出应该去哪里,并通过打包图像存储内部函数输出它。
Slide 80
📌 要点汇总
- 手动内存转换:着色结果转为内存原始形式并缓存LDS
- 命令解码循环:遍历扩展命令集并解码LDS结果
- 输出位置确定:通道精准定位输出位置
将输出广播到单个无人机的代码如下所示。
您可以看到,我们通过手动将着色结果转换为内存中的最终原始形式并将结果缓存在 LDS 中来启动 。 然后我们可以循环遍历扩展的命令集,解码它们并获取我们保存在与每个命令相关的LDS中的结果。 最后,,每个通道都可以准确地确定其输出应该去哪里,并通过打包图像存储内部函数输出它。
Slide 81
📌 要点汇总
- 手动转换着色结果:将着色结果转为内存中的原始形式并缓存到LDS
- 循环扩展命令集:遍历扩展命令集并解码获取LDS中保存的结果
- 确定输出位置:每个通道通过打包图像存储函数确定输出目标位置
- LDS缓存机制:利用LDS缓存中间结果实现高效数据访问
- 图像存储输出:最终通过图像存储内部函数完成像素输出
将输出广播到单个无人机的代码如下所示。
您可以看到,我们通过手动将着色结果转换为内存中的最终原始形式并将结果缓存在 LDS 中来启动 。 然后我们可以循环遍历扩展的命令集,解码它们并获取我们保存在与每个命令相关的LDS中的结果。 最后,,每个通道都可以准确地确定其输出应该去哪里,并通过打包图像存储内部函数输出它。
Slide 82
📌 要点汇总
- 手动转换着色结果:将着色结果转为内存中的原始形式并缓存到LDS
- 循环扩展命令集:遍历扩展命令集并解码获取LDS中保存的结果
- 确定输出位置:每个通道通过打包图像存储函数确定输出目标位置
- LDS缓存机制:利用LDS缓存中间结果实现高效数据访问
- 图像存储输出:最终通过图像存储内部函数完成像素输出
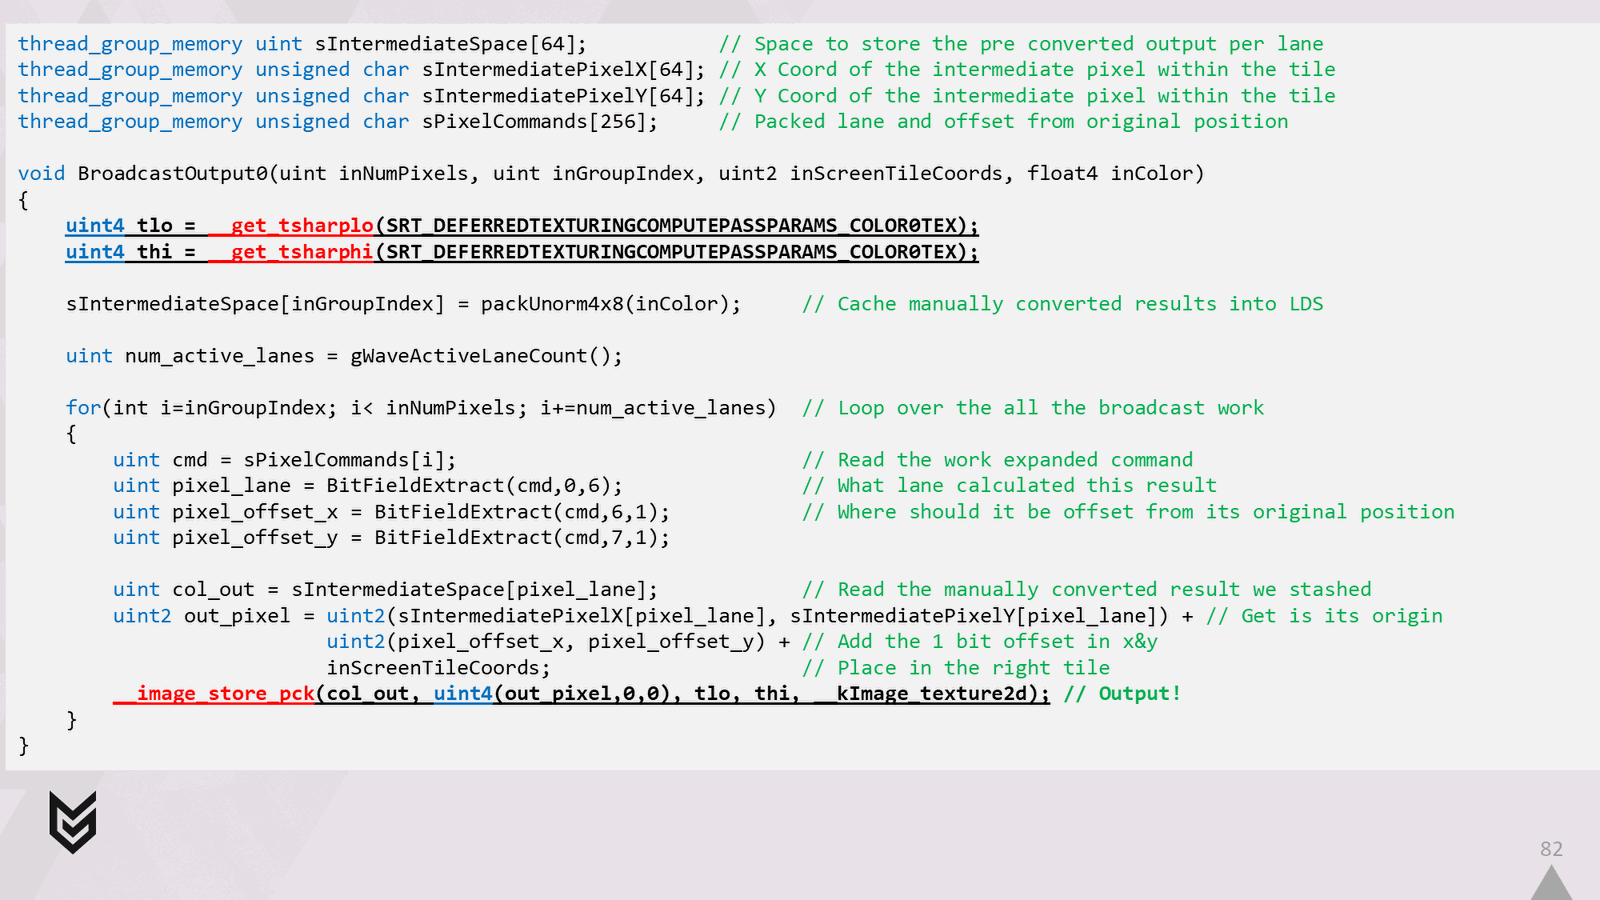
将输出广播到单个无人机的代码如下所示。
您可以看到,我们通过手动将着色结果转换为内存中的最终原始形式并将结果缓存在 LDS 中来启动 。 然后我们可以循环遍历扩展的命令集,解码它们并获取我们保存在与每个命令相关的LDS中的结果。 最后,,每个通道都可以准确地确定其输出应该去哪里,并通过打包图像存储内部函数输出它。
Slide 83
📌 要点汇总
- 插入代码片段:在着色器顶部添加LDS扩展命令列表生成代码
- 生成扩展命令:当波中通道需要广播时生成对应扩展命令
- 定位四边形像素:确定四边形左上角像素及阴影样本计算位置
- LDS起始位置:计算并记录通道命令在LDS中的存储起始地址
- 统计像素数量:计算wave波总像素输出数量用于后续处理
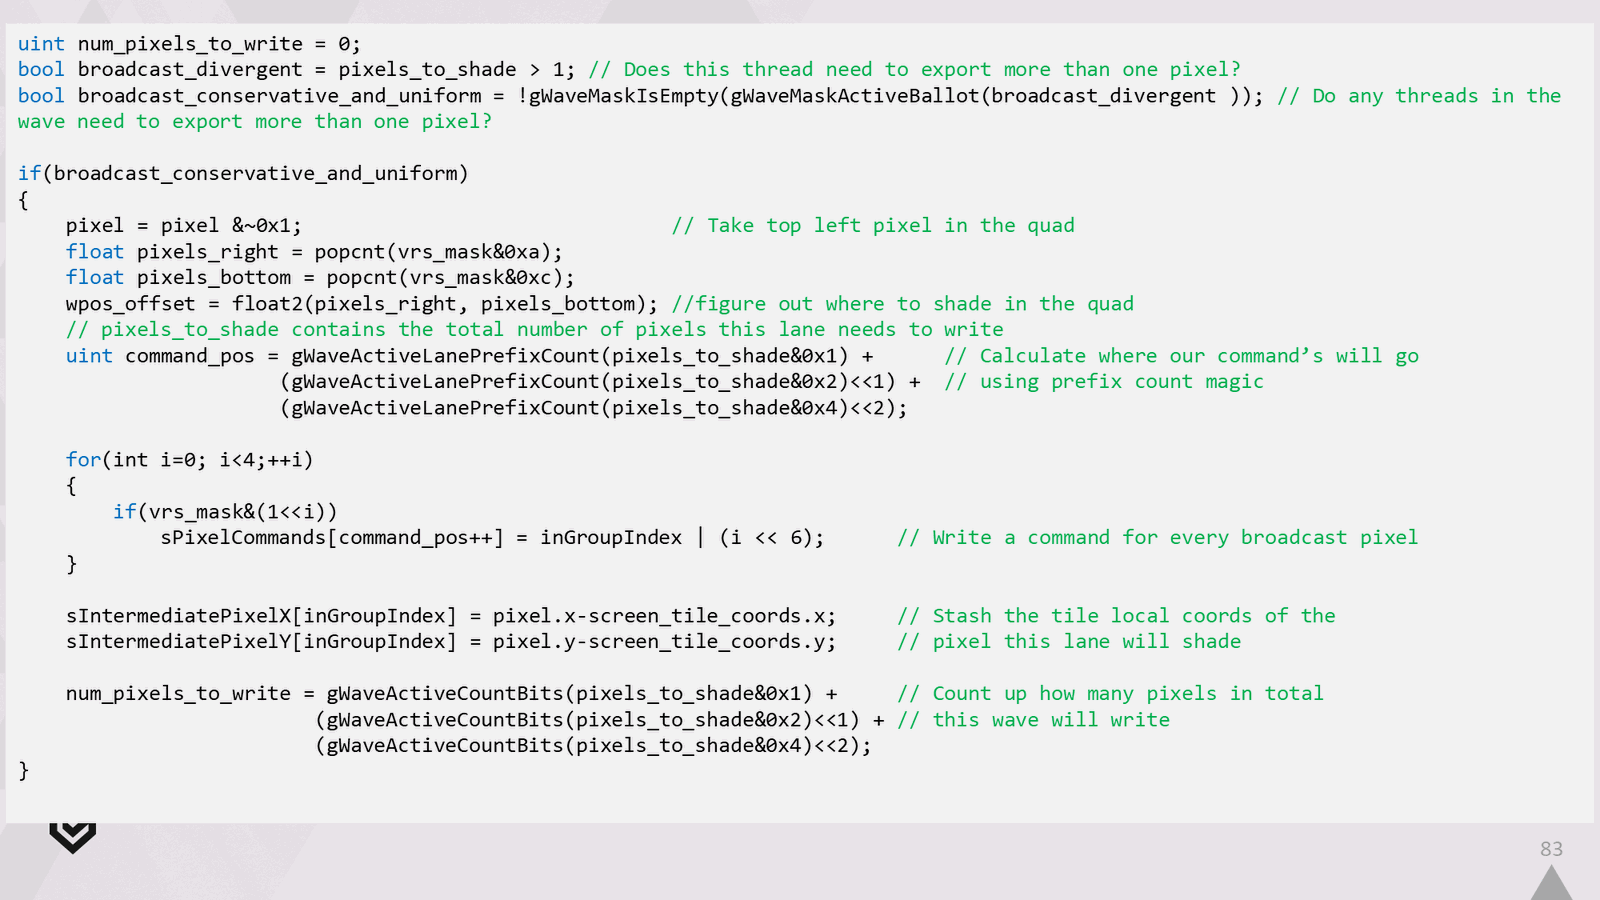
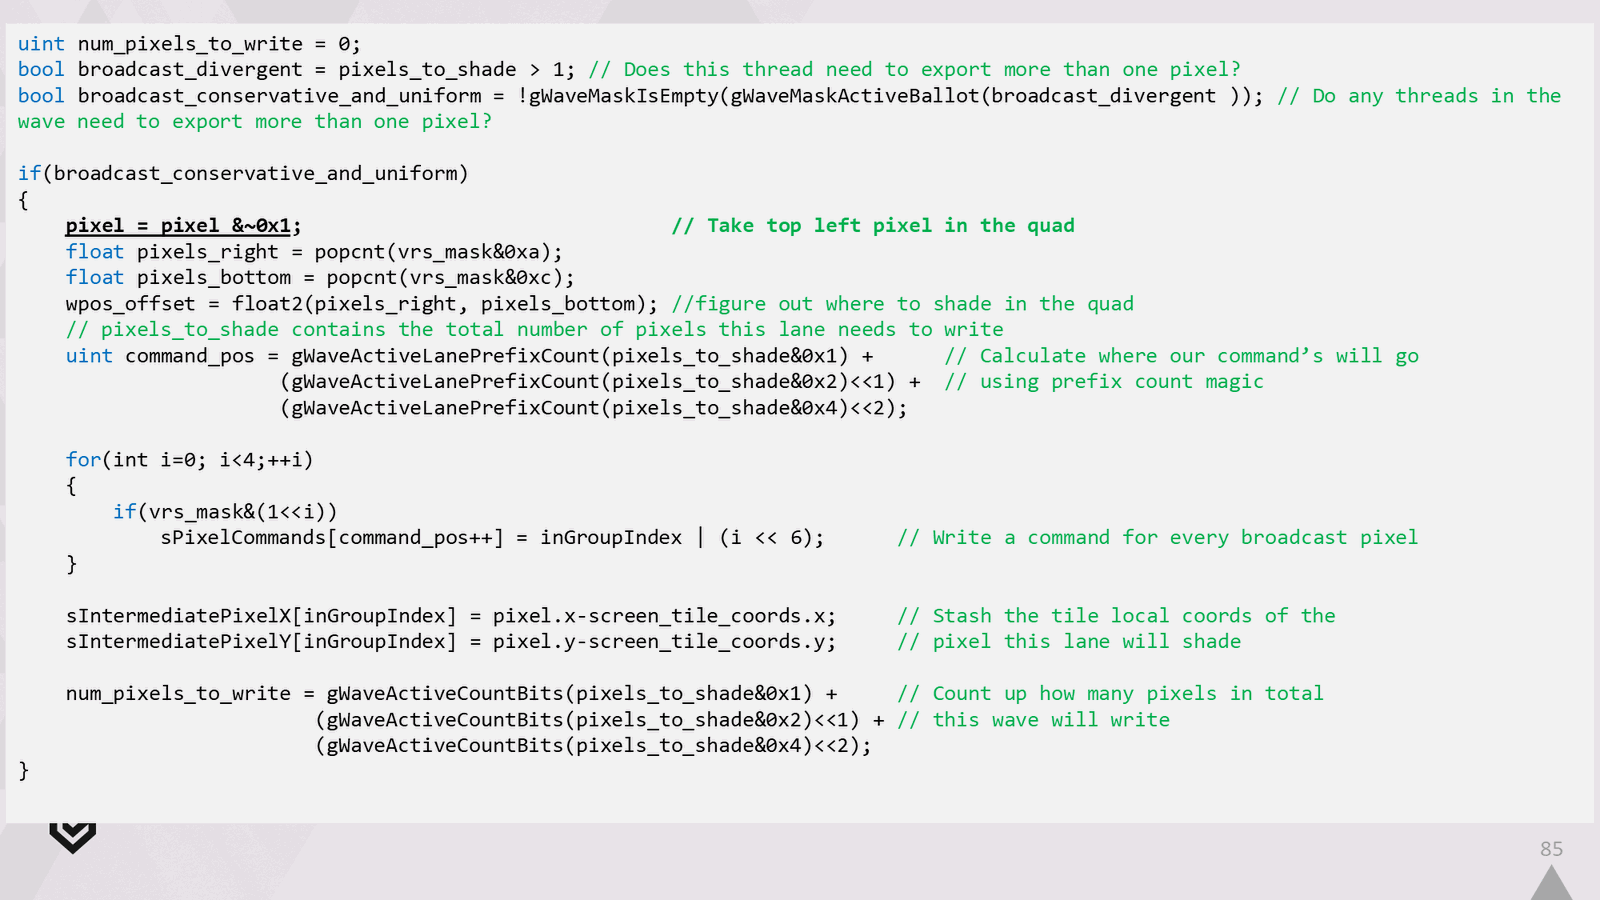
下面是我们需要在生成的着色器顶部附近插入的代码片段,以便在 LDS 中创建像素命令的扩展列表。
如果我们的波中的任何通道需要广播,我们需要生成这些扩展命令
对于每个泳道,我们然后找出四边形中的左上角像素,以及我们应该计算阴影样本的位置。 之后我们可以找出该通道的命令应在LDS中开始的位置,输出它们,并记录四边形在图块中的相对位置。 最后我们计算一下这个wave总共需要输出多少个像素。
Slide 84
📌 要点汇总
- 插入代码片段:在着色器顶部添加LDS扩展命令列表生成代码
- 生成扩展命令:当波中通道需要广播时生成
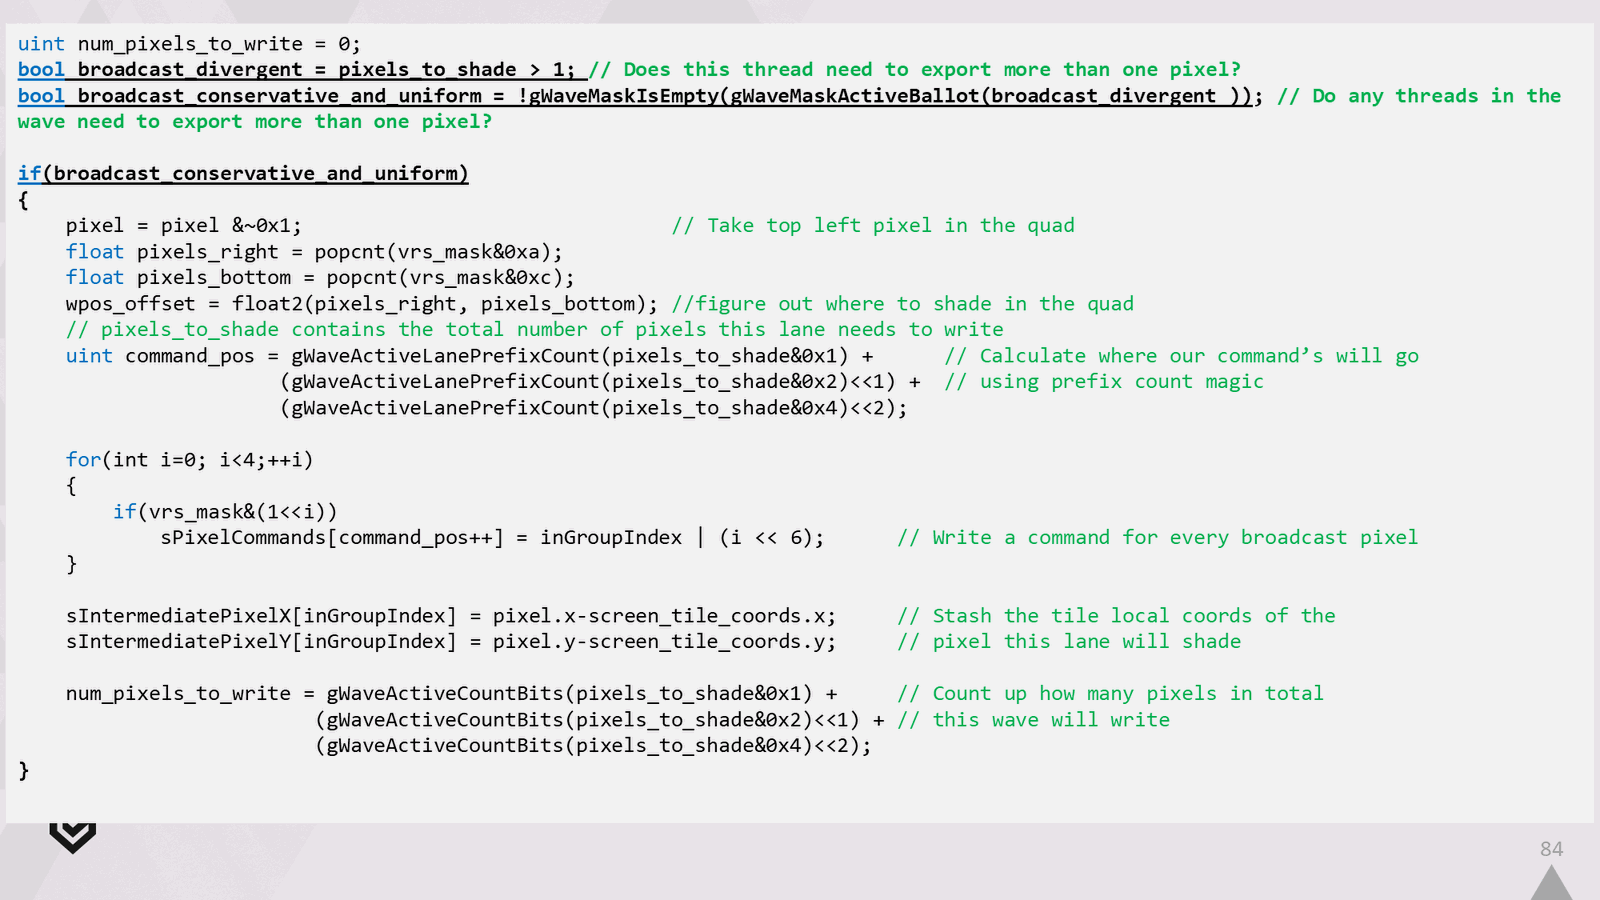
下面是我们需要在生成的着色器顶部附近插入的代码片段,以便在 LDS 中创建像素命令的扩展列表。
如果我们的波中的任何通道需要广播,我们需要生成这些扩展命令
对于每个泳道,我们然后找出四边形中的左上角像素,以及我们应该计算阴影样本的位置。 之后我们可以找出该通道的命令应在LDS中开始的位置,输出它们,并记录四边形在图块中的相对位置。 最后我们计算一下这个wave总共需要输出多少个像素。
Slide 85
📌 要点汇总
- (生成失败):解析批次响应时未找到此幻灯片
下面是我们需要在生成的着色器顶部附近插入的代码片段,以便在 LDS 中创建像素命令的扩展列表。
如果我们的波中的任何通道需要广播,我们需要生成这些扩展命令
对于每个泳道,我们然后找出四边形中的左上角像素,以及我们应该计算阴影样本的位置。 之后我们可以找出该通道的命令应在LDS中开始的位置,输出它们,并记录四边形在图块中的相对位置。 最后我们计算一下这个wave总共需要输出多少个像素。
Slide 86
📌 要点汇总
- 插入代码片段:在着色器顶部插入代码以创建LDS中的像素命令扩展列表
- 广播处理:若波中通道需广播,生成对应扩展命令
- 定位像素:确定四边形左上角像素及阴影样本位置
- LDS起始位置:计算通道命令在LDS中的起始地址并输出
- 记录位置:保存四边形在图块中的相对位置信息
- 像素统计:计算wave需输出的总像素数量
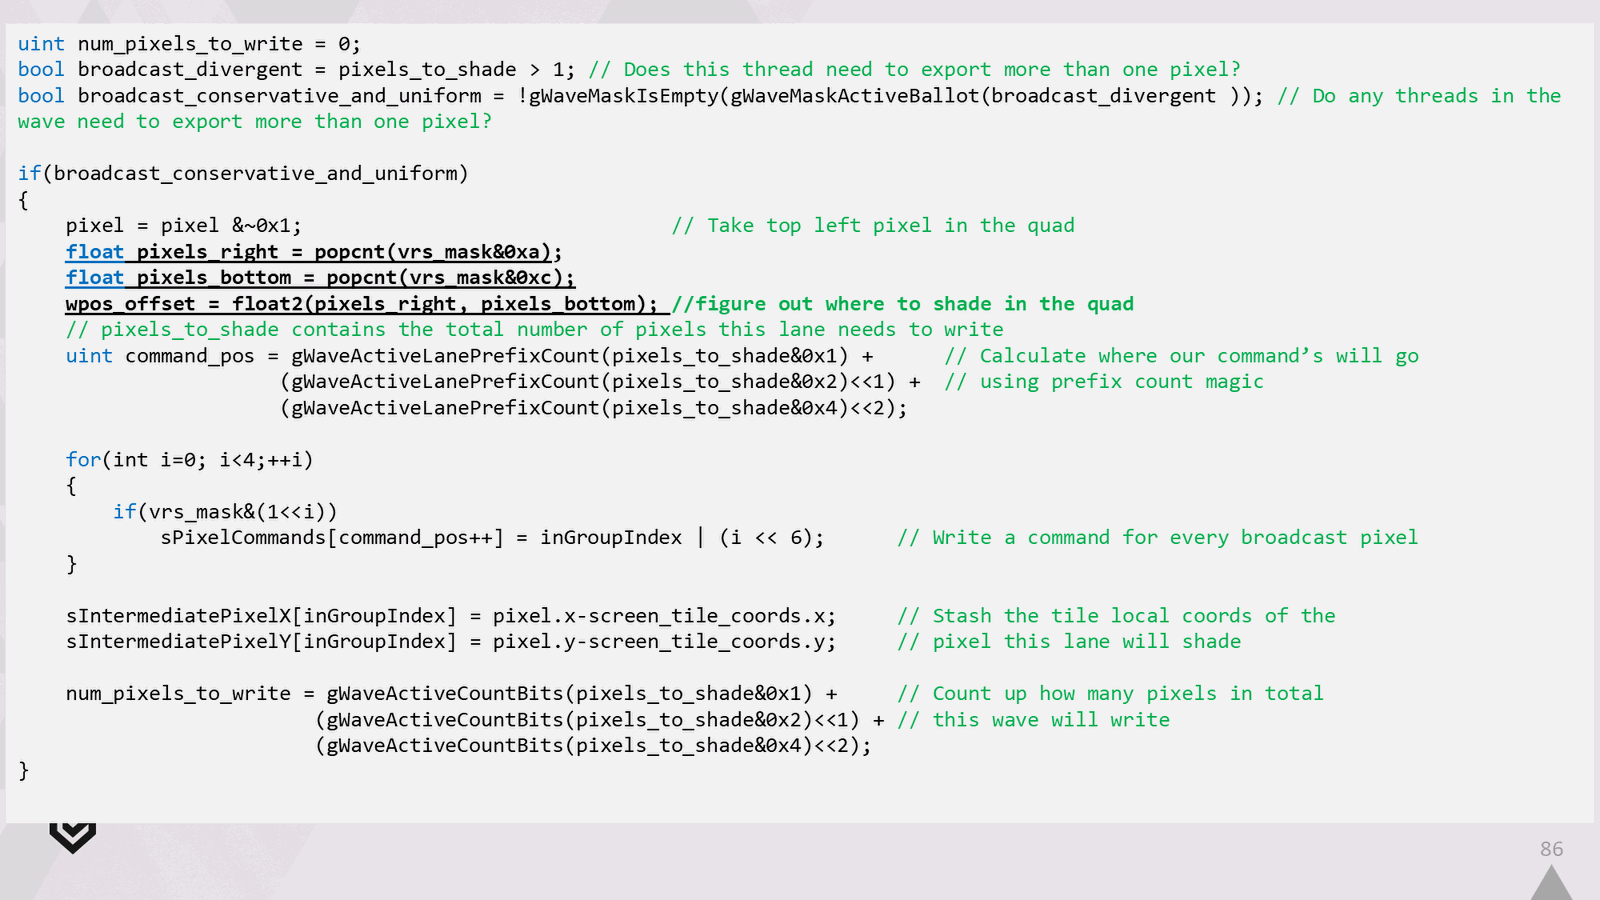
下面是我们需要在生成的着色器顶部附近插入的代码片段,以便在 LDS 中创建像素命令的扩展列表。
如果我们的波中的任何通道需要广播,我们需要生成这些扩展命令
对于每个泳道,我们然后找出四边形中的左上角像素,以及我们应该计算阴影样本的位置。 之后我们可以找出该通道的命令应在LDS中开始的位置,输出它们,并记录四边形在图块中的相对位置。 最后我们计算一下这个wave总共需要输出多少个像素。
Slide 87
📌 要点汇总
- 插入代码片段:在着色器顶部插入代码以创建LDS中的像素命令扩展列表
- 广播处理:若波中通道需广播,生成对应扩展命令
- 定位像素:确定四边形左上角像素及阴影样本位置
- LDS起始位置:计算通道命令在LDS中的起始地址并输出
- 记录位置:保存四边形在图块中的相对位置信息
- 像素统计:计算wave需输出的总像素数量
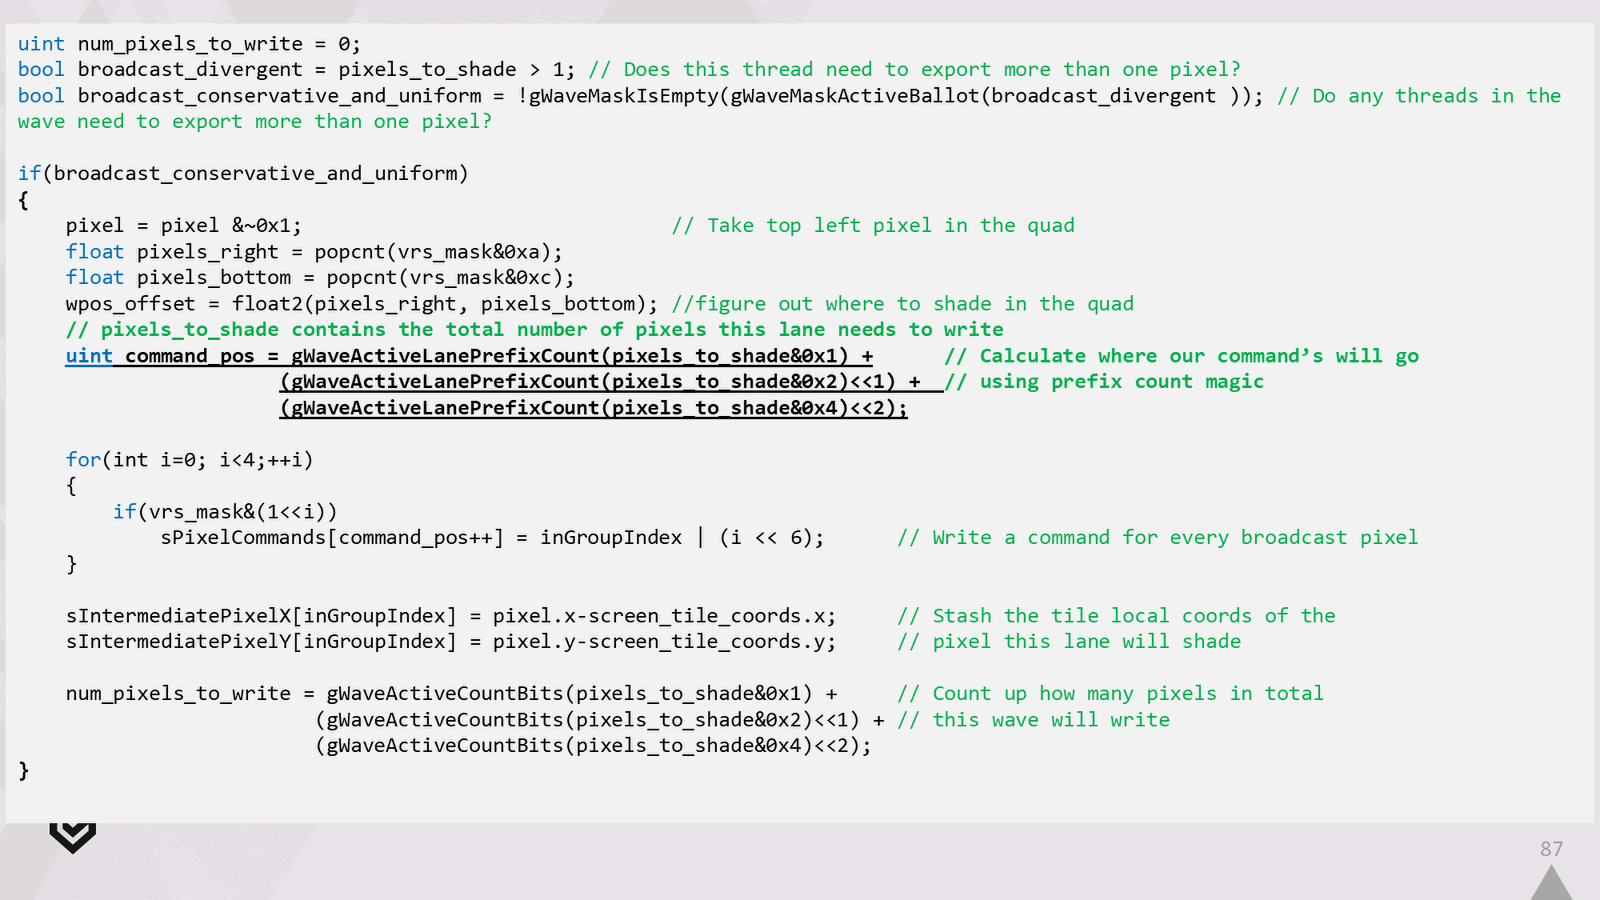
下面是我们需要在生成的着色器顶部附近插入的代码片段,以便在 LDS 中创建像素命令的扩展列表。
如果我们的波中的任何通道需要广播,我们需要生成这些扩展命令
对于每个泳道,我们然后找出四边形中的左上角像素,以及我们应该计算阴影样本的位置。 之后我们可以找出该通道的命令应在LDS中开始的位置,输出它们,并记录四边形在图块中的相对位置。 最后我们计算一下这个wave总共需要输出多少个像素。
Slide 88
📌 要点汇总
- 插入代码片段:在着色器顶部插入代码以创建LDS中的像素命令扩展列表
- 广播处理:若波中通道需广播,生成对应扩展命令
- 定位像素:确定四边形左上角像素及阴影样本位置
- LDS起始位置:计算通道命令在LDS中的起
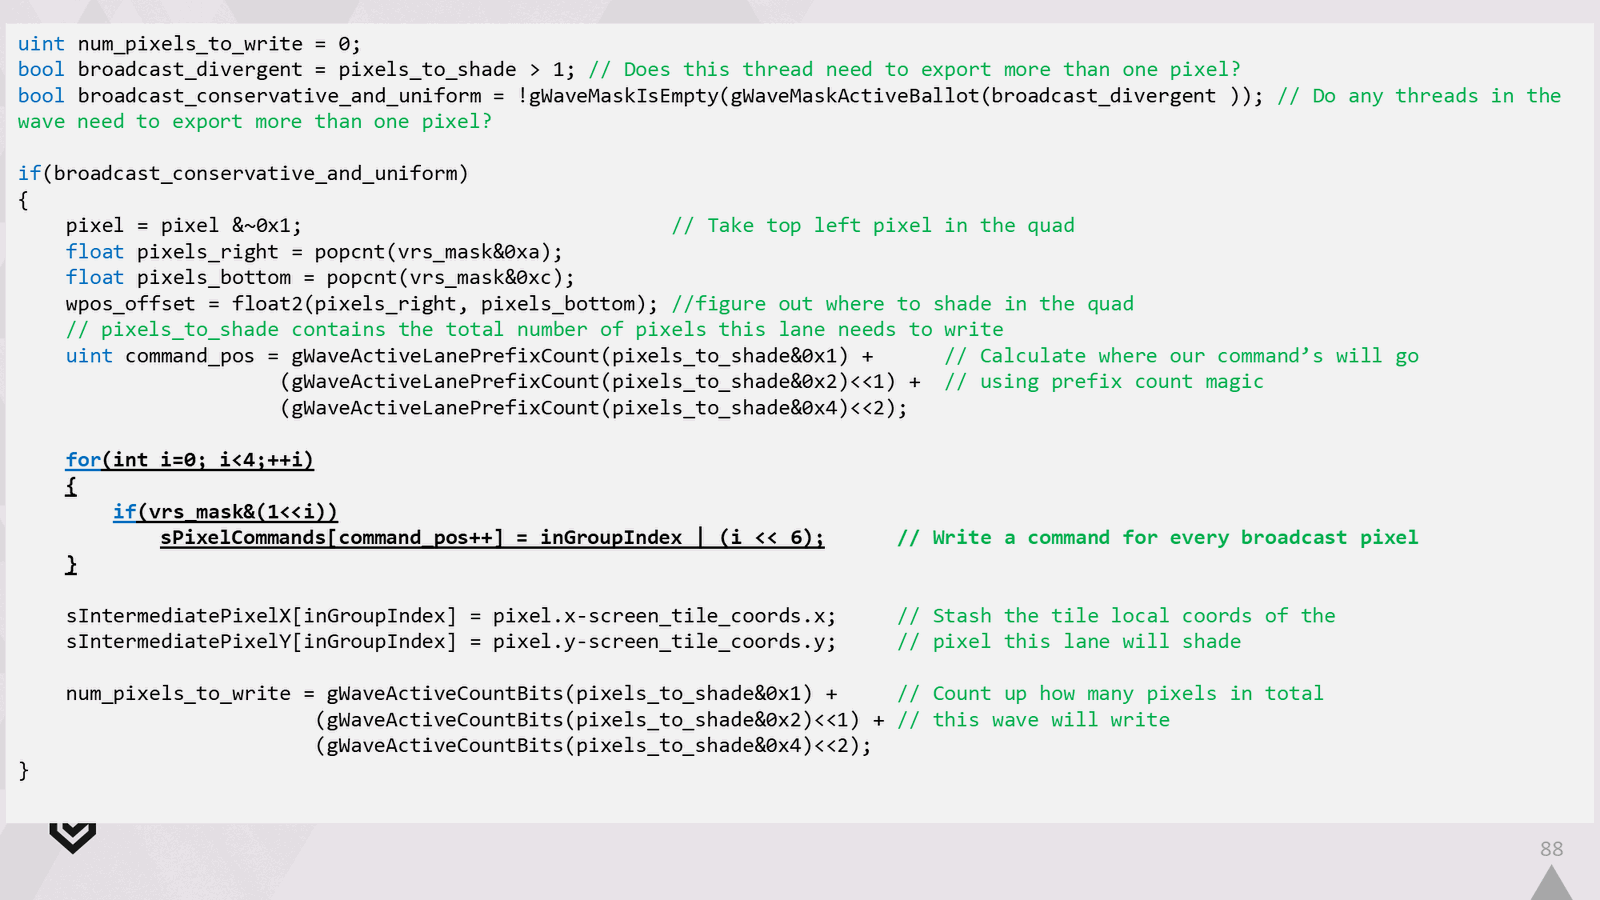
下面是我们需要在生成的着色器顶部附近插入的代码片段,以便在 LDS 中创建像素命令的扩展列表。
如果我们的波中的任何通道需要广播,我们需要生成这些扩展命令
对于每个泳道,我们然后找出四边形中的左上角像素,以及我们应该计算阴影样本的位置。 之后我们可以找出该通道的命令应在LDS中开始的位置,输出它们,并记录四边形在图块中的相对位置。 最后我们计算一下这个wave总共需要输出多少个像素。
Slide 89
📌 要点汇总
- 插入代码片段:在着色器顶部添加LDS扩展列表生成代码
- 生成扩展命令:当波中通道需要广播时创建对应命令
- 确定四边形坐标:定位每个泳道四边形的左上角像素
- 计算阴影样本:确定阴影采样位置的坐标参数
- 记录LDS偏移:计算并存储命令在LDS中的起始地址
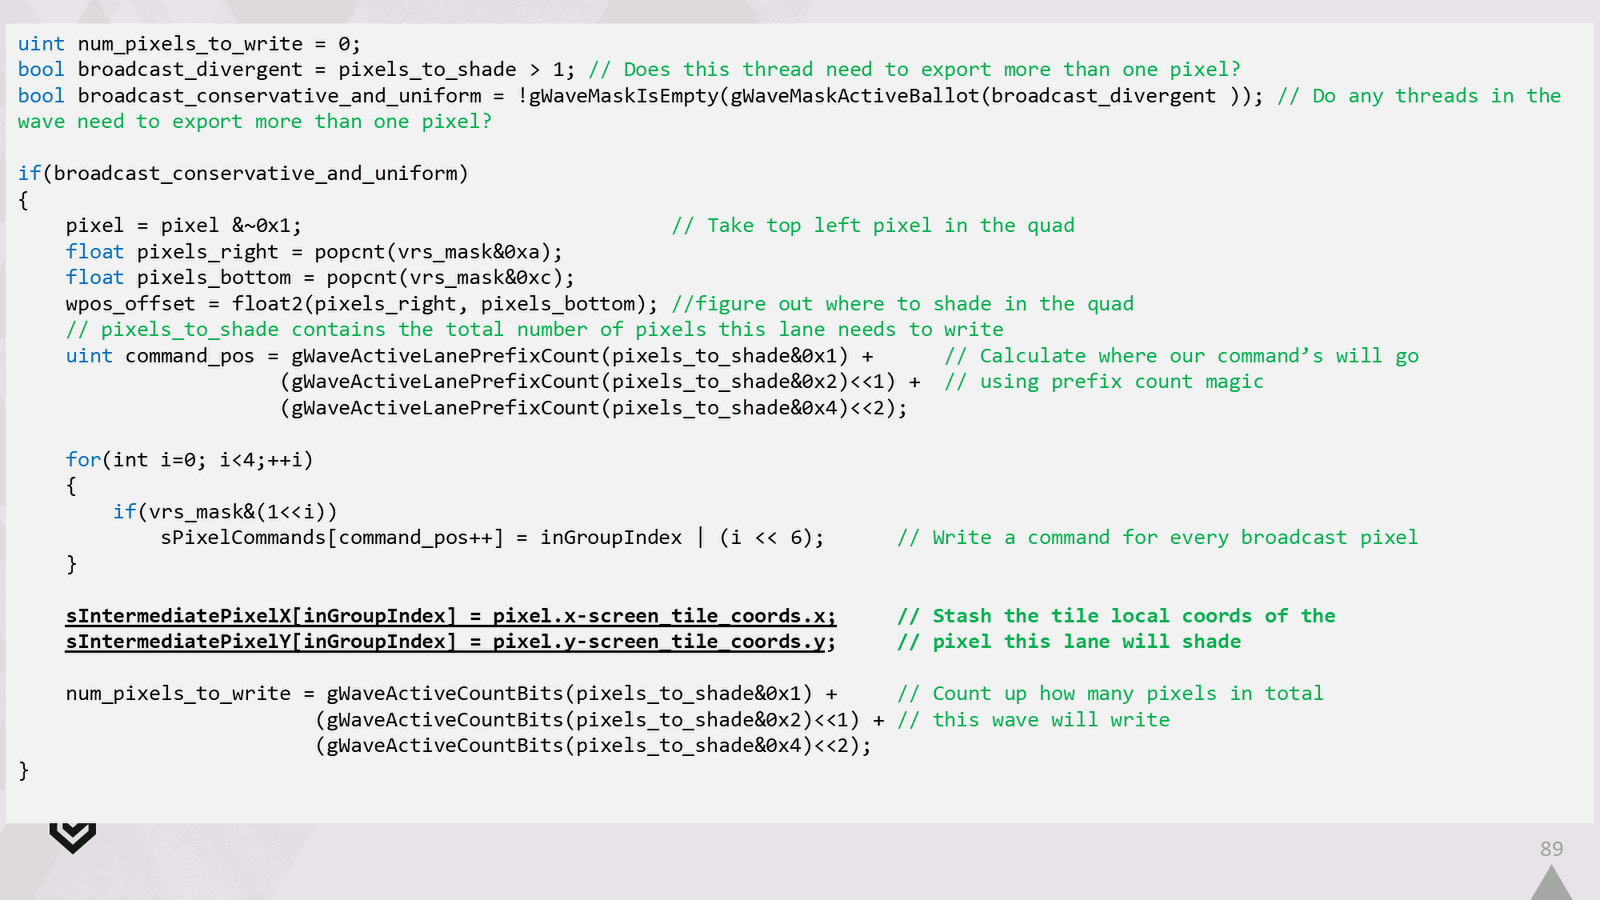
下面是我们需要在生成的着色器顶部附近插入的代码片段,以便在 LDS 中创建像素命令的扩展列表。
如果我们的波中的任何通道需要广播,我们需要生成这些扩展命令
对于每个泳道,我们然后找出四边形中的左上角像素,以及我们应该计算阴影样本的位置。 之后我们可以找出该通道的命令应在LDS中开始的位置,输出它们,并记录四边形在图块中的相对位置。 最后我们计算一下这个wave总共需要输出多少个像素。
Slide 90
📌 要点汇总
- 插入代码片段:在着色器顶部添加LDS扩展列表生成代码
- 生成扩展命令:当波中通道需要广播时创建对应命令
- 确定四边形坐标:定位每个泳道四边形的左上角像素
- 计算阴影样本:确定阴影采样位置的坐标参数
- 记录LDS偏移:计算并存储命令在LDS中的起始地址
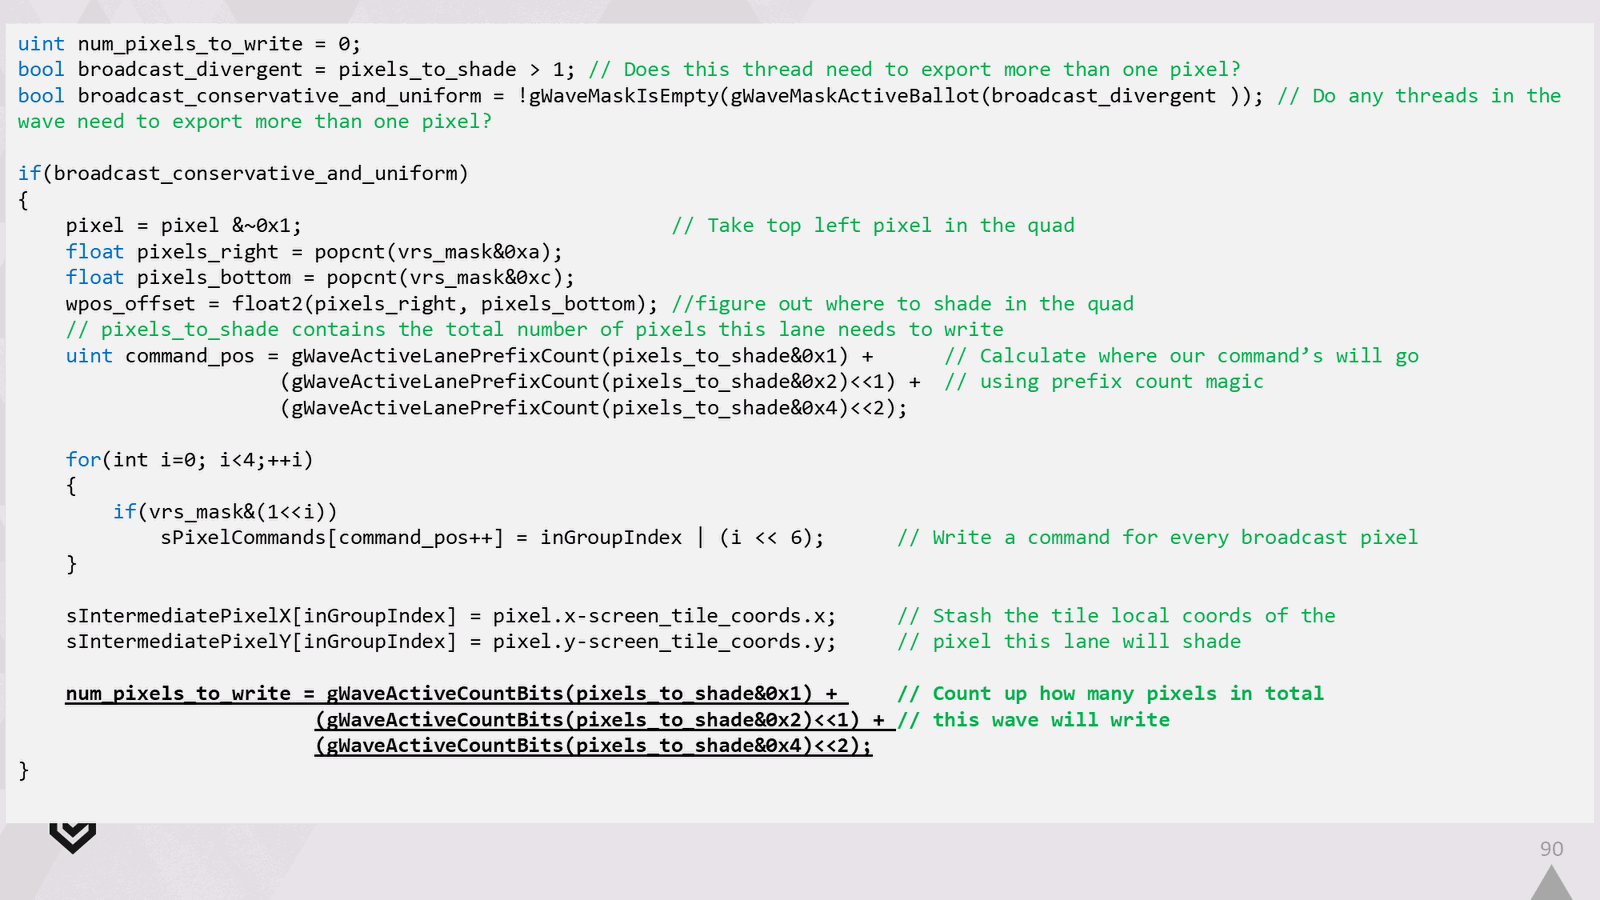
下面是我们需要在生成的着色器顶部附近插入的代码片段,以便在 LDS 中创建像素命令的扩展列表。
如果我们的波中的任何通道需要广播,我们需要生成这些扩展命令
对于每个泳道,我们然后找出四边形中的左上角像素,以及我们应该计算阴影样本的位置。 之后我们可以找出该通道的命令应在LDS中开始的位置,输出它们,并记录四边形在图块中的相对位置。 最后我们计算一下这个wave总共需要输出多少个像素。
Slide 91
📌 要点汇总
- 路径选择:着色器末尾决定快速路径与广播输出路径的切换
- 输出机制:两种渲染路径的切换逻辑直接影响最终画面输出
- 性能优化:通过路径选择实现渲染效率与画面质量的平衡
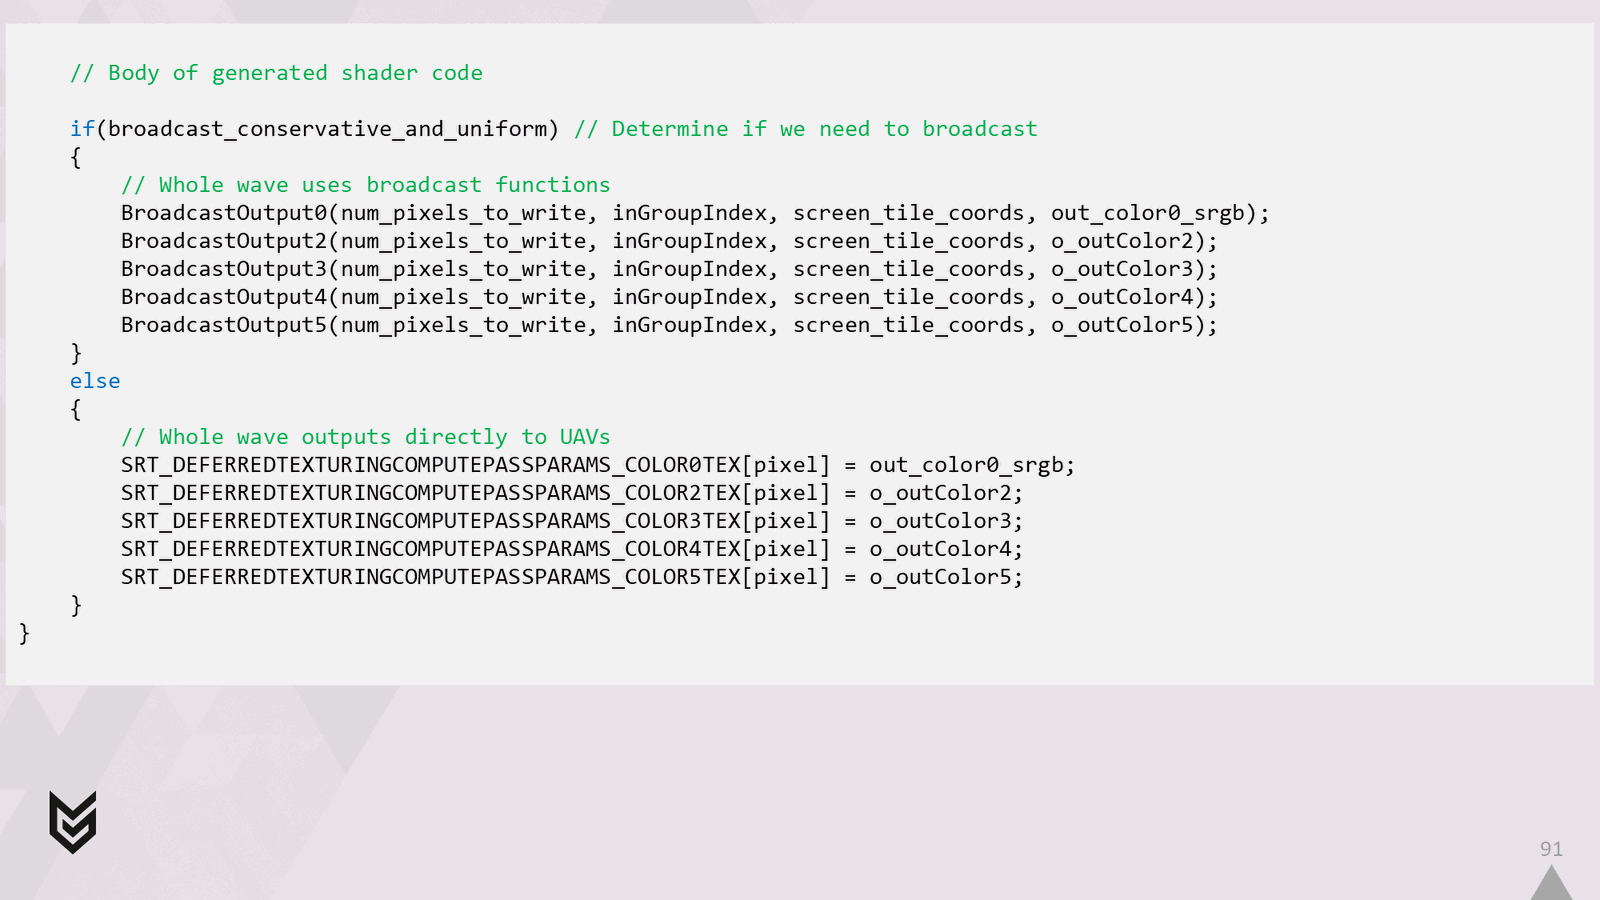
然后在着色器的末尾,我们在正常输出的快速路径和广播输出路径之间进行选择。
Slide 92
📌 要点汇总
- (无内容):此幻灯片无演讲内容
好吧,我在 VRS 上的时间就这么多了。让我们来看看整个系统的表现如何。
Slide 93
📌 要点汇总
- 计算工作块:阴影重叠区域呈现稳定的计算模块执行效果
- 环形缓冲区:顶点数据经过10次转换写入环形缓冲区
- 像素着色:利用缓冲区数据对屏幕像素进行着色处理
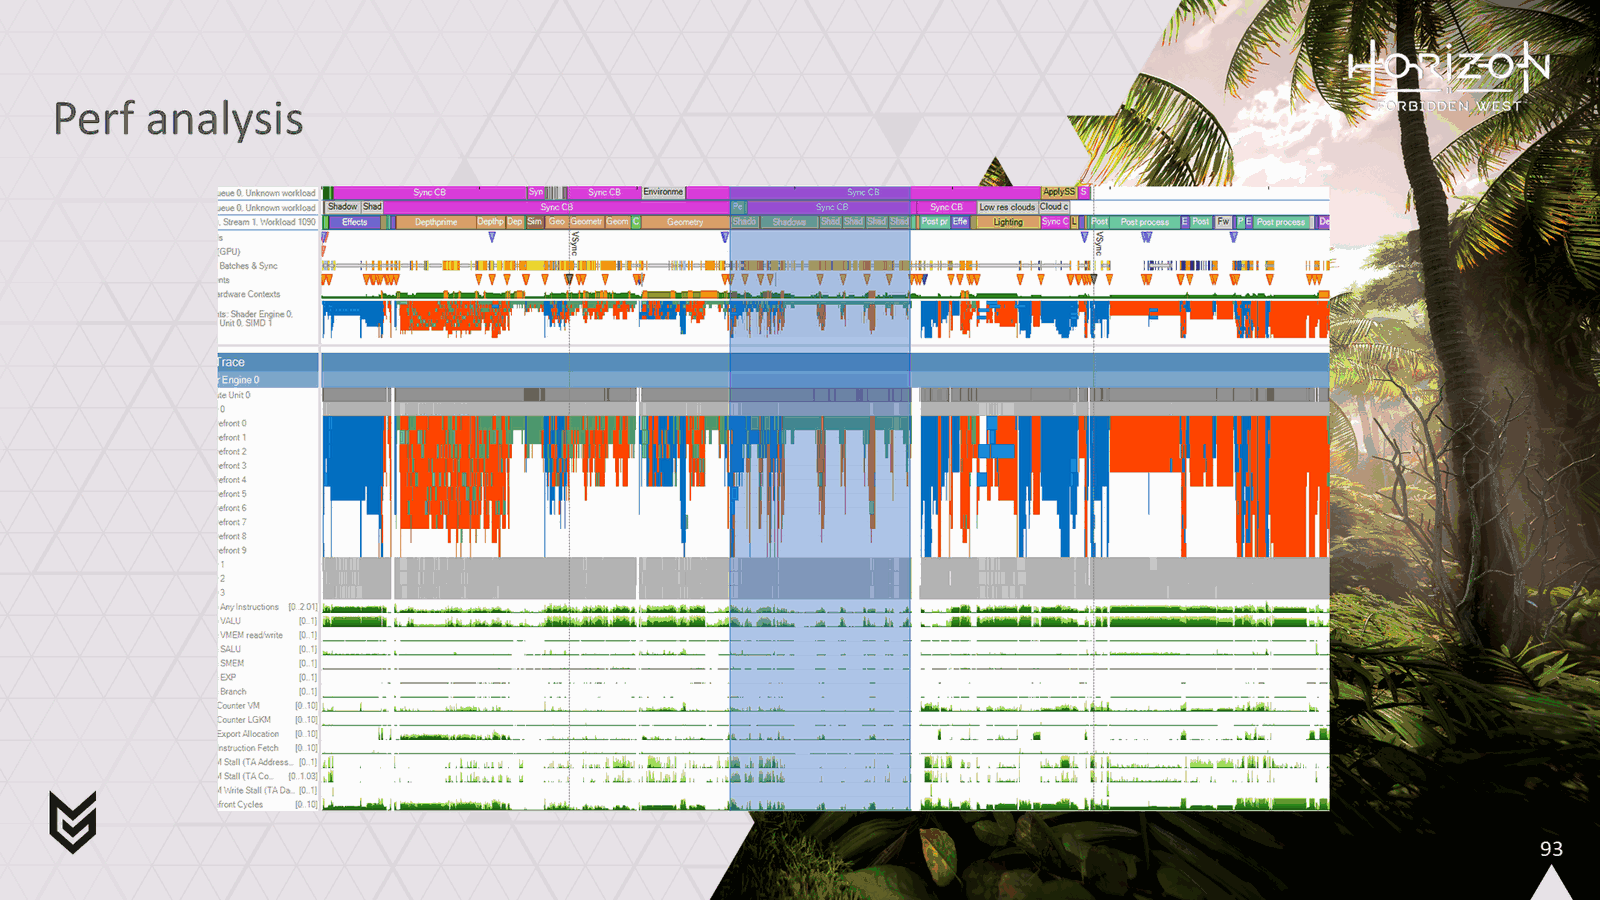
让我们看一下演示开始时带有大阴影帽的框架。 正如您所看到的,我们现在拥有看起来相当坚固的计算工作块,与阴影重叠。 实际上,这是将顶点转换为环形缓冲区的 10 遍,然后使用它来对屏幕上的像素进行着色。
Slide 94
📌 要点汇总
- 计算工作块:阴影重叠区域呈现稳定的计算模块执行效果
- 环形缓冲区:顶点数据经过10次转换写入环形缓冲区
- 像素着色:利用缓冲区数据对屏幕像素进行着色处理
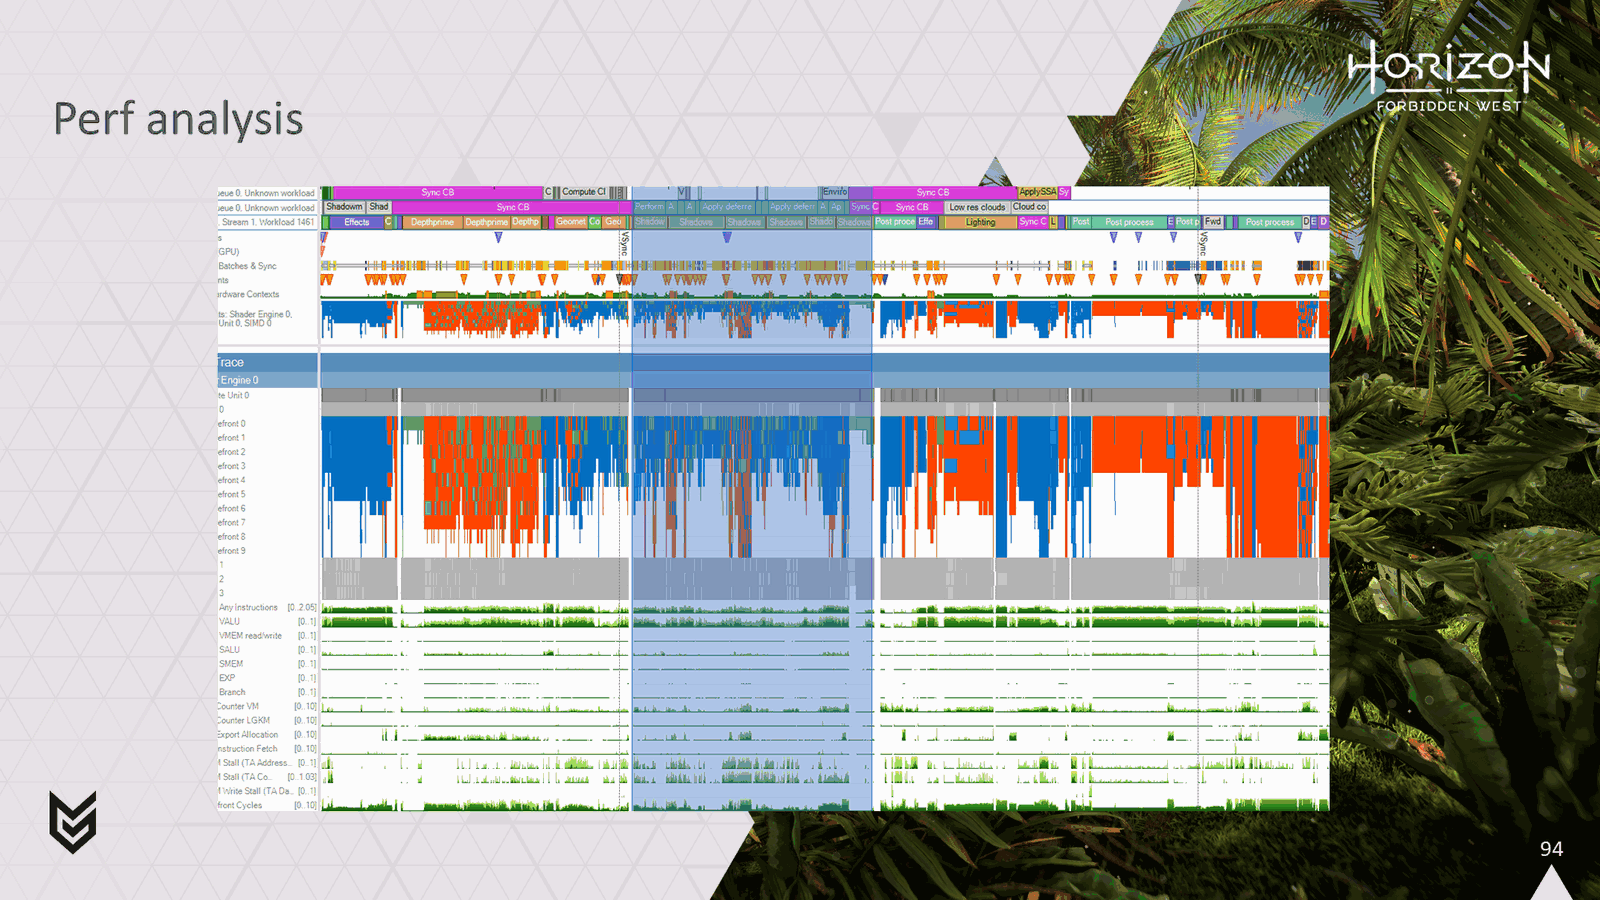
让我们看一下演示开始时带有大阴影帽的框架。 正如您所看到的,我们现在拥有看起来相当坚固的计算工作块,与阴影重叠。 实际上,这是将顶点转换为环形缓冲区的 10 遍,然后使用它来对屏幕上的像素进行着色。
Slide 95
📌 要点汇总
- 交错处理:像素着色与顶点着色工作在不同管道实现完美交错
- 波前区分:绿色波前代表像素工作,灰色波前代表顶点工作
- **管道分离
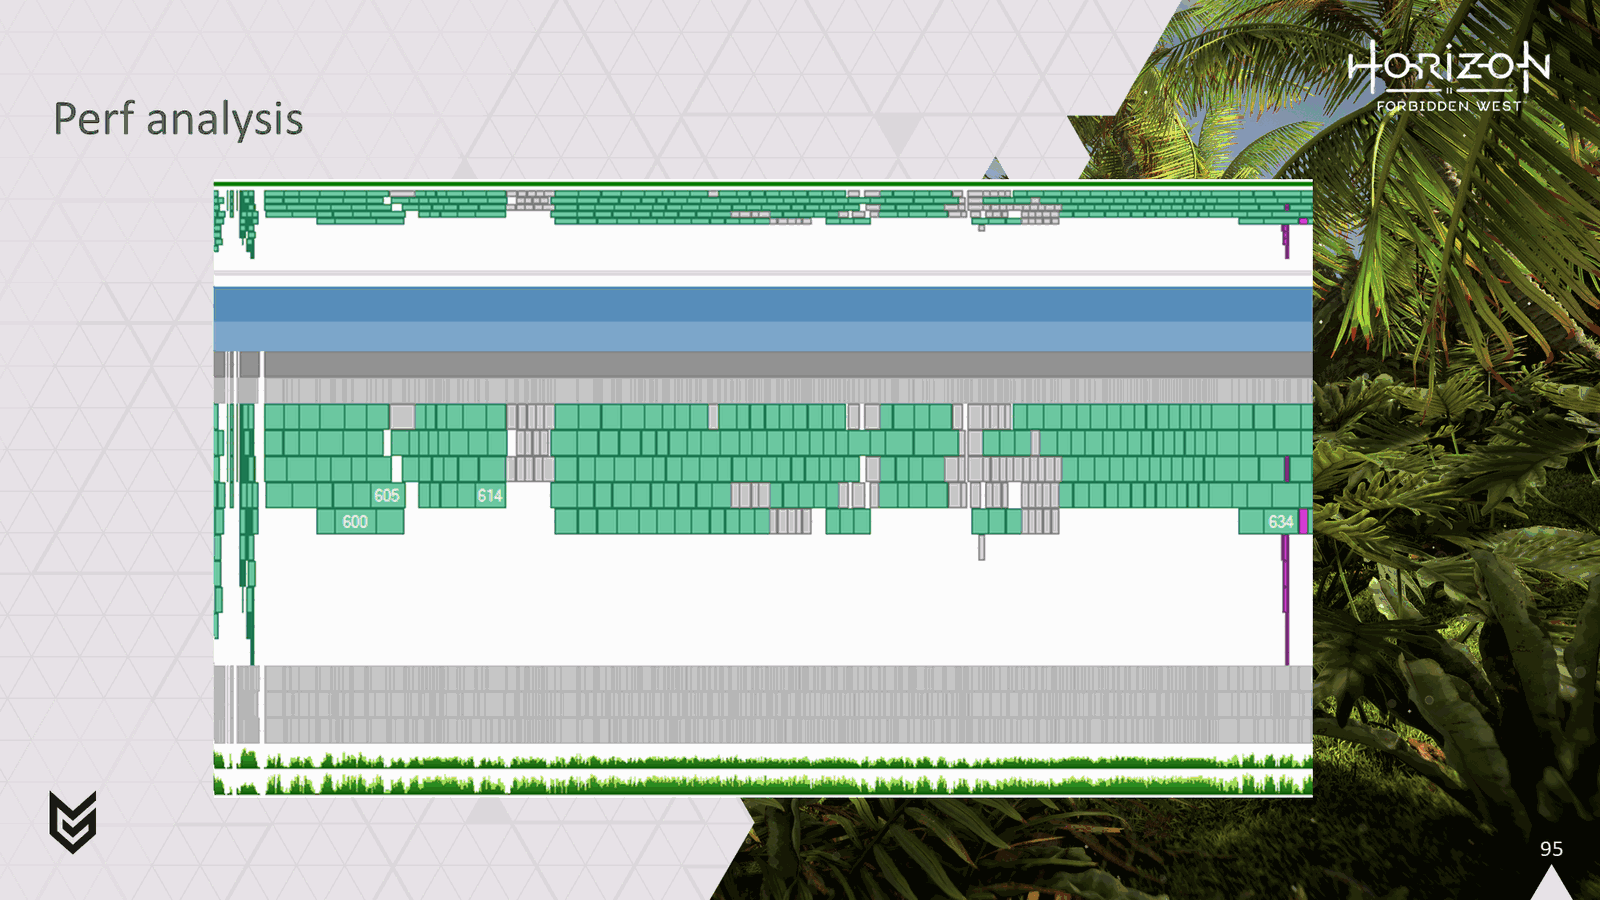
如果我们不与阴影重叠并在图形管道上运行像素着色工作,同时仍然在计算管道上保留顶点着色,您可以看到一切都是如何很好地交错的。 在这张图中,绿色波前是像素工作,灰色波前是顶点工作。
Slide 96
📌 要点汇总
- 基于批次着色:展示同一管道下不同批次的交错优化效果
- 性能提升:批次处理实现更高效的渲染流水线调度
- 可视化效果:通过交错减少GPU空闲时间提升帧率
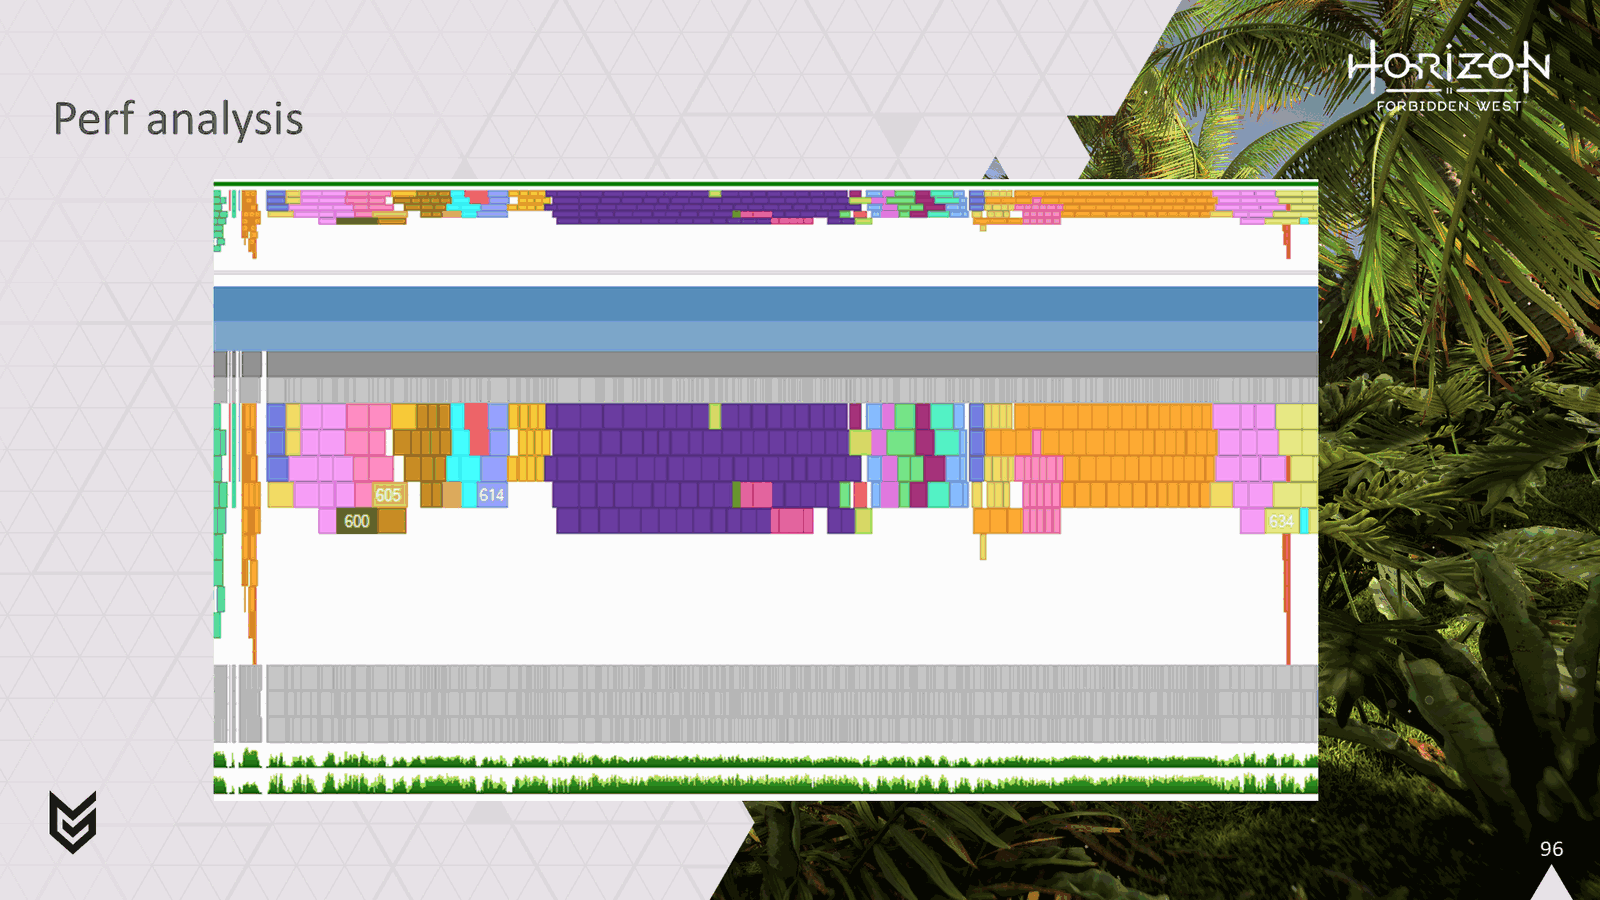
切换到基于批次的着色,您可以看到同一管道上的所有不同批次如何很好地交错。
Slide 97
📌 要点汇总
- 森林场景数据:PS5 4K下获1.4ms增益,PS4基础版获2.5ms提升
- 阴影重叠优化:PS4因阴影重叠实现显著性能突破
- 硬件差异:不同世代主机在相同技术下表现差异明显
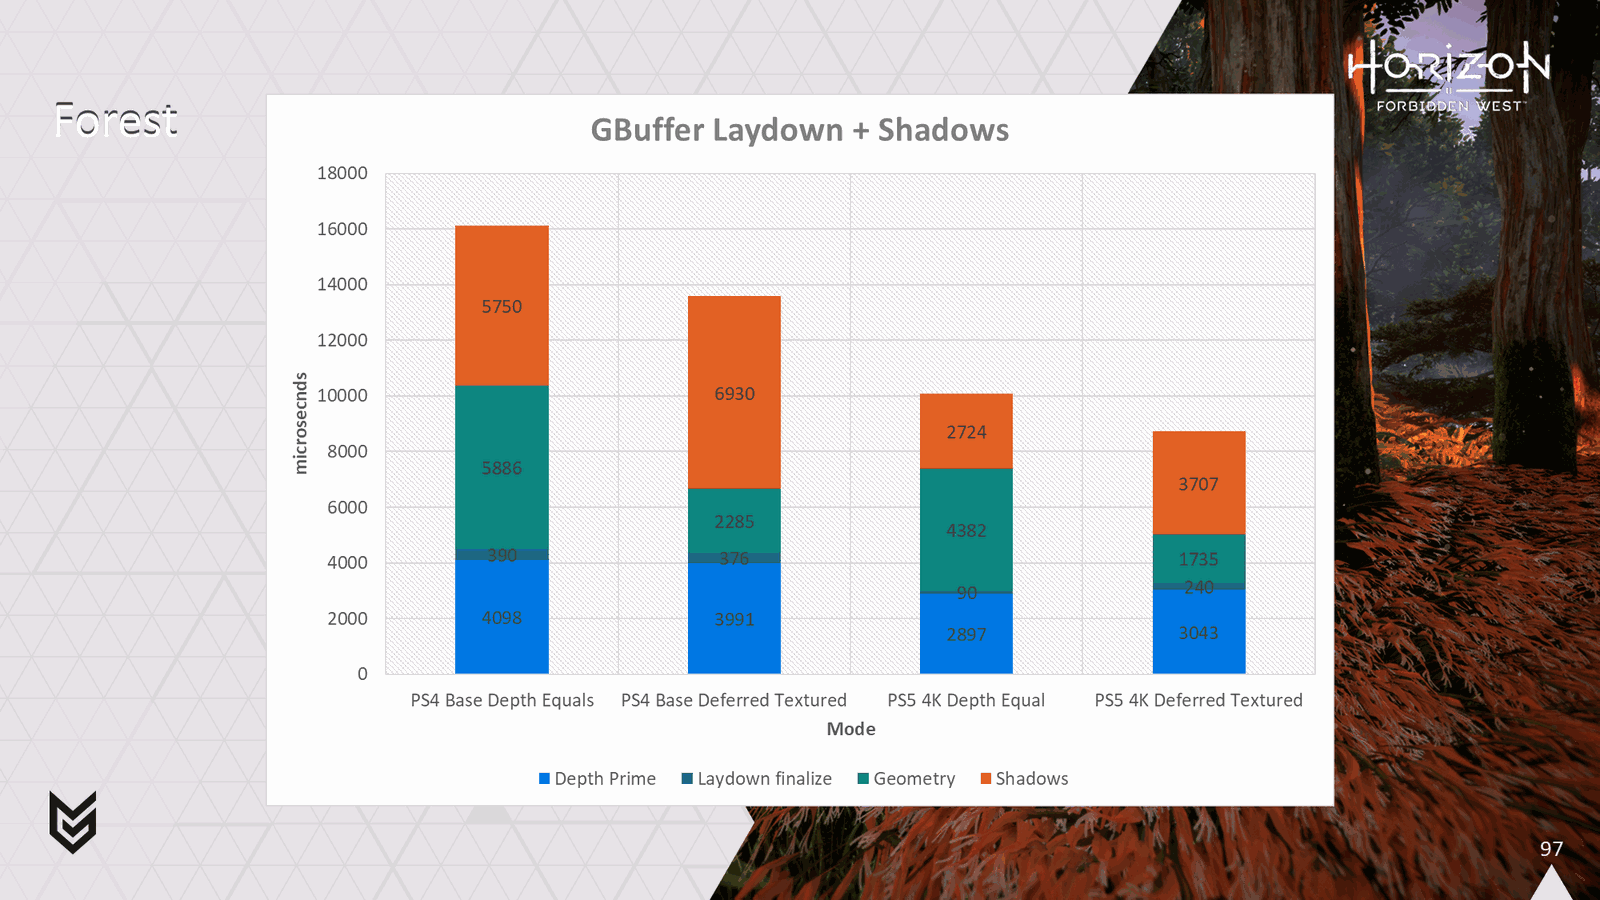
因此,这里有一些数字可以让您了解它在几个场景中的表现。 首先,我们有一个森林场景。 在这里您可以看到,我们在 4K 下的 PS5 上获得了大约 1.4 毫秒的合理增益,但真正的赢家是 PS4。 在基础 PS4 上,由于与阴影重叠,我们得到了近 2.5 毫秒的时间,这非常有用。
Slide 98
📌 要点汇总
- 几何通道迁移:树叶着色工作从几何通道转移到延迟纹理
- 时间占比优化:延迟纹理解决使该工作耗时降低
- 性能收益:分离几何通道工作带来显著效率提升
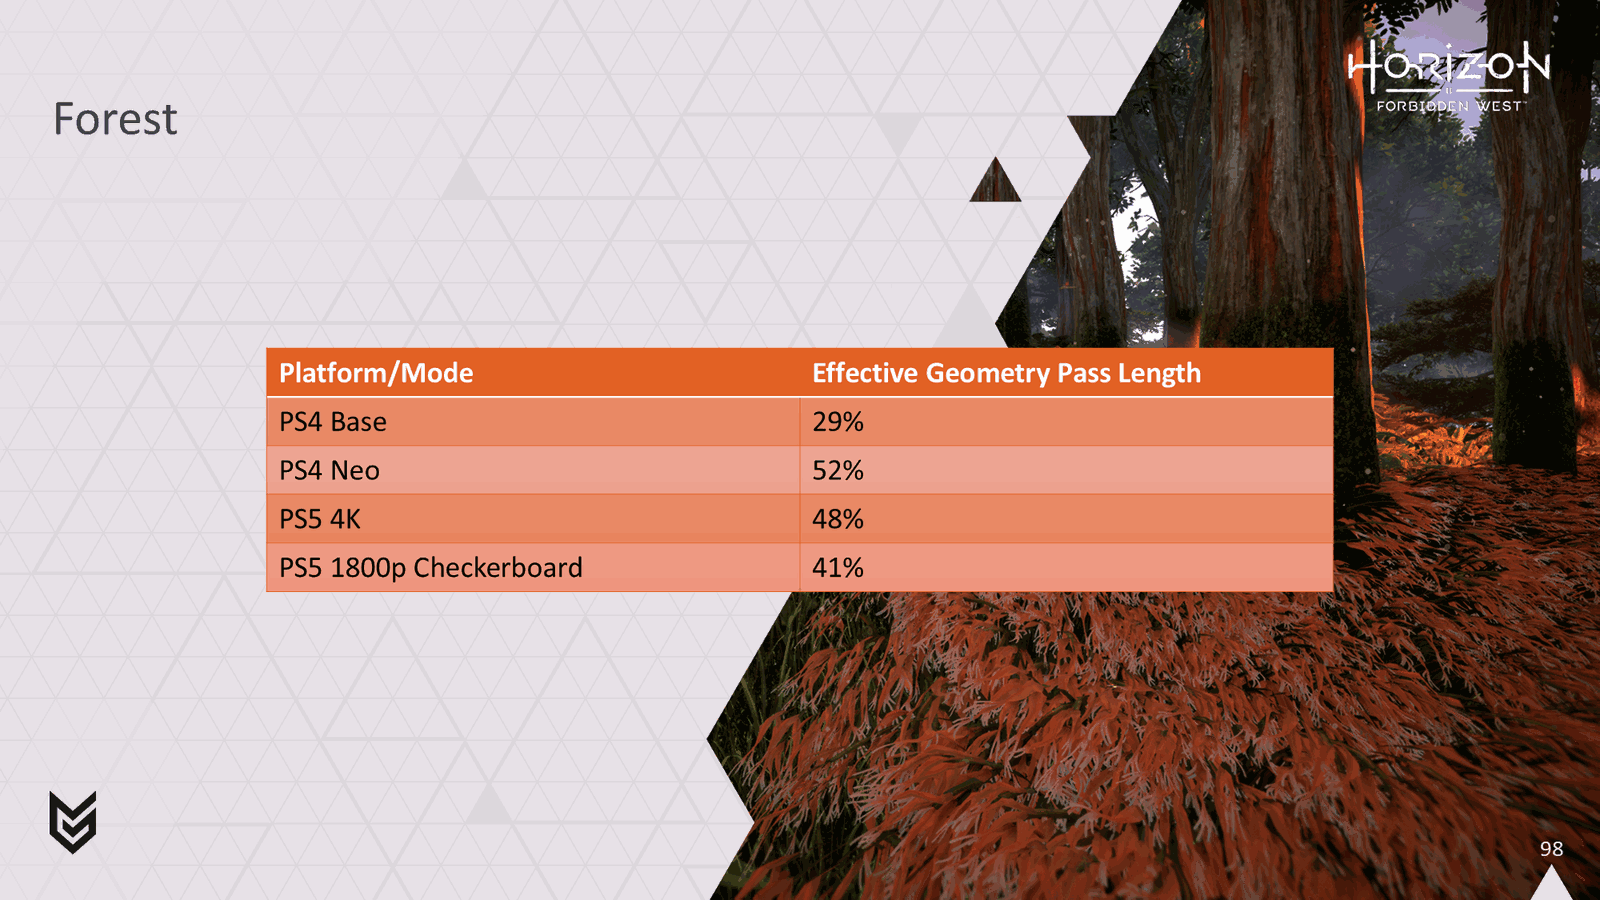
如果我们分离出我们过去在几何通道中为树叶着色的工作,并查看该工作现在在框架中有效占用了多少时间,因为它已通过延迟纹理解决并与阴影重叠,您可以看到我们获得了一些相当健康的收益。
Slide 99
📌 要点汇总
- 草原场景收益:PS4与PS5均获性能提升但幅度小于森林场景
- 顶点挑战:场景复杂度导致顶点处理成为瓶颈
- 剔除效率:低剔除效率影响整体性能表现
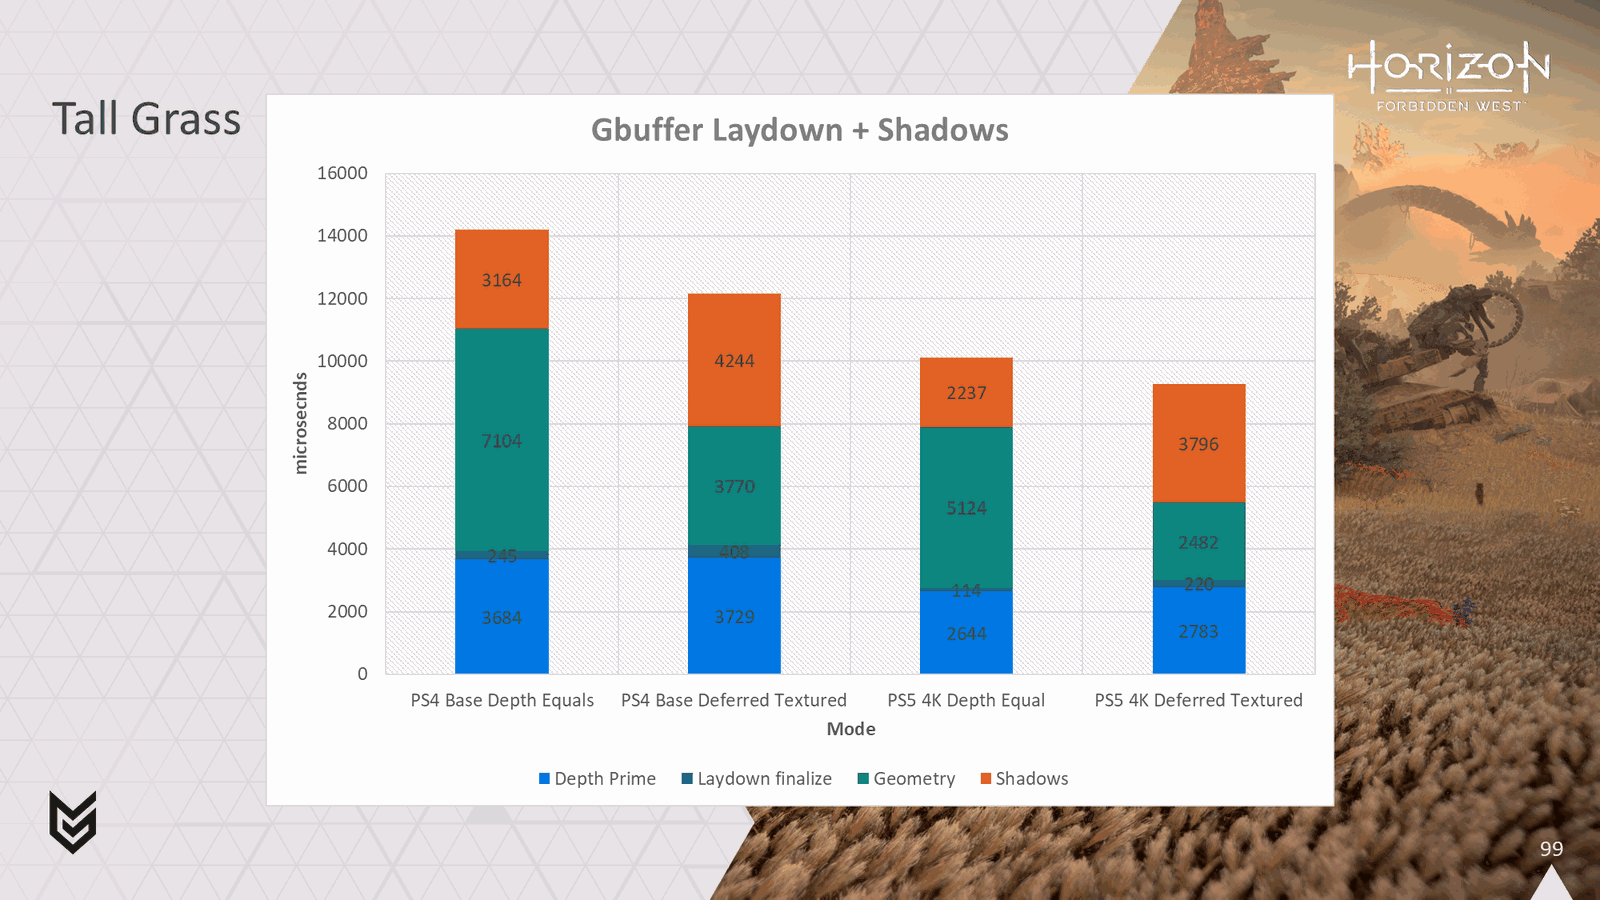
在这个草原场景中,您可以看到我们也获得了一些不错的收益,但不如森林那么多。 PS4 仍然是这里的大赢家,但 PS5 也受益。 这个场景稍微更具挑战性,因为顶点工作量太大,并且剔除效率较低。
Slide 100
📌 要点汇总
- 延迟纹理验证:几何通道工作迁移后仍保持有效时间占比
- 持续优化:延迟纹理解决带来持续性性能收益
- 技术验证:通过时间占比分析确认优化方案有效性
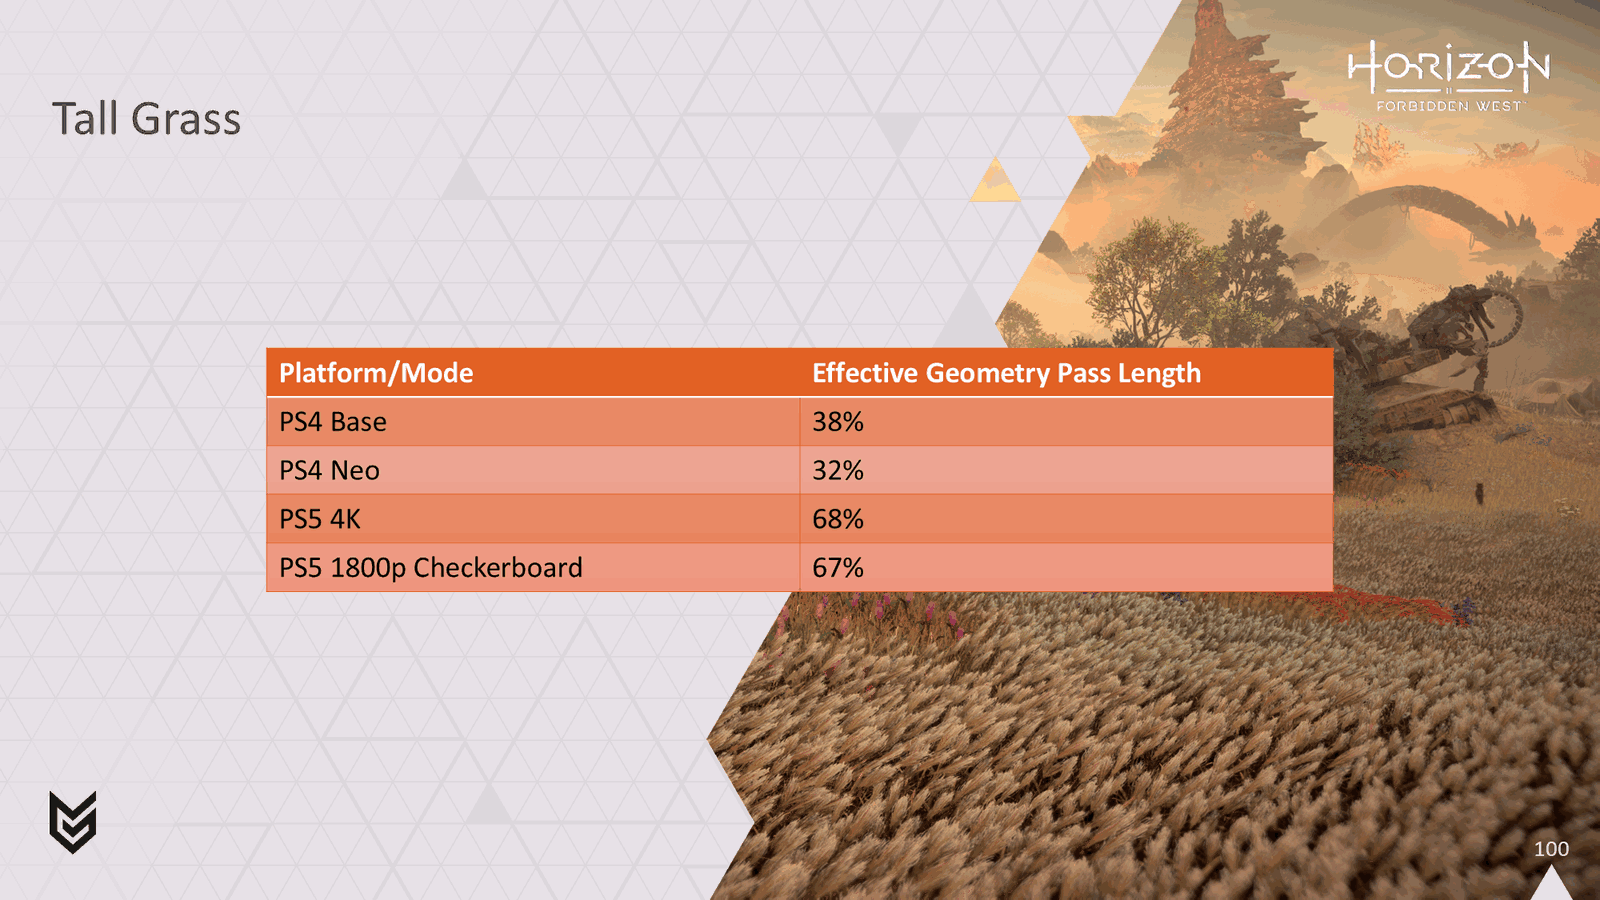
再次,如果您查看我们现在在延迟纹理中所做的工作(过去在几何通道中完成)的有效长度,您会发现我们仍然取得了一些不错的成果。
Slide 101
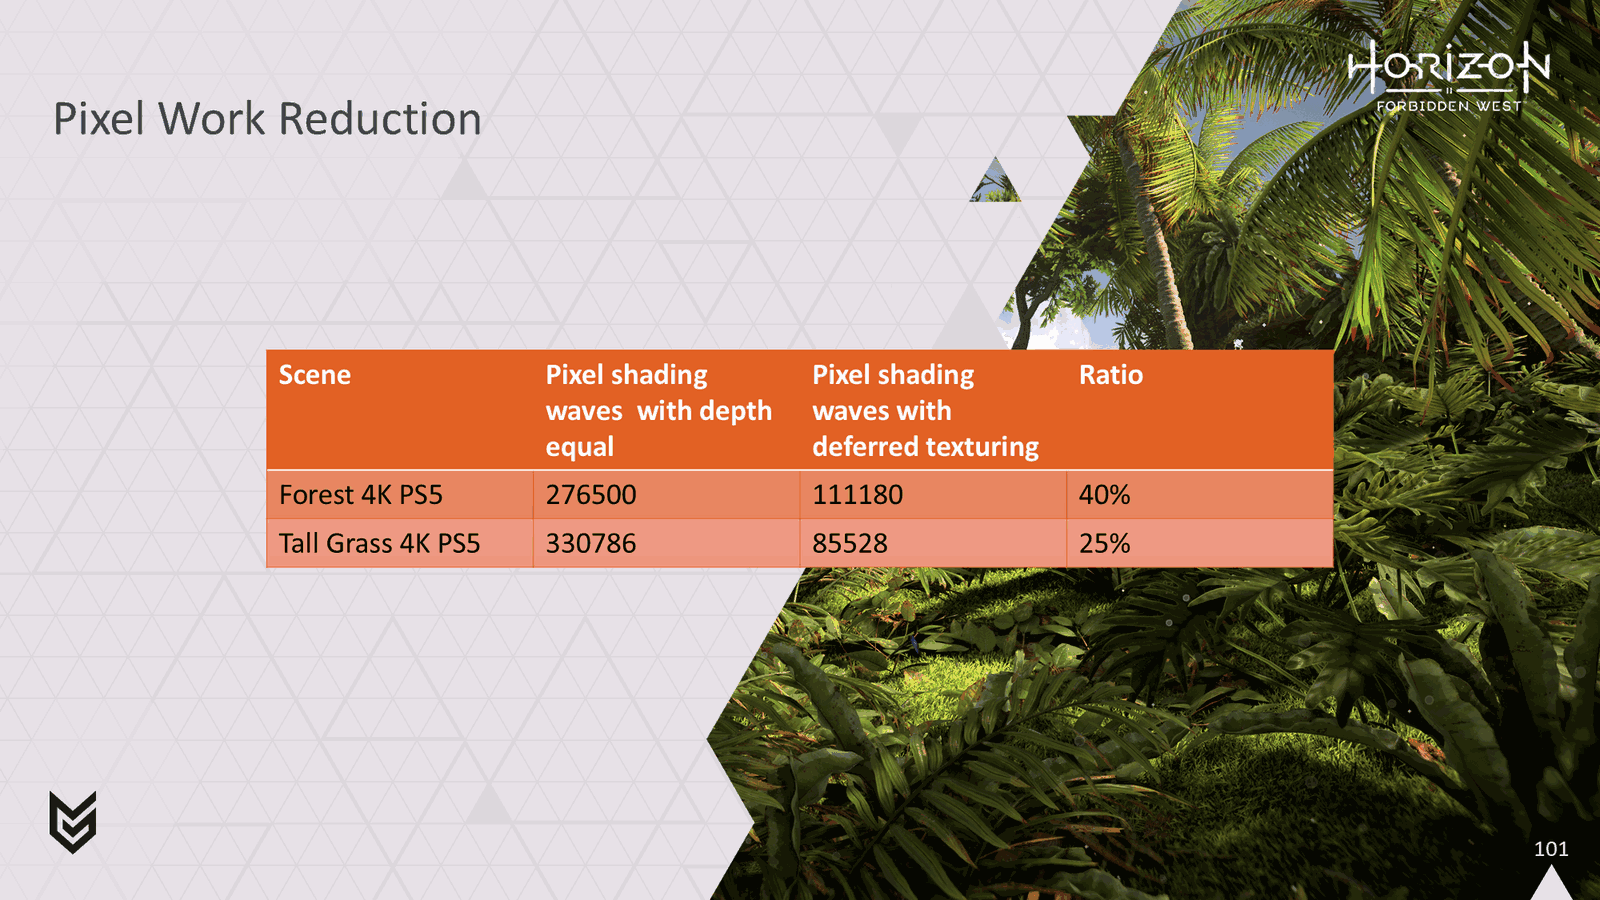
📌 要点汇总
- 像素优化:系统通过像素处理显著减少过度阴影
- 性能提升:优化技术降低渲染冗余工作量
- 视觉效果:改善阴影质量同时保持画面完整性
最后,我们还可以看到系统通过像素工作设法减少了多少过度阴影
Slide 102
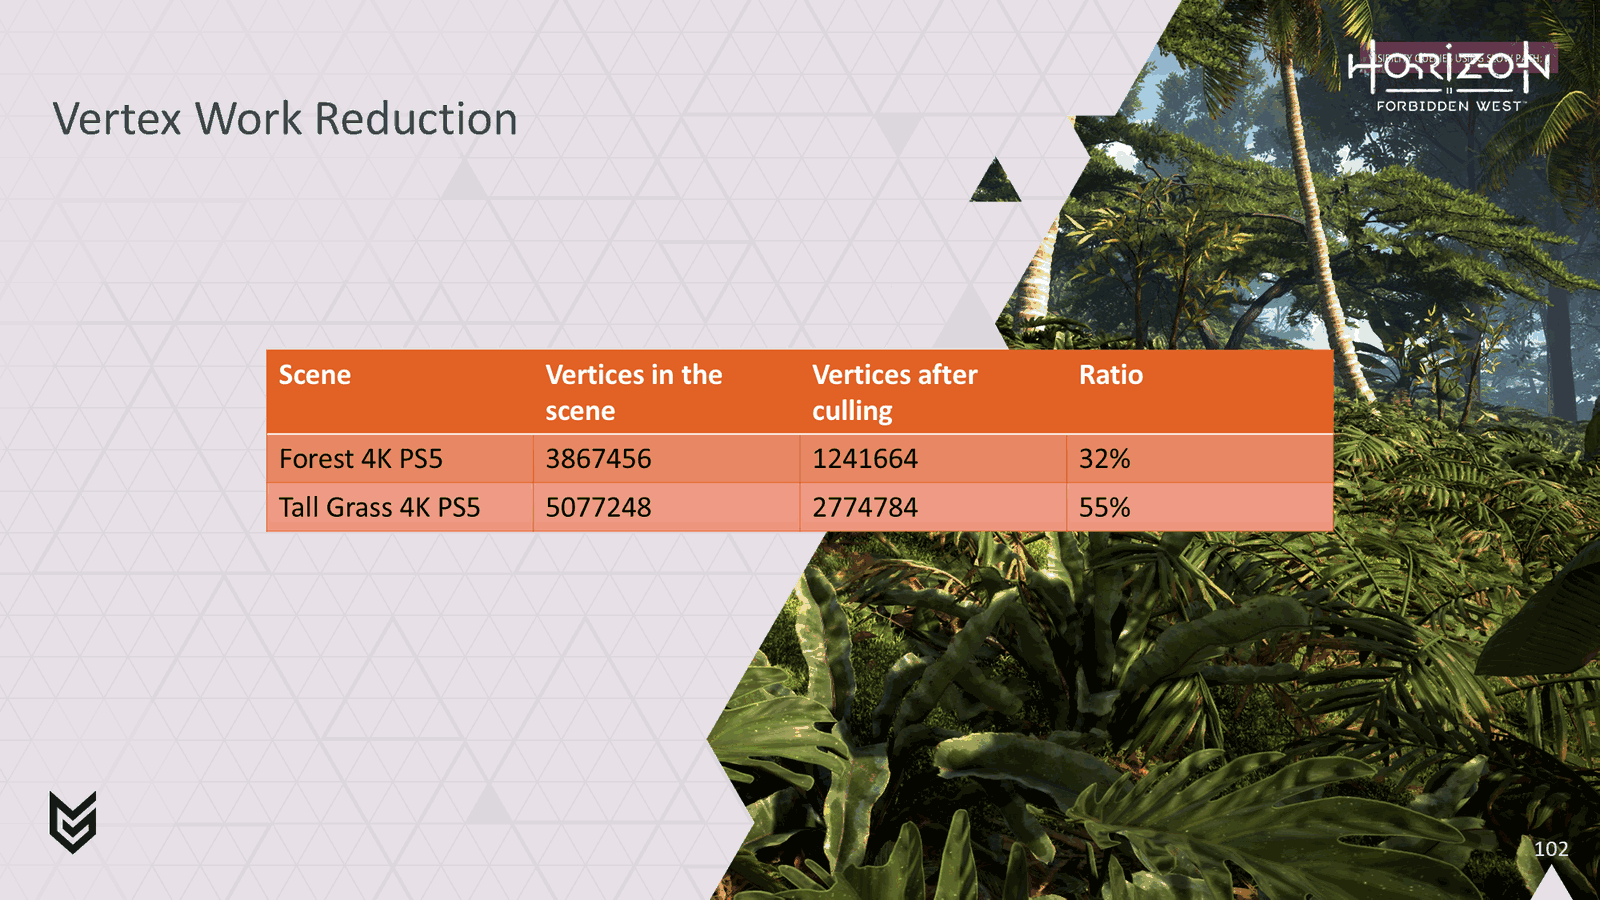
📌 要点汇总
- 顶点剔除:通过剔除无效顶点减少计算负担
- 性能优化:关键技术削减图形处理工作量
- 效率提升:降低GPU负载提高渲染效率
还有我们正在做的顶点剔除要削减多少工作。
Slide 103
📌 要点汇总
- 技术总结:系统优化提升渲染效率与画面质量
- 视觉改进:树叶着色优化使场景更自然生动
- 性能验证:帧率提升验证优化方案有效性
我的演讲到此结束。 我希望你喜欢我们这次的冒险之旅。我们用新的眼光审视了树叶着色,虽然像素看起来与我们开始时几乎一模一样,但我希望你会同意草现在看起来更绿了一点……。至少从帧率的角度来看。
Slide 104
📌 要点汇总
- (无内容):此幻灯片无演讲内容
Slide 105
📌 要点汇总
- (无内容):此幻灯片无演讲内容
Slide 106
📌 要点汇总
- (无内容):此幻灯片无演讲内容
Slide 107
📌 要点汇总
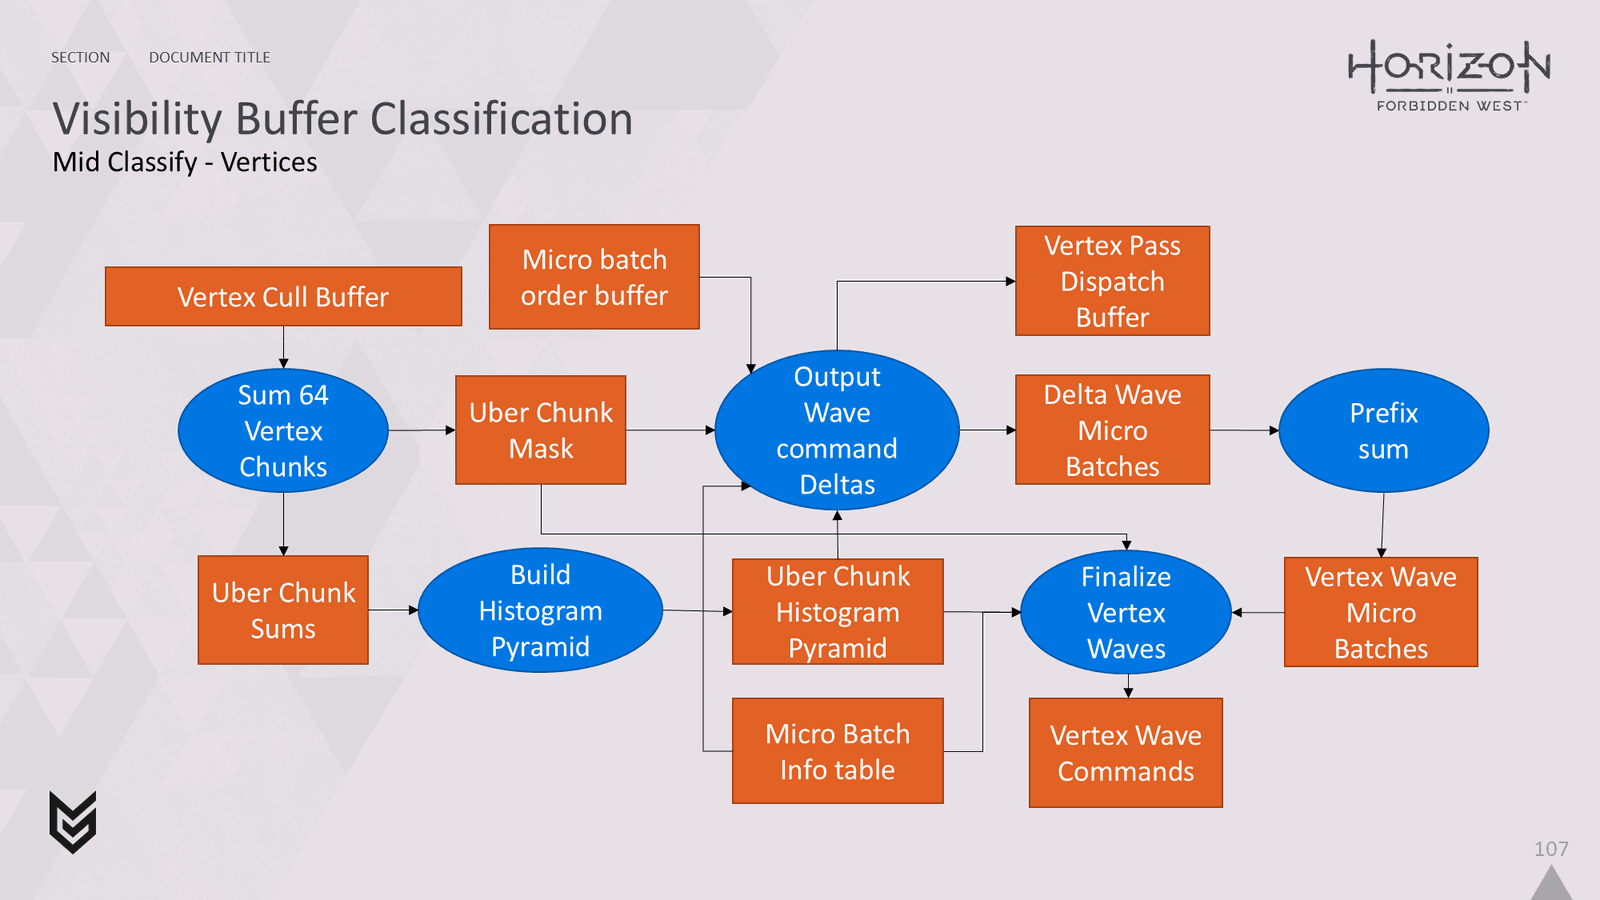
- 顶点剔除缓冲区:统计超级块中可见顶点块数量
- 64位掩码生成:标记超级块内子块可见性
- 直方图金字塔:实现线性索引到超级块的映射
- 微批次调度:基于掩码和直方图计算顶点波数量
- 间接命令生成:结合掩码和微批次信息分配顶点块
<这是我们如何生成顶点波命令的简要说明> 因此,我们采用顶点剔除缓冲区,并总结有多少个顶点块在我们所谓的超级块中可见,这是一组由 64 个顶点组成的 64 个块。 我们还为每个超级块吐出一个 64 位掩码,告诉我们设置了哪些块。 通过超级块总和,我们可以构建一个直方图金字塔,这将使我们能够轻松地将工作项的线性索引映射到超级块以及其中子顶点块的子索引。 使用我们为每个超级块构建的 64 位掩码,我们可以轻松地将子顶点块索引转换回顶点块的全局索引。 我们对所有微批次进行调度,读取微批次信息表并使用我们刚刚描述的映射来计算出每次传递需要多少个顶点波。 我们读取在 CPU 上设置的微批次顺序缓冲区,描述微批次的处理顺序。 这用于在微批次 ID 将改变的顶点波命令流中的每个位置处自动写入微批次 ID 的增量。 然后使用前缀和将增量转换为实际的微批次 ID。 然后我们通过对我们需要的所有顶点波命令进行间接调度来结束, 读取直方图金字塔和掩码以及微批次信息表,以查找每个波命令应转换哪个顶点块,并将此信息与已记录的微批次一起添加到命令中。
Slide 108
📌 要点汇总
- 批次组限制:每个通道最多支持32个批次组
- 批次组定义:相同着色器但实例不同的批次集合
- 限制原因:当前可见性缓冲区分类架构约束
<这张幻灯片被(也许是愚蠢地)剪切了,它曾经直接位于幻灯片 44 之后,这个 32 的限制使后面图表中的一些掩码/计数器内容有意义> 对于每个通道,我们最多支持 32 个批次组。 批次组是一组具有相同着色器和每批次数据但实例不同的批次。 理想情况下,我们不希望有 32 个限制,但目前这是我们的一些可见性缓冲区分类工作结构的结果。
Slide 109
📌 要点汇总
- 计算/阴影平衡:通过性能计数器动态调整工作负载
- 90%时间目标:计算工作占用阴影时间的90%
- 波前速率控制:使用SetComputeShaderControl()参数调节
- 资源优化:避免波前浪费和运行时间失衡
我们的着色工作将与阴影并行运行,并且 理想情况下,我们希望计算工作运行的时间与阴影所花费的时间大致匹配。 这有望确保两种工作负载的最佳混合。 任何一个的运行时间明显长于另一个都会导致效率低下。 为了实现这种理想的平衡,我们使用性能计数器来了解每个帧在最后一帧中花费了多长时间。 然后我们使用它来逐渐调整 SetComputeShaderControl() 的参数,以便我们可以更改计算工作的波前生成速率。 我们的目标是计算工作占用大约 90% 的阴影时间,因为阴影通道结束时通常会进行深度解压缩,而该深度解压缩往往不会很好地重叠。 此外,我们希望避免计算工作被调整为不使用它可以使用的所有波前但运行时间较长的情况。这通常是比阴影运行时间更长的情况更糟糕的情况。
Slide 110
📌 要点汇总
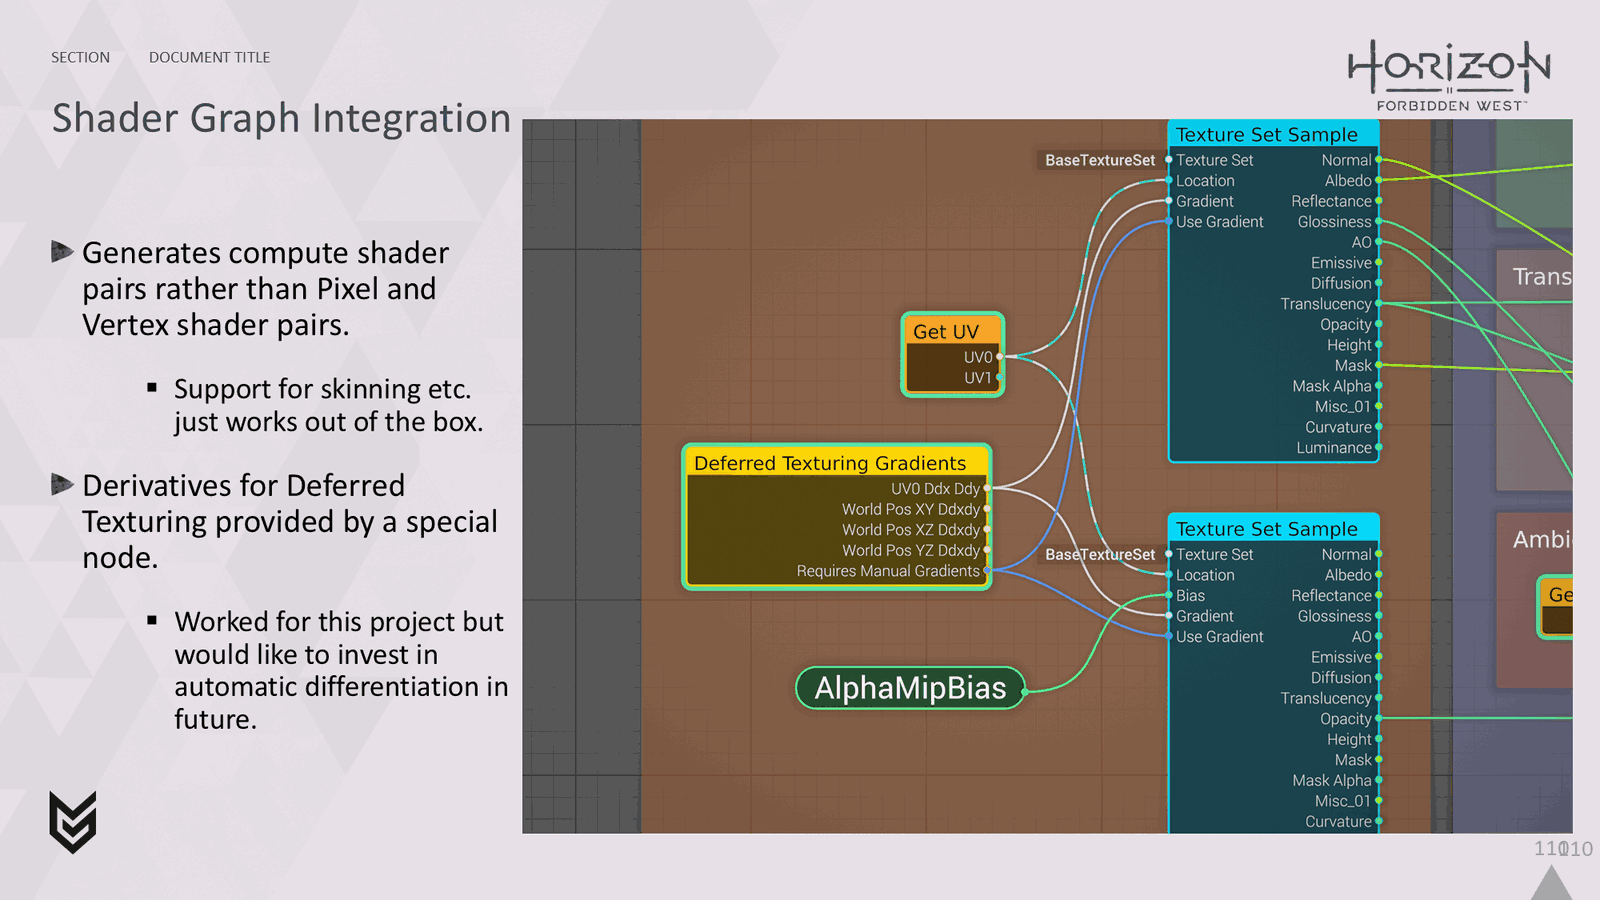
- (无内容):此幻灯片无演讲内容