【GDC 2014】Advanced Visual Effects with DirectX 11 Grass, Fur and Hair
来源:D:\迅雷下载\GDC2014 Advanced Visual Effects with DirectX 11 Grass, Fur and Hair - 腾讯游戏知识库 - KM平台.m3u8\GDC2014 Advanced Visual Effects with DirectX 11 Grass, Fur and Hair.mp4
提取时间:2026-04-28 14:31:26
根据提供的信息,这里是对AMD在毛发和草模拟技术上的工作的总结:
-
每像素链接列表(PerPixel Linked List):这是一种处理大量片段的方法,其中每个像素可以有多个片段。这种方法需要分配一个节点池来存储所有片段,并且很难确定实际要分配多少节点以满足给定帧的需求。
-
K缓冲区方法(K-buffer approach):为了克服每像素链接列表的内存绑定问题,AMD考虑使用固定大小的数组作为中间存储器,称为K缓冲区。每个像素有k个元素,其中k可以是4、8或16等值。这种方法通过在内存中进行排序来减少写入和读取操作。
-
互斥体(Mutexes):为了处理多线程环境下的竞争条件问题,在K缓冲区内存方法中使用了自旋锁机制,以确保每个像素的片段可以被正确地排序而不会发生冲突。这种方法通过原子操作来实现,并且需要在完成工作后释放互斥锁。
-
性能比较:与无序混合相比,内存中的K缓冲区通常比每像素链接列表慢,但在某些情况下会更快。然而,在延迟的每像素链表方法中,比率小于一,表明分类片段可以采用更便宜的着色器路线。
- 毛发和草模拟技术细节:
- 毛发模型包括长度限制、局部约束(保持弯曲度)、全局约束(防止头发回到原来的位置)以及碰撞形状等。
- 草叶模拟则简化了这些约束,更注重于与物理对象的互动效果。
- 演示和应用:AMD展示了一个包含约三十万根草的游戏场景,并且能够同时模拟十六个子弹和球体。这表明该技术在实际游戏中的性能表现良好,可以处理大规模的动态物体交互。
通过这些方法和技术细节,AMD展示了其如何优化毛发和草叶的实时渲染与物理模拟,使得这类复杂效果能够在现代游戏中实现高效、逼真的视觉体验。
Slide 1 — 00:00:07

📌 要点汇总
- (Transitional content, no key points)
- (Transitional content, no key points)
感谢大家整个下午的陪伴,我真的很感激。
我的名字是尼克·泰贝罗斯,我是 AMD 游戏工程的全球经理。
Slide 2 — 00:00:24
📌 要点汇总
- 团队持续探索并将新技术应用于游戏开发中
- 同事卡尔正在进行图形研究等创新项目
我与同事们合作开发了许多游戏、优化和新功能。这是一份非常棒的工作。我的同事卡尔已经开始进行一些很酷的项目,比如图形研究等。
所以,我们团队在不断探索新技术并将其应用到游戏中去。
Slide 3 — 00:00:35
📌 要点汇总
- 下一代头发图形技术在《古墓丽影》等游戏中实现高质量视觉效果
- 使用计算着色器进行模拟可避免CPU瓶颈,提高性能
- 抗锯齿和透明度是提升真实感的关键因素
- TrisFX管道包括模拟、片段着色与存储及排序渲染三个步骤
- PPLL技术用于高效处理大量发丝或毛皮片段
- 性能优化通过减少高质量阴影应用范围实现,提高效率
- 延迟PPL方法相比传统前向每像素链接列表法性能更优(2.13毫秒 vs 3.38毫秒)
那么,我今天为什么在这里与大家谈论下一代头发图形?确实,在过去几年中,此类技术在图形方面取得了显著的进步,并且事实上,图形硬件已经达到了性能水平,使您可以在渲染这些技术时真正突破极限。我们已经看到 Crystal Dynamics 的人员在《古墓丽影》中用头发做了什么,他们不仅在 PC 平台上做到了这一点(PC 平台通常有高端显卡),而且也在第四代游戏机上实现了这一目标。很明显,他们能够以相当适中的价格和性能为您提供这种非常引人注目、有趣且高质量的视觉效果。这对你们来说意味着玩家很可能会期望你们的游戏达到这种水平的质量。因此,您需要开始思考自己真正能做什么以及如何实现这样的图形。
实际上,本次演讲并不是关于镶嵌的艺术部分。我们不会对此进行太多介绍。这实际上是谈论我们所做的性能优化,分享我们在过去几年中所做的经验,并希望激励您在应用程序中使用这些技术。所以,实际上,我们所做的是研究 TrisFX,它是在过去几年中开发的,显然被用于《古墓丽影》和其他一些项目。我们还意识到,我们可以将同样的技术用于任何类型的应用程序,这些应用程序依赖于使用相当长的条纹三角形,特别是草或毛皮渲染之类的东西。
特别重要的是模拟。您需要确保您的头发、毛皮或草的模拟足够真实,而做到这一点的最佳方法是通过计算着色器真正运行这些模拟。如果您愿意的话,您可以在 CPU 上运行这些程序,但由于您必须处理大量发丝、毛皮或草叶的数量,CPU 很可能会因这种工作负载成为瓶颈。因此,对于此类场景,计算和 GPU 计算尤其是最佳选择。
抗锯齿非常重要。它是获得下一代外观的关键。如果没有抗锯齿功能,您将无法获得所需的真实感。透明度也是关键,本质上,您需要某种透明度来模仿或至少模拟发丝或毛丝的稀疏度。因此,通过对这些趋势应用透明度,您可以有效地模仿它们非常薄的外观。
我们将回顾一下我们使用的原始 TruesFX 管道。从那时起,我们做了许多改进。在多个领域,但在传达经验和我们为加快速度而采取的步骤方面,了解遗留方法的工作原理非常重要。所以实际上,我们有三个步骤:首先对头发进行模拟,然后脱落这些头发并将它们存储到一堆缓冲区中,最后获取所有脱落的片段,对其进行排序,并将它们渲染到 GPU 上。
该技术的核心原理是依靠 PPLL 的每像素链接列表的使用。这是我们在 2010 年 GDC 上展示的东西,从那时起我们就不断改进这项技术。第一遍只是头发模拟。我们为此使用了一堆计算着色器。作为输入,我们有毛茸茸的朋友。它由模型空间中的许多线段组成,然后我们将其输入到许多计算着色器中,以执行边长约束、全局形状约束、局部形状约束等模拟所需的任何操作。
第二步是对片段进行着色并将其存储到缓冲区中的想法。这样我们就得到了前一遍的输出。同样,我们的线段、世界空间中的顶点,然后我们将其发送到顶点着色器中。在这个阶段所做的是将那些片段(即那些线段)挤出到非索引三角形中。
在像素着色器中会发生许多有趣的事情。覆盖范围是一,所以这基本上就是我们的抗锯齿。因此,PS 中发生的事情是光照,相当简单。您将照明模型应用到片段上,然后还添加阴影。以前,您不仅必须使用模型的阴影贴图,还必须再次使用毛皮模型或草叶或其他任何东西,如果您想将阴影投射到毛皮上。
在输出方面,PS 没有实际的渲染目标绑定,因此我们在这个阶段实际上没有编写任何内容来渲染目标。但是,我们确实绑定了模板缓冲区,这将允许我们优化下一个通道。最后一步是获取这些片段,对其进行排序,并将其丢弃然后渲染它们。在这里进行区分很重要。我们不依赖硬件混合(如 ROP)来执行此操作。一切都发生在 PS 中。
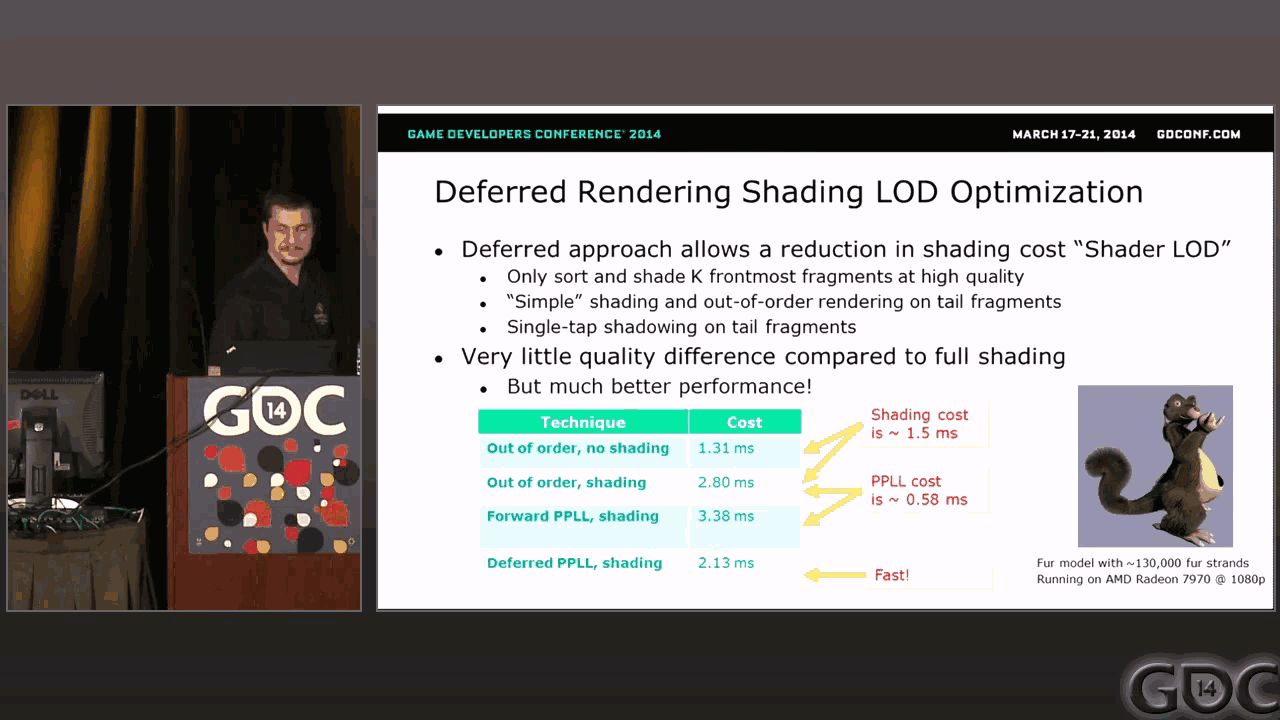
就性能而言,之前已经说过一些关于有目的的链接列表的事情。主要成本不是此类技术的 PPL 解析。这确实是脱落的部分。如果您仔细考虑一下,您就会丢失大量碎片,显然这往往会成为您游戏中应用程序的瓶颈。所以重点是,您实际上并不需要所有这些片段都具有完整的质量。您可以使用某种阴影 LOD 系统,即只对离您较近的片段应用高质量的阴影,但任何较远的片段(我们称为尾部片段)都可以使用更简单的方法来完成。
因此,左边是我们刚刚描述的前向管道,右边是延迟变体。非常相似,但您会看到一些关键区别,这使我们能够声称具有更好的性能。头发模拟通道保持不变。现在的第二遍非常相似。在这个阶段要提到的是,实际上并不需要延迟方法来执行从线段扩展到三角形的方式。
在最后一步中,我们将获取这些片段,对其进行排序,并将其丢弃然后渲染它们。在这里得到了全屏三角形。我们已经像以前一样将模板缓冲区绑定到了 PS。我们仍然从每像素链接列表中读取,所以这相当简单。这就是我们进行照明和阴影的地方。但同样,我们只会对那些洞穴最前面的片段进行高质量的照明和高质量的阴影。
最后,我想在这里看一些快速的数字。这些数据实际上是在上一代汽车上捕获的,而不是我们今天获得的高端汽车上捕获的数据。这里的毛朋友已经有十万多根毛了,大约有十三万根毛。这大约与您头上的头发数量相同。这是一个相当大的数字,并且在相当接近的范围内以 10 ATP 运行。如果我们无序地渲染所有这些片段,没有着色,成本是 1.3 毫秒。如果使用完全着色,则成本将变为 2.8 毫秒。现在,如果我们使用传统方法,即带有阴影的前向每像素链接列表,我们将得到 3.38 毫秒。最后,我们得到了延迟的 PPL 方法,它的运行时间为 2.13 毫秒。实际上,对于它正在做的事情来说相当快。
Slide 4 — 00:15:20
📌 要点汇总
- 演示左侧采用全片段强制高质量渲染
- 右侧使用LOD系统:前四个片段保持高质渲染,后续片段降级处理以节省资源
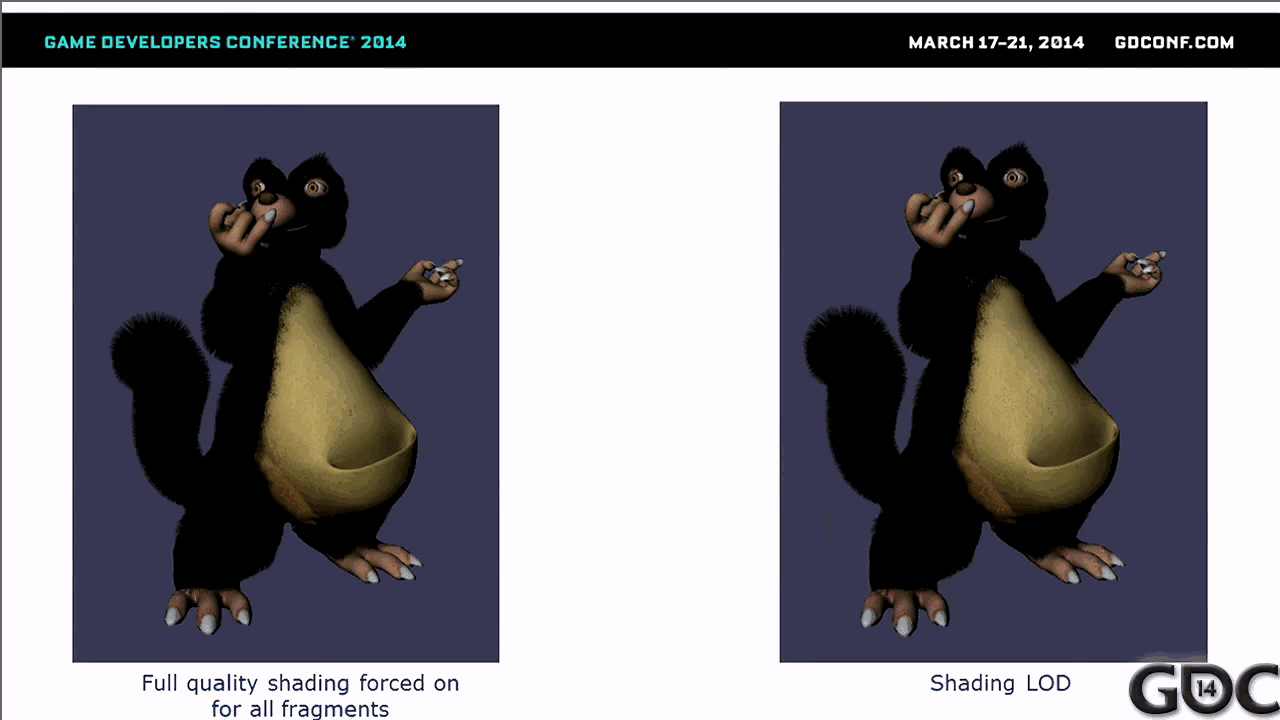
我不知道你是否能看出这里的差异。希望你不应该这样做——这就是整个想法。
在左侧,您可以看到我们对所有片段强制执行的完整质量着色。而在右侧,我们正在执行一种奇特的着色—LOD(Level of Detail)系统,在前四个片段上应用完整的着色质量,并且在尾部片段上进行无序混合和廉价着色。
所以它看起来不应该完全相同,但就质量而言,显然足够好。
Slide 5 — 00:15:48
📌 要点汇总
- 几何优化减少GPU前端时间,通过预先计算索引缓冲区提高性能。
- 实现基于距离的LOD系统,减少远距离模型线段数量并调整自阴影效果以保持视觉质量。
- 采用动态数组排序替代方法,显著提升像素着色器性能。
- 需要优化内存分配策略和处理PPL缓冲区溢出问题,避免清晰度漏洞。
我们还进行了许多几何优化。尽管着色成本通常是主要成本,并且是此类渲染技术的主要瓶颈,但我们也注意到我们在前端花费了相当多的时间。我的意思是,如果你仔细想想,有130,000根线,这实际上是VS中要转换的毛皮模型总共近100万条线段。所以这是一项相当大的工作。
从线段到三角形的扩展最初是在.GS中完成的,然后我们转向Bill之前提到的顶点着色器实例化方法,这意味着我们有未索引的三角形。因此,每条线段将创建六个顶点,即两个三角形。你知道,它运行得很好。但后来我们意识到,因为我们正在VS中进行扩展,并且因为我们事先知道头发丝、毛丝、草叶或任何您想要使用的东西的拓扑结构,所以我们实际上可以预先计算这些索引缓冲区,本质上这使我们能够从后顶点缓存中获得最大的好处,并且通过减少在GPU前端花费的总时间,这样做确实显著提高了我们的性能。
我们还做了另一项对游戏非常重要的优化:基于距离的LOD系统优化,与着色器LOD无关。本质上,我们所做的是,你知道,我们想要做的,是确保当模型离相机更远时,效果滚动得更快。所以我们已经做到了。随着模型进入远处,通过减少发丝的数量,为此,我们基本上随机化了模型内发丝的顺序。因此,您所要做的基本上就是随着模型距离越来越远,绘制更少数量的线段。所以做起来相当简单。
现在,话虽如此,如果您只这样做而不做其他任何事情,那么您的模型随着距离的增加将会变得更薄。所以你也不想要这样。因此,为了补偿,我们正在使模型变得更厚一些。同时,由于远距离渲染的片段较少,因此我们必须在自阴影方面进行一些调整。所以我们必须使实际模型变暗一点来弥补这一点。
最后,我们还增加了alpha阈值,该阈值基本上决定了我们是否要将片段包含在PPL中。让我对此进行更多解释。当我们计算覆盖信息时,然后当我们调整alpha时,使用该片段传入的alpha得到的alpha值,我们会查看该alpha值,如果该alpha值太接近零,我们就不会费心将其包含在PPL中。现在,随着模型变得越来越远,我们实际上可以为包含测试设置更高的阈值。
我们还做了一些其他优化:头部无人机现在像实际的两架D无人机一样使用。最初,它使用缓冲区,您知道我们从中可以更好地利用两个D缓存。我们所做的另一项重要工作是避免使用GPR索引进行排序。因此,本质上,当您对最前面的k个片段、四个片段、八个片段或十六个片段进行排序时,排序过程将需要在像素着色器中分配动态数组(GPR数组)。然后确实需要索引来明显地将片段转移到排序。所以它工作得很好,但是执行这种真正的动态VGPRI索引会产生很大的开销。
在您的代码中,我们实际上已经研究过它,并且我们使用了不同的方法来执行索引。相反,我们所做的是对所有索引进行一组条件分配,基本上每个索引都作为条件测试,我们仅在所需索引是当前正在寻找的索引时才验证结果。所以这是一种非常聪明的方法,并且确实显著提高了性能。因此,您可能希望在自己的应用程序中重用它。
实际上,如果您现在有任何声明VGP或GPR数组的Shadow.Code,应该说您正在对其进行排序或对其进行索引。您可能需要考虑这种技术,因为您可能会看到一些性能优势。我们还没有做的一件事是优化计算模拟,而且我们确实认识到我们需要花一些时间,更多的时间。所以我们一直在主要侧重于让您知道模拟看起来不错,但这些的实际性能可以改进。
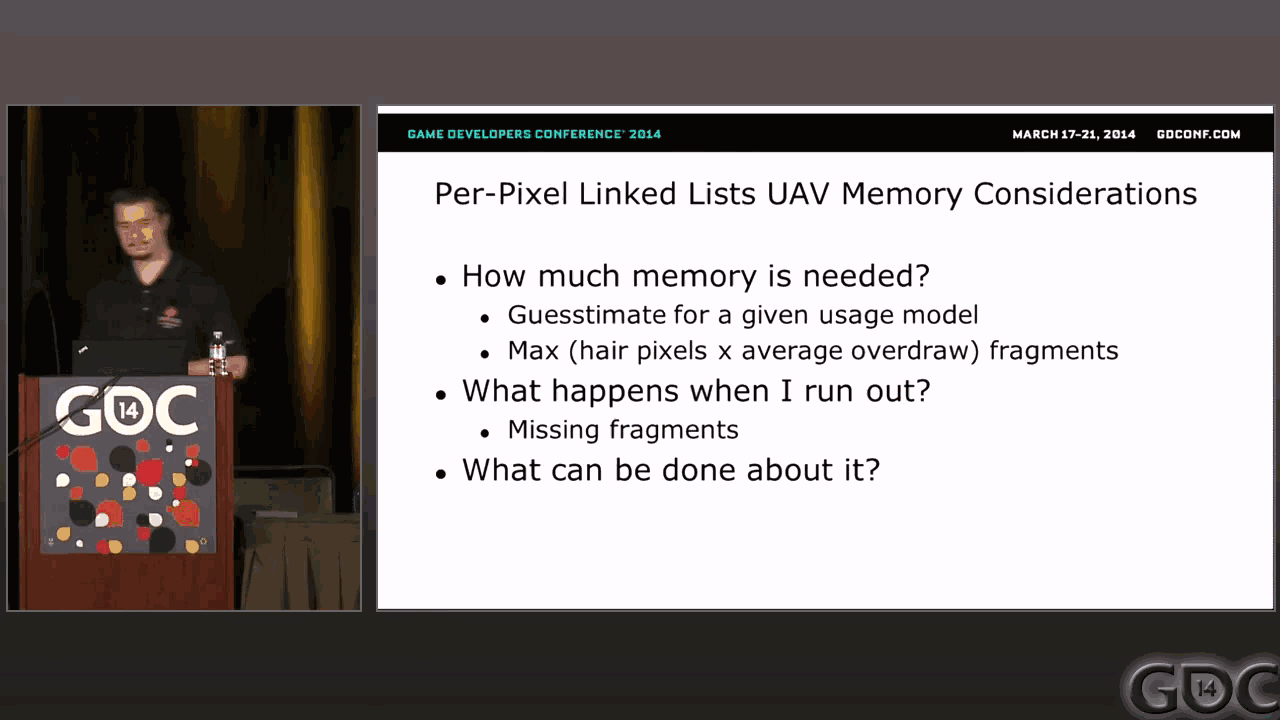
这是我们在接下来的几个月里要做的事情。这是我的最后一张幻灯片。内存方面的考虑很重要。您知道,您有一大堆片段要存储在PPL缓冲区中,这也是经常出现的问题。您需要多少内存?为了保证所有片段都能放入该缓冲区,您应该分配的像素链接列表的实际大小是多少?
我的意思是,这几乎是一个猜测。当然,您需要考虑屏幕的分辨率。您需要考虑该模型的预期Alpha透支——这肯定不是一门完美的科学。现在,您分配多少取决于您的目标平台。我想说,在下一代游戏机上,你知道,内存量相当大,所以100兆、200兆可能并不少见。
但问题仍然出现:如果用完了怎么办?如果您有太多片段不适合您的每像素链接列表,会发生什么情况?那么在这种情况下,您的模型就会出现清晰度漏洞,这不是一个好地方。现在,我再次认为这不是一个大问题,因为在类似游戏的场景中,您可能能够限制一些(您知道的)相机与模型的距离,等等。
您知道,根据引擎的不同,执行此操作可能或多或少容易,但您有一些方法可以尝试避免这种情况发生。尽管如此,在某些情况下,您可能需要一个不同的解决方案,该解决方案依赖于这些缓冲区的固定内存量,这就是Carl现在要讨论的内容。
Slide 6 — 00:21:35
📌 要点汇总
- (Content too short, no key points)
所以这是一个实验。
Slide 7 — 00:21:45
📌 要点汇总
- 使用 K 缓冲区解决内存绑定问题,K 是固定大小数组的参数。
- 每像素链表方法需要大量内存分配和读写操作,而 K 缓冲区减少这些开销。
- 初始化 K 缓冲区时可采用全屏清除或模板技术,并使用互斥锁确保原子性。
- 在毛发模型中,K 缓冲区内存限制比每像素链表慢,但提供更简单的内存管理。
- 局部和全局约束用于保持头发形状,局部约束允许一定程度的弯曲和卷曲。
我最近重新审视了一个很久以前做的项目,正如尼克提到的,我们的目标是找到解决难以绑定内存问题的替代方案。对于每像素链接列表,您需要从中分配节点池,并且很难知道实际要分配多少节点。理想情况下,您需要足够的空间来满足给定帧所需的所有片段。
因此,我们考虑采用现有结构之一并将其放入内存中。在本例中,我们将使用 K 缓冲区,它是一个固定大小的数组,其大小为屏幕上的像素数乘以 K。这里的 K 是一个技巧,用于处理大型排序问题。如果尝试对所有片段进行排序,您最终会遇到这种问题。
这是一个早期版本的毛茸模型图表,每个像素平均有 20 个片段,红色区域超过 100 个片段,而绿色像素约为 50 个。因此,降低成本非常重要,并且它也用于延迟着色等技巧。我们尝试过的 K 值是四、八和十六。
最前面的 k 个片段就是我所说的位于 k 缓冲区中的片段,然后使用 Nick 所做的相同术语,尾部片段是落在缓冲区之外的片段。需要注意的一件事是,在您看到所有像素或所有片段之前,您不知道前面的 K 是什么。因此,这是您需要对每个像素中的每个片段执行的操作概述。
您有这个 K 缓冲区,并且有一个尾部片段,您想知道该新片段将在哪里结束。为了帮助您,您可以跟踪该像素的 K 缓冲区中最远片段的索引,然后如果您决定该片段需要进入 k 缓冲区,那么您需要首先与那里最远的元素进行交换,现在这将是尾部片段,即被踢出的片段,然后您需要计算下一个最远的片段将是什么。完成后,您可以将尾部片段混合出来。
如果它不会出现在 K 缓冲区中,那么您可以立即将其分类为尾部片段。在最小化方面,您不必对 k 缓冲区做任何事情。再次,您将其混合出来。这是逐像素链表方法和在内存中使用 K 缓冲区之间差异的概述。
在每像素链接列表中,传递的细分是在将片段写入内存时和在第二遍中将它们全部读回并处理它们之间。如果你切换到这个想法,使用 k 缓冲区作为内存中的东西,那么你就消除了写入和读取。您已将传递向下移动到收集了所有片段和 K 缓冲区之后,在这两种情况下,您仍然需要进行第二次遍历或第二阶段,对所有片段进行排序并按顺序混合它们。
K 缓冲区只是屏幕宽度乘以屏幕高度,每个像素都有 k 个元素。K 又是四、八、十六。如果您要存储深度和数据,则每个字节有八个字节。在每像素链表的第二遍中,这些东西基本上都在寄存器中。因为它们在第二遍中,而如果你打算使用 K 缓冲区作为中间存储器,那么这些东西最终会出现在内存中,当然,这会产生一些额外的复杂性。
第一个问题是 K 缓冲区,即使只是一个像素所需的元素数量也大于 32 位,并且您需要对其进行原子操作。所以我们尝试了一些软件互斥体。另一个改变的是一个选项。实际上,您现在可以使用混合单元,因为无论如何您都会进入内存,因此您可以通过固定功能硬件混合尾部片段或尾部颜色。
我们将互斥锁与此索引以及其他一些内容一起打包,我将解释其中的一些其他位字段。这里每个像素基本上有 32 位。所以,在 mutex 中,我们使用了这种自旋锁方法,其他人也做了类似的事情。这个想法是,您使用互锁交换写入保留值,如果您返回的内容表明该内容已经被保留,那么您必须继续尝试。
否则,如果您返回的内容表明尚未保留,那么您就是那个可以开始工作的人。当您完成后,您需要释放它。从技术上讲,您需要一个内存屏障,因为您希望确保在您真正说您已经完成工作之前就可以看到您所做的工作。仅仅因为我很偏执,我在这里设置了最大循环计数,我们将讨论您实际上需要进行多少次尝试。
另一件事是初始化,这里有几个选项。您可以全屏清除整个 K 缓冲区。您可以使用已有的模板,因为您知道哪些像素中有有趣的内容,并且您知道使用模板在第三遍中清除它们。您可以对第一个片段执行某种条件清除。这就是初始化位的作用。另一个选择是计数。
前 K 个片段,你只需做一个简单的互锁添加。这其实很简单。你这样做,然后你只需检查并逐步填写它们。这就是为什么我为此计数分配了这么多位。所以我这里有 26 位,如果你的图片中出现了 26 个片段,那么你可能遇到了其他问题。
这里有一些模型我已经测试过的。我们有毛发模型和一个时髦的中间模型。我只是把这个放进去,因为我想看看如果我们有更好的纵横比的三角形,是否有什么显着的不同,并且这些三角形有两到三百五十万个片段。它们有 200 到 300,000 个像素被此效果覆盖。
从尼克的角度来看,你会发现这可能是一个重要因素。一些深度复杂性的示例说明了每个像素为获取该互斥体进行了多少次尝试。所以,这就是深蓝色本质上是像素,其中没有一个片段必须对其进行多次拍摄。有一种水绿色,其颜色超过 1 但不超过 4。
对于这个 k 等于 4 的情况,没有任何颜色超过 8。我实际上会尝试展示一个现场演示。为了总结这些,我不确定如何总结这些,所以我采取了相对于无序混合进行比率的方法。主要的收获是,在内存中执行此 K 缓冲区往往比每像素链接列表慢。
在某些情况下,它会更快,但你总是会比延迟做得更好。注意:这是延迟的每像素链接列表。与无序混合相比,这里的比率小于一,这是因为如果您可以对片段进行分类,您就可以采用一些更便宜的着色器路线。因此,这部分的摘要:K 缓冲区内存为您提供了一个简单的内存限制。
对于草和毛皮,我们有长度限制,因为你不希望头发像橡皮筋一样伸展。有一个局部约束来保持弯曲度和卷曲度。全局约束不要试图让头发回到原来的位置。局部约束和全局约束是一种软约束,从某种意义上说,您可以使用几帧来恢复它们。
事实上,这正是您想要的那种效果。虽然有长度限制,但您不希望看到它伸展。模型变换是保持毛发在头部。碰撞形状是为了防止头发穿透肩膀,然后我们还有风、重力之类的外力。因此,当您制作毛发时,全局约束并不那么重要,并且碰撞形状可能也不那么重要。
请注意,所以我将它们归类为可选。然后有了草,你甚至可以走更多的捷径。全局约束或模型变换实际上没有任何意义。局部约束,你可以选择用另一个做一些低维度的事情,比如头发。你需要一个几乎完整的参考系来获得诸如扭曲之类的东西。但对于草,你可以稍微欺骗一下。
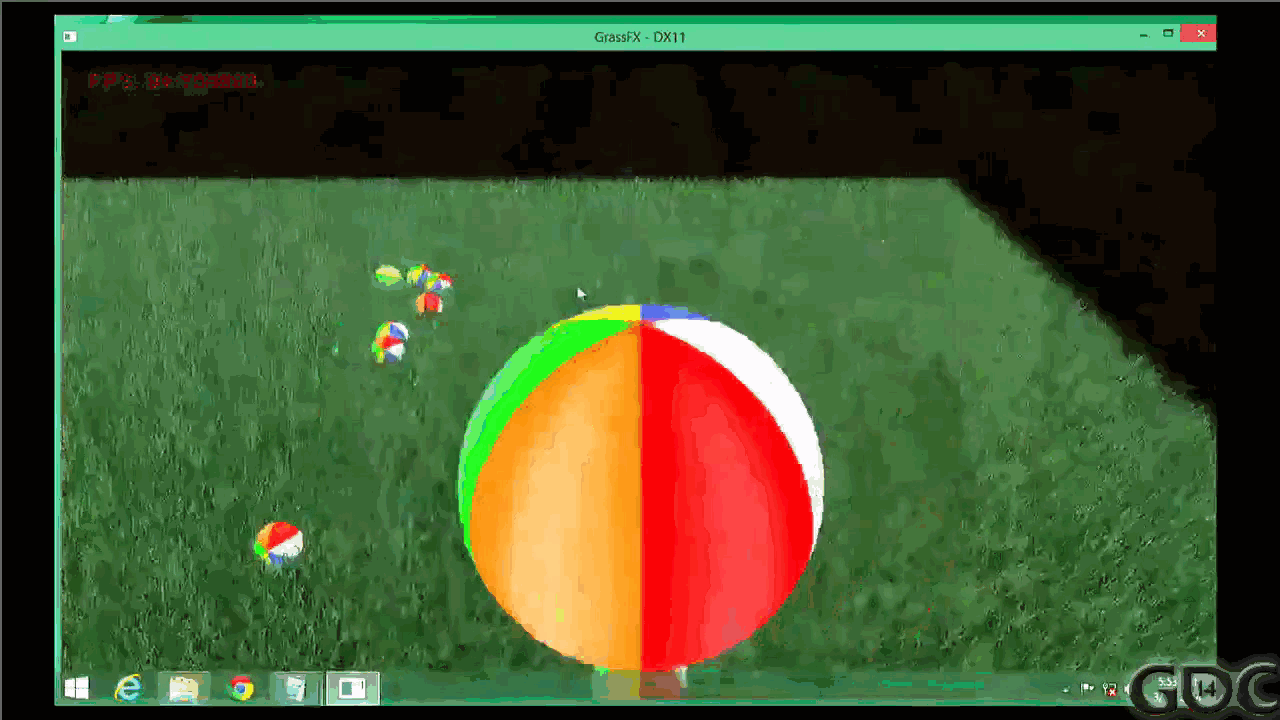
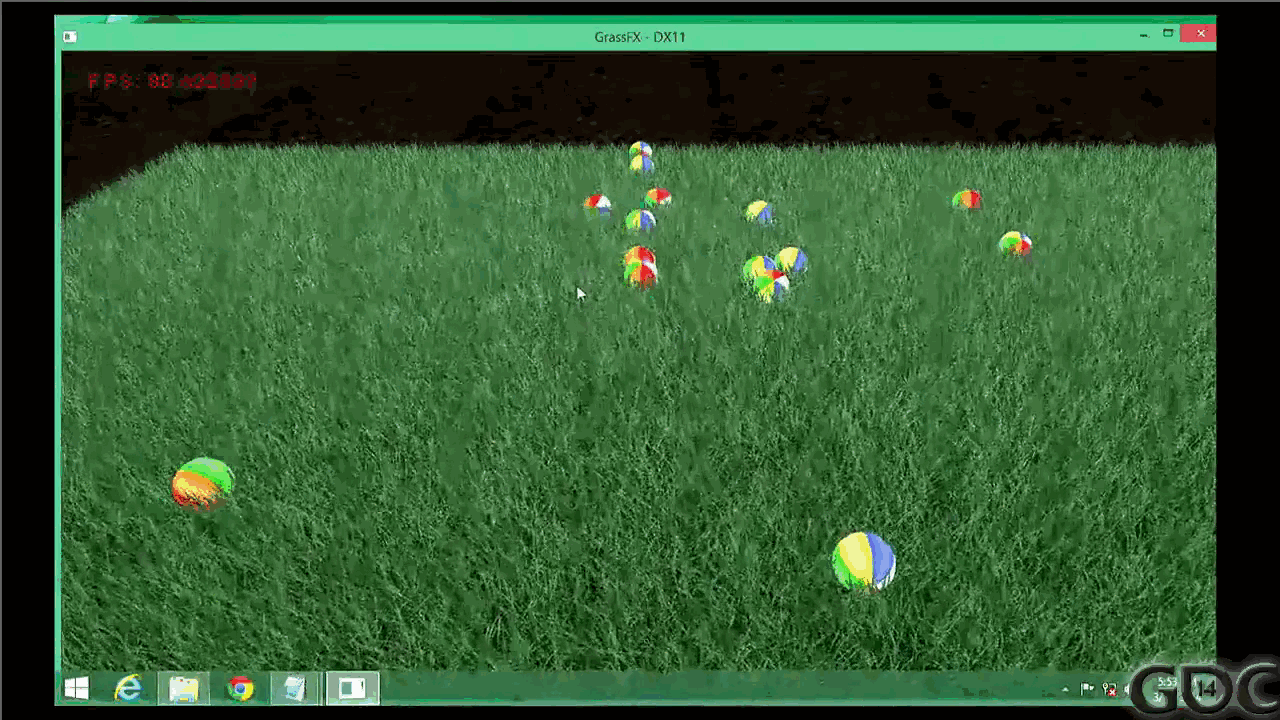
这些夹杂物形状在能够与草互动方面更有趣。所以这些重量过重的沙滩球在草地上的传球效果很好。这里稍微介绍一下约束方法。AMD 发布的 SDK 以及我们过去使用的约束方法都是迭代的。我的意思是它的语言英语
迭代各种顶点,并根据需要捏造它们以尝试满足约束。 它用于长度、局部和全局约束,但长度确实是个问题,因为你真的想要一些坚硬的东西。您不希望您的头发在多个框架上伸展。所以我们还有另一个三对角矩阵。我们称之为公式。这是长度约束的直接解决方案。它的拉伸几乎为零。
需要注意的是,它确实需要采取更小的时间步长,因为它线性化了一些并非真正线性的东西。但它仍然相当便宜。它利用了股线的矩阵结构。你其实并不需要。这是一个非常稀疏的矩阵,非常规则。基本上只有三个。它是一个带状矩阵,基本上相当于两次迭代。
关于迭代方法的成本,我们还没有在 SDK 中发布,但是去年 Rifez 有一篇论文解释了这种方法的工作原理。希望我们有时间进行演示。所以,好吧,很好。请给我一分钟时间。这件事正在升温。看看这个,是的。
Slide 8 — 00:35:59
📌 要点汇总
- (Content too short, no key points)
好的。
Slide 9 — 00:36:03
📌 要点汇总
- (Content too short, no key points)
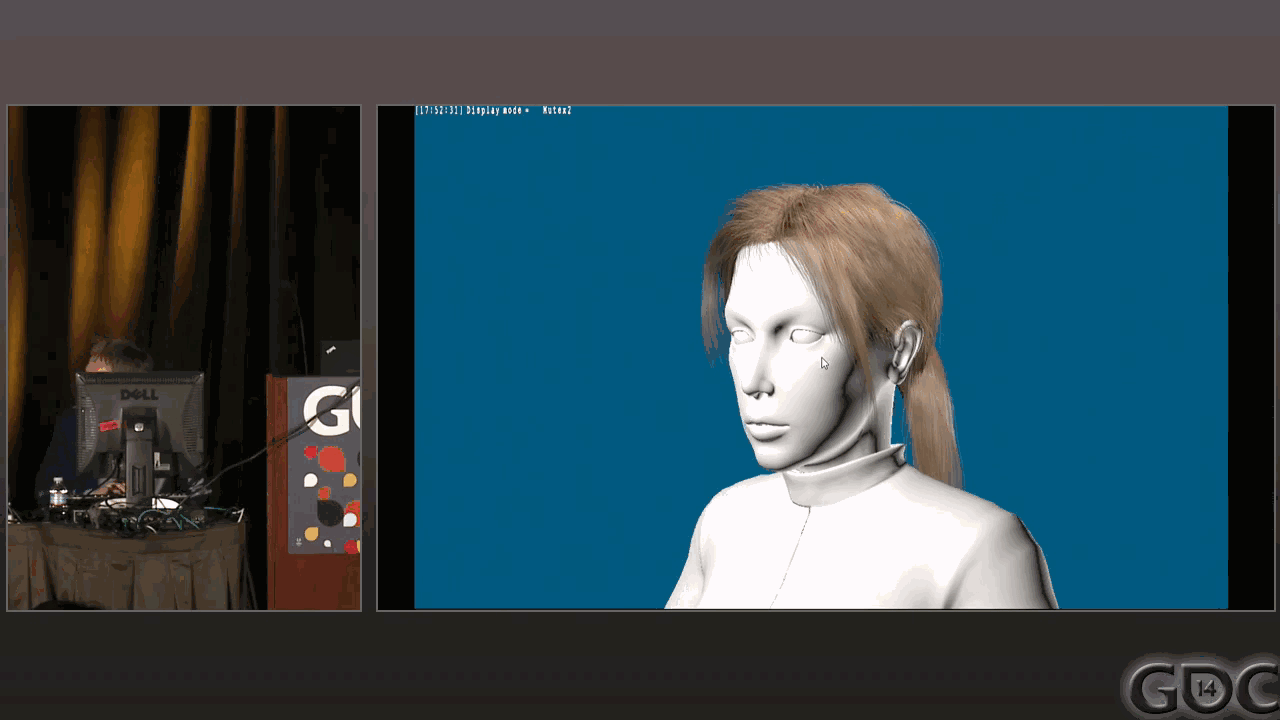
这只是为了向您展示。
这只是我对各种方法的测试应用程序。
Slide 10 — 00:36:08
📌 要点汇总
- (Transitional content, no key points)
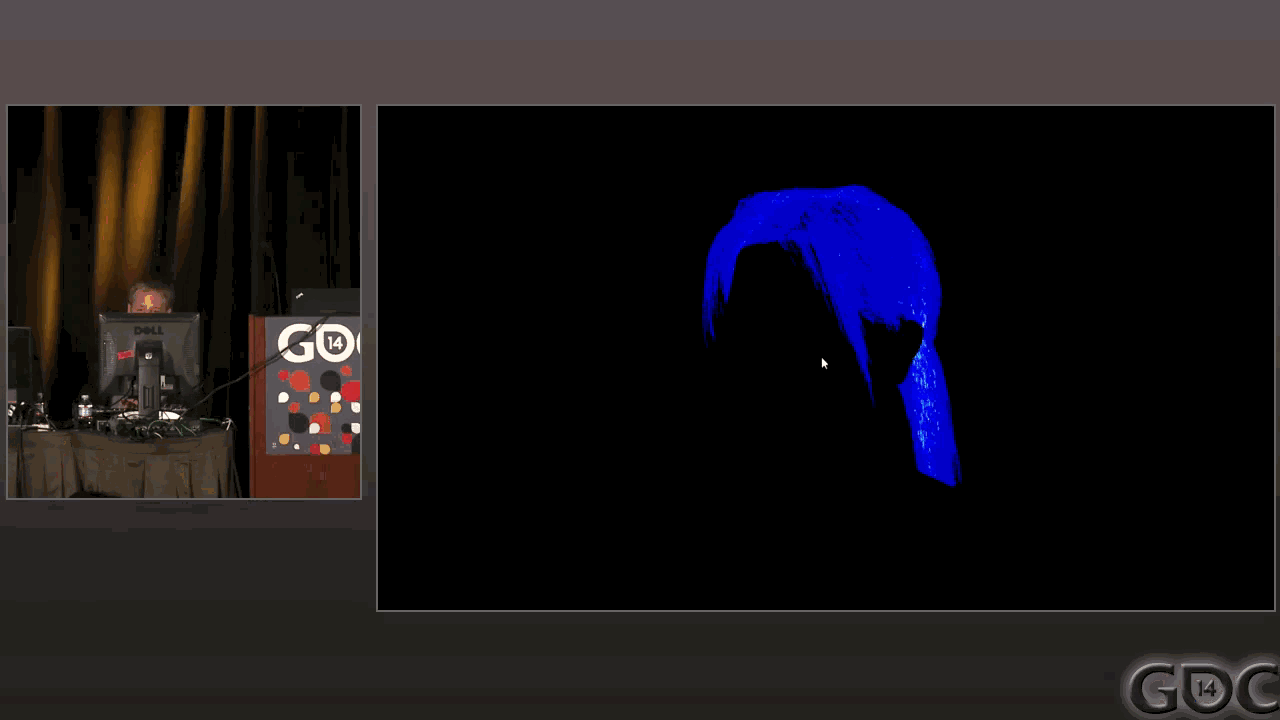
我觉得这很酷。不知道你们是否这样做过,但这基本上展示了对互斥体的争夺情况,以及相关的细节。
\n\n
(由于提供的文本较短且内容单一,这里保持为单段)
Slide 11 — 00:36:19
📌 要点汇总
- (Transitional content, no key points)
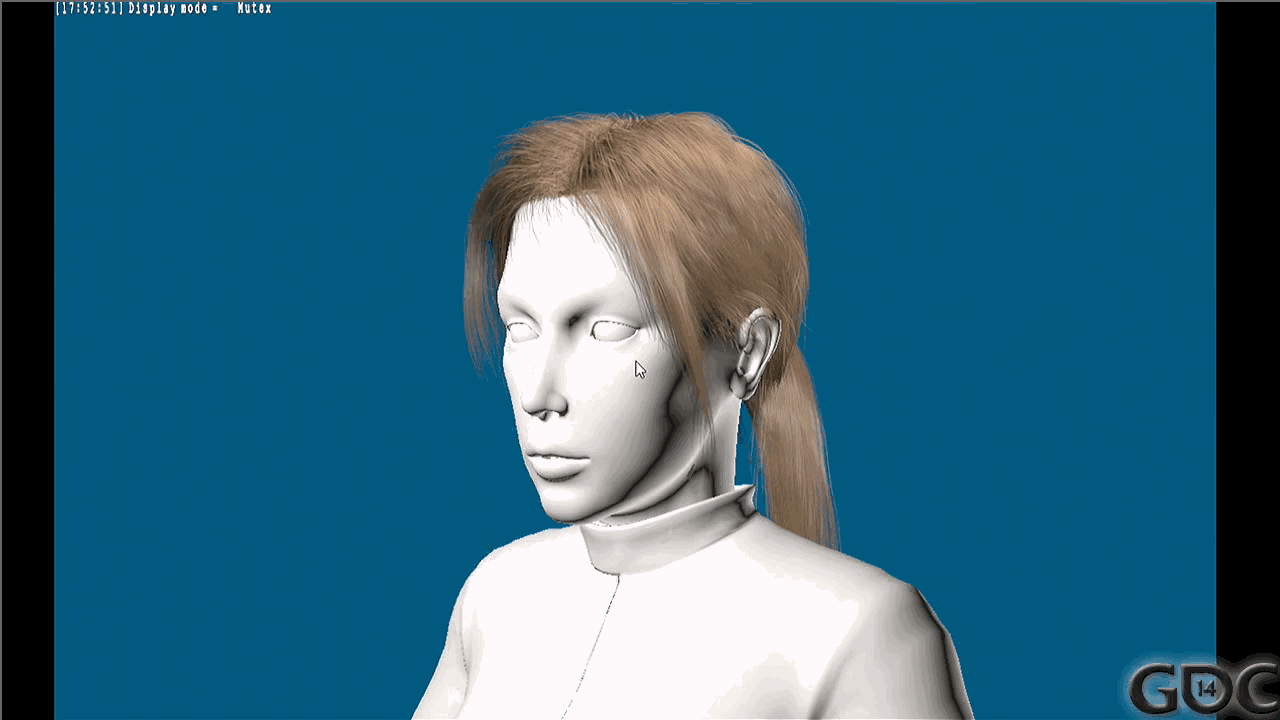
其他人基本上是为了向你展示,无序是行不通的,有序才是可行的。
Slide 12 — 00:36:28
📌 要点汇总
- (Content too short, no key points)
所以我想向你展示那个。这是。
Slide 13 — 00:36:37
📌 要点汇总
- (Transitional content, no key points)
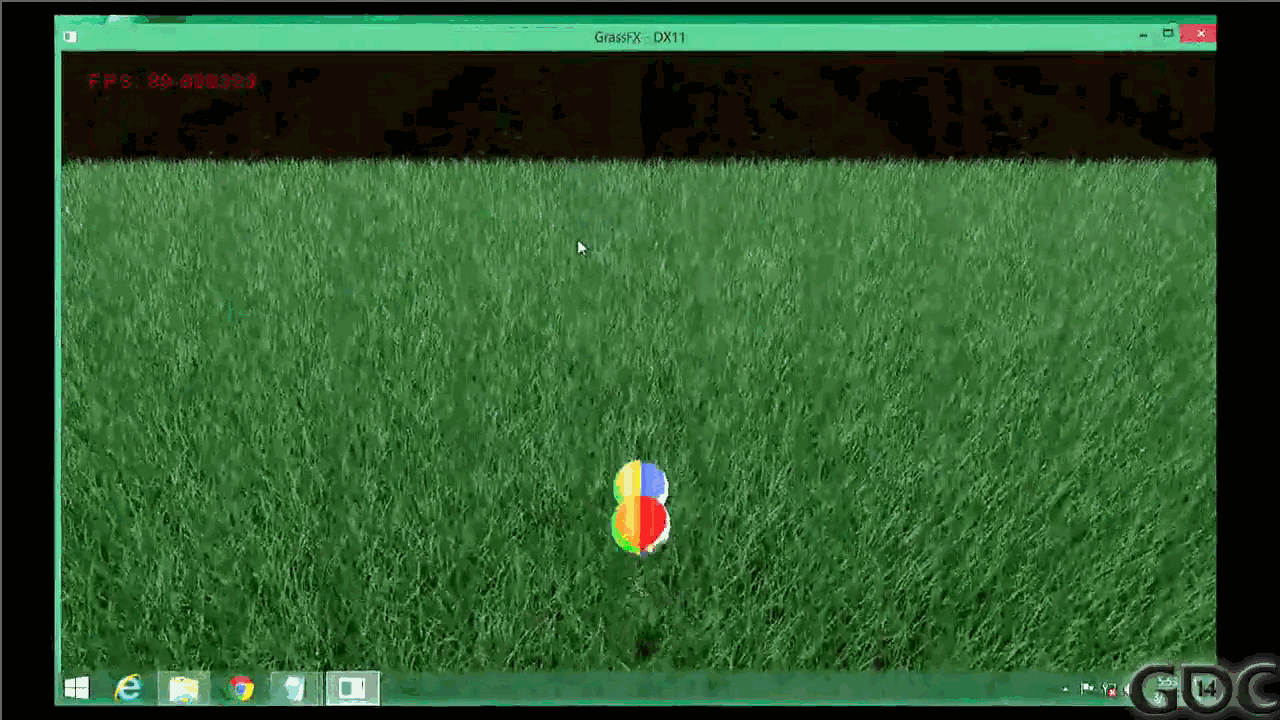
这是我认为玩起来最有趣的一个游戏。这个游戏大约包含三十万根草,CPU同时在模拟十六个子弹和模拟球。
Slide 14 — 00:36:51
📌 要点汇总
- 传输位置和半径数据以模拟所有300,000片草叶
- 方法通过无差别地模拟每一片草叶而显得计算资源消耗大
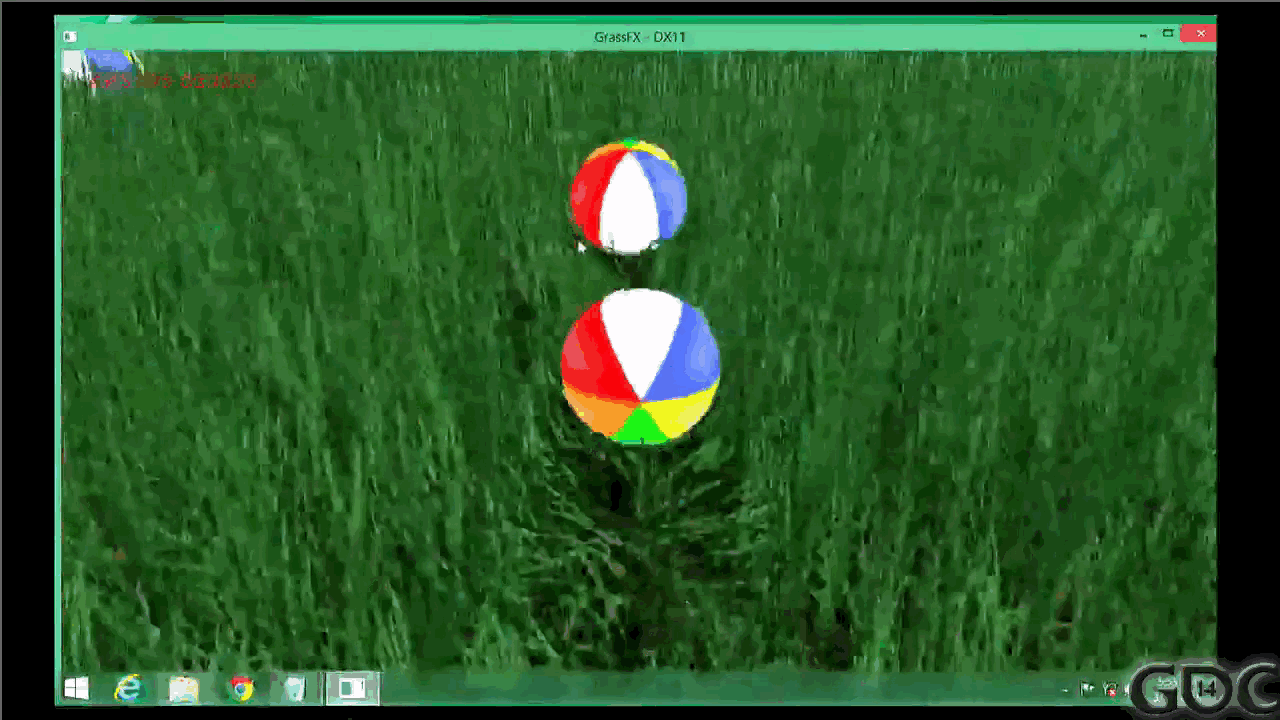
我们传输位置和半径。这方法非常暴力,因为它会模拟所有的300,000片草叶,不论这些草叶是否与其他物体发生交互。
Slide 15 — 00:37:06
📌 要点汇总
- (Content too short, no key points)
所有十六个领域,所以你应该能够。
Slide 16 — 00:37:10
📌 要点汇总
- (Content too short, no key points)
用这个做很多事情。
Slide 17 — 00:37:15
📌 要点汇总
- (Content too short, no key points)
对不起,希望我沒有讓你頭暈。是的,這個玩起來很有趣。
Slide 18 — 00:37:23
📌 要点汇总
- (Transitional content, no key points)
但它真的很便宜,因为原材料真的很便宜。你可以用它来做一些有趣的事情。
Slide 19 — 00:37:32
📌 要点汇总
- (Content too short, no key points)
进而。
Slide 20 — 00:37:41
📌 要点汇总
- (Content too short, no key points)
还有一张。这是为了演示。这是。
Slide 21 — 00:37:45
📌 要点汇总
- (Transitional content, no key points)
- (Transitional content, no key points)
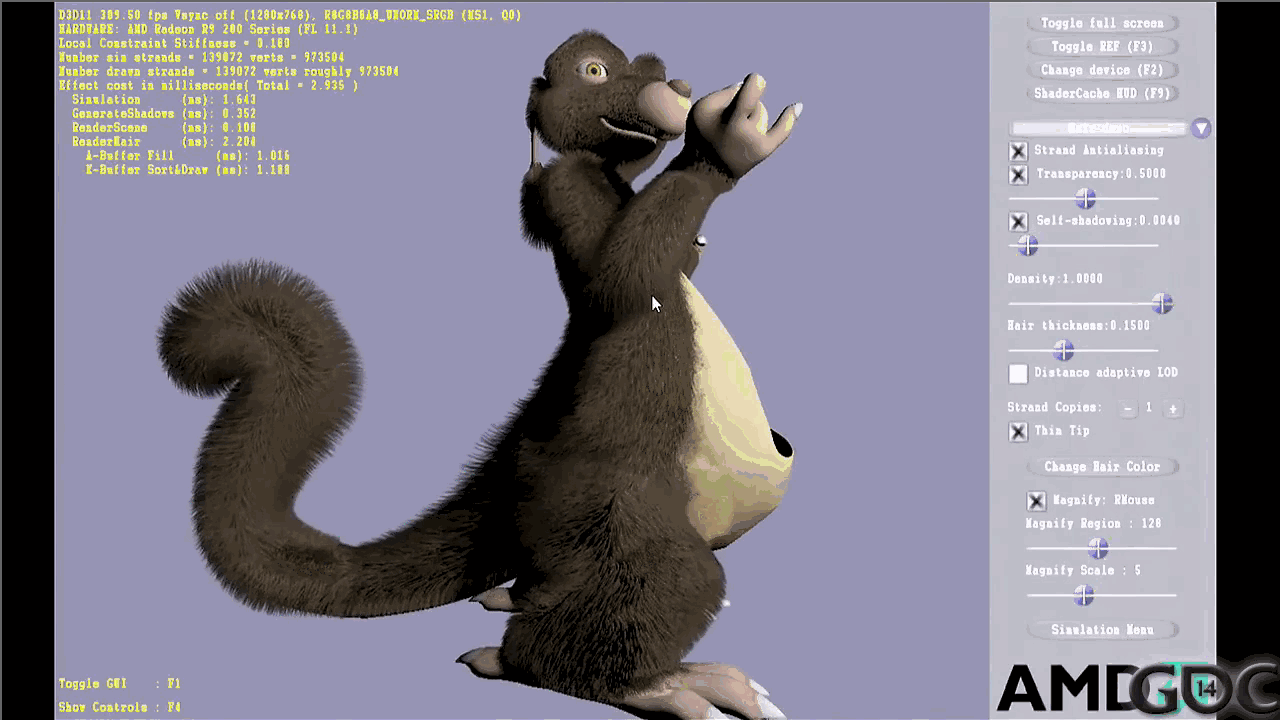
基本上是上周拼凑起来的,但这就是 100 条。我猜它接近 14,000 条。
进行模拟时,你可以得到一些平移运动,还可以在这里添加一点风的效果,吹动一下,这样你就可以真正看到这些变化,你知道,真的可以看到效果。
无论如何,它们都在这里。这很有趣。
Slide 22 — 00:38:29
📌 要点汇总
- (Content too short, no key points)
所以,感谢您的演示,我来做个快速总结。
哦,原来如此。
Slide 23 — 00:38:42
📌 要点汇总
- 延迟着色技术可实现昂贵的着色操作而无需深度复杂性
- 键缓冲内存是内存受限情况下的良好选择
- 鼓励研究将不同技术应用于各种材质如草和毛皮
是的,就是这样。好的。
所以你现在真的可以得到一些好看的效果了。现在有一些游戏采用了此类技术。
延迟着色确实可以帮助你实现这一目标,因为你可以执行非常昂贵的着色操作,但不必以透明度通常所需的深度复杂性来执行此操作。
键缓冲内存是一个不错的选择,也许在内存有限的情况下尤其适用。
您已经看到我们可以将这些不同的技术应用于不同类型的材质,例如草和毛皮。所以我鼓励大家仔细研究这些技术。
谢谢。
Slide 24 — 00:39:31
📌 要点汇总
- (Transitional content, no key points)
- 更新环境参数至着色器每帧会产生内存复制开销;需考虑特殊更新方式或确认性能影响是否可接受
有疑问吗?因此,我不太确定这是否适用于计算着色器,例如 DirectX 9 常规着色器。但我发现,如果我有一个环境参数输入到着色器中,并且需要每帧更新,那么就会涉及到成本。我想,基本上设置这些参数,将内存复制到 GPU 或其他任何东西,无论它来自哪里,都会产生一定的开销。
有考虑因素吗?比如风和在草地上滚动的球体。例如,您是否必须以某种特殊方式更新这些参数,或者只是因为它足够快而无关紧要?我认为我们不必在那里做任何特别奇特的事情。如果它是类似于结构化缓冲区的东西,我们可能必须对缓冲区进行环形处理,但除此之外,我什么都不知道。
好吧。谢谢。 好的。谢谢。谢谢。
Slide 25 — 00:40:46
(该幻灯片时间段内未检测到语音内容)